Kurs
Prompt-Engineering mit der OpenAI-API
4 Std.
53.5K
OpenAI hat kürzlich sein lang erwartetes Modell mit „PhD‑Reasoning“ veröffentlicht, und es ist nicht GPT‑5, wie viele dachten — es ist das OpenAI o1 Modell.
Die Arbeitsweise von OpenAI o1 markiert einen wichtigen Paradigmenwechsel bei der Verteilung von Rechenressourcen, mit mehr Fokus auf Trainings- und Inferenzphase. Das macht es außergewöhnlich stark bei komplexen Reasoning-Aufgaben, aber auch deutlich langsamer als seine Geschwister GPT‑4o und GPT‑4o mini.
Das heißt: GPT‑4o und GPT‑4o mini bleiben die erste Wahl für Anwendungen mit schnellen Antworten, Bildverarbeitung oder Function Calling. Wenn dein Projekt jedoch fortgeschrittenes Reasoning erfordert und etwas längere Antwortzeiten verkraftet, ist das o1‑Modell die richtige Wahl.
Ich habe o1 über die OpenAI‑API ausprobiert und zeige dir in diesem Blog Schritt für Schritt, wie du das auch tust. Ich erkläre die Verbindung zur API, das Kostenmanagement und teile am Ende ein paar Prompting‑Tipps, um Ausgaben zu senken und bessere Antworten zu erhalten.
Wenn du einen stärker einführenden Artikel suchst, schau dir diesen OpenAI o1‑Guide an.
Hinweis: Zum Zeitpunkt dieses Tutorials sind die o1‑Modelle noch in der Beta. Der Verbindungsprozess zur API bleibt jedoch unverändert.
Eines der ersten Dinge: Derzeit erfordert der Zugriff auf die o1‑Modelle über die API ein Nutzungslevel Tier 5.
|
Tier |
Qualifikation |
Nutzungslimits |
|
Free |
User muss sich in einer zulässigen Region befinden |
$100 / Monat |
|
Tier 1 |
$5 bezahlt |
$100 / Monat |
|
Tier 2 |
$50 bezahlt und 7+ Tage seit der ersten erfolgreichen Zahlung |
$500 / Monat |
|
Tier 3 |
$100 bezahlt und 7+ Tage seit der ersten erfolgreichen Zahlung |
$1.000 / Monat |
|
Tier 4 |
$250 bezahlt und 14+ Tage seit der ersten erfolgreichen Zahlung |
$5.000 / Monat |
|
Tier 5 |
$1.000 bezahlt und 30+ Tage seit der ersten erfolgreichen Zahlung |
$50.000 / Monat |
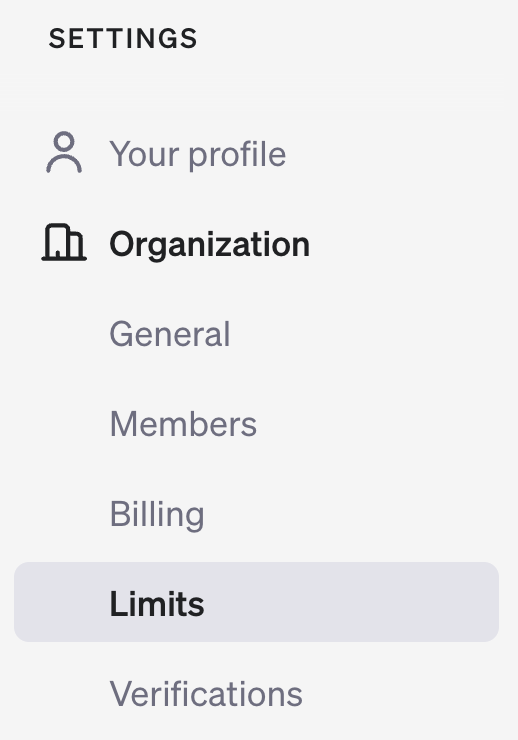
Um dein Tier zu prüfen, rufe deine Kontoseite auf der OpenAI Developer Platform auf und sieh im Bereich Limits unter Organization nach.
Jedes Tier hat eigene Ratenlimits. Zum Zeitpunkt dieses Artikels gelten für Tier 5 folgende Limits:
|
Modell |
RPM (Requests per Minute) |
TPM (Tokens per Minute) |
Batch-Queue-Limit |
|
gpt-4o |
10.000 |
30.000.000 |
5.000.000.000 |
|
gpt-4o-mini |
30.000 |
150.000.000 |
15.000.000.000 |
|
o1-preview |
500 |
30.000.000 |
derzeit nicht unterstützt |
|
o1-mini |
1.000 |
150.000.000 |
derzeit nicht unterstützt |
O1‑Modelle benötigen in der Inferenzphase deutlich mehr Zeit, was die niedrigeren RPM‑Limits im Vergleich zu GPT‑4o erklärt. Beachte: Batching wird für o1 derzeit nicht unterstützt, du kannst also keine mehreren Anfragen gleichzeitig bündeln.
Das O1‑Modell ist noch neu, daher können sich diese Voraussetzungen und Limits in den kommenden Wochen ändern. So hat OpenAI z. B. zuerst wöchentliche Limits von 30 Nachrichten für o1‑preview und 50 für o1‑mini angekündigt und wenige Tage später auf 50 Anfragen pro Woche für o1‑preview bzw. 50 pro Tag für o1‑mini aktualisiert.
Gleich geht es hands‑on weiter, aber zuerst klären wir ein neues, zentrales Konzept für die Nutzung von o1 über die API: Reasoning‑Tokens. Dieses Konzept ist entscheidend, um deine monatliche OpenAI‑Rechnung zu verstehen.
Wenn du o1‑preview über die ChatGPT‑Oberfläche genutzt hast, hast du gesehen, dass es vor der Antwort quasi „laut denkt“.
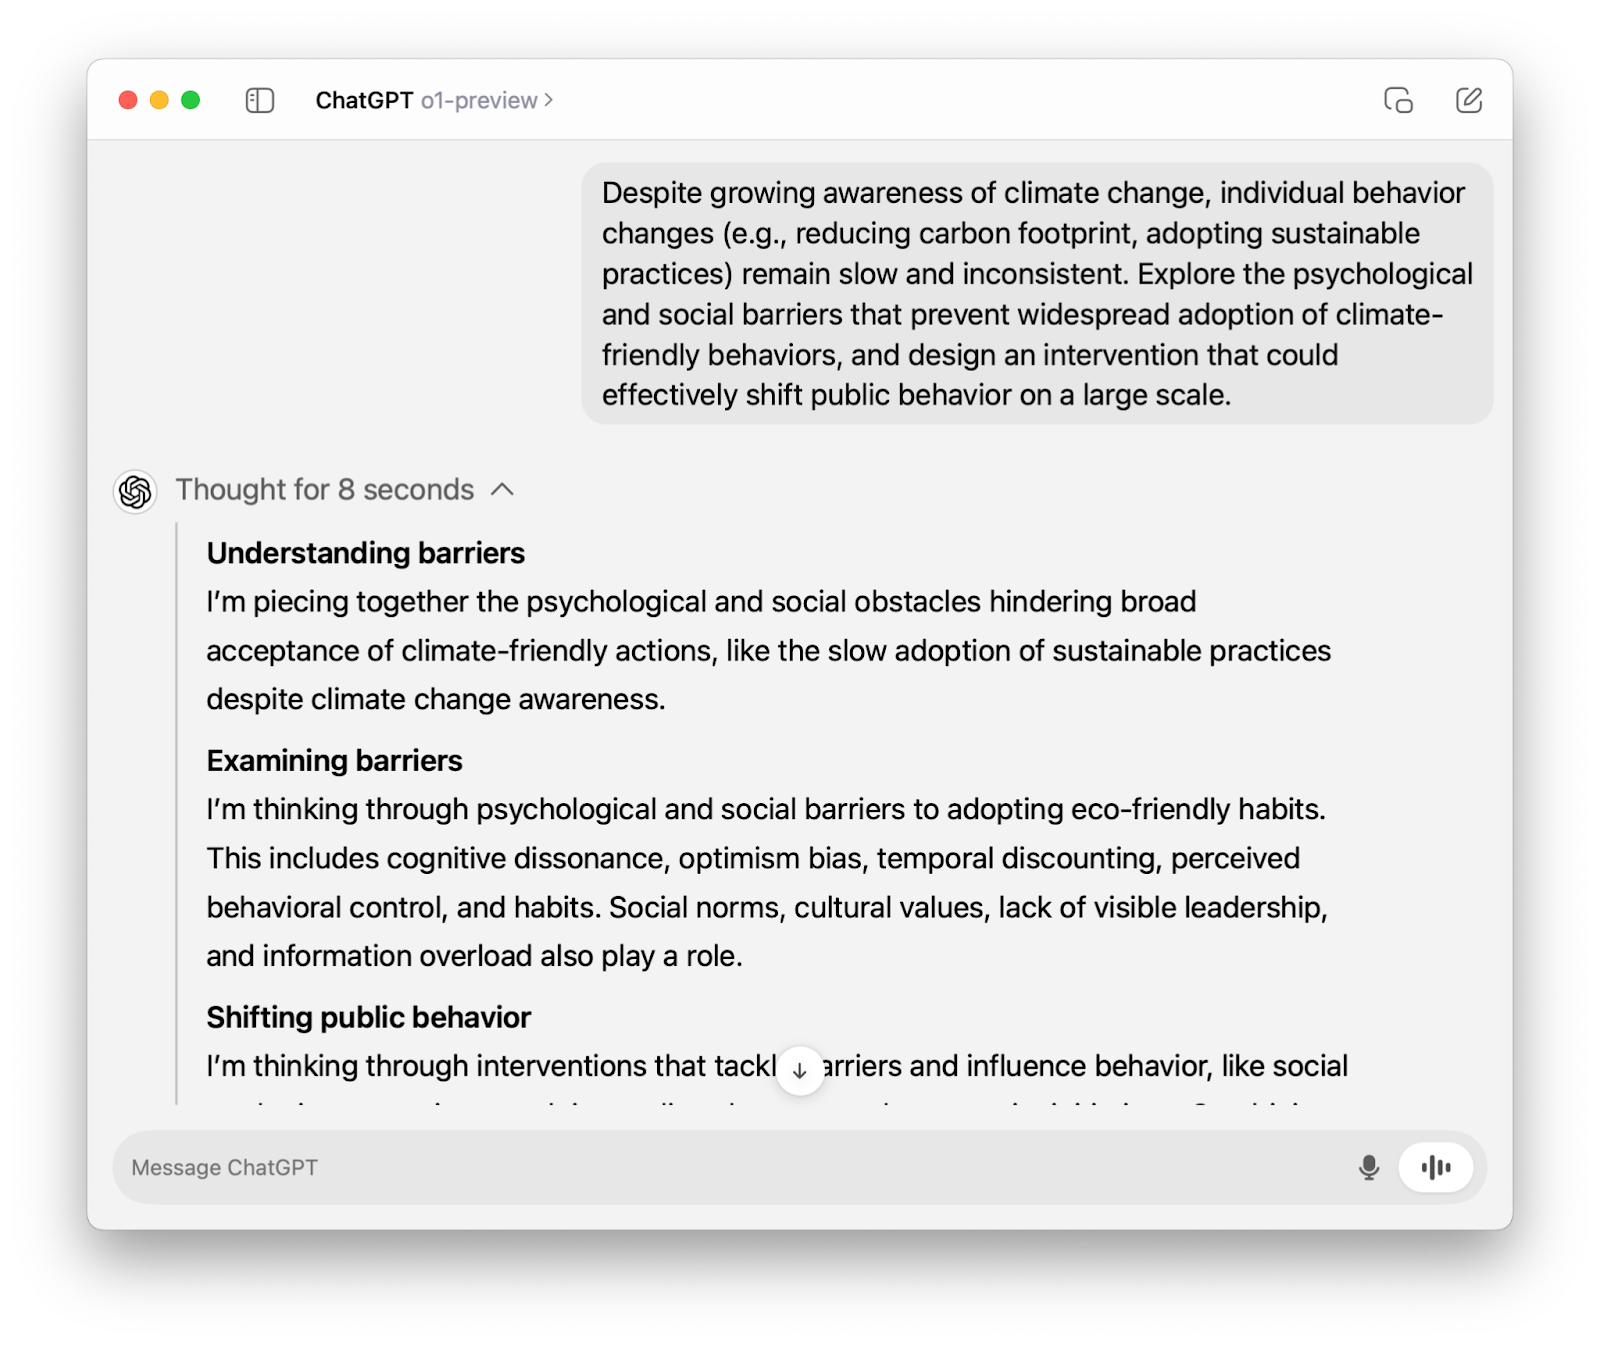
Über die API durchläuft o1 denselben Denkprozess. Der einzige Unterschied: Anders als in ChatGPT ist das Reasoning nicht sichtbar, du siehst nur die finale Antwort.
Das Reasoning wird jedoch tokenisiert (daher „Reasoning‑Tokens“) und ist — wie du dir denken kannst — kostenpflichtig. Reasoning‑Tokens werden als Output‑Tokens abgerechnet, die viermal teurer sind als Input‑Tokens.
Gleich sehen wir, wie du die Tokenanzahl steuern und Kosten managen kannst. Zunächst verbinden wir uns aber mit der OpenAI‑API, um die o1‑Modelle zu nutzen.
In diesem Abschnitt gehen wir die Schritte durch, um über die API eine Verbindung zum o1‑preview‑Modell herzustellen. Später zeigen wir auch die Verbindung zu o1‑mini.
Mit aktivem Konto erhältst du deinen geheimen API‑Schlüssel auf der API‑Key‑Seite von OpenAI.
Wenn du zu einer Organization gehörst, brauchst du eventuell zusätzlich deren ID und eine Projekt‑ID, damit dein Team Kosten besser zuordnen kann. Kläre das ggf. intern ab.
Egal ob API‑Neuling oder erfahrene Entwicklerin: Halte dich an Best Practices zur API‑Key‑Sicherheit.
openai-Bibliothek importierenOpenAI erleichtert die Nutzung der API mit der Python‑Bibliothek openai. Installation mit folgendem Befehl:
pip install openaiNach der Installation importieren wir die Klasse OpenAI aus der Bibliothek openai:
from openai import OpenAIZur Interaktion mit der OpenAI‑API initialisieren wir einen Client mit unserem geheimen API‑Key:
client = OpenAI(api_key=’your-api-key’)Wenn du zu einer Organization gehörst, brauchst du möglicherweise zusätzlich die Organization‑ID und eine Projekt‑ID. So könnte der Schritt bei dir aussehen:
client = OpenAI(
    organization=’your-organization-id’,
    project=’your-project-id’,
    api_key=’your-api-key’
)Zum Zeitpunkt dieses Artikels sind o-1 preview und o1-mini verfügbar. Beide erreichst du über den Endpoint chat.completions. Beachte im Code unten:
client.chat.completions.create() auf.model den String ”o1-preview”.”content”.response.choices[0].message.content zu.response = client.chat.completions.create(
model="o1-preview",
messages=[
{
"role": "user",
"content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
}
]
)
print(response.choices[0].message.content)```python
import ast
# Read the input string
s = input()
# Add outer brackets to make it a valid list representation
input_str = '[' + s + ']'
# Safely evaluate the string to a list of lists
matrix = ast.literal_eval(input_str)
# Transpose the matrix
transposed = list(map(list, zip(*matrix)))
# Convert the transposed matrix back to the required string format
transposed_str = ','.join('[' + ','.join(map(str, row)) + ']' for row in transposed)
# Print the result
print(transposed_str)
```Wie erwähnt, zählen die unsichtbaren Gedankenschritte als abrechenbare Tokens. Für den obigen Code sieht die Aufschlüsselung so aus:
print(response.usage)CompletionUsage(completion_tokens=1279, prompt_tokens=43, total_tokens=1322, completion_tokens_details={'reasoning_tokens': 1024})Aus dem Output sehen wir 1.024 Reasoning‑Tokens: completion_tokens_details={'reasoning_tokens': 1024}.
Das Modell hat 1.279 Tokens für die Completion erzeugt (completion_tokens=1279), davon 1.024 unsichtbare Reasoning‑Tokens — rund 80 %!
Mit den neuen o1‑Modellen wird das Kostenmanagement komplexer. Schauen wir uns das genauer an.
Bisher nutzten wir den Parameter max_tokens, um die Anzahl der Completion‑Tokens zu begrenzen. Das war einfach: erzeugte Tokens = sichtbare Tokens.
Bei o1 brauchen wir jedoch eine Obergrenze für alle Completion‑Tokens, also sichtbare Output‑Tokens und unsichtbare Reasoning‑Tokens. Daher hat OpenAI den Parameter max_completion_tokens eingeführt, max_tokens deprecatet und für o1 inkompatibel gemacht.
Testen wir max_completion_tokens mit unserem Beispiel und setzen ihn auf 300. Achtung: Dafür brauchst du ggf. ein Update der openai‑Bibliothek, wenn du eine ältere Version nutzt.
response_with_limit = client.chat.completions.create(
    model="o1-preview",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
        }
    ],
    max_completion_tokens=300
)
print(response_with_limit.choices[0].message.content) Achte darauf: Wir haben keinen Output erhalten. Zahlen wir trotzdem? Die Antwort ist ja.
print(response_with_limit.usage)CompletionUsage(completion_tokens=300, prompt_tokens=43, total_tokens=343, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=300))Wenn o1 das Tokenlimit erreicht, bevor es eine finale Antwort hat, stoppt es das Reasoning und liefert keinen Output. Deshalb ist es wichtig, max_completion_tokens so zu wählen, dass Output gewährleistet ist — sonst zahlen wir für Reasoning‑ und Input‑Tokens, ohne etwas zu erhalten.
Den genauen Wert musst du je nach Use Case testen, aber OpenAI empfiehlt, mindestens 25.000 Tokens für die Completion insgesamt zu reservieren.
Um abgeschnittenen Output (oder gar keinen) zu vermeiden, behalte auch das Kontextfenster im Blick, wenn viele Tokens im Spiel sind. o1‑preview und o1‑mini haben ein Kontextfenster von 128.000 Tokens. Allerdings sind die Output‑Tokens (sichtbar und unsichtbar) bei o1‑preview auf 32.768 und bei o1‑mini auf 65.536 Tokens begrenzt.
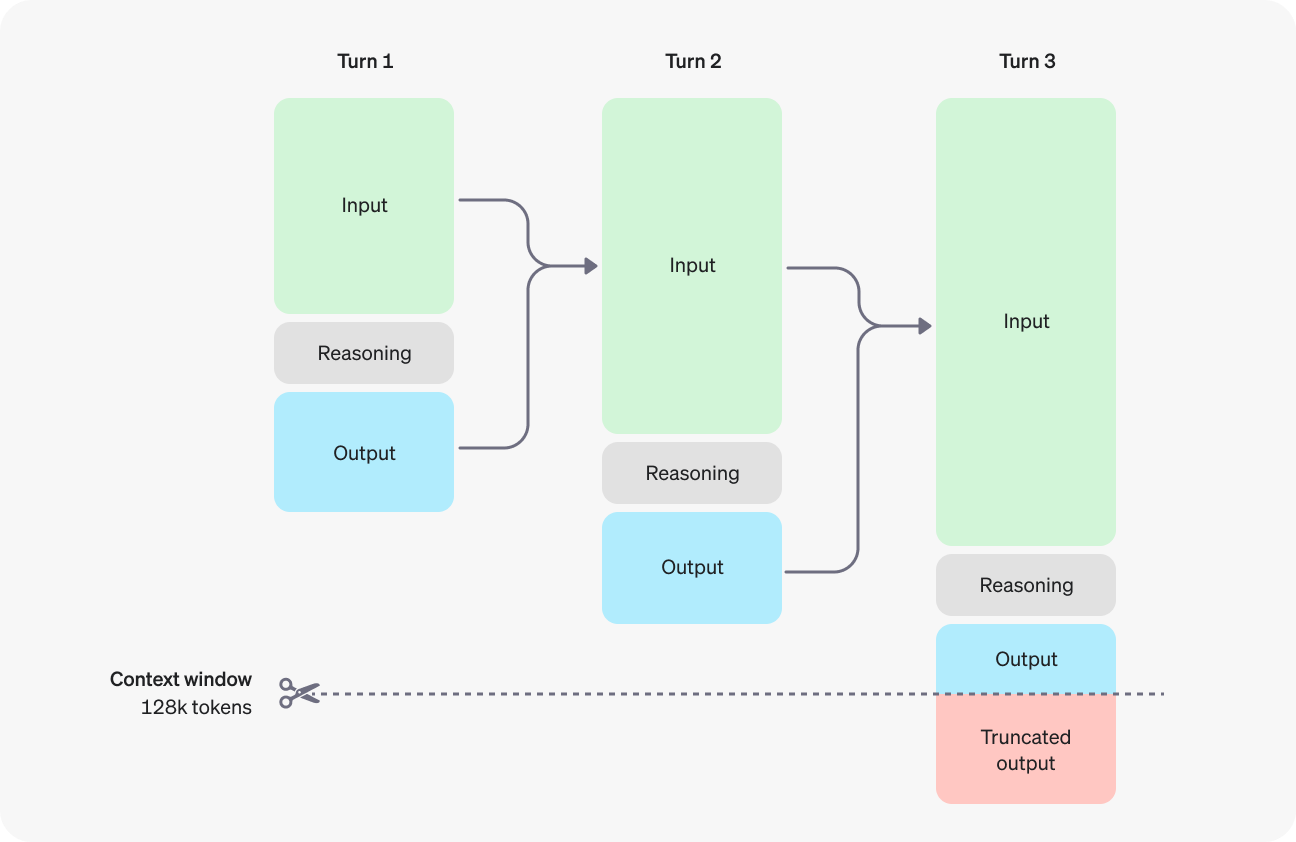
Quelle: OpenAI
Das große o1 ist stark im fortgeschrittenen Reasoning, aber sehr langsam. Wenn du für deine Anwendung schnellere Antworten brauchst und leichte Abstriche beim Reasoning akzeptierst, ist o1‑mini oft die bessere Wahl.
Für die Verbindung zu o1‑mini folgst du denselben Schritten wie bei o1‑preview — außer dass du beim Parameter model den String ”o1-mini” setzt.
Wir nutzen denselben Prompt wie zuvor, um die Token‑Nutzung zu vergleichen:
response_mini = client.chat.completions.create(
    model="o1-mini",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
        }
    ]
)
print(response_mini.choices[0].message.content)
Certainly! Below is a Python script that takes a matrix represented as a string in the format `'[1,2],[3,4],[5,6]'`, computes its transpose, and prints the transposed matrix in the same string format.
```python
def parse_matrix(matrix_str):
"""
Parses a matrix string like '[1,2],[3,4],[5,6]' into a list of lists.
"""
# Split the string by '],[' to separate the rows
rows = matrix_str.strip().split('],[')
# Clean the first and last elements by removing any leading '[' or trailing ']'
rows[0] = rows[0].lstrip('[')
rows[-1] = rows[-1].rstrip(']')
# Convert each row into a list of integers
matrix = []
for row in rows:
# Split each row by ',' and convert each element to integer
matrix.append([int(num) for num in row.split(',')])
return matrix
def transpose_matrix(matrix):
"""
Transposes a given matrix (list of lists).
"""
# Use zip with unpacking to transpose the matrix
transposed = list(zip(*matrix))
# Convert each tuple in the transposed matrix back to a list
transposed = [list(row) for row in transposed]
return transposed
def matrix_to_string(matrix):
"""
Converts a list of lists into a string format like '[1,3,5],[2,4,6]'.
"""
# Convert each row to a string
row_strings = []
for row in matrix:
# Convert each number to string and join with commas
row_str = ','.join(str(num) for num in row)
# Enclose the row in brackets
row_strings.append(f'[{row_str}]')
# Join all rows with commas
return ','.join(row_strings)
def main():
# Example input
input_str = '[1,2],[3,4],[5,6]'
# Parse the input string into a matrix
matrix = parse_matrix(input_str)
# Compute the transpose of the matrix
transposed = transpose_matrix(matrix)
# Convert the transposed matrix back to string format
output_str = matrix_to_string(transposed)
# Print the result
print(output_str)
if __name__ == "__main__":
main()
```
### How It Works:
1. **Parsing the Input String:**
- The `parse_matrix` function takes the input string and splits it into individual rows by looking for the pattern `"],["`.
- It cleans the first and last rows by removing any leading `[` or trailing `]`.
- Each row string is then split by `,` to extract individual numbers, which are converted to integers and stored in a nested list.
2. **Transposing the Matrix:**
- The `transpose_matrix` function uses the `zip` function along with unpacking (`*`) to transpose the matrix. This effectively switches rows with columns.
- Since `zip` returns tuples, each transposed row is converted back into a list.
3. **Converting Back to String:**
- The `matrix_to_string` function takes the transposed matrix and converts each row back into a string in the desired format.
- It joins the elements of each row with commas and encloses them in brackets.
- Finally, all row strings are joined together with commas to form the final output string.
4. **Main Execution:**
- The `main` function demonstrates the usage with an example input. You can modify `input_str` to test with different matrices.
- It prints the transposed matrix in the specified string format.
### Example:
Given the input string:
```
'[1,2],[3,4],[5,6]'
```
The script will output:
```
[1,3,5],[2,4,6]
```
### Handling User Input:
If you'd like the script to accept user input instead of having a hardcoded string, you can modify the `main` function as follows:
```python
def main():
# Take user input
input_str = input("Enter the matrix string (e.g., '[1,2],[3,4],[5,6]'): ").strip()
# Parse the input string into a matrix
matrix = parse_matrix(input_str)
# Compute the transpose of the matrix
transposed = transpose_matrix(matrix)
# Convert the transposed matrix back to string format
output_str = matrix_to_string(transposed)
# Print the result
print(output_str)
```
With this modification, when you run the script, it will prompt you to enter the matrix string:
```
Enter the matrix string (e.g., '[1,2],[3,4],[5,6]'): [1,2],[3,4],[5,6]
[1,3,5],[2,4,6]
```
### Notes:
- **Error Handling:** The current script assumes that the input string is well-formatted. For production code, you might want to add error handling to manage malformed inputs.
- **Non-integer Elements:** If your matrix contains non-integer elements (e.g., floats or strings), you'll need to adjust the parsing logic accordingly.
### Running the Script:
1. **Save the Script:** Save the above code to a file, say `transpose_matrix.py`.
2. **Run the Script:** Open a terminal or command prompt, navigate to the directory containing the script, and execute:
```bash
python transpose_matrix.py
```
3. **Provide Input:** If you've modified it to accept user input, enter the matrix string when prompted.
This script provides a straightforward way to transpose a matrix represented as a string and can be easily adapted or extended based on specific requirements.Der sichtbare Output ist deutlich ausführlicher als bei o1‑preview — vergleichen wir die Nutzung:
print(response_mini.usage) # o1-mini
print(response.usage) # o1-preview
CompletionUsage(completion_tokens=1511, prompt_tokens=43, total_tokens=1554, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=256))
CompletionUsage(completion_tokens=1279, prompt_tokens=43, total_tokens=1322, completion_tokens_details={'reasoning_tokens': 1024})o1‑mini „denkt“ viermal weniger als o1 (256 vs. 1.024 Reasoning‑Tokens). Wegen der ausführlicheren Antwort ist die Gesamtzahl der Completion‑Tokens jedoch größer. Auch wenn o1‑mini deutlich günstiger ist als o1‑preview, ist das nicht ideal.
Abhilfe schafft Prompt Engineering — wir weisen das Modell an, Erklärungen und Einleitungen zu vermeiden und nur die Antwort auszugeben.
response_mini_2 = client.chat.completions.create(
    model="o1-mini",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. Limit yourself to the answer and don't add explanations or introductions."
        }
    ]
)
print(response_mini_2.choices[0].message.content)
```python
import ast
def parse_matrix(matrix_str):
rows = matrix_str.split('],[')
rows[0] = rows[0].lstrip('[')
rows[-1] = rows[-1].rstrip(']')
matrix = [ast.literal_eval(f'[{row}]') for row in rows]
return matrix
def transpose(matrix):
return list(zip(*matrix))
def format_matrix(transposed):
return ','.join([f'[{",".join(map(str, row))}]' for row in transposed])
input_str = '[1,2],[3,4],[5,6]'
matrix = parse_matrix(input_str)
transposed = transpose(matrix)
output_str = format_matrix(transposed)
print(output_str)
```Viel besser! Die Gesamtzahl der Completion‑Tokens ist etwa dreimal geringer:
print(response_mini_2.usage)CompletionUsage(completion_tokens=487, prompt_tokens=55, total_tokens=542, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=320))Zum Zeitpunkt dieses Tutorials sind die o1‑Modelle in der Beta. OpenAI plant in den nächsten Wochen weitere Features und freundlichere Limits. Aktuell gelten folgende Einschränkungen:
temperature, top_p und n sind auf 1 fixiert, presence_penalty und frequency_penalty auf 0.Im Bereich fortgeschrittenes Reasoning hat OpenAI derzeit kaum Konkurrenz. Entsprechend sind die Preise eher hoch — und deutlich über den GPT‑4o‑Modellen:
|
Modell |
Preis |
|
o1-preview |
$15.00 / 1 M Input‑Tokens |
|
$60.00 / 1 M Output‑Tokens |
|
|
o1-mini |
$3.00 / 1 M Input‑Tokens |
|
$12.00 / 1 M Output‑Tokens |
|
|
gpt-4o |
$5.00 / 1 M Input‑Tokens |
|
$15.00 / 1 M Output‑Tokens |
|
|
gpt-4o-mini |
$0.150 / 1 M Input‑Tokens |
|
$0.600 / 1 M Output‑Tokens |
Die o1‑Modelle unterscheiden sich deutlich von Modellen wie GPT‑4o oder Claude 3.5 Sonnet. Da o1 bereits Chain‑of‑Thought intern nutzt, funktionieren klare, einfache Prompts am besten. Few‑Shot‑Prompts oder „Schritt für Schritt denken“ können die Leistung sogar verschlechtern.
Empfehlungen der Entwickler bei OpenAI:
In diesem Blog habe ich dir Schritt für Schritt gezeigt, wie du dich über die OpenAI‑API mit den o1‑Modellen verbindest.
Wenn dein Projekt fortgeschrittenes Reasoning erfordert und etwas längere Antwortzeiten okay sind, sind die o1‑Modelle eine sehr gute Option.
Für Anwendungen mit schnellen Antworten, Bildverarbeitung oder Function Calling bleiben GPT‑4o und GPT‑4o mini die bevorzugte Wahl.
Zum Weiterlernen empfehle ich diese Ressourcen:
Lerne KI mit diesen Kursen!
Kurs
Lernpfad
Kurs