
Corso
Prompt Engineering con l'API di OpenAI
4 ore
55.8K
OpenAI ha recentemente rilasciato il suo attesissimo modello capace di “ragionamento da dottorato”, e non è GPT-5, come molti pensavano: è il modello OpenAI o1.
Il modo in cui opera OpenAI o1 segna un importante cambio di paradigma nell'allocazione delle risorse computazionali, con maggiore enfasi sulle fasi di training e inferenza. Questo approccio lo rende straordinariamente efficace nei compiti di ragionamento complessi, ma anche molto più lento rispetto ai suoi “fratelli”, GPT-4o e GPT-4o mini.
Detto ciò, GPT-4o e GPT-4o mini restano le opzioni preferite per applicazioni che richiedono risposte rapide, gestione di immagini o function calling. Tuttavia, se il tuo progetto richiede capacità avanzate di ragionamento e può tollerare tempi di risposta leggermente più lunghi, il modello o1 è la scelta giusta.
Ho avuto modo di esplorare o1 tramite l'API di OpenAI e, in questo blog, ti guiderò passo dopo passo su come fare lo stesso. Ti mostrerò come connetterti all'API, gestire i costi e, alla fine, condividerò alcuni consigli di prompting per aiutarti a ridurre le spese e ottenere risposte migliori.
Se cerchi un articolo più introduttivo, dai un'occhiata a questa Guida a OpenAI o1.
Nota: Al momento della stesura di questo tutorial, i modelli o1 sono ancora in beta. Tuttavia, il processo per connettersi all'API resta lo stesso.
Una delle prime cose da sapere è che, per ora, l'accesso ai modelli o1 tramite API richiede un livello di utilizzo Tier 5.
|
Tier |
Qualificazione |
Limiti d'uso |
|
Free |
L'utente deve trovarsi in una geografia consentita |
$100 / mese |
|
Tier 1 |
$5 pagati |
$100 / mese |
|
Tier 2 |
$50 pagati e 7+ giorni dal primo pagamento riuscito |
$500 / mese |
|
Tier 3 |
$100 pagati e 7+ giorni dal primo pagamento riuscito |
$1.000 / mese |
|
Tier 4 |
$250 pagati e 14+ giorni dal primo pagamento riuscito |
$5.000 / mese |
|
Tier 5 |
$1.000 pagati e 30+ giorni dal primo pagamento riuscito |
$50.000 / mese |
Per verificare il tuo tier di utilizzo, vai alla pagina del tuo account sulla piattaforma sviluppatori di OpenAI e guarda nella sezione Limits sotto Organization.
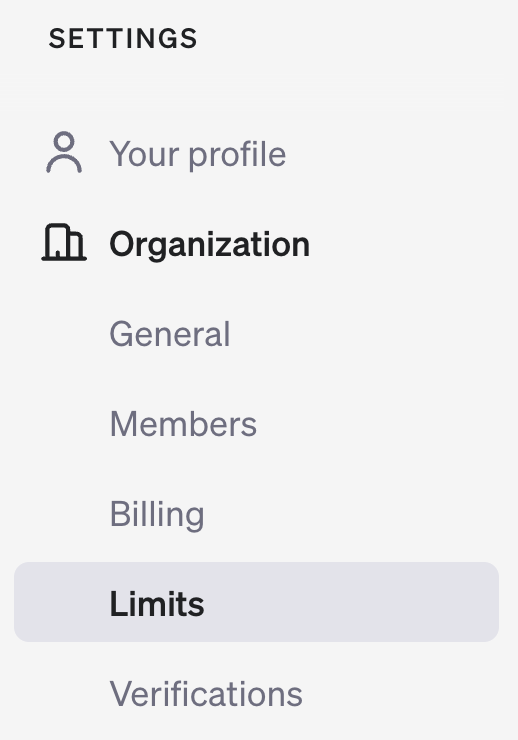
Ogni tier di utilizzo ha specifici rate limit. Alla data di stesura di questo articolo, questi sono i rate limit per il Tier 5:
|
Modello |
RPM (Richieste al minuto) |
TPM (Token al minuto) |
Limite coda batch |
|
gpt-4o |
10.000 |
30.000.000 |
5.000.000.000 |
|
gpt-4o-mini |
30.000 |
150.000.000 |
15.000.000.000 |
|
o1-preview |
500 |
30.000.000 |
al momento non supportato |
|
o1-mini |
1000 |
150.000.000 |
al momento non supportato |
I modelli O1 richiedono un notevole tempo di elaborazione nella fase di inferenza, il che spiega i limiti RPM più bassi rispetto ai modelli GPT-4o. Nota che il batching al momento non è supportato per i modelli o1, quindi non puoi raggruppare (batch) più richieste al modello contemporaneamente.
Il modello O1 è ancora nuovo, quindi questi requisiti e rate limit potrebbero cambiare nelle prossime settimane. Ad esempio, OpenAI aveva inizialmente annunciato che i rate limit settimanali sarebbero stati 30 messaggi per o1-preview e 50 per o1-mini. Tuttavia, pochi giorni dopo, hanno aggiornato i limiti a 50 query a settimana per o1-preview e 50 query al giorno per o1-mini.
Tra poco passeremo alla pratica, ma prima chiariremo un concetto nuovo, fondamentale per usare o1 tramite API: i reasoning token. Capire questo concetto è essenziale per comprendere la tua bolletta mensile di OpenAI.
Se hai usato o1-preview tramite l'interfaccia ChatGPT, avrai notato che “pensa ad alta voce” prima di generare una risposta.
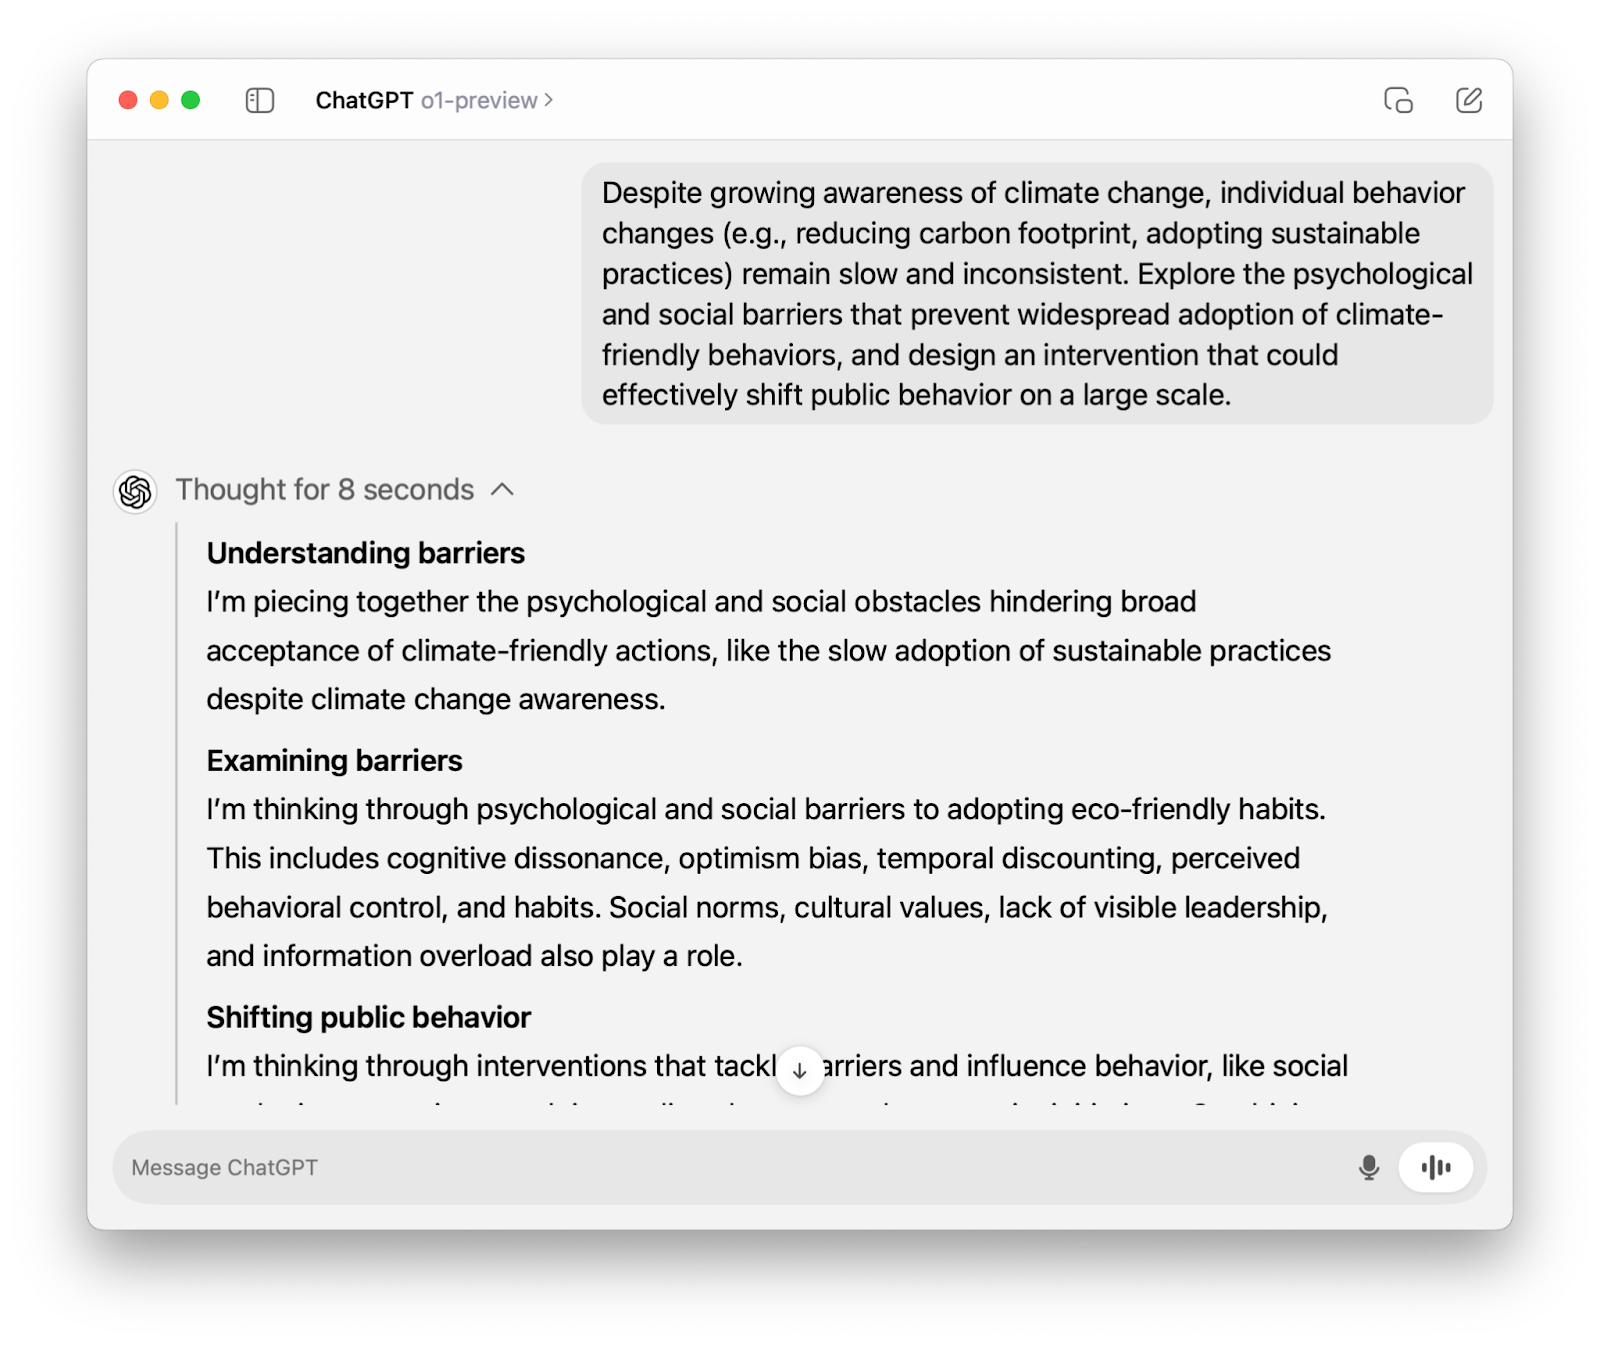
Quando usiamo il modello o1 tramite API, attraversa lo stesso processo di pensiero. L'unica differenza è che, a differenza dell'interfaccia ChatGPT, il ragionamento non è visibile e vediamo solo la risposta finale.
Tuttavia, il ragionamento è comunque tokenizzato (da qui il nome “reasoning token”) e, come avrai intuito, è fatturabile. I reasoning token sono fatturati come token di output, che costano quattro volte più degli input token.
Tra poco vedremo come controllare il numero di token e gestire i costi, ma per ora concentriamoci sulla connessione all' API di OpenAI per usare i modelli o1.
In questa sezione, elencheremo una serie di passaggi per aiutarti a connetterti al modello o1-preview tramite API. Più avanti, vedremo anche come connettersi al modello o1-mini.
Se hai un account attivo, puoi ottenere la tua chiave API segreta dalla pagina delle chiavi API di OpenAI.
Se fai parte di un'organizzazione, potresti aver bisogno anche dell'ID dell'organizzazione e di un ID progetto, che possono aiutare il tuo team a gestire meglio i costi. Verifica con il tuo team.
Che tu sia alle prime armi con le API o uno sviluppatore esperto, è sempre una buona idea seguire le best practice per le API.
openaiOpenAI rende semplice interagire con la sua API tramite la sua libreria Python openai. Puoi installarla con il seguente comando:
pip install openaiUna volta installata, importiamo la classe OpenAI dalla libreria openai:
from openai import OpenAIPer interagire con l'API di OpenAI, inizializziamo un client usando la nostra chiave API segreta:
client = OpenAI(api_key=’your-api-key’)Se fai parte di un'organizzazione, potresti aver bisogno anche dell'ID dell'organizzazione e di un ID progetto; ecco come potrebbe apparire questo passaggio per te:
client = OpenAI(
    organization=’your-organization-id’,
    project=’your-project-id’,
    api_key=’your-api-key’
)Gli unici modelli o1 disponibili al momento della stesura di questo articolo sono o-1 preview e o1-mini. Entrambi sono disponibili tramite l'endpoint chat.completions. Nel codice qui sotto, nota che:
client.chat.completions.create()."o1-preview" per il parametro model."content".response.choices[0].message.content.response = client.chat.completions.create(
model="o1-preview",
messages=[
{
"role": "user",
"content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
}
]
)
print(response.choices[0].message.content)```python
import ast
# Read the input string
s = input()
# Add outer brackets to make it a valid list representation
input_str = '[' + s + ']'
# Safely evaluate the string to a list of lists
matrix = ast.literal_eval(input_str)
# Transpose the matrix
transposed = list(map(list, zip(*matrix)))
# Convert the transposed matrix back to the required string format
transposed_str = ','.join('[' + ','.join(map(str, row)) + ']' for row in transposed)
# Print the result
print(transposed_str)
```Come accennato, il ragionamento “sotto il cofano” conta comunque come token fatturabili. Per il codice eseguito sopra, ecco il dettaglio di tutti i token usati:
print(response.usage)CompletionUsage(completion_tokens=1279, prompt_tokens=43, total_tokens=1322, completion_tokens_details={'reasoning_tokens': 1024})Esaminando l'output, vediamo che il numero di reasoning token è 1024: completion_tokens_details={'reasoning_tokens': 1024}.
Il modello ha generato un completamento usando 1279 token (completion_tokens=1279), di cui 1024 erano reasoning token invisibili: circa l'80%!
La gestione dei costi diventa un po' più complicata con i nuovi modelli o1, quindi approfondiamo.
Con i modelli precedenti usavamo il parametro max_tokens per controllare il numero di token di completamento. Era piuttosto semplice: il numero di token generati e quello dei token visibili coincidevano sempre.
Con i modelli o1, invece, ci serve un parametro che imposti un limite superiore su tutti i token di completamento, inclusi i token di output visibili e i reasoning token invisibili. Per questo motivo, OpenAI ha aggiunto il parametro max_completion_tokens, deprecando max_tokens e rendendolo incompatibile con i modelli o1.
Proviamo max_completion_tokens con il nostro esempio precedente. Lo imposteremo a 300 e vediamo cosa otteniamo. Per usare questo nuovo parametro, potresti dover aggiornare la libreria openai se stai usando versioni più vecchie.
response_with_limit = client.chat.completions.create(
    model="o1-preview",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
        }
    ],
    max_completion_tokens=300
)
print(response_with_limit.choices[0].message.content) Nota che non abbiamo ottenuto alcun output. Ma stiamo comunque pagando? La risposta è sì.
print(response_with_limit.usage)CompletionUsage(completion_tokens=300, prompt_tokens=43, total_tokens=343, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=300))Se il modello o1 raggiunge il limite di token prima di arrivare a una risposta finale, interrompe il processo di ragionamento e non restituisce alcun output. Per questo è importante impostare max_completion_tokens a un valore che garantisca l'output, altrimenti pagheremo sia i reasoning token sia gli input token senza ottenere nulla in cambio.
Dovrai sperimentare il valore esatto di max_completion_tokens in base al tuo caso d'uso, ma OpenAI consiglia di riservare almeno 25.000 token per il numero totale di completion token.
Per evitare output troncati (o assenti), dovrai anche tenere d'occhio la context window se il tuo caso d'uso coinvolge un gran numero di token. I modelli o1-preview e o-1 mini hanno una context window di 128.000 token. Nota però che i token di output (visibili e invisibili) sono limitati a 32.768 per o1-preview e 65.536 per o1-mini.
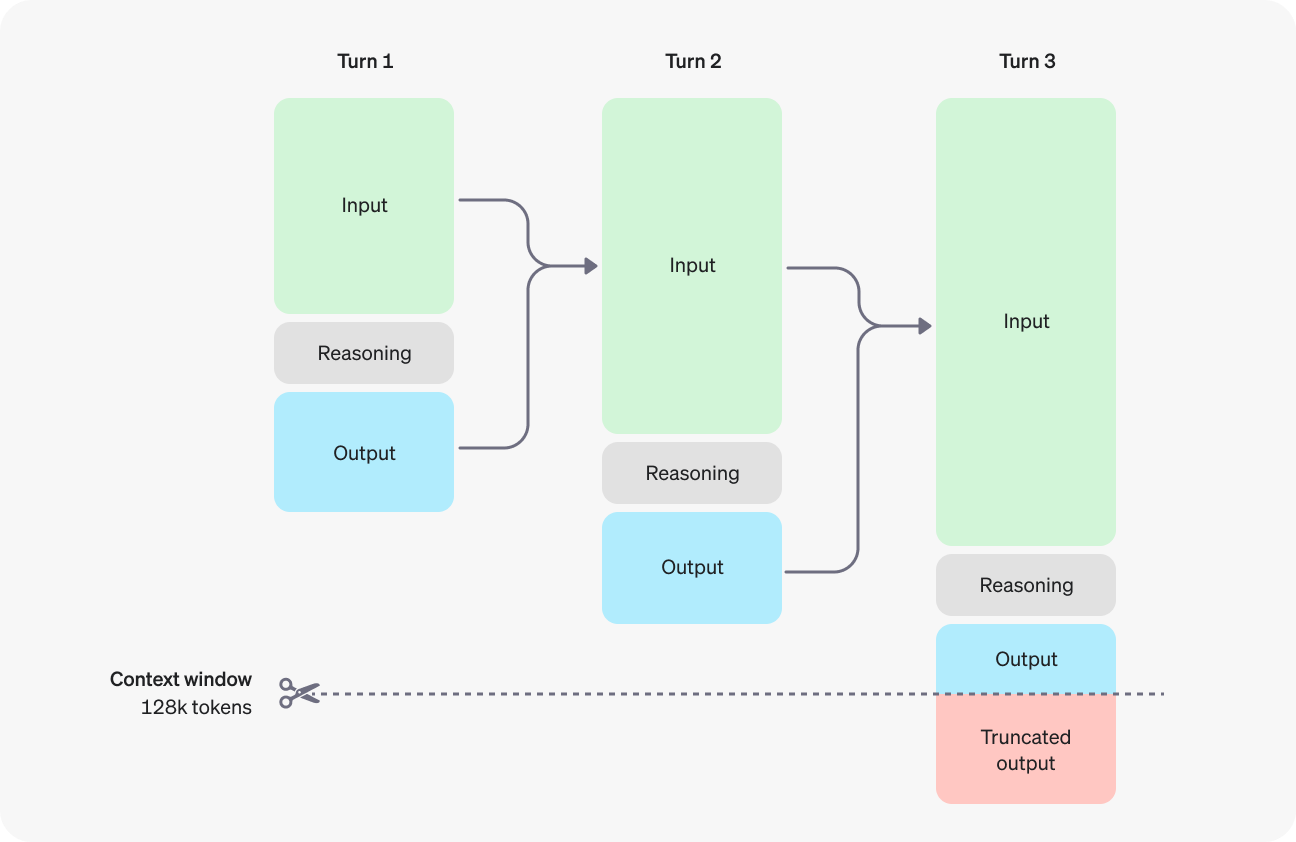
Fonte: OpenAI
Il grande modello o1 è potente nel ragionamento avanzato, ma è anche molto lento. Se ti servono tempi di risposta più rapidi per le tue applicazioni e sei disposto a un piccolo compromesso nelle prestazioni di ragionamento, allora il modello o1-mini potrebbe essere una scelta migliore.
Per connetterti al modello o1-mini tramite API, segui tutti i passaggi visti per il modello o1-preview, tranne il parametro model, dove devi usare la stringa "o1-mini".
Useremo lo stesso prompt dell'esempio precedente, così possiamo confrontare l'uso dei token:
response_mini = client.chat.completions.create(
    model="o1-mini",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
        }
    ]
)
print(response_mini.choices[0].message.content)
Certainly! Below is a Python script that takes a matrix represented as a string in the format `'[1,2],[3,4],[5,6]'`, computes its transpose, and prints the transposed matrix in the same string format.
```python
def parse_matrix(matrix_str):
"""
Parses a matrix string like '[1,2],[3,4],[5,6]' into a list of lists.
"""
# Split the string by '],[' to separate the rows
rows = matrix_str.strip().split('],[')
# Clean the first and last elements by removing any leading '[' or trailing ']'
rows[0] = rows[0].lstrip('[')
rows[-1] = rows[-1].rstrip(']')
# Convert each row into a list of integers
matrix = []
for row in rows:
# Split each row by ',' and convert each element to integer
matrix.append([int(num) for num in row.split(',')])
return matrix
def transpose_matrix(matrix):
"""
Transposes a given matrix (list of lists).
"""
# Use zip with unpacking to transpose the matrix
transposed = list(zip(*matrix))
# Convert each tuple in the transposed matrix back to a list
transposed = [list(row) for row in transposed]
return transposed
def matrix_to_string(matrix):
"""
Converts a list of lists into a string format like '[1,3,5],[2,4,6]'.
"""
# Convert each row to a string
row_strings = []
for row in matrix:
# Convert each number to string and join with commas
row_str = ','.join(str(num) for num in row)
# Enclose the row in brackets
row_strings.append(f'[{row_str}]')
# Join all rows with commas
return ','.join(row_strings)
def main():
# Example input
input_str = '[1,2],[3,4],[5,6]'
# Parse the input string into a matrix
matrix = parse_matrix(input_str)
# Compute the transpose of the matrix
transposed = transpose_matrix(matrix)
# Convert the transposed matrix back to string format
output_str = matrix_to_string(transposed)
# Print the result
print(output_str)
if __name__ == "__main__":
main()
```
### How It Works:
1. **Parsing the Input String:**
- The `parse_matrix` function takes the input string and splits it into individual rows by looking for the pattern `"],["`.
- It cleans the first and last rows by removing any leading `[` or trailing `]`.
- Each row string is then split by `,` to extract individual numbers, which are converted to integers and stored in a nested list.
2. **Transposing the Matrix:**
- The `transpose_matrix` function uses the `zip` function along with unpacking (`*`) to transpose the matrix. This effectively switches rows with columns.
- Since `zip` returns tuples, each transposed row is converted back into a list.
3. **Converting Back to String:**
- The `matrix_to_string` function takes the transposed matrix and converts each row back into a string in the desired format.
- It joins the elements of each row with commas and encloses them in brackets.
- Finally, all row strings are joined together with commas to form the final output string.
4. **Main Execution:**
- The `main` function demonstrates the usage with an example input. You can modify `input_str` to test with different matrices.
- It prints the transposed matrix in the specified string format.
### Example:
Given the input string:
```
'[1,2],[3,4],[5,6]'
```
The script will output:
```
[1,3,5],[2,4,6]
```
### Handling User Input:
If you'd like the script to accept user input instead of having a hardcoded string, you can modify the `main` function as follows:
```python
def main():
# Take user input
input_str = input("Enter the matrix string (e.g., '[1,2],[3,4],[5,6]'): ").strip()
# Parse the input string into a matrix
matrix = parse_matrix(input_str)
# Compute the transpose of the matrix
transposed = transpose_matrix(matrix)
# Convert the transposed matrix back to string format
output_str = matrix_to_string(transposed)
# Print the result
print(output_str)
```
With this modification, when you run the script, it will prompt you to enter the matrix string:
```
Enter the matrix string (e.g., '[1,2],[3,4],[5,6]'): [1,2],[3,4],[5,6]
[1,3,5],[2,4,6]
```
### Notes:
- **Error Handling:** The current script assumes that the input string is well-formatted. For production code, you might want to add error handling to manage malformed inputs.
- **Non-integer Elements:** If your matrix contains non-integer elements (e.g., floats or strings), you'll need to adjust the parsing logic accordingly.
### Running the Script:
1. **Save the Script:** Save the above code to a file, say `transpose_matrix.py`.
2. **Run the Script:** Open a terminal or command prompt, navigate to the directory containing the script, and execute:
```bash
python transpose_matrix.py
```
3. **Provide Input:** If you've modified it to accept user input, enter the matrix string when prompted.
This script provides a straightforward way to transpose a matrix represented as a string and can be easily adapted or extended based on specific requirements.L'output visibile è molto più verboso rispetto a quello di o1-preview: confrontiamo l'utilizzo:
print(response_mini.usage) # o1-mini
print(response.usage) # o1-preview
CompletionUsage(completion_tokens=1511, prompt_tokens=43, total_tokens=1554, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=256))
CompletionUsage(completion_tokens=1279, prompt_tokens=43, total_tokens=1322, completion_tokens_details={'reasoning_tokens': 1024})Il modello o1-mini ragiona quattro volte meno rispetto al modello o1 (256 vs 1024 reasoning token). Tuttavia, a causa della risposta prolissa, il numero totale di completion token è in realtà maggiore. Anche se o1-mini è significativamente più economico di o1-preview, questo non è comunque ideale.
Un modo per mitigare è il prompt engineering: istruiremo il modello a evitare spiegazioni e introduzioni e a limitare l'output alla sola risposta.
response_mini_2 = client.chat.completions.create(
    model="o1-mini",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. Limit yourself to the answer and don't add explanations or introductions."
        }
    ]
)
print(response_mini_2.choices[0].message.content)
```python
import ast
def parse_matrix(matrix_str):
rows = matrix_str.split('],[')
rows[0] = rows[0].lstrip('[')
rows[-1] = rows[-1].rstrip(']')
matrix = [ast.literal_eval(f'[{row}]') for row in rows]
return matrix
def transpose(matrix):
return list(zip(*matrix))
def format_matrix(transposed):
return ','.join([f'[{",".join(map(str, row))}]' for row in transposed])
input_str = '[1,2],[3,4],[5,6]'
matrix = parse_matrix(input_str)
transposed = transpose(matrix)
output_str = format_matrix(transposed)
print(output_str)
```Molto meglio! Il numero totale di completion token è circa tre volte inferiore:
print(response_mini_2.usage)CompletionUsage(completion_tokens=487, prompt_tokens=55, total_tokens=542, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=320))Al momento della stesura di questo tutorial, i modelli o1 sono ancora in beta. Sebbene OpenAI abbia annunciato nuove funzionalità e rate limit più favorevoli nelle prossime settimane, ecco le limitazioni che incontrerai usando i modelli o1 in beta:
temperature, top_p e n sono fissati a 1, mentre sia presence_penalty sia frequency_penalty sono impostati a 0.Al momento, OpenAI non sembra avere molta concorrenza nell'ambito del ragionamento avanzato. Di conseguenza, i prezzi sono forse un po' gonfiati e, come puoi vedere, significativamente più alti rispetto ai modelli GPT-4o:
|
Modello |
Prezzo |
|
o1-preview |
$15,00 / 1M token di input |
|
$60,00 / 1M token di output |
|
|
o1-mini |
$3,00 / 1M token di input |
|
$12,00 / 1M token di output |
|
|
gpt-4o |
$5,00 / 1M token di input |
|
$15,00 / 1M token di output |
|
|
gpt-4o-mini |
$0,150 / 1M token di input |
|
$0,600 / 1M token di output |
I modelli o1 sono molto diversi dai modelli a cui siamo abituati, come GPT-4o o Claude 3.5 Sonnet. Poiché i modelli o1 effettuano già un ragionamento a catena di pensieri (chain-of-thought), lavorano meglio con prompt semplici e diretti. Usare few-shot prompting o chiedere al modello di pensare “passo dopo passo” può in realtà peggiorarne le prestazioni.
Ecco alcune best practice di prompting raccomandate dagli sviluppatori di OpenAI:
In questo blog ho condiviso una guida passo-passo per connettersi ai modelli o1 tramite l'API di OpenAI.
Se il tuo progetto richiede capacità avanzate di ragionamento e può accettare tempi di risposta leggermente più lunghi, i modelli o1 sono un'ottima scelta.
Per applicazioni che richiedono risposte rapide, elaborazione di immagini o function calling, GPT-4o e GPT-4o mini restano le scelte preferite.
Per continuare a imparare, ti consiglio queste risorse:
Impara l'IA con questi corsi!
Corso
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



