
Cursus
Prompt Engineering met de OpenAI API
4 uur
55.8K
OpenAI heeft onlangs het langverwachte model gelanceerd dat in staat is tot “PhD-reasoning”, en het is niet GPT-5, zoals velen van ons dachten—het is het OpenAI o1-model.
De manier waarop OpenAI o1 werkt, markeert een belangrijke paradigmaverschuiving in de toewijzing van rekenbronnen, met meer nadruk op de trainings- en inferencefase. Deze aanpak maakt het uitzonderlijk goed in complexe redeneertaken, maar ook erg traag vergeleken met zijn broers, GPT-4o en GPT-4o mini.
Dat gezegd hebbende, GPT-4o en GPT-4o mini blijven de voorkeursopties voor toepassingen die snelle reacties, afhandeling van afbeeldingen of function calling vereisen. Maar als je project geavanceerde redeneercapaciteiten vraagt en iets langere reactietijden kan tolereren, is het o1-model de juiste keuze.
Ik heb de kans gehad om o1 te verkennen via de API van OpenAI, en in deze blog geef ik stapsgewijze uitleg over hoe je dat doet. Ik laat je zien hoe je verbinding maakt met de API, kosten beheert, en aan het einde deel ik een paar prompting-tips om je uitgaven te beperken en betere antwoorden te krijgen.
Zoek je een meer inleidend artikel? Bekijk dan deze OpenAI o1-gids.
Opmerking: Op het moment van schrijven van deze tutorial zijn de o1-modellen nog in bèta. Het proces om verbinding te maken met de API blijft echter hetzelfde.
Een van de eerste dingen die je moet weten, is dat toegang tot de o1-modellen via de API voor nu een Tier 5-gebruikersniveau vereist.
|
Tier |
Kwalificatie |
Gebruikslimieten |
|
Free |
Gebruiker moet zich in een toegestane regio bevinden |
$100 / maand |
|
Tier 1 |
$5 betaald |
$100 / maand |
|
Tier 2 |
$50 betaald en 7+ dagen sinds de eerste geslaagde betaling |
$500 / maand |
|
Tier 3 |
$100 betaald en 7+ dagen sinds de eerste geslaagde betaling |
$1.000 / maand |
|
Tier 4 |
$250 betaald en 14+ dagen sinds de eerste geslaagde betaling |
$5.000 / maand |
|
Tier 5 |
$1.000 betaald en 30+ dagen sinds de eerste geslaagde betaling |
$50.000 / maand |
Om je gebruiksniveau te controleren, ga je naar je accountpagina op het OpenAI-ontwikkelaarsplatform en kijk in de sectie Limits onder Organization.
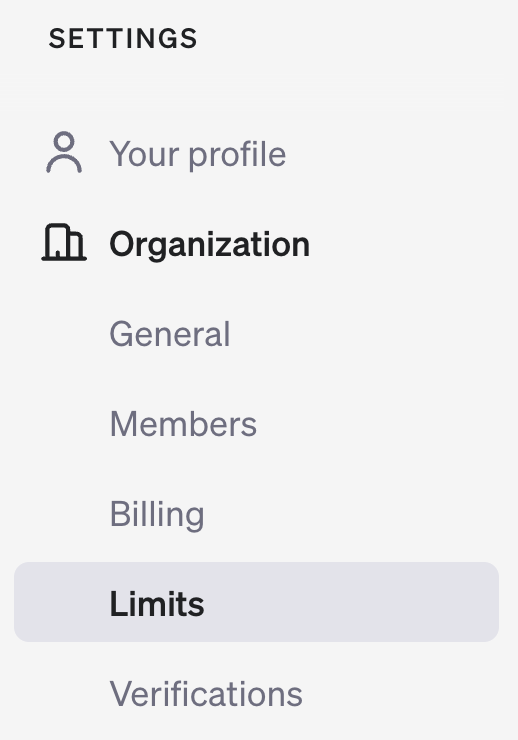
Elk gebruiksniveau heeft specifieke snelheidslimieten. Op het moment van schrijven zijn dit de Tier 5-limieten:
|
Model |
RPM (Requests per Minute) |
TPM (Tokens per Minute) |
Batchwachtrijlimiet |
|
gpt-4o |
10.000 |
30.000.000 |
5.000.000.000 |
|
gpt-4o-mini |
30.000 |
150.000.000 |
15.000.000.000 |
|
o1-preview |
500 |
30.000.000 |
momenteel niet ondersteund |
|
o1-mini |
1000 |
150.000.000 |
momenteel niet ondersteund |
O1-modellen hebben in de inferencefase aanzienlijk meer verwerkingstijd nodig, wat de lagere RPM-limieten verklaart vergeleken met de GPT-4o-modellen. Let op dat batching momenteel niet wordt ondersteund voor o1-modellen, wat betekent dat je niet meerdere verzoeken tegelijk kunt groeperen (batchen) naar het model.
Het O1-model is nog nieuw, dus deze vereisten en limieten kunnen de komende weken veranderen. Zo kondigde OpenAI aanvankelijk aan dat de wekelijkse limieten 30 berichten voor o1-preview en 50 voor o1-mini zouden zijn. Enkele dagen later pasten ze dit aan naar 50 queries per week voor o1-preview en 50 queries per dag voor o1-mini.
We gaan zo praktisch aan de slag, maar eerst verduidelijken we een nieuw concept dat fundamenteel is bij het gebruik van o1 via de API: reasoning-tokens. Dit begrijpen is essentieel om je maandelijkse OpenAI-rekening te doorgronden.
Als je o1-preview hebt gebruikt via de ChatGPT-interface, heb je gezien dat het “hardop nadenkt” voordat het een antwoord genereert.
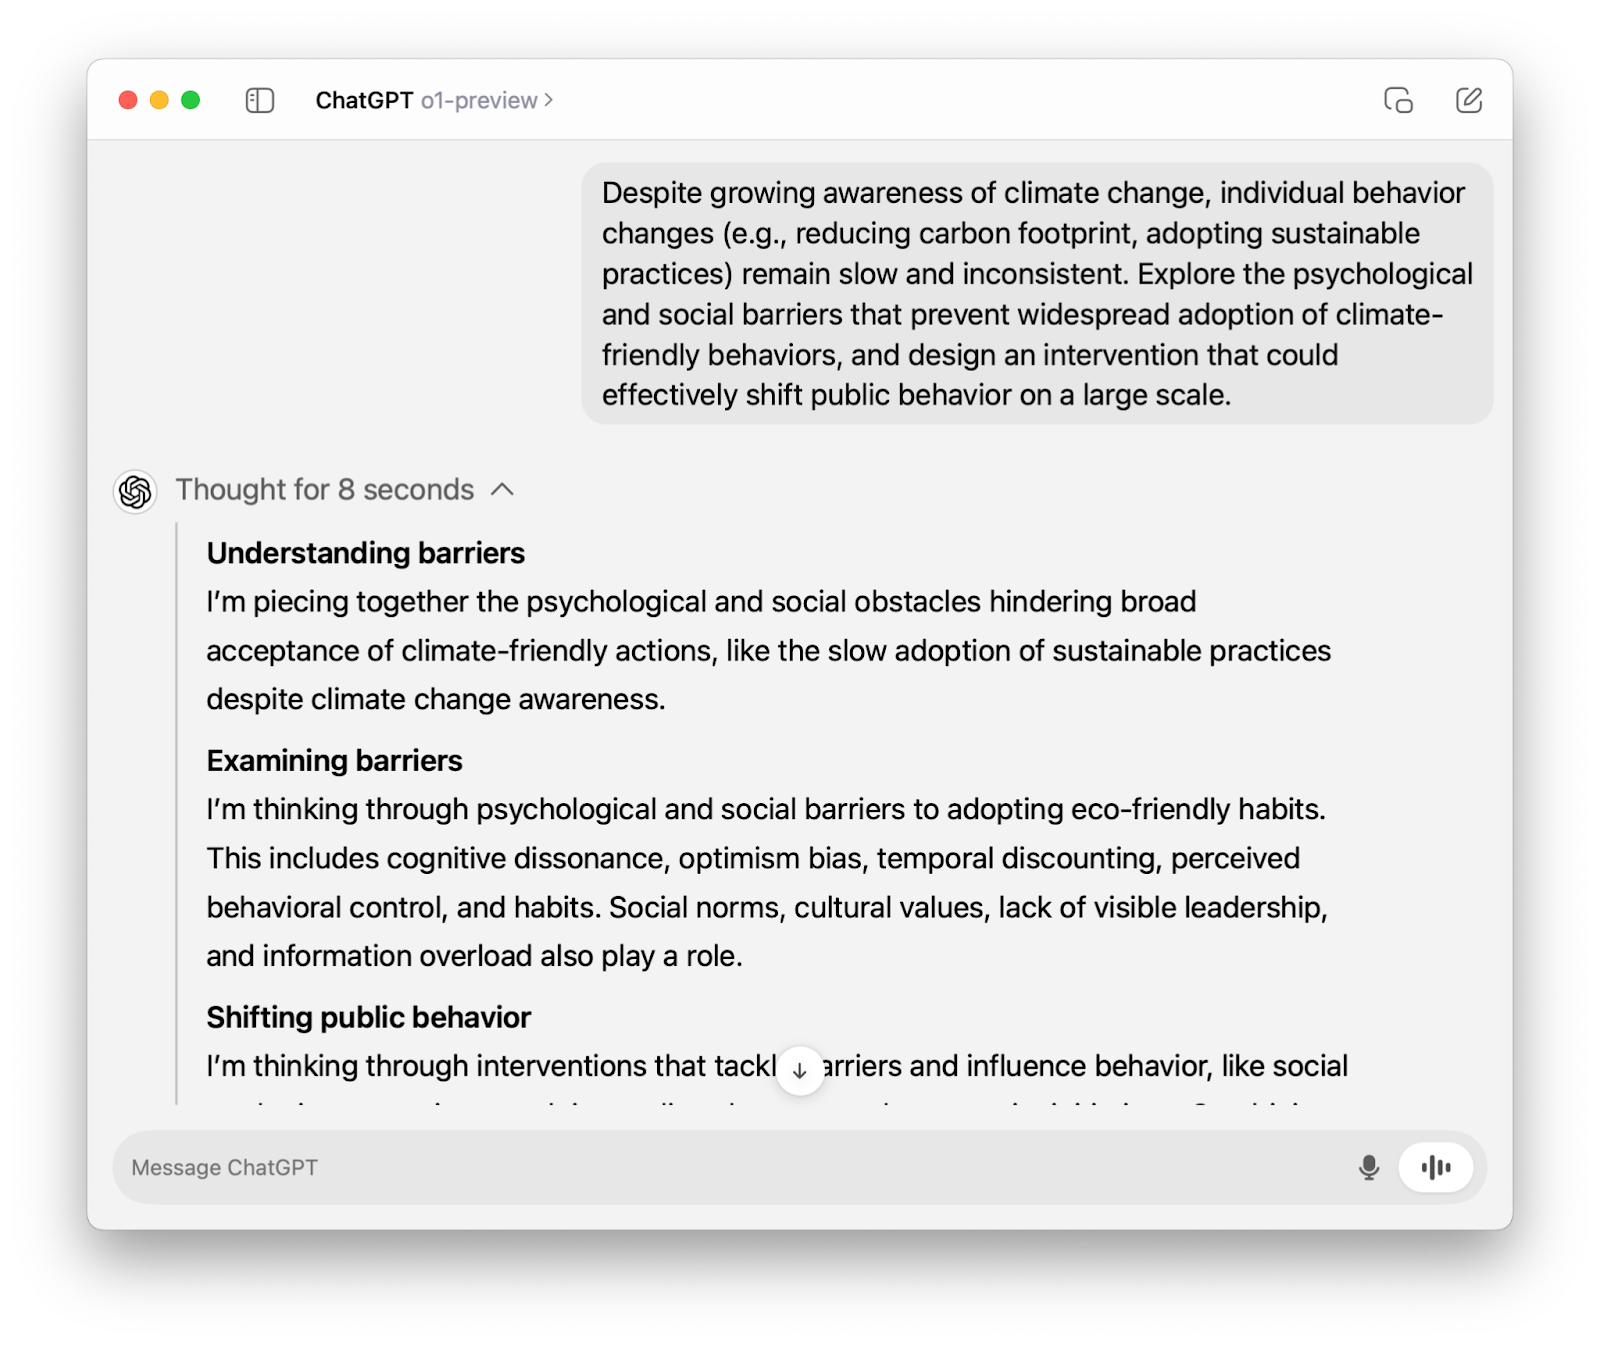
Wanneer we het o1-model via de API gebruiken, doorloopt het hetzelfde denkproces. Het enige verschil is dat het redeneerproces, anders dan in de ChatGPT-interface, niet zichtbaar is en we alleen het eindantwoord zien.
Toch wordt het denkproces getokenized (vandaar de naam “reasoning-tokens”) en, zoals je waarschijnlijk al vermoedde, hiervoor wordt gefactureerd. De reasoning-tokens worden afgerekend als outputtokens, die vier keer zo duur zijn als inputtokens.
We leren zo hoe je het aantal tokens kunt sturen en kosten kunt beheren, maar laten we eerst focussen op de koppeling met de API van OpenAI om de o1-modellen te gebruiken.
In deze sectie zetten we de stappen uiteen om via de API verbinding te maken met het o1-preview-model. Later behandelen we ook hoe je koppelt met o1-mini.
Als je een actief account hebt, kun je je geheime API-sleutel ophalen op de API-sleutelpagina van OpenAI.
Als je deel uitmaakt van een organisatie, heb je mogelijk ook de ID van je organisatie en een project-ID nodig, wat je team kan helpen kosten effectiever te beheren. Check dit bij je team.
Of je nu nieuw bent met API’s of een ervaren ontwikkelaar, het is altijd een goed idee om best practices voor API-sleutels te volgen.
openai-bibliotheekOpenAI maakt het eenvoudig om met de API te werken via de Python-bibliotheek openai. Je installeert die met het volgende commando:
pip install openaiNa installatie importeren we de klasse OpenAI uit de openai-bibliotheek:
from openai import OpenAIOm met de API van OpenAI te communiceren, initialiseren we een client met onze geheime API-sleutel:
client = OpenAI(api_key=’your-api-key’)Als je deel uitmaakt van een organisatie, heb je mogelijk ook de ID van je organisatie en een project-ID nodig; zo kan deze stap er voor jou uitzien:
client = OpenAI(
    organization=’your-organization-id’,
    project=’your-project-id’,
    api_key=’your-api-key’
)De enige o1-modellen die beschikbaar zijn op het moment van schrijven, zijn o-1 preview en o1-mini. Beide zijn beschikbaar via de chat.completions-endpoint. Let in onderstaande code op het volgende:
client.chat.completions.create().”o1-preview” op voor de parameter model.”content”.response.choices[0].message.content.response = client.chat.completions.create(
model="o1-preview",
messages=[
{
"role": "user",
"content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
}
]
)
print(response.choices[0].message.content)```python
import ast
# Read the input string
s = input()
# Add outer brackets to make it a valid list representation
input_str = '[' + s + ']'
# Safely evaluate the string to a list of lists
matrix = ast.literal_eval(input_str)
# Transpose the matrix
transposed = list(map(list, zip(*matrix)))
# Convert the transposed matrix back to the required string format
transposed_str = ','.join('[' + ','.join(map(str, row)) + ']' for row in transposed)
# Print the result
print(transposed_str)
```Zoals eerder genoemd, telt het onderliggende redeneerproces nog steeds als factureerbare tokens. Voor de code die we hierboven draaiden, is hier een uitsplitsing van alle gebruikte tokens:
print(response.usage)CompletionUsage(completion_tokens=1279, prompt_tokens=43, total_tokens=1322, completion_tokens_details={'reasoning_tokens': 1024})Uit de output zien we dat het aantal reasoning-tokens 1024 is: completion_tokens_details={'reasoning_tokens': 1024}.
Het model genereerde een completion met 1279 tokens (completion_tokens=1279), waarvan 1024 onzichtbare reasoning-tokens waren—ongeveer 80%!
Kostenbeheer wordt wat complexer met de nieuwe o1-modellen, dus laten we dit in meer detail bespreken.
Bij eerdere modellen gebruikten we de parameter max_tokens om het aantal completion-tokens te sturen. Dat was vrij rechttoe rechtaan: het aantal gegenereerde tokens en het aantal zichtbare tokens waren altijd gelijk.
Bij de o1-modellen hebben we echter een parameter nodig die een bovengrens stelt aan alle completion-tokens, inclusief zichtbare outputtokens en onzichtbare reasoning-tokens. Daarom heeft OpenAI de parameter max_completion_tokens toegevoegd, max_tokens uitgefaseerd en onverenigbaar gemaakt met o1-modellen.
Laten we max_completion_tokens proberen met ons vorige voorbeeld. We zetten die op 300 en kijken wat we krijgen. Let op: om deze nieuwe parameter te gebruiken, heb je mogelijk een update van de openai-bibliotheek nodig als je een oudere versie draait.
response_with_limit = client.chat.completions.create(
    model="o1-preview",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
        }
    ],
    max_completion_tokens=300
)
print(response_with_limit.choices[0].message.content) Merk op dat we geen output kregen. Maar betalen we nog steeds? Het antwoord is ja.
print(response_with_limit.usage)CompletionUsage(completion_tokens=300, prompt_tokens=43, total_tokens=343, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=300))Als het o1-model de tokenlimiet bereikt voordat het een eindantwoord bereikt, stopt het zijn redeneerproces en geeft het geen output terug. Daarom is het belangrijk om max_completion_tokens op een waarde te zetten die output garandeert—anders worden we afgerekend voor zowel reasoning- als inputtokens zonder iets terug te krijgen.
Je zult moeten experimenteren met de exacte waarde van max_completion_tokens op basis van jouw usecase, maar OpenAI raadt aan om minstens 25.000 tokens te reserveren voor het totale aantal completion-tokens.
Om afgekapt(e) output (of helemaal geen output) te voorkomen, moet je ook rekening houden met het contextvenster als je usecase veel tokens vergt. De o1-preview- en o-1 mini-modellen hebben een contextvenster van 128.000 tokens. Let wel: de outputtokens (zichtbaar en onzichtbaar) zijn begrensd op 32.768 tokens voor o1-preview en 65.536 tokens voor o1-mini.
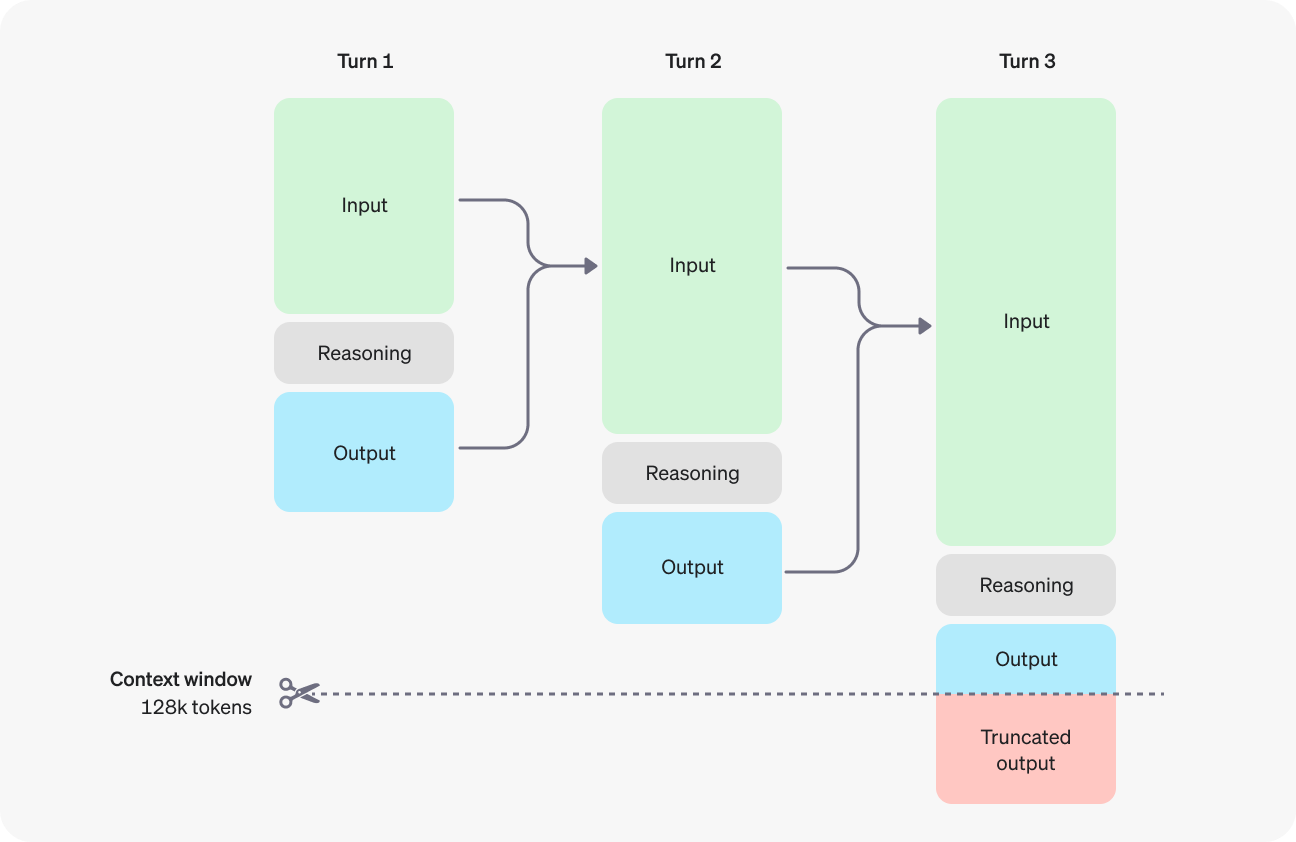
Bron: OpenAI
Het grote o1-model is sterk in geavanceerd redeneren, maar ook erg traag. Heb je snellere reactietijden nodig en kun je een kleine concessie doen in redeneerprestaties, dan is het o1-mini-model mogelijk een betere keuze.
Om via de API verbinding te maken met het o1-mini-model, volg je alle stappen die we voor o1-preview hebben behandeld—behalve bij de parameter model, waar je de string ”o1-mini” gebruikt.
We gebruiken dezelfde prompt als in ons laatste voorbeeld, zodat we het tokenverbruik kunnen vergelijken:
response_mini = client.chat.completions.create(
    model="o1-mini",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
        }
    ]
)
print(response_mini.choices[0].message.content)
Certainly! Below is a Python script that takes a matrix represented as a string in the format `'[1,2],[3,4],[5,6]'`, computes its transpose, and prints the transposed matrix in the same string format.
```python
def parse_matrix(matrix_str):
"""
Parses a matrix string like '[1,2],[3,4],[5,6]' into a list of lists.
"""
# Split the string by '],[' to separate the rows
rows = matrix_str.strip().split('],[')
# Clean the first and last elements by removing any leading '[' or trailing ']'
rows[0] = rows[0].lstrip('[')
rows[-1] = rows[-1].rstrip(']')
# Convert each row into a list of integers
matrix = []
for row in rows:
# Split each row by ',' and convert each element to integer
matrix.append([int(num) for num in row.split(',')])
return matrix
def transpose_matrix(matrix):
"""
Transposes a given matrix (list of lists).
"""
# Use zip with unpacking to transpose the matrix
transposed = list(zip(*matrix))
# Convert each tuple in the transposed matrix back to a list
transposed = [list(row) for row in transposed]
return transposed
def matrix_to_string(matrix):
"""
Converts a list of lists into a string format like '[1,3,5],[2,4,6]'.
"""
# Convert each row to a string
row_strings = []
for row in matrix:
# Convert each number to string and join with commas
row_str = ','.join(str(num) for num in row)
# Enclose the row in brackets
row_strings.append(f'[{row_str}]')
# Join all rows with commas
return ','.join(row_strings)
def main():
# Example input
input_str = '[1,2],[3,4],[5,6]'
# Parse the input string into a matrix
matrix = parse_matrix(input_str)
# Compute the transpose of the matrix
transposed = transpose_matrix(matrix)
# Convert the transposed matrix back to string format
output_str = matrix_to_string(transposed)
# Print the result
print(output_str)
if __name__ == "__main__":
main()
```
### How It Works:
1. **Parsing the Input String:**
- The `parse_matrix` function takes the input string and splits it into individual rows by looking for the pattern `"],["`.
- It cleans the first and last rows by removing any leading `[` or trailing `]`.
- Each row string is then split by `,` to extract individual numbers, which are converted to integers and stored in a nested list.
2. **Transposing the Matrix:**
- The `transpose_matrix` function uses the `zip` function along with unpacking (`*`) to transpose the matrix. This effectively switches rows with columns.
- Since `zip` returns tuples, each transposed row is converted back into a list.
3. **Converting Back to String:**
- The `matrix_to_string` function takes the transposed matrix and converts each row back into a string in the desired format.
- It joins the elements of each row with commas and encloses them in brackets.
- Finally, all row strings are joined together with commas to form the final output string.
4. **Main Execution:**
- The `main` function demonstrates the usage with an example input. You can modify `input_str` to test with different matrices.
- It prints the transposed matrix in the specified string format.
### Example:
Given the input string:
```
'[1,2],[3,4],[5,6]'
```
The script will output:
```
[1,3,5],[2,4,6]
```
### Handling User Input:
If you'd like the script to accept user input instead of having a hardcoded string, you can modify the `main` function as follows:
```python
def main():
# Take user input
input_str = input("Enter the matrix string (e.g., '[1,2],[3,4],[5,6]'): ").strip()
# Parse the input string into a matrix
matrix = parse_matrix(input_str)
# Compute the transpose of the matrix
transposed = transpose_matrix(matrix)
# Convert the transposed matrix back to string format
output_str = matrix_to_string(transposed)
# Print the result
print(output_str)
```
With this modification, when you run the script, it will prompt you to enter the matrix string:
```
Enter the matrix string (e.g., '[1,2],[3,4],[5,6]'): [1,2],[3,4],[5,6]
[1,3,5],[2,4,6]
```
### Notes:
- **Error Handling:** The current script assumes that the input string is well-formatted. For production code, you might want to add error handling to manage malformed inputs.
- **Non-integer Elements:** If your matrix contains non-integer elements (e.g., floats or strings), you'll need to adjust the parsing logic accordingly.
### Running the Script:
1. **Save the Script:** Save the above code to a file, say `transpose_matrix.py`.
2. **Run the Script:** Open a terminal or command prompt, navigate to the directory containing the script, and execute:
```bash
python transpose_matrix.py
```
3. **Provide Input:** If you've modified it to accept user input, enter the matrix string when prompted.
This script provides a straightforward way to transpose a matrix represented as a string and can be easily adapted or extended based on specific requirements.De zichtbare output is veel uitgebreider dan die van o1-preview—laten we het verbruik vergelijken:
print(response_mini.usage) # o1-mini
print(response.usage) # o1-preview
CompletionUsage(completion_tokens=1511, prompt_tokens=43, total_tokens=1554, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=256))
CompletionUsage(completion_tokens=1279, prompt_tokens=43, total_tokens=1322, completion_tokens_details={'reasoning_tokens': 1024})Het o1-mini-model redeneert vier keer minder dan het o1-model (256 vs. 1024 reasoning-tokens). Maar door het uitgebreide antwoord is het totale aantal completion-tokens juist groter. Hoewel o1-mini aanzienlijk goedkoper is dan o1-preview, is dit nog steeds niet ideaal.
Een manier om dit te beperken is via prompt engineering—we instrueren het model om uitleg en inleidingen te vermijden en de output te beperken tot alleen het antwoord.
response_mini_2 = client.chat.completions.create(
    model="o1-mini",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. Limit yourself to the answer and don't add explanations or introductions."
        }
    ]
)
print(response_mini_2.choices[0].message.content)
```python
import ast
def parse_matrix(matrix_str):
rows = matrix_str.split('],[')
rows[0] = rows[0].lstrip('[')
rows[-1] = rows[-1].rstrip(']')
matrix = [ast.literal_eval(f'[{row}]') for row in rows]
return matrix
def transpose(matrix):
return list(zip(*matrix))
def format_matrix(transposed):
return ','.join([f'[{",".join(map(str, row))}]' for row in transposed])
input_str = '[1,2],[3,4],[5,6]'
matrix = parse_matrix(input_str)
transposed = transpose(matrix)
output_str = format_matrix(transposed)
print(output_str)
```Veel beter! Het totale aantal completion-tokens is ongeveer drie keer lager:
print(response_mini_2.usage)CompletionUsage(completion_tokens=487, prompt_tokens=55, total_tokens=542, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=320))Op het moment van schrijven zijn de o1-modellen nog in bèta. Hoewel OpenAI heeft aangekondigd dat er in de komende weken extra functies en ruimere limieten komen, zijn dit de beperkingen waar je nu tegenaan loopt:
temperature, top_p en n staan vast op 1, terwijl zowel presence_penalty als frequency_penalty op 0 staan.Op dit moment lijkt OpenAI weinig concurrentie te hebben op het gebied van geavanceerd redeneren. De prijzen zijn daardoor misschien wat opgeblazen, en zoals je ziet liggen ze aanzienlijk hoger dan die van de GPT-4o-modellen:
|
Model |
Prijzen |
|
o1-preview |
$15,00 / 1M inputtokens |
|
$60,00 / 1M outputtokens |
|
|
o1-mini |
$3,00 / 1M inputtokens |
|
$12,00 / 1M outputtokens |
|
|
gpt-4o |
$5,00 / 1M inputtokens |
|
$15,00 / 1M outputtokens |
|
|
gpt-4o-mini |
$0,150 / 1M inputtokens |
|
$0,600 / 1M outputtokens |
De o1-modellen verschillen flink van de modellen die we gewend zijn, zoals GPT-4o of Claude 3.5 Sonnet. Omdat de o1-modellen al aan chain-of-thought-redeneren doen, werken ze het best met eenvoudige, directe prompts. Few-shot prompting gebruiken of het model vragen “stap voor stap” te denken, kan de prestaties juist verslechteren.
Hier zijn enkele best practices voor prompting, aanbevolen door de ontwikkelaars bij OpenAI:
In deze blog heb ik stapsgewijs uitgelegd hoe je via de API van OpenAI koppelt met de o1-modellen.
Als je project geavanceerde redeneercapaciteiten vereist en iets langere reactietijden aankan, zijn de o1-modellen uitstekende opties.
Voor toepassingen die snelle reacties, beeldverwerking of function calling nodig hebben, blijven GPT-4o en GPT-4o mini de voorkeurskeuzes.
Wil je verder leren? Dan raad ik deze resources aan:
Leer AI met deze cursussen!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

