DataCamp Premium à -50 %.Plus de 700 cours, à moitié prix. Commencez à apprendre dès aujourd’hui.
OpenAI a récemment lancé son modèle très attendu, capable d’une « raisonnement de niveau PhD ». Contrairement à ce que beaucoup pensaient, il ne s’agit pas de GPT-5, mais du modèle OpenAI o1.
La manière dont OpenAI o1 fonctionne marque un changement de paradigme important dans l’allocation des ressources de calcul, avec un accent accru sur les phases d’entraînement et d’inférence. Cette approche le rend exceptionnel pour les tâches de raisonnement complexes, mais aussi nettement plus lent que ses cousins, GPT-4o et GPT-4o mini.
Cela dit, GPT-4o et GPT-4o mini restent les options privilégiées pour les applications nécessitant des réponses rapides, la gestion d’images ou le function calling. En revanche, si votre projet exige des capacités de raisonnement avancées et peut tolérer des temps de réponse un peu plus longs, le modèle o1 est tout indiqué.
J’ai eu l’occasion d’explorer o1 via l’API d’OpenAI et, dans cet article, je vous propose un guide pas à pas pour faire de même. Je vous montre comment vous connecter à l’API, gérer les coûts et, en fin d’article, je partage quelques conseils de prompt pour réduire les dépenses et obtenir de meilleures réponses.
Si vous cherchez un article plus introductif, consultez ce guide OpenAI o1.
Remarque : au moment de la rédaction de ce tutoriel, les modèles o1 sont encore en bêta. Toutefois, la procédure de connexion à l’API reste identique.
Première information importante : pour l’instant, l’accès aux modèles o1 via l’API requiert un niveau d’usage Tier 5.
|
Niveau |
Qualification |
Plafonds d’usage |
|
Gratuit |
L’utilisateur doit se trouver dans une zone autorisée |
100 $ / mois |
|
Tier 1 |
5 $ payés |
100 $ / mois |
|
Tier 2 |
50 $ payés et 7 jours ou plus depuis le premier paiement réussi |
500 $ / mois |
|
Tier 3 |
100 $ payés et 7 jours ou plus depuis le premier paiement réussi |
1 000 $ / mois |
|
Tier 4 |
250 $ payés et 14 jours ou plus depuis le premier paiement réussi |
5 000 $ / mois |
|
Tier 5 |
1 000 $ payés et 30 jours ou plus depuis le premier paiement réussi |
50 000 $ / mois |
Pour vérifier votre niveau d’usage, rendez-vous sur la page de votre compte sur la plateforme développeurs OpenAI et consultez la section Limits sous Organization.
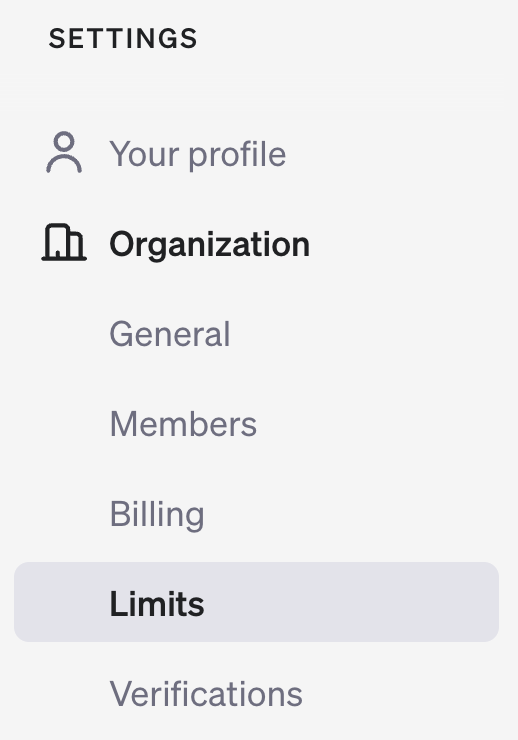
Chaque niveau d’usage s’accompagne de limites de débit spécifiques. À la date de rédaction, voici les plafonds pour le Tier 5 :
|
Modèle |
RPM (requêtes par minute) |
TPM (tokens par minute) |
Limite de file d’attente batch |
|
gpt-4o |
10 000 |
30 000 000 |
5 000 000 000 |
|
gpt-4o-mini |
30 000 |
150 000 000 |
15 000 000 000 |
|
o1-preview |
500 |
30 000 000 |
non pris en charge pour le moment |
|
o1-mini |
1 000 |
150 000 000 |
non pris en charge pour le moment |
Les modèles O1 nécessitent un temps d’inférence conséquent, d’où des limites RPM plus basses que les modèles GPT-4o. Notez que le batching n’est pas pris en charge pour les modèles o1 : vous ne pouvez pas regrouper plusieurs requêtes simultanément.
Le modèle O1 est encore récent : ces prérequis et limites de débit peuvent évoluer dans les prochaines semaines. Par exemple, OpenAI avait d’abord annoncé des plafonds hebdomadaires de 30 messages pour o1-preview et 50 pour o1-mini. Quelques jours plus tard, ces limites ont été mises à jour à 50 requêtes par semaine pour o1-preview et 50 requêtes par jour pour o1-mini.
Nous allons passer à la pratique dans un instant, mais commençons par clarifier une notion clé pour utiliser o1 via l’API : les reasoning tokens. La comprendre est essentiel pour anticiper votre facture mensuelle OpenAI.
Si vous avez utilisé o1-preview via l’interface ChatGPT, vous avez vu qu’il « pense à voix haute » avant de produire une réponse.
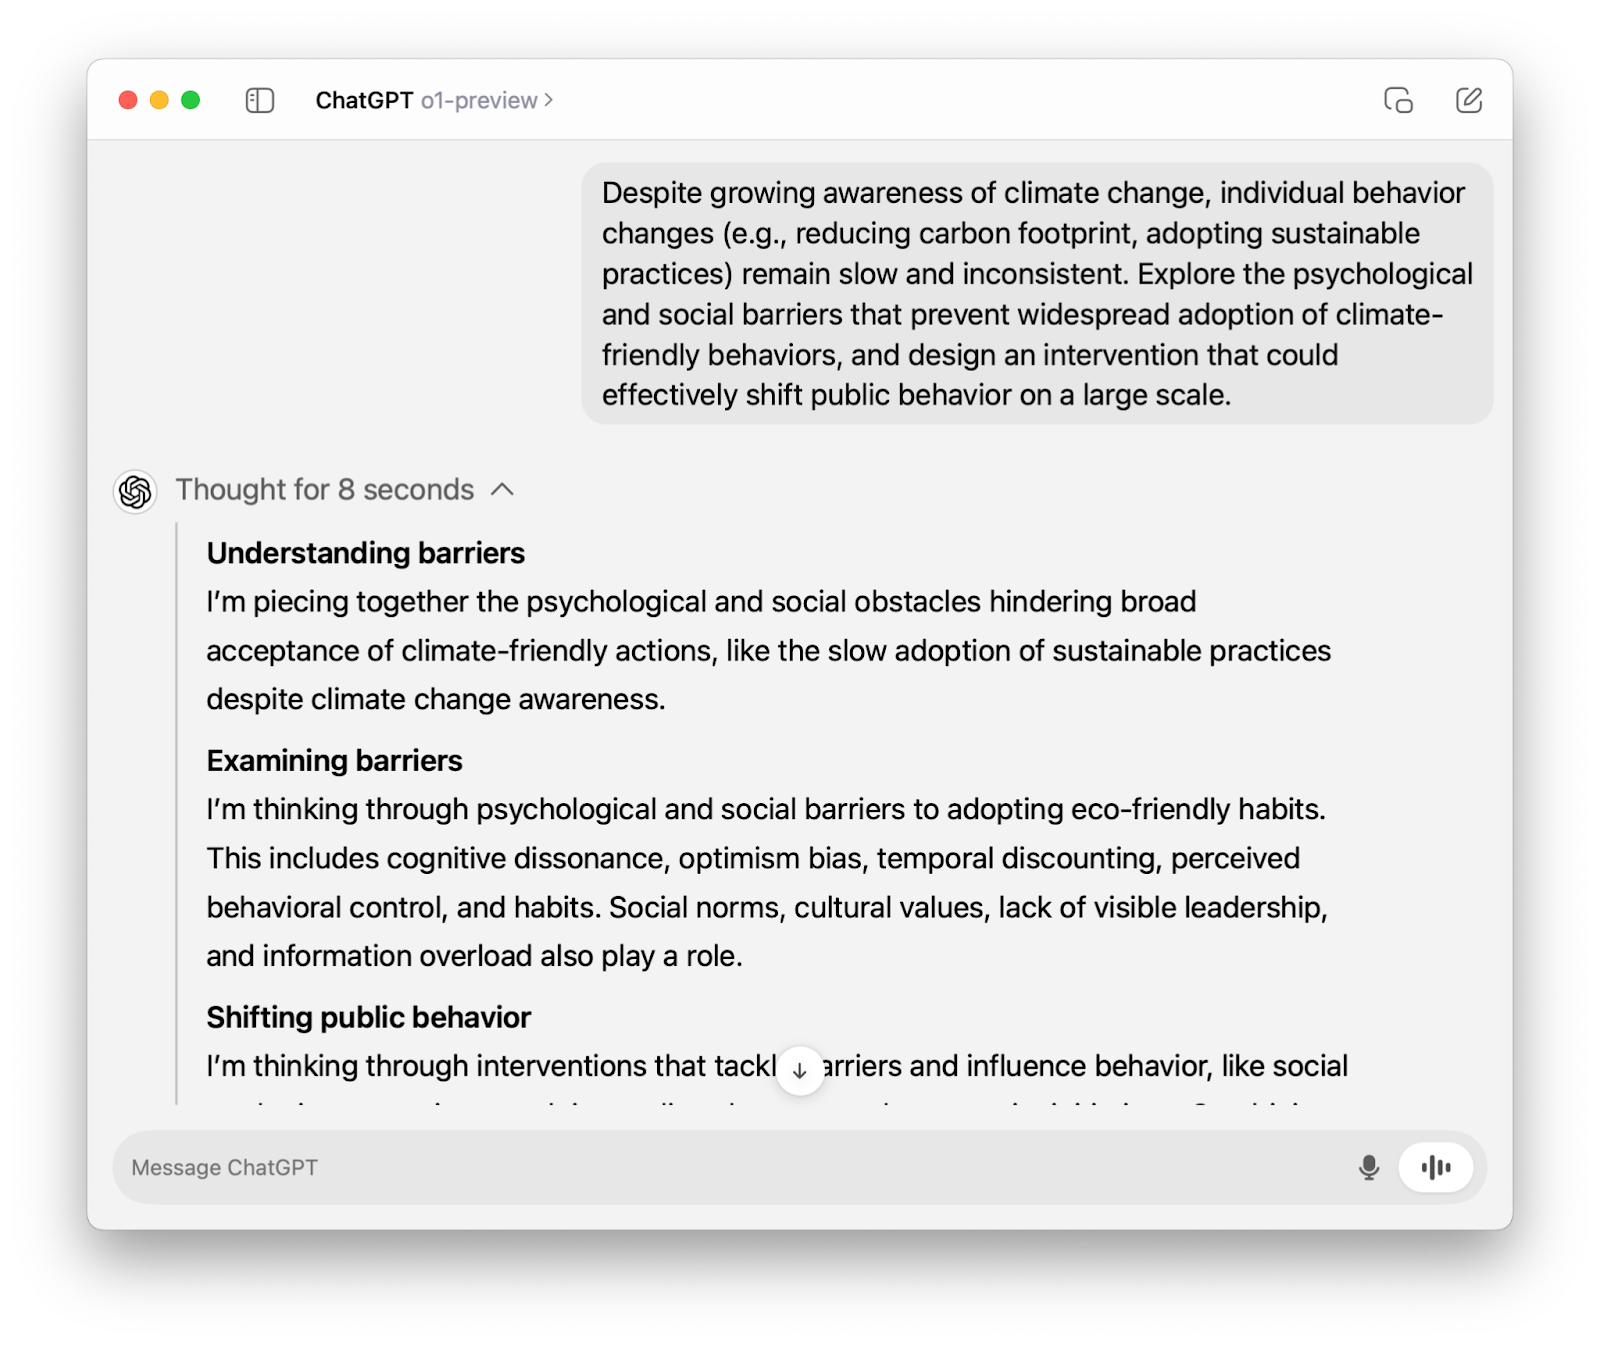
Via l’API, le modèle o1 suit le même processus de réflexion. À la différence près que, contrairement à l’interface ChatGPT, ce raisonnement n’est pas visible : vous ne voyez que la réponse finale.
Cependant, ce raisonnement est quand même tokenisé (d’où le terme « reasoning tokens ») et, comme vous vous en doutez, il est facturé. Les reasoning tokens sont facturés comme des tokens de sortie, quatre fois plus chers que les tokens d’entrée.
Nous verrons bientôt comment contrôler le nombre de tokens et maîtriser les coûts, mais concentrons-nous d’abord sur la connexion à l’API d’OpenAI pour utiliser les modèles o1.
Dans cette section, nous détaillons les étapes pour vous connecter au modèle o1-preview via l’API. Nous verrons ensuite comment se connecter au modèle o1-mini.
Si vous disposez d’un compte actif, vous pouvez récupérer votre clé API secrète sur la page des clés API d’OpenAI.
Si vous faites partie d’une organisation, vous aurez peut-être aussi besoin de l’ID d’organisation et d’un ID de projet, utiles pour mieux répartir les coûts. Vérifiez cela avec votre équipe.
Que vous soyez débutant avec les API ou développeur expérimenté, il est toujours recommandé d’appliquer les bonnes pratiques de sécurité des clés API.
openaiOpenAI facilite l’interaction avec son API via sa bibliothèque Python openai. Vous pouvez l’installer avec la commande suivante :
pip install openaiUne fois installée, importez la classe OpenAI depuis la bibliothèque openai :
from openai import OpenAIPour interagir avec l’API d’OpenAI, initialisez un client avec votre clé API secrète :
client = OpenAI(api_key=’your-api-key’)Si vous faites partie d’une organisation, vous aurez peut-être aussi besoin de l’ID d’organisation et de l’ID de projet : voici à quoi cette étape peut ressembler pour vous :
client = OpenAI(
    organization=’your-organization-id’,
    project=’your-project-id’,
    api_key=’your-api-key’
)Au moment de la rédaction, seuls les modèles o-1 preview et o1-mini sont disponibles. Tous deux sont accessibles via l’endpoint chat.completions. Dans le code ci-dessous, notez que :
client.chat.completions.create().”o1-preview” pour le paramètre model.”content”.response.choices[0].message.content.response = client.chat.completions.create(
model="o1-preview",
messages=[
{
"role": "user",
"content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
}
]
)
print(response.choices[0].message.content)```python
import ast
# Read the input string
s = input()
# Add outer brackets to make it a valid list representation
input_str = '[' + s + ']'
# Safely evaluate the string to a list of lists
matrix = ast.literal_eval(input_str)
# Transpose the matrix
transposed = list(map(list, zip(*matrix)))
# Convert the transposed matrix back to the required string format
transposed_str = ','.join('[' + ','.join(map(str, row)) + ']' for row in transposed)
# Print the result
print(transposed_str)
```Comme indiqué plus haut, le raisonnement en coulisses compte aussi comme des tokens facturables. Pour le code exécuté ci-dessus, voici la répartition des tokens utilisés :
print(response.usage)CompletionUsage(completion_tokens=1279, prompt_tokens=43, total_tokens=1322, completion_tokens_details={'reasoning_tokens': 1024})En examinant la sortie, on constate que le nombre de reasoning tokens est de 1 024 : completion_tokens_details={'reasoning_tokens': 1024}.
Le modèle a généré une complétion de 1 279 tokens (completion_tokens=1279), dont 1 024 de raisonnement invisible — soit environ 80 % !
Avec les nouveaux modèles o1, la maîtrise des coûts devient plus subtile : voyons cela en détail.
Avec les modèles précédents, on utilisait le paramètre max_tokens pour plafonner les tokens de sortie. C’était simple : le nombre de tokens générés correspondait aux tokens visibles.
Avec les modèles o1, il faut un paramètre qui fixe une limite supérieure à tous les tokens de complétion, y compris les tokens de sortie visibles et les tokens de raisonnement invisibles. OpenAI a donc ajouté max_completion_tokens, tout en dépréciant max_tokens (incompatible avec o1).
Essayons max_completion_tokens avec l’exemple précédent. Fixons-le à 300 et regardons le résultat. Pour utiliser ce nouveau paramètre, vous devrez peut-être mettre à jour la bibliothèque openai si votre version est ancienne.
response_with_limit = client.chat.completions.create(
    model="o1-preview",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
        }
    ],
    max_completion_tokens=300
)
print(response_with_limit.choices[0].message.content) Remarquez que nous n’avons obtenu aucune sortie. Mais paye-t-on quand même ? La réponse est oui.
print(response_with_limit.usage)CompletionUsage(completion_tokens=300, prompt_tokens=43, total_tokens=343, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=300))Si le modèle o1 atteint la limite de tokens avant d’aboutir à une réponse finale, il interrompt son raisonnement et ne renvoie aucune sortie. Il est donc crucial de définir max_completion_tokens à une valeur suffisante pour garantir une réponse — sinon, vous serez facturé pour les tokens de raisonnement et d’entrée sans rien obtenir en retour.
La valeur exacte de max_completion_tokens dépendra de votre cas d’usage. OpenAI recommande toutefois de réserver au moins 25 000 tokens pour le total des tokens de complétion.
Pour éviter une sortie tronquée (ou l’absence de sortie), attention aussi à la fenêtre de contexte si vous utilisez beaucoup de tokens. Les modèles o1-preview et o1-mini disposent d’une fenêtre de 128 000 tokens. Notez cependant que les tokens de sortie (visibles et invisibles) sont plafonnés à 32 768 pour o1-preview et 65 536 pour o1-mini.
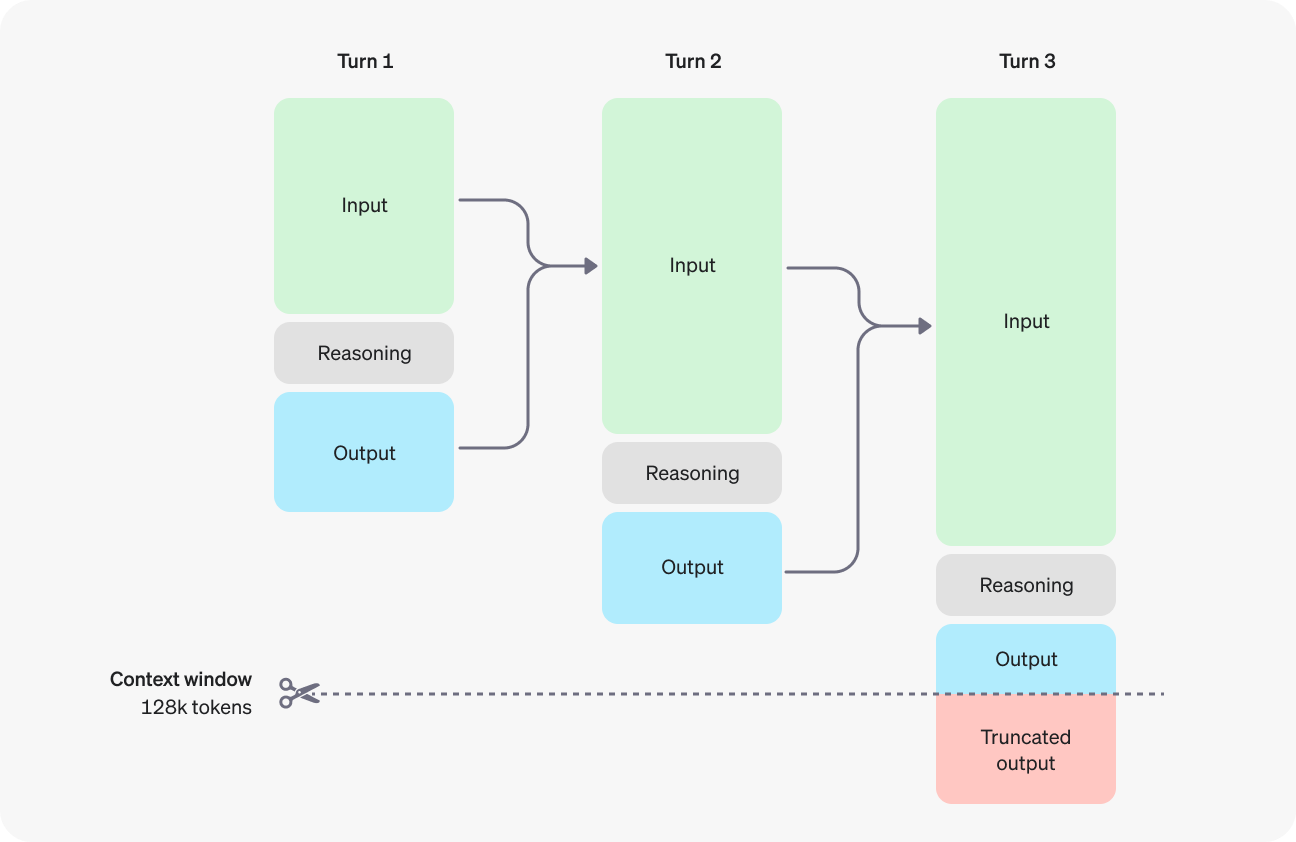
Source : OpenAI
Le grand modèle o1 excelle en raisonnement avancé, mais il est très lent. Si vous avez besoin de réponses plus rapides et acceptez un léger compromis sur la performance de raisonnement, le modèle o1-mini peut être un meilleur choix.
Pour vous connecter à o1-mini via l’API, reprenez les mêmes étapes que pour o1-preview — à l’exception du paramètre model, où vous utiliserez la chaîne ”o1-mini”.
Nous allons réutiliser le même prompt que précédemment pour comparer la consommation de tokens :
response_mini = client.chat.completions.create(
    model="o1-mini",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
        }
    ]
)
print(response_mini.choices[0].message.content)
Certainly! Below is a Python script that takes a matrix represented as a string in the format `'[1,2],[3,4],[5,6]'`, computes its transpose, and prints the transposed matrix in the same string format.
```python
def parse_matrix(matrix_str):
"""
Parses a matrix string like '[1,2],[3,4],[5,6]' into a list of lists.
"""
# Split the string by '],[' to separate the rows
rows = matrix_str.strip().split('],[')
# Clean the first and last elements by removing any leading '[' or trailing ']'
rows[0] = rows[0].lstrip('[')
rows[-1] = rows[-1].rstrip(']')
# Convert each row into a list of integers
matrix = []
for row in rows:
# Split each row by ',' and convert each element to integer
matrix.append([int(num) for num in row.split(',')])
return matrix
def transpose_matrix(matrix):
"""
Transposes a given matrix (list of lists).
"""
# Use zip with unpacking to transpose the matrix
transposed = list(zip(*matrix))
# Convert each tuple in the transposed matrix back to a list
transposed = [list(row) for row in transposed]
return transposed
def matrix_to_string(matrix):
"""
Converts a list of lists into a string format like '[1,3,5],[2,4,6]'.
"""
# Convert each row to a string
row_strings = []
for row in matrix:
# Convert each number to string and join with commas
row_str = ','.join(str(num) for num in row)
# Enclose the row in brackets
row_strings.append(f'[{row_str}]')
# Join all rows with commas
return ','.join(row_strings)
def main():
# Example input
input_str = '[1,2],[3,4],[5,6]'
# Parse the input string into a matrix
matrix = parse_matrix(input_str)
# Compute the transpose of the matrix
transposed = transpose_matrix(matrix)
# Convert the transposed matrix back to string format
output_str = matrix_to_string(transposed)
# Print the result
print(output_str)
if __name__ == "__main__":
main()
```
### How It Works:
1. **Parsing the Input String:**
- The `parse_matrix` function takes the input string and splits it into individual rows by looking for the pattern `"],["`.
- It cleans the first and last rows by removing any leading `[` or trailing `]`.
- Each row string is then split by `,` to extract individual numbers, which are converted to integers and stored in a nested list.
2. **Transposing the Matrix:**
- The `transpose_matrix` function uses the `zip` function along with unpacking (`*`) to transpose the matrix. This effectively switches rows with columns.
- Since `zip` returns tuples, each transposed row is converted back into a list.
3. **Converting Back to String:**
- The `matrix_to_string` function takes the transposed matrix and converts each row back into a string in the desired format.
- It joins the elements of each row with commas and encloses them in brackets.
- Finally, all row strings are joined together with commas to form the final output string.
4. **Main Execution:**
- The `main` function demonstrates the usage with an example input. You can modify `input_str` to test with different matrices.
- It prints the transposed matrix in the specified string format.
### Example:
Given the input string:
```
'[1,2],[3,4],[5,6]'
```
The script will output:
```
[1,3,5],[2,4,6]
```
### Handling User Input:
If you'd like the script to accept user input instead of having a hardcoded string, you can modify the `main` function as follows:
```python
def main():
# Take user input
input_str = input("Enter the matrix string (e.g., '[1,2],[3,4],[5,6]'): ").strip()
# Parse the input string into a matrix
matrix = parse_matrix(input_str)
# Compute the transpose of the matrix
transposed = transpose_matrix(matrix)
# Convert the transposed matrix back to string format
output_str = matrix_to_string(transposed)
# Print the result
print(output_str)
```
With this modification, when you run the script, it will prompt you to enter the matrix string:
```
Enter the matrix string (e.g., '[1,2],[3,4],[5,6]'): [1,2],[3,4],[5,6]
[1,3,5],[2,4,6]
```
### Notes:
- **Error Handling:** The current script assumes that the input string is well-formatted. For production code, you might want to add error handling to manage malformed inputs.
- **Non-integer Elements:** If your matrix contains non-integer elements (e.g., floats or strings), you'll need to adjust the parsing logic accordingly.
### Running the Script:
1. **Save the Script:** Save the above code to a file, say `transpose_matrix.py`.
2. **Run the Script:** Open a terminal or command prompt, navigate to the directory containing the script, and execute:
```bash
python transpose_matrix.py
```
3. **Provide Input:** If you've modified it to accept user input, enter the matrix string when prompted.
This script provides a straightforward way to transpose a matrix represented as a string and can be easily adapted or extended based on specific requirements.La sortie visible est bien plus verbeuse que celle de o1-preview — comparons l’usage :
print(response_mini.usage) # o1-mini
print(response.usage) # o1-preview
CompletionUsage(completion_tokens=1511, prompt_tokens=43, total_tokens=1554, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=256))
CompletionUsage(completion_tokens=1279, prompt_tokens=43, total_tokens=1322, completion_tokens_details={'reasoning_tokens': 1024})Le modèle o1-mini raisonne quatre fois moins que o1 (256 vs 1 024 reasoning tokens). Cependant, comme sa réponse est plus verbeuse, le nombre total de tokens de complétion est plus élevé. Même si o1-mini est nettement moins cher que o1-preview, ce n’est pas idéal.
Une manière d’atténuer cela est le prompt engineering : nous allons demander explicitement au modèle d’éviter les explications et introductions, et de se limiter à la réponse.
response_mini_2 = client.chat.completions.create(
    model="o1-mini",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. Limit yourself to the answer and don't add explanations or introductions."
        }
    ]
)
print(response_mini_2.choices[0].message.content)
```python
import ast
def parse_matrix(matrix_str):
rows = matrix_str.split('],[')
rows[0] = rows[0].lstrip('[')
rows[-1] = rows[-1].rstrip(']')
matrix = [ast.literal_eval(f'[{row}]') for row in rows]
return matrix
def transpose(matrix):
return list(zip(*matrix))
def format_matrix(transposed):
return ','.join([f'[{",".join(map(str, row))}]' for row in transposed])
input_str = '[1,2],[3,4],[5,6]'
matrix = parse_matrix(input_str)
transposed = transpose(matrix)
output_str = format_matrix(transposed)
print(output_str)
```Beaucoup mieux ! Le nombre total de tokens de complétion est environ trois fois inférieur :
print(response_mini_2.usage)CompletionUsage(completion_tokens=487, prompt_tokens=55, total_tokens=542, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=320))Au moment de la rédaction, les modèles o1 sont encore en bêta. OpenAI a annoncé des fonctionnalités supplémentaires et des limites plus souples dans les prochaines semaines, mais voici les restrictions actuelles :
temperature, top_p et n sont fixés à 1, tandis que presence_penalty et frequency_penalty sont à 0.À l’heure actuelle, OpenAI a peu de concurrence sur le terrain du raisonnement avancé. Les prix sont donc peut-être un peu élevés et, comme vous le voyez, nettement supérieurs à ceux des modèles GPT-4o :
|
Modèle |
Tarifs |
|
o1-preview |
15,00 $ / 1 M de tokens d’entrée |
|
60,00 $ / 1 M de tokens de sortie |
|
|
o1-mini |
3,00 $ / 1 M de tokens d’entrée |
|
12,00 $ / 1 M de tokens de sortie |
|
|
gpt-4o |
5,00 $ / 1 M de tokens d’entrée |
|
15,00 $ / 1 M de tokens de sortie |
|
|
gpt-4o-mini |
0,150 $ / 1 M de tokens d’entrée |
|
0,600 $ / 1 M de tokens de sortie |
Les modèles o1 diffèrent sensiblement de ceux auxquels nous sommes habitués, comme GPT-4o ou Claude 3.5 Sonnet. Puisque les modèles o1 effectuent déjà un raisonnement en chaîne de pensée, ils fonctionnent mieux avec des prompts directs et simples. Utiliser des few-shot prompts ou demander au modèle de réfléchir « étape par étape » peut en réalité dégrader ses performances.
Voici quelques bonnes pratiques de prompting recommandées par les équipes d’OpenAI :
Dans cet article, je vous ai proposé un pas-à-pas pour vous connecter aux modèles o1 via l’API d’OpenAI.
Si votre projet requiert des capacités de raisonnement avancées et peut accepter des délais de réponse légèrement plus longs, les modèles o1 sont d’excellentes options.
Pour des applications nécessitant des réponses rapides, le traitement d’images ou le function calling, GPT-4o et GPT-4o mini restent les meilleurs choix.
Pour aller plus loin, je vous recommande ces ressources :
Apprenez l’IA avec ces cours !
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cursus} other {Cursus}}
{count, plural, one {Cours} other {Cours}}
{count, plural, one {blog} other {blogs}}
{count, plural, one {blog} other {blogs}}
Kurtis Pykes
9 min
{count, plural, one {Tutoriel} other {Tutoriels}}
{count, plural, one {Tutoriel} other {Tutoriels}}
Moez Ali
6 min
{count, plural, one {Tutoriel} other {Tutoriels}}
DataCamp Team
5 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Sejal Jaiswal
24 min