
Khóa học
Kỹ thuật Prompt với OpenAI API
4 giờ
55.7K
OpenAI gần đây đã ra mắt mô hình được mong đợi từ lâu với khả năng “lập luận ở trình độ tiến sĩ”, và đó không phải là GPT-5 như nhiều người nghĩ—mà là mô hình OpenAI o1.
Cách vận hành của OpenAI o1 đánh dấu một bước chuyển hướng quan trọng trong việc phân bổ tài nguyên tính toán, nhấn mạnh hơn vào giai đoạn huấn luyện và suy luận. Cách tiếp cận này giúp mô hình đặc biệt xuất sắc ở các tác vụ lập luận phức tạp, nhưng cũng rất chậm so với các “anh em” GPT-4o và GPT-4o mini.
Mặc dù vậy, GPT-4o và GPT-4o mini vẫn là lựa chọn ưu tiên cho các ứng dụng cần phản hồi nhanh, xử lý hình ảnh hoặc gọi hàm. Tuy nhiên, nếu dự án của bạn đòi hỏi khả năng lập luận nâng cao và có thể chấp nhận thời gian phản hồi dài hơn một chút, mô hình o1 là lựa chọn phù hợp.
Tôi đã có dịp khám phá o1 thông qua API của OpenAI, và trong bài viết này, tôi sẽ hướng dẫn từng bước cách thực hiện. Tôi sẽ chỉ bạn cách kết nối với API, quản lý chi phí, và cuối bài sẽ chia sẻ một vài mẹo nhắc lệnh (prompting) để giúp bạn giảm chi phí và có phản hồi tốt hơn.
Nếu bạn đang tìm một bài viết nhập môn hơn, hãy xem Hướng dẫn OpenAI o1 này.
Lưu ý: Tại thời điểm viết hướng dẫn này, các mô hình o1 vẫn đang ở giai đoạn beta. Tuy nhiên, quy trình kết nối với API vẫn giữ nguyên.
Một trong những điều đầu tiên bạn cần biết là hiện tại, để truy cập các mô hình o1 qua API, bạn cần mức sử dụng Tier 5.
|
Tier |
Điều kiện |
Giới hạn sử dụng |
|
Miễn phí |
Người dùng phải ở khu vực được phép |
$100 / tháng |
|
Tier 1 |
Đã chi $5 |
$100 / tháng |
|
Tier 2 |
Đã chi $50 và 7+ ngày kể từ thanh toán thành công đầu tiên |
$500 / tháng |
|
Tier 3 |
Đã chi $100 và 7+ ngày kể từ thanh toán thành công đầu tiên |
$1,000 / tháng |
|
Tier 4 |
Đã chi $250 và 14+ ngày kể từ thanh toán thành công đầu tiên |
$5,000 / tháng |
|
Tier 5 |
Đã chi $1,000 và 30+ ngày kể từ thanh toán thành công đầu tiên |
$50,000 / tháng |
Để kiểm tra mức sử dụng của bạn, hãy vào trang tài khoản trên nền tảng dành cho nhà phát triển của OpenAI và xem mục Limits trong phần Organization.
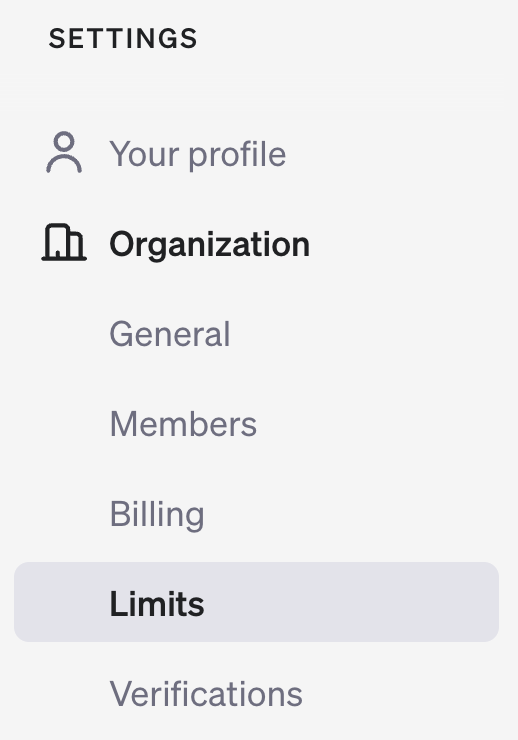
Mỗi tier sử dụng đi kèm các giới hạn tốc độ cụ thể. Tại thời điểm viết bài, đây là giới hạn tốc độ cho Tier 5:
|
Mô hình |
RPM (Yêu cầu mỗi phút) |
TPM (Token mỗi phút) |
Giới hạn hàng đợi batch |
|
gpt-4o |
10,000 |
30,000,000 |
5,000,000,000 |
|
gpt-4o-mini |
30,000 |
150,000,000 |
15,000,000,000 |
|
o1-preview |
500 |
30,000,000 |
hiện chưa hỗ trợ |
|
o1-mini |
1000 |
150,000,000 |
hiện chưa hỗ trợ |
Các mô hình O1 mất nhiều thời gian xử lý ở giai đoạn suy luận, đó là lý do giới hạn RPM thấp hơn so với các mô hình GPT-4o. Lưu ý hiện batching chưa được hỗ trợ cho các mô hình o1, nghĩa là bạn không thể gộp (batch) nhiều yêu cầu cùng lúc.
Mô hình O1 vẫn còn mới, vì vậy các yêu cầu và giới hạn tốc độ này có thể thay đổi trong vài tuần tới. Chẳng hạn, ban đầu OpenAI thông báo giới hạn theo tuần là 30 tin nhắn cho o1-preview và 50 cho o1-mini. Tuy nhiên, chỉ vài ngày sau, họ đã cập nhật thành 50 truy vấn mỗi tuần cho o1-preview và 50 truy vấn mỗi ngày cho o1-mini.
Chúng ta sẽ sớm đến phần thực hành, nhưng trước đó, hãy làm rõ một khái niệm mới rất quan trọng khi dùng o1 qua API: reasoning tokens. Hiểu khái niệm này là chìa khóa để hiểu hóa đơn OpenAI hàng tháng của bạn.
Nếu bạn đã dùng o1-preview qua giao diện ChatGPT, bạn sẽ thấy nó “nghĩ thành tiếng” trước khi tạo câu trả lời.
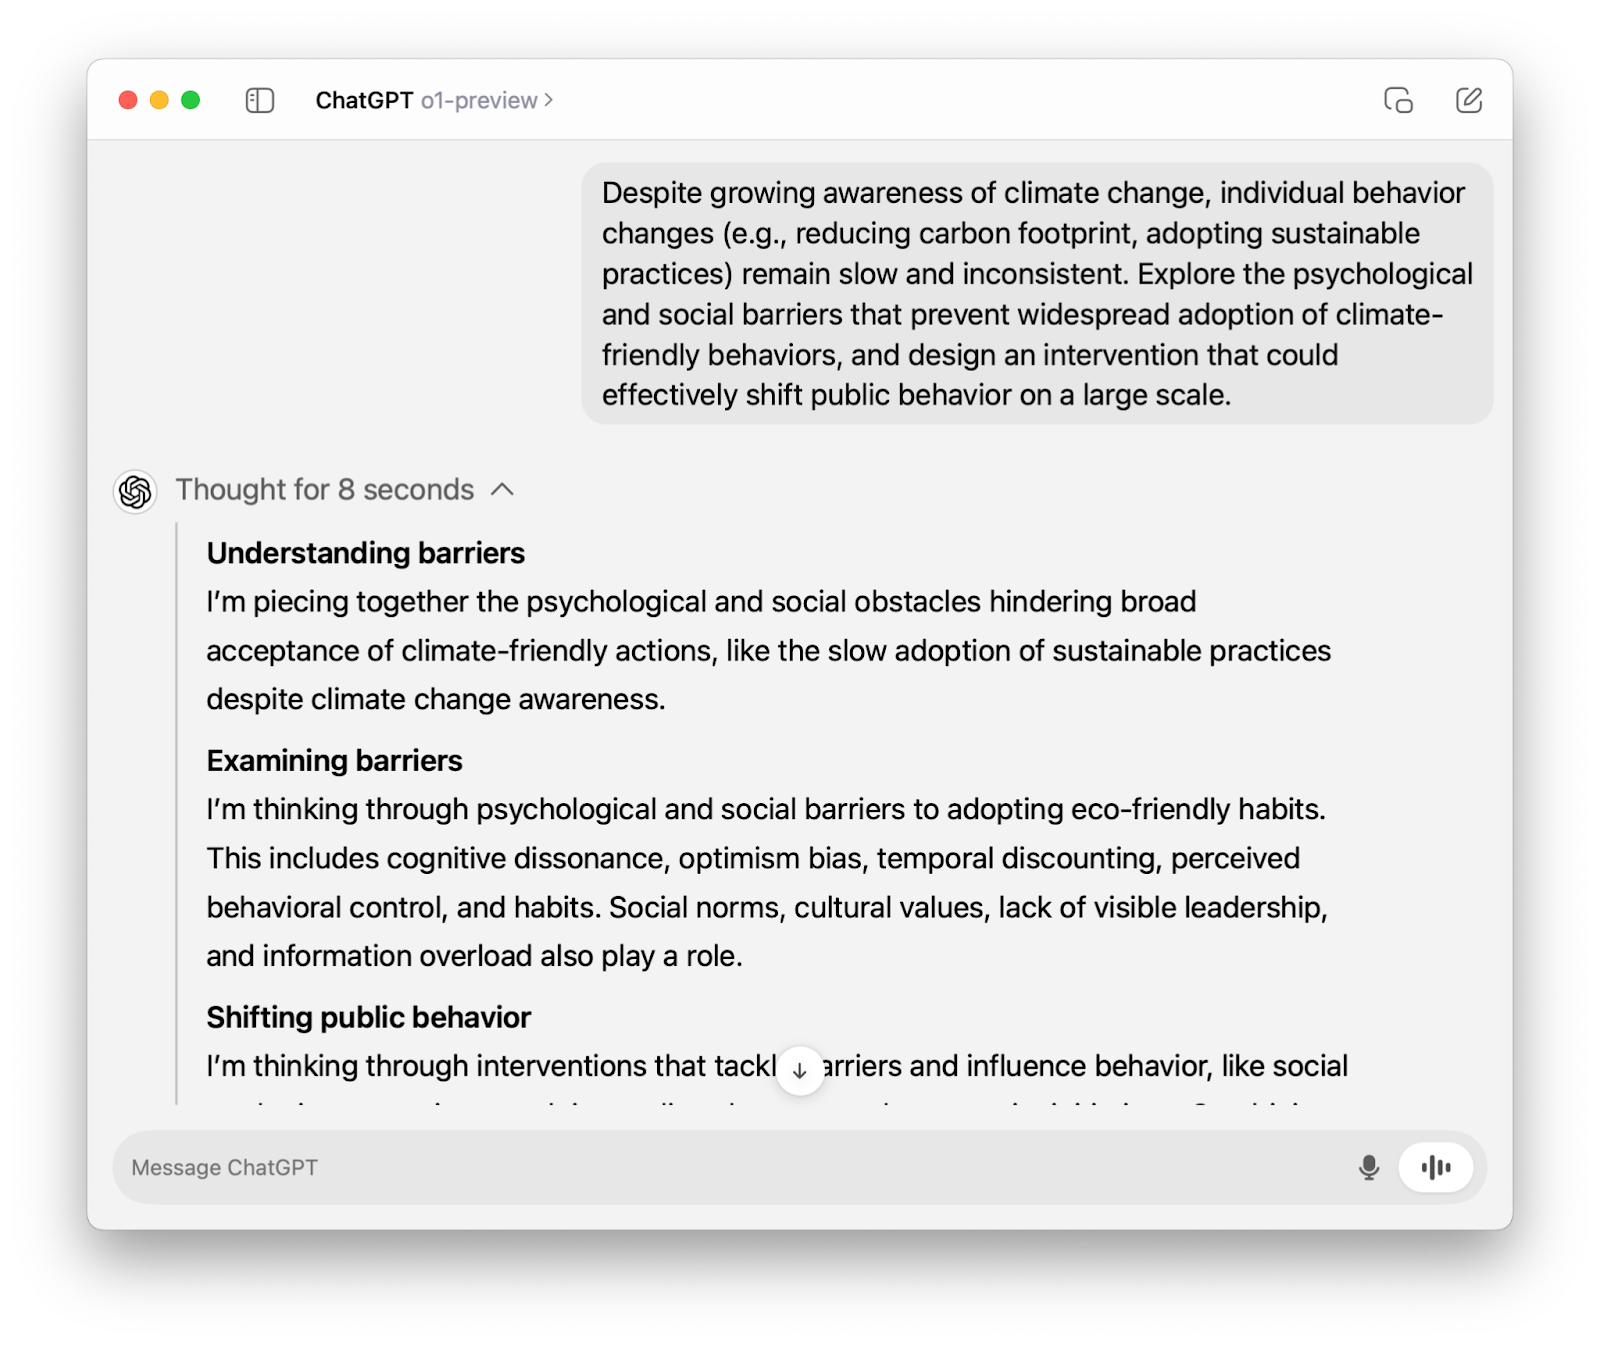
Khi dùng mô hình o1 qua API, nó cũng trải qua quá trình suy nghĩ tương tự. Điểm khác biệt duy nhất là không như trong giao diện ChatGPT, phần lập luận không hiển thị, và bạn chỉ thấy câu trả lời cuối cùng.
Tuy nhiên, phần lập luận vẫn được mã hoá thành token (vì thế mới gọi là “reasoning tokens”), và như bạn đoán, nó sẽ bị tính phí. Reasoning tokens được tính như token đầu ra, vốn đắt gấp bốn lần token đầu vào.
Chúng ta sẽ sớm học cách kiểm soát số lượng token và quản lý chi phí, nhưng trước hết, hãy tập trung vào việc kết nối tới API của OpenAI để dùng các mô hình o1.
Trong phần này, chúng ta sẽ đi qua các bước để kết nối tới mô hình o1-preview qua API. Sau đó, chúng ta cũng sẽ đề cập cách kết nối tới mô hình o1-mini.
Nếu bạn có tài khoản đang hoạt động, bạn có thể lấy khóa API bí mật từ trang khóa API của OpenAI.
Nếu bạn thuộc một tổ chức, bạn cũng có thể cần ID tổ chức và ID dự án, giúp đội ngũ quản lý chi phí hiệu quả hơn. Hãy kiểm tra với đội của bạn về điều này.
Dù bạn mới làm quen với API hay là nhà phát triển dày dạn, luôn là ý tưởng tốt để tuân theo các thực hành tốt về API.
openaiOpenAI giúp tương tác với API dễ dàng thông qua thư viện Python openai. Bạn có thể cài đặt bằng lệnh sau:
pip install openaiSau khi cài, chúng ta nhập lớp OpenAI từ thư viện openai:
from openai import OpenAIĐể tương tác với API của OpenAI, chúng ta khởi tạo một client bằng khóa API bí mật:
client = OpenAI(api_key=’your-api-key’)Nếu bạn thuộc một tổ chức, bạn cũng có thể cần ID tổ chức và ID dự án, khi đó bước này của bạn có thể trông như sau:
client = OpenAI(
    organization=’your-organization-id’,
    project=’your-project-id’,
    api_key=’your-api-key’
)Các mô hình o1 duy nhất có sẵn tại thời điểm viết bài là o-1 preview và o1-mini. Cả hai đều khả dụng qua endpoint chat.completions. Trong đoạn mã dưới đây, lưu ý rằng:
client.chat.completions.create().”o1-preview” cho tham số model.”content”.response.choices[0].message.content.response = client.chat.completions.create(
model="o1-preview",
messages=[
{
"role": "user",
"content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
}
]
)
print(response.choices[0].message.content)```python
import ast
# Read the input string
s = input()
# Add outer brackets to make it a valid list representation
input_str = '[' + s + ']'
# Safely evaluate the string to a list of lists
matrix = ast.literal_eval(input_str)
# Transpose the matrix
transposed = list(map(list, zip(*matrix)))
# Convert the transposed matrix back to the required string format
transposed_str = ','.join('[' + ','.join(map(str, row)) + ']' for row in transposed)
# Print the result
print(transposed_str)
```Như đã đề cập, phần lập luận “ẩn” vẫn được tính là token tính phí. Với đoạn mã chúng ta vừa chạy, đây là phân rã các token đã dùng:
print(response.usage)CompletionUsage(completion_tokens=1279, prompt_tokens=43, total_tokens=1322, completion_tokens_details={'reasoning_tokens': 1024})Quan sát đầu ra, chúng ta thấy số reasoning tokens là 1024: completion_tokens_details={'reasoning_tokens': 1024}.
Mô hình đã tạo phần hoàn tất với 1279 token (completion_tokens=1279), trong đó 1024 là token lập luận “vô hình”—chiếm khoảng 80%!
Quản lý chi phí trở nên phức tạp hơn với các mô hình o1 mới, vì vậy hãy bàn kỹ hơn.
Với các mô hình trước đây, chúng ta dùng tham số max_tokens để kiểm soát số token hoàn tất. Mọi thứ khá đơn giản: số token được tạo ra và số token hiển thị luôn giống nhau.
Tuy nhiên, với các mô hình o1, chúng ta cần một tham số đặt giới hạn trên cho toàn bộ token hoàn tất, bao gồm token đầu ra hiển thị và token lập luận ẩn. Vì lý do này, OpenAI đã thêm tham số max_completion_tokens, đồng thời loại bỏ max_tokens và khiến nó không tương thích với các mô hình o1.
Hãy thử max_completion_tokens với ví dụ trước. Chúng ta sẽ đặt là 300 và xem kết quả. Lưu ý bạn có thể cần cập nhật thư viện openai nếu đang dùng phiên bản cũ để sử dụng tham số mới này.
response_with_limit = client.chat.completions.create(
    model="o1-preview",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
        }
    ],
    max_completion_tokens=300
)
print(response_with_limit.choices[0].message.content) Lưu ý rằng chúng ta không nhận được đầu ra nào. Nhưng liệu chúng ta vẫn bị tính phí? Câu trả lời là có.
print(response_with_limit.usage)CompletionUsage(completion_tokens=300, prompt_tokens=43, total_tokens=343, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=300))Nếu mô hình o1 chạm giới hạn token trước khi có câu trả lời cuối cùng, nó sẽ dừng quá trình lập luận và không trả về đầu ra. Vì vậy, điều quan trọng là đặt max_completion_tokens ở mức đảm bảo có đầu ra—nếu không, chúng ta sẽ bị tính phí cho cả token lập luận và token đầu vào mà không nhận lại gì.
Bạn sẽ cần thử nghiệm giá trị cụ thể của max_completion_tokens dựa trên trường hợp sử dụng của mình, nhưng OpenAI khuyến nghị dành tối thiểu 25.000 token cho tổng số token hoàn tất.
Để tránh đầu ra bị cắt cụt (hoặc không có đầu ra), bạn cũng cần lưu ý cửa sổ ngữ cảnh nếu trường hợp sử dụng liên quan đến số lượng token lớn. Các mô hình o1-preview và o-1 mini có cửa sổ ngữ cảnh 128.000 token. Tuy nhiên, lưu ý rằng token đầu ra (hiển thị và ẩn) bị giới hạn ở 32.768 token với o1-preview và 65.536 token với o1-mini.
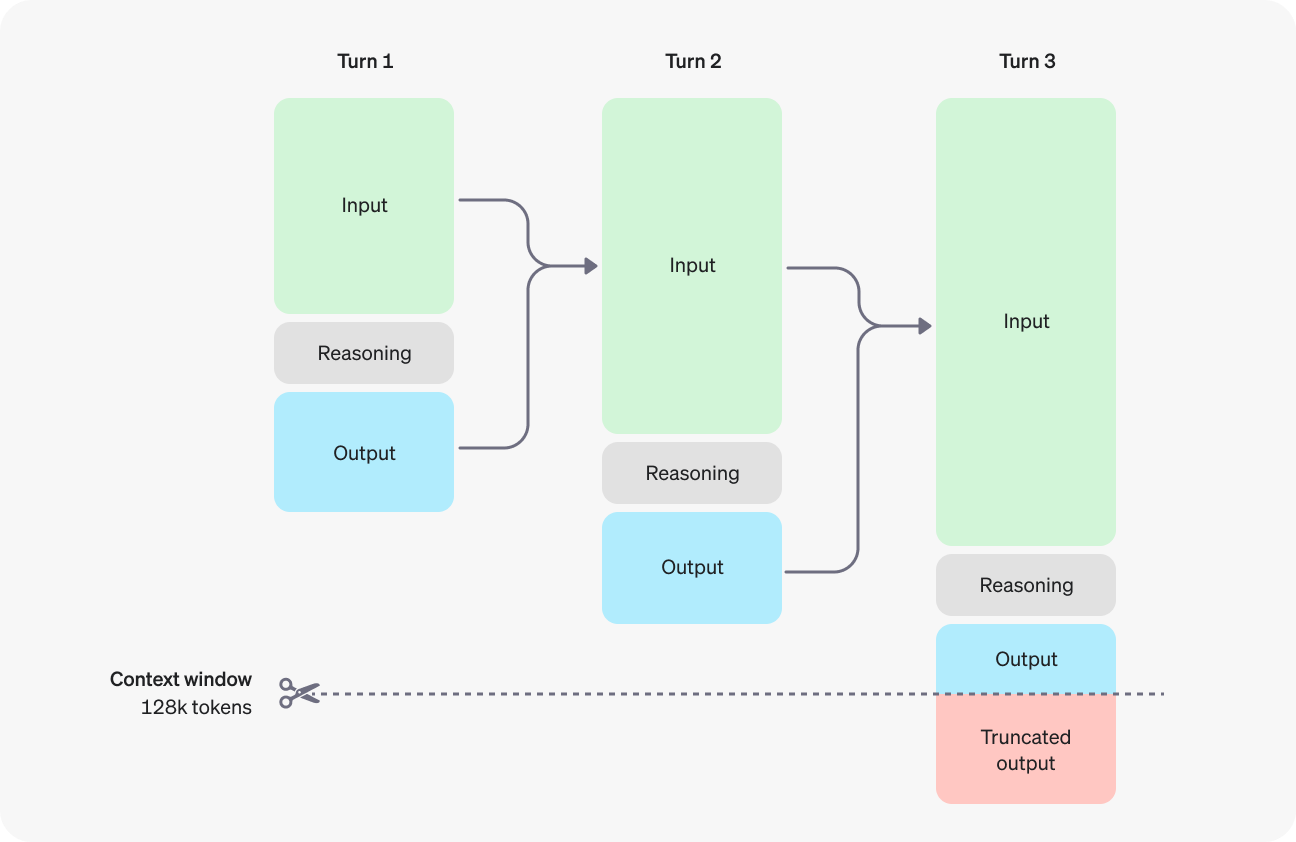
Nguồn: OpenAI
Mô hình o1 lớn rất mạnh ở lập luận nâng cao, nhưng cũng rất chậm. Nếu bạn cần thời gian phản hồi nhanh hơn cho ứng dụng và sẵn sàng chấp nhận đôi chút giảm sút về hiệu năng lập luận, thì mô hình o1-mini có thể phù hợp hơn.
Để kết nối tới o1-mini qua API, hãy làm theo tất cả các bước đã nêu cho mô hình o1-preview—ngoại trừ tham số model, nơi bạn cần dùng chuỗi ”o1-mini”.
Chúng ta sẽ dùng cùng một prompt như ví dụ trước để có thể so sánh mức sử dụng token:
response_mini = client.chat.completions.create(
    model="o1-mini",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
        }
    ]
)
print(response_mini.choices[0].message.content)
Certainly! Below is a Python script that takes a matrix represented as a string in the format `'[1,2],[3,4],[5,6]'`, computes its transpose, and prints the transposed matrix in the same string format.
```python
def parse_matrix(matrix_str):
"""
Parses a matrix string like '[1,2],[3,4],[5,6]' into a list of lists.
"""
# Split the string by '],[' to separate the rows
rows = matrix_str.strip().split('],[')
# Clean the first and last elements by removing any leading '[' or trailing ']'
rows[0] = rows[0].lstrip('[')
rows[-1] = rows[-1].rstrip(']')
# Convert each row into a list of integers
matrix = []
for row in rows:
# Split each row by ',' and convert each element to integer
matrix.append([int(num) for num in row.split(',')])
return matrix
def transpose_matrix(matrix):
"""
Transposes a given matrix (list of lists).
"""
# Use zip with unpacking to transpose the matrix
transposed = list(zip(*matrix))
# Convert each tuple in the transposed matrix back to a list
transposed = [list(row) for row in transposed]
return transposed
def matrix_to_string(matrix):
"""
Converts a list of lists into a string format like '[1,3,5],[2,4,6]'.
"""
# Convert each row to a string
row_strings = []
for row in matrix:
# Convert each number to string and join with commas
row_str = ','.join(str(num) for num in row)
# Enclose the row in brackets
row_strings.append(f'[{row_str}]')
# Join all rows with commas
return ','.join(row_strings)
def main():
# Example input
input_str = '[1,2],[3,4],[5,6]'
# Parse the input string into a matrix
matrix = parse_matrix(input_str)
# Compute the transpose of the matrix
transposed = transpose_matrix(matrix)
# Convert the transposed matrix back to string format
output_str = matrix_to_string(transposed)
# Print the result
print(output_str)
if __name__ == "__main__":
main()
```
### How It Works:
1. **Parsing the Input String:**
- The `parse_matrix` function takes the input string and splits it into individual rows by looking for the pattern `"],["`.
- It cleans the first and last rows by removing any leading `[` or trailing `]`.
- Each row string is then split by `,` to extract individual numbers, which are converted to integers and stored in a nested list.
2. **Transposing the Matrix:**
- The `transpose_matrix` function uses the `zip` function along with unpacking (`*`) to transpose the matrix. This effectively switches rows with columns.
- Since `zip` returns tuples, each transposed row is converted back into a list.
3. **Converting Back to String:**
- The `matrix_to_string` function takes the transposed matrix and converts each row back into a string in the desired format.
- It joins the elements of each row with commas and encloses them in brackets.
- Finally, all row strings are joined together with commas to form the final output string.
4. **Main Execution:**
- The `main` function demonstrates the usage with an example input. You can modify `input_str` to test with different matrices.
- It prints the transposed matrix in the specified string format.
### Example:
Given the input string:
```
'[1,2],[3,4],[5,6]'
```
The script will output:
```
[1,3,5],[2,4,6]
```
### Handling User Input:
If you'd like the script to accept user input instead of having a hardcoded string, you can modify the `main` function as follows:
```python
def main():
# Take user input
input_str = input("Enter the matrix string (e.g., '[1,2],[3,4],[5,6]'): ").strip()
# Parse the input string into a matrix
matrix = parse_matrix(input_str)
# Compute the transpose of the matrix
transposed = transpose_matrix(matrix)
# Convert the transposed matrix back to string format
output_str = matrix_to_string(transposed)
# Print the result
print(output_str)
```
With this modification, when you run the script, it will prompt you to enter the matrix string:
```
Enter the matrix string (e.g., '[1,2],[3,4],[5,6]'): [1,2],[3,4],[5,6]
[1,3,5],[2,4,6]
```
### Notes:
- **Error Handling:** The current script assumes that the input string is well-formatted. For production code, you might want to add error handling to manage malformed inputs.
- **Non-integer Elements:** If your matrix contains non-integer elements (e.g., floats or strings), you'll need to adjust the parsing logic accordingly.
### Running the Script:
1. **Save the Script:** Save the above code to a file, say `transpose_matrix.py`.
2. **Run the Script:** Open a terminal or command prompt, navigate to the directory containing the script, and execute:
```bash
python transpose_matrix.py
```
3. **Provide Input:** If you've modified it to accept user input, enter the matrix string when prompted.
This script provides a straightforward way to transpose a matrix represented as a string and can be easily adapted or extended based on specific requirements.Đầu ra hiển thị dài dòng hơn nhiều so với o1-preview—hãy so sánh mức sử dụng:
print(response_mini.usage) # o1-mini
print(response.usage) # o1-preview
CompletionUsage(completion_tokens=1511, prompt_tokens=43, total_tokens=1554, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=256))
CompletionUsage(completion_tokens=1279, prompt_tokens=43, total_tokens=1322, completion_tokens_details={'reasoning_tokens': 1024})Mô hình o1-mini lập luận ít hơn bốn lần so với mô hình o1 (256 so với 1024 reasoning tokens). Tuy nhiên, do câu trả lời dài dòng, tổng số token hoàn tất thực tế lại lớn hơn. Dù o1-mini rẻ hơn đáng kể so với o1-preview, điều này vẫn không lý tưởng.
Một cách giảm thiểu là thông qua kỹ thuật nhắc lệnh (prompt engineering)—chúng ta sẽ hướng dẫn mô hình tránh giải thích và phần mở đầu, chỉ giới hạn ở câu trả lời.
response_mini_2 = client.chat.completions.create(
    model="o1-mini",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. Limit yourself to the answer and don't add explanations or introductions."
        }
    ]
)
print(response_mini_2.choices[0].message.content)
```python
import ast
def parse_matrix(matrix_str):
rows = matrix_str.split('],[')
rows[0] = rows[0].lstrip('[')
rows[-1] = rows[-1].rstrip(']')
matrix = [ast.literal_eval(f'[{row}]') for row in rows]
return matrix
def transpose(matrix):
return list(zip(*matrix))
def format_matrix(transposed):
return ','.join([f'[{",".join(map(str, row))}]' for row in transposed])
input_str = '[1,2],[3,4],[5,6]'
matrix = parse_matrix(input_str)
transposed = transpose(matrix)
output_str = format_matrix(transposed)
print(output_str)
```Tốt hơn nhiều! Tổng số token hoàn tất giảm khoảng ba lần:
print(response_mini_2.usage)CompletionUsage(completion_tokens=487, prompt_tokens=55, total_tokens=542, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=320))Tại thời điểm viết hướng dẫn này, các mô hình o1 vẫn đang ở giai đoạn beta. Mặc dù OpenAI đã công bố kế hoạch bổ sung tính năng và nới lỏng giới hạn trong vài tuần tới, dưới đây là những hạn chế bạn sẽ gặp khi dùng các mô hình o1 bản beta:
temperature, top_p, và n cố định ở 1, trong khi presence_penalty và frequency_penalty đặt ở 0.Hiện tại, OpenAI dường như chưa có nhiều đối thủ trong lĩnh vực lập luận nâng cao. Do đó, mức giá có phần cao, và như bạn thấy, cao hơn đáng kể so với các mô hình GPT-4o:
|
Mô hình |
Giá |
|
o1-preview |
$15.00 / 1M token đầu vào |
|
$60.00 / 1M token đầu ra |
|
|
o1-mini |
$3.00 / 1M token đầu vào |
|
$12.00 / 1M token đầu ra |
|
|
gpt-4o |
$5.00 / 1M token đầu vào |
|
$15.00 / 1M token đầu ra |
|
|
gpt-4o-mini |
$0.150 / 1M token đầu vào |
|
$0.600 / 1M token đầu ra |
Các mô hình o1 khác biệt đáng kể so với những mô hình chúng ta quen thuộc như GPT-4o hay Claude 3.5 Sonnet. Vì các mô hình o1 vốn đã thực hiện lập luận theo chuỗi suy nghĩ (chain-of-thought), chúng hoạt động tốt nhất với các prompt đơn giản. Dùng few-shot prompting hoặc yêu cầu mô hình “nghĩ từng bước” thực ra có thể làm giảm hiệu năng.
Dưới đây là một số thực hành nhắc lệnh tốt nhất do các nhà phát triển tại OpenAI khuyến nghị:
Xuyên suốt bài viết, tôi đã chia sẻ hướng dẫn từng bước để kết nối tới các mô hình o1 qua API của OpenAI.
Nếu dự án của bạn yêu cầu khả năng lập luận nâng cao và có thể chấp nhận thời gian phản hồi dài hơn một chút, các mô hình o1 là lựa chọn tuyệt vời.
Đối với ứng dụng cần phản hồi nhanh, xử lý hình ảnh hoặc gọi hàm, GPT-4o và GPT-4o mini vẫn là lựa chọn ưu tiên.
Để tiếp tục học, tôi khuyến nghị các tài nguyên sau:
Học AI với những khóa học này!
Khóa học
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
