
{count, plural, one {Corso} other {Corsi}}
Elaborazione di immagini in Python
{hours} ore
57K
Estrarre manualmente testo da immagini e documenti può essere molto noioso e richiedere tempo. Fortunatamente, l’OCR (Optical Character Recognition) può automatizzare questo processo, permettendoti di convertire quelle immagini in file di testo modificabili e ricercabili.
Le tecniche che stai per imparare si applicano in molte situazioni:
Il tutorial si concentrerà sul motore Tesseract OCR e sulla sua API Python, PyTesseract. Prima di iniziare a scrivere codice, rivediamo brevemente alcune delle librerie più popolari dedicate all’OCR.
Poiché l’OCR è un problema molto studiato, molte librerie open-source cercano di affrontarlo. In questa sezione vedremo quelle che hanno guadagnato più popolarità grazie alle loro prestazioni e accuratezza.
Tesseract OCR è un motore open-source per il riconoscimento ottico dei caratteri, il più popolare tra gli sviluppatori. Come gli altri strumenti in questo elenco, Tesseract può prendere immagini contenenti testo e convertirle in testo modificabile.
EasyOCR è una libreria Python progettata per rendere l’OCR semplice. Fa onore al suo nome offrendo un approccio intuitivo all’estrazione di testo dalle immagini.
Keras-OCR è una libreria Python costruita sopra Keras, un popolare framework di deep learning. Fornisce modelli OCR pronti all’uso e una pipeline end-to-end per addestrare nuovi modelli.
Ecco una tabella che riassume differenze, vantaggi e svantaggi:
|
Nome pacchetto |
Vantaggio |
Svantaggi |
|
Tesseract (pytesseract) |
Maturo, ampiamente usato, supporto esteso |
Più lento, minore accuratezza su layout complessi |
|
EasyOCR |
Semplice da usare, modelli multipli |
Accuratezza inferiore, personalizzazione limitata |
|
Keras-OCR |
Maggiore accuratezza, personalizzabile |
Richiede GPU, curva di apprendimento più ripida |
In questo tutorial ci concentreremo su PyTesseract, l’API Python di Tesseract. Impareremo a estrarre testo da immagini semplici, a disegnare riquadri di delimitazione attorno al testo e a svolgere un caso di studio con un documento scansionato.
PyTesseract funziona sopra il motore Tesseract ufficiale, che è un software CLI separato. Prima di installare pytesseract, devi avere il motore installato. Qui sotto trovi le istruzioni di installazione per diverse piattaforme.
Per Ubuntu o WSL2 (la mia scelta):
$ sudo apt update && sudo apt upgrade
$ sudo apt install tesseract-ocr
$ sudo apt install libtesseract-dev
Per Mac con Homebrew:
$ brew install tesseract
Per Windows, segui le istruzioni su questa pagina GitHub.
Poi crea un nuovo ambiente virtuale. Io userò Conda:
$ conda create -n ocr python==3.9 -y
$ conda activate ocr
Quindi, devi installare pytesseract per eseguire l’OCR e opencv per la manipolazione delle immagini:
$ pip install pytesseract
$ pip install opencv-python
Se stai seguendo questo tutorial in Jupyter, esegui questi comandi nella stessa sessione di terminale così che il nuovo ambiente virtuale venga aggiunto come kernel:
$ pip install ipykernel
$ ipython kernel install --user --name=ocr
Ora possiamo iniziare a scrivere codice.
Iniziamo importando le librerie necessarie:
import cv2
import pytesseract
Il nostro compito è leggere il testo dalla seguente immagine:
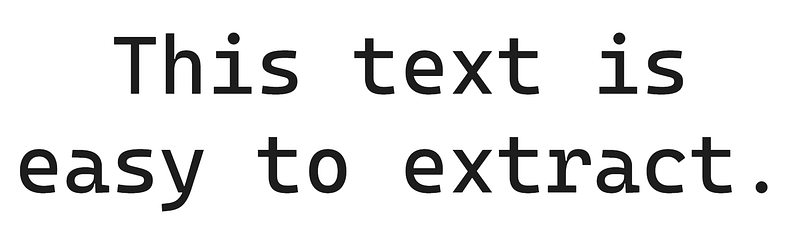
Per prima cosa, definiamo il percorso dell’immagine e lo passiamo alla funzione cv2.imread:
# Read image
easy_text_path = "images/easy_text.png"
easy_img = cv2.imread(easy_text_path)
Poi passiamo l’immagine caricata alla funzione image_to_string di pytesseract per estrarre il testo:
# Convert to text
text = pytesseract.image_to_string(easy_img)
print(text)
This text is
easy to extract.
È tutto qui! Convertiamo quanto fatto in una funzione:
def image_to_text(input_path):
   """
   A function to read text from images.
   """
   img = cv2.imread(input_path)
   text = pytesseract.image_to_string(img)

   return text.strip()
Usiamo la funzione su un’immagine più difficile:
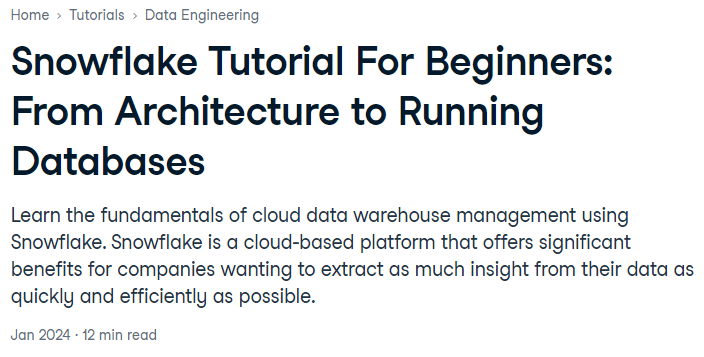
L’immagine è più impegnativa perché contiene più punteggiatura e testo con font diversi.
# Define image path
medium_text_path = "images/medium_text.png"

# Extract text
extracted_text = image_to_text(medium_text_path)
print(extracted_text)
Home > Tutorials » Data Engineering

Snowflake Tutorial For Beginners:
From Architecture to Running
Databases

Learn the fundamentals of cloud data warehouse management using
Snowflake. Snowflake is a cloud-based platform that offers significant
benefits for companies wanting to extract as much insight from their data as
quickly and efficiently as possible.

Jan 2024 - 12 min read
La nostra funzione ha funzionato quasi perfettamente. Ha confuso uno dei punti e i segni “>”, ma il risultato è comunque accettabile.
Un’operazione comune nell’OCR è disegnare riquadri di delimitazione attorno al testo. Questa operazione è supportata in PyTesseract.
Per prima cosa, passiamo un’immagine caricata alla funzione image_to_data:
from pytesseract import Output

# Extract recognized data from easy text
data = pytesseract.image_to_data(easy_img, output_type=Output.DICT)
La parte Output.DICT fa sì che i dettagli dell’immagine vengano restituiti come dizionario. Diamo un’occhiata dentro:
data{'level': [1, 2, 3, 4, 5, 5, 5, 4, 5, 5, 5],
'page_num': [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1],
'block_num': [0, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1],
'par_num': [0, 0, 1, 1, 1, 1, 1, 1, 1, 1, 1],
'line_num': [0, 0, 0, 1, 1, 1, 1, 2, 2, 2, 2],
'word_num': [0, 0, 0, 0, 1, 2, 3, 0, 1, 2, 3],
'left': [0, 41, 41, 236, 236, 734, 1242, 41, 41, 534, 841],
'top': [0, 68, 68, 68, 68, 80, 68, 284, 309, 284, 284],
'width': [1658, 1550, 1550, 1179, 380, 383, 173, 1550, 381, 184, 750],
'height': [469, 371, 371, 128, 128, 116, 128, 155, 130, 117, 117],
'conf': [-1, -1, -1, -1, 96, 95, 95, -1, 96, 96, 96],
'text': ['', '', '', '', 'This', 'text', 'is', '', 'easy', 'to', 'extract.']}
Il dizionario contiene molte informazioni sull’immagine. Innanzitutto, nota le chiavi conf e text. Entrambe hanno lunghezza 11:
len(data["text"])11Questo significa che pytesseract ha disegnato 11 riquadri. conf indica la confidenza. Se è uguale a -1, il riquadro corrispondente è disegnato attorno a blocchi di testo, e non a singole parole.
Per esempio, se guardi i primi quattro valori di width e height, sono grandi rispetto agli altri perché quei riquadri sono disegnati attorno all’intero testo centrale, poi a ciascuna riga di testo e all’immagine complessiva.
Inoltre:
left è la distanza dall’angolo in alto a sinistra del riquadro al bordo sinistro dell’immagine.top è la distanza dall’angolo in alto a sinistra del riquadro al bordo superiore dell’immagine.width e height sono larghezza e altezza del riquadro.Usando queste informazioni, disegniamo i riquadri sull’immagine con OpenCV.
Per prima cosa, estraiamo di nuovo i dati e la loro lunghezza:
from pytesseract import Output

# Extract recognized data
data = pytesseract.image_to_data(easy_img, output_type=Output.DICT)
n_boxes = len(data["text"])
Poi, creiamo un ciclo per il numero di riquadri trovati:
for i in range(n_boxes):
   if data["conf"][i] == -1:
       continue
All’interno del ciclo, creiamo una condizione che salta l’iterazione corrente se conf è uguale a -1. Saltare i riquadri più grandi manterrà l’immagine pulita.
Poi definiamo le coordinate del riquadro corrente, in particolare le posizioni degli angoli in alto a sinistra e in basso a destra:
for i in range(n_boxes):
   if data["conf"][i] == -1:
       continue
   # Coordinates
   x, y = data["left"][i], data["top"][i]
   w, h = data["width"][i], data["height"][i]

   # Corners
   top_left = (x, y)
   bottom_right = (x + w, y + h)
Dopo aver definito alcuni parametri del riquadro, come colore e spessore in pixel, passiamo tutte le informazioni alla funzione cv2.rectangle:
for i in range(n_boxes):
   if data["conf"][i] == -1:
       continue
   # Coordinates
   x, y = data["left"][i], data["top"][i]
   w, h = data["width"][i], data["height"][i]

   # Corners
   top_left = (x, y)
   bottom_right = (x + w, y + h)

   # Box params
   green = (0, 255, 0)
   thickness = 3  # pixels

   cv2.rectangle(
       img=easy_img, pt1=top_left, pt2=bottom_right, color=green, thickness=thickness
   )
La funzione disegnerà i riquadri sopra l’immagine originale. Salviamo l’immagine e diamo un’occhiata:
# Save the image
output_image_path = "images/text_with_boxes.jpg"
cv2.imwrite(output_image_path, easy_img)
True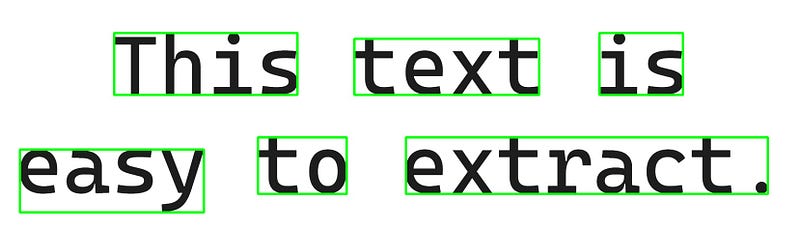
Il risultato è proprio quello che volevamo!
Ora mettiamo di nuovo tutto in una funzione:
def draw_bounding_boxes(input_img_path, output_path):
   img = cv2.imread(input_img_path)

   # Extract data
   data = pytesseract.image_to_data(img, output_type=Output.DICT)
   n_boxes = len(data["text"])

   for i in range(n_boxes):
       if data["conf"][i] == -1:
           continue
       # Coordinates
       x, y = data["left"][i], data["top"][i]
       w, h = data["width"][i], data["height"][i]

       # Corners
       top_left = (x, y)
       bottom_right = (x + w, y + h)

       # Box params
       green = (0, 255, 0)
       thickness = 1  # The function-version uses thinner lines

       cv2.rectangle(img, top_left, bottom_right, green, thickness)

   # Save the image with boxes
   cv2.imwrite(output_path, img)
E usiamo la funzione sul testo di difficoltà media:
output_path = "images/medium_text_with_boxes.png"

draw_bounding_boxes(medium_text_path, output_path)
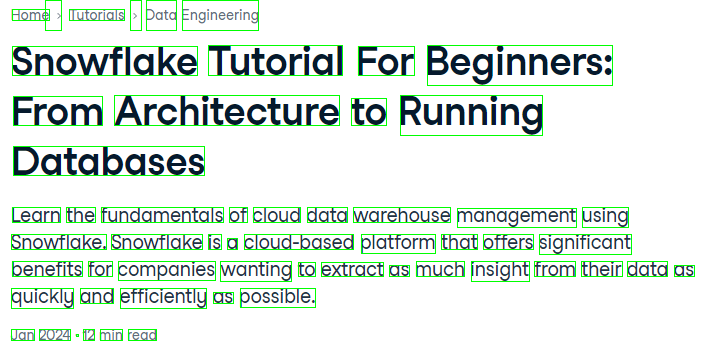
Anche per l’immagine più difficile, il risultato è perfetto!
Facciamo un caso di studio su un file PDF scansionato di esempio. In pratica, è molto probabile che lavorerai con PDF scansionati invece che con immagini, come questo:
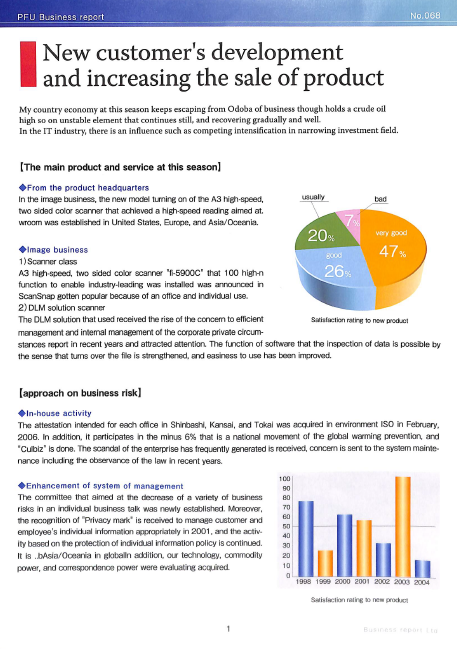
Puoi scaricare il PDF da questa pagina del mio GitHub.
Il passo successivo è installare la libreria pdf2image, che richiede un software di elaborazione PDF chiamato Poppler. Ecco le istruzioni specifiche per piattaforma:
Per Mac:
$ brew install poppler
$ pip install pdf2image
Per Linux e WSL2:
$ sudo apt-get install -y poppler-utils
$ pip install pdf2image
Per Windows, puoi seguire le istruzioni dalla documentazione di PDF2Image.
Dopo l’installazione, importiamo i moduli rilevanti:
import pathlib
from pathlib import Path

from pdf2image import convert_from_path
La funzione convert_from_path converte un dato PDF in una serie di immagini. Ecco una funzione che salva ciascuna pagina di un file PDF come immagine in una directory specificata:
def pdf_to_image(pdf_path, output_folder: str = "."):
   """
   A function to convert PDF files to images
   """
   # Create the output folder if it doesn't exist
   if not Path(output_folder).exists():
       Path(output_folder).mkdir()

   pages = convert_from_path(pdf_path, output_folder=output_folder, fmt="png")

   return pages
Eseguiamola sul nostro documento:
pdf_path = "scanned_document.pdf"

pdf_to_image(pdf_path, output_folder="documents")
[<PIL.PngImagePlugin.PngImageFile image mode=RGB size=1662x2341>]
L’output è un elenco che contiene un singolo oggetto immagine PngImageFile. Diamo un’occhiata alla directory documents:
$ ls documents
2d8f6922-99c4-4ef4-a475-ef81effe65a3-1.png
L’immagine c’è, quindi passiamola alla nostra funzione image_to_text creata all’inizio e stampiamo le prime qualche centinaio di caratteri del testo estratto:
scanned_img_path = "documents/2d8f6922-99c4-4ef4-a475-ef81effe65a3-1.png"

print(image_to_text(scanned_img_path)[:377])
PEU Business report

New customer's development
and increasing the sale of product

My country economy at this season keeps escaping from Odoba of business though holds a crude oil
high so on unstable element that continues still, and recovering gradually and well.
In the IT industry, there is an influence such as competing intensification in narrowing investment field.
Se confrontiamo il testo con il file, tutto funziona bene: formattazione e spaziatura sono preservate e il testo è accurato. Quindi, come condividiamo il testo estratto?
Be’, il formato migliore per condividere testo estratto da PDF è un altro file PDF! PyTesseract ha una funzione image_to_pdf_or_hocr che prende un’immagine con testo e la converte in un PDF grezzo, ricercabile. Usiamola sulla nostra immagine scansionata:
raw_pdf = pytesseract.image_to_pdf_or_hocr(scanned_img_path)

with open("searchable_pdf.pdf", "w+b") as f:
   f.write(bytearray(raw_pdf))
Ed ecco come appare searchable_pdf:
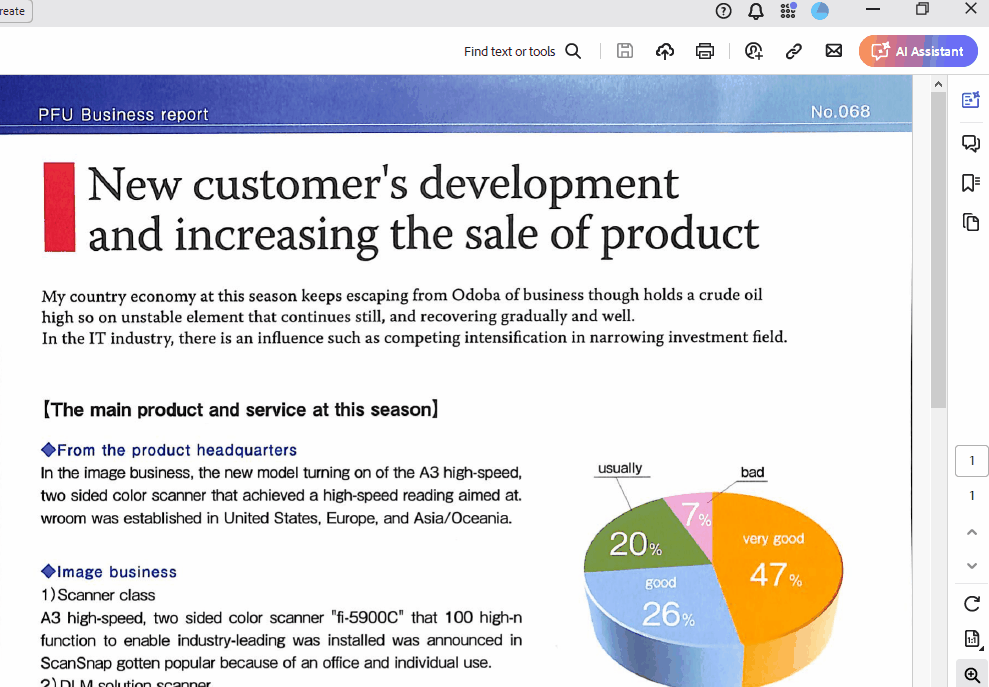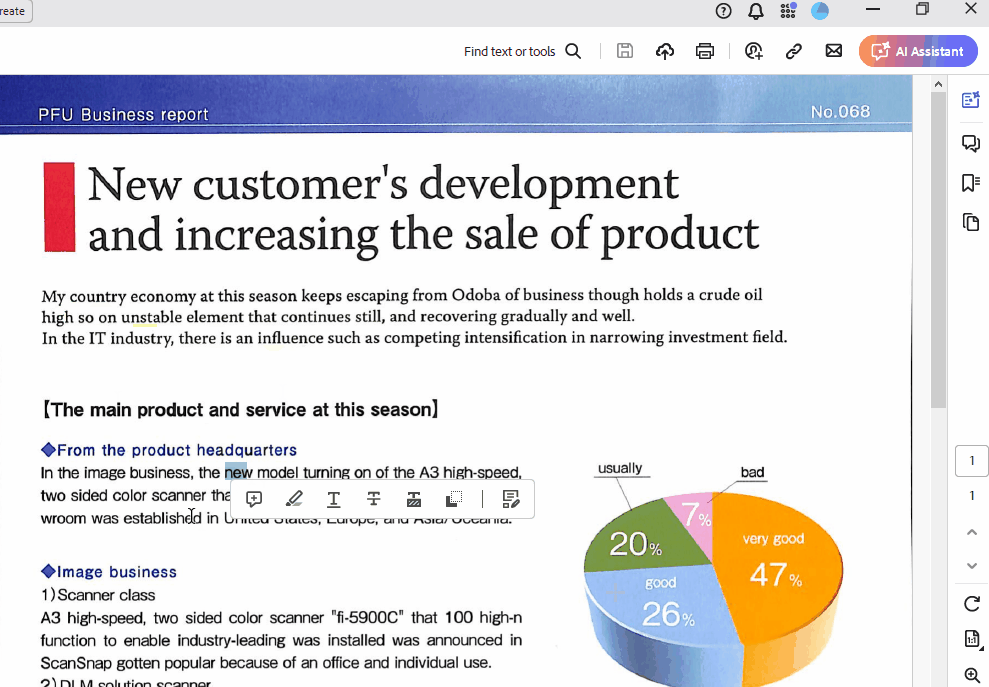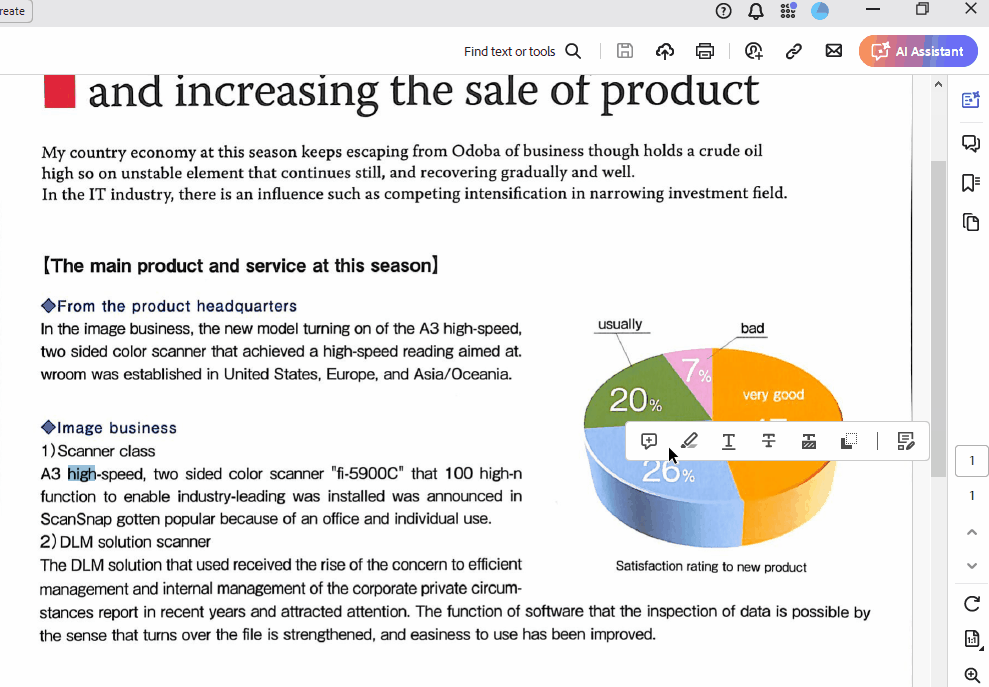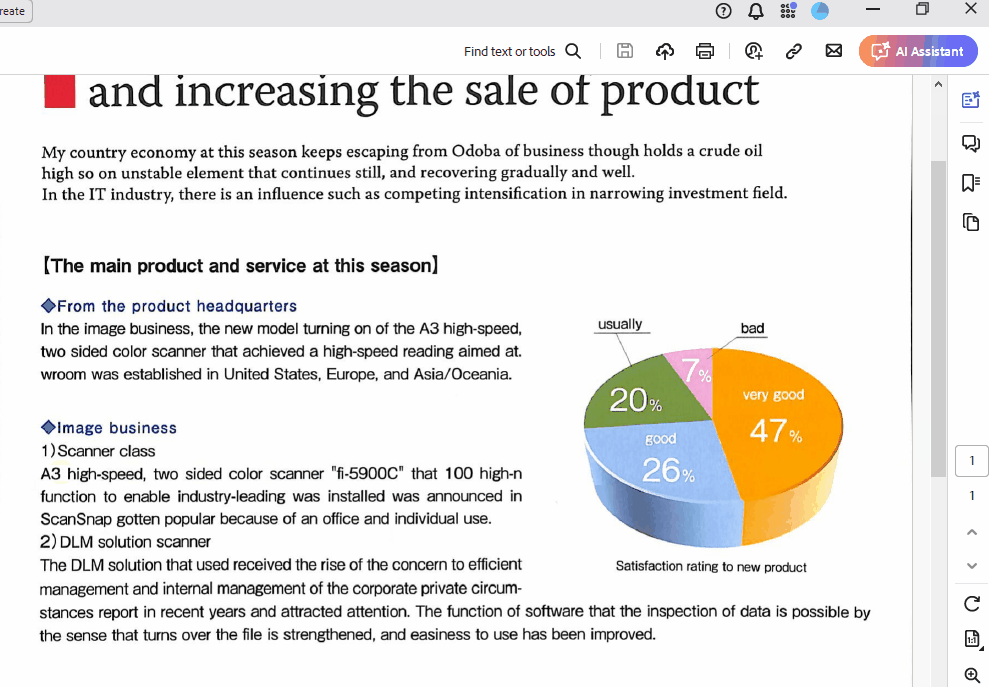
Come puoi vedere, posso evidenziare e copiare il testo dal file. Inoltre, tutti gli elementi del PDF originale sono preservati.
Non esiste un approccio valido per tutti per l’OCR. Le tecniche che abbiamo visto oggi potrebbero non funzionare con altri tipi di immagini. Ti consiglio di sperimentare diverse tecniche di pre-processing delle immagini e configurazioni di Tesseract per trovare le impostazioni ottimali per immagini specifiche.
Il fattore più importante nell’OCR è la qualità dell’immagine. Immagini scansionate correttamente, perfettamente verticali e ad alto contrasto (bianco e nero) tendono a funzionare meglio con qualsiasi software OCR. Ricorda: solo perché tu riesci a leggere il testo non significa che il tuo computer possa farlo.
Se le tue immagini non soddisfano gli elevati standard di qualità di Tesseract e l’output è incomprensibile, puoi eseguire alcuni passaggi di pre-processing.
Per prima cosa, inizia convertendo le immagini a colori in scala di grigi. Questo può migliorare l’accuratezza eliminando variazioni di colore che potrebbero confondere il processo di riconoscimento. In OpenCV, appare così:
def grayscale(image):
   """Converts an image to grayscale.

   Args:
       image: The input image in BGR format.

   Returns:
       The grayscale image.
   """
   return cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
Non tutte le immagini, soprattutto i documenti scansionati, hanno sfondi puliti e uniformi. Inoltre, alcune immagini possono provenire da documenti antichi in cui le pagine si sono deteriorate con il tempo. Ecco un esempio:
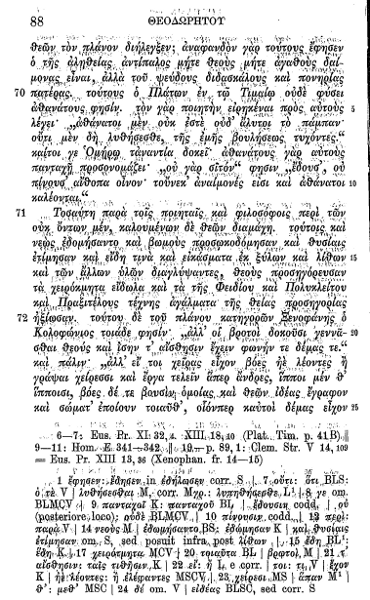
Applica tecniche come i filtri di denoising (ad es. blur mediano) per ridurre gli artefatti di rumore nell’immagine che possono portare a interpretazioni errate durante l’OCR. In OpenCV puoi usare la funzione medianBlur:
def denoise(image):
   """Reduces noise in the image using a median blur filter.

   Args:
       image: The input grayscale image.

   Returns:
       The denoised image.
   """
   return cv2.medianBlur(image, 5)  # Adjust kernel size as needed
In alcuni casi, aumentare la nitidezza dell’immagine può esaltare i bordi e migliorare il riconoscimento dei caratteri, soprattutto per immagini sfocate o a bassa risoluzione. Lo sharpening può essere eseguito applicando un filtro Laplaciano in OpenCV:
def sharpen(image):
   """Sharpens the image using a Laplacian filter.

   Args:
       image: The input grayscale image.

   Returns:
       The sharpened image (be cautious with sharpening).
   """
   kernel = np.array([[0, -1, 0], [-1, 5, -1], [0, -1, 0]])
   return cv2.filter2D(image, -1, kernel)
Per alcune immagini, la binarizzazione (conversione in bianco e nero) può essere utile. Sperimenta diverse tecniche di thresholding per trovare la separazione ottimale tra primo piano (testo) e sfondo.
Tuttavia, la binarizzazione può essere sensibile alle variazioni di illuminazione e non è sempre necessaria. Ecco come appare un’immagine binarizzata:
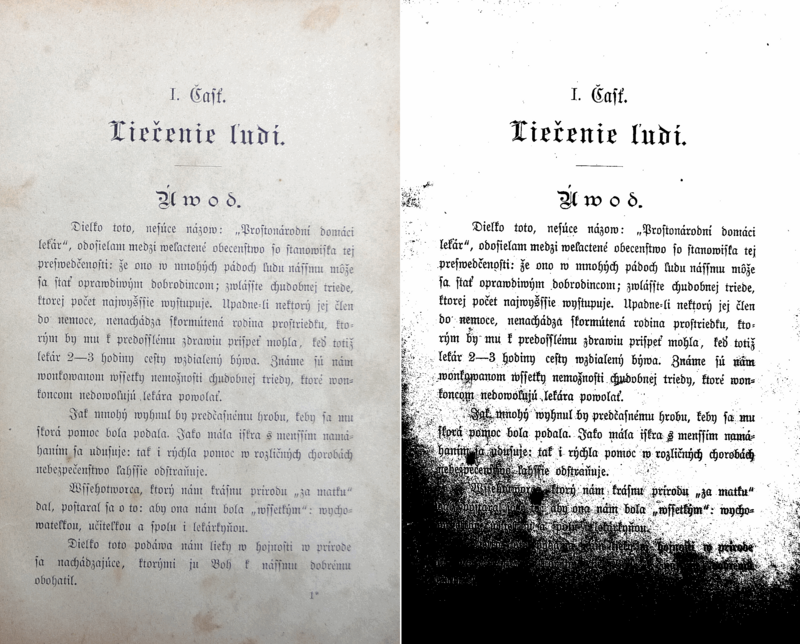
Per eseguire la binarizzazione in OpenCV, puoi usare la funzione adaptiveThreshold:
def binarize(image):
   """Binarizes the image using adaptive thresholding.

   Args:
       image: The input grayscale image.

   Returns:
       The binary image.
   """
   thresh = cv2.adaptiveThreshold(
       image, 255, cv2.ADAPTIVE_THRESH_MEAN_C, cv2.THRESH_BINARY, 11, 2
   )

   return thresh
Esistono molte altre tecniche di pre-processing, come:
Puoi approfondire il miglioramento della qualità delle immagini su questa pagina della documentazione di Tesseract.
In questo articolo hai mosso i primi passi per comprendere il problema dinamico dell’OCR. Abbiamo iniziato con l’estrazione di testo da immagini semplici, per poi passare a immagini più complesse con formattazioni articolate.
Abbiamo anche visto un flusso end-to-end per estrarre testo da PDF scansionati e come salvare nuovamente il testo estratto in un PDF, rendendolo ricercabile. Abbiamo concluso con alcuni suggerimenti per migliorare la qualità delle immagini con OpenCV prima di passarle a Tesseract.
Se vuoi approfondire i problemi legati alle immagini, ecco alcune risorse di computer vision da esplorare:
Continua il tuo percorso di apprendimento di Python!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



