
Cursus
Beeldverwerking in Python
4 uur
57K
Handmatig tekst uit afbeeldingen en documenten halen kan erg saai en tijdrovend zijn. Gelukkig kan OCR (Optical Character Recognition) dit proces automatiseren, zodat je die afbeeldingen kunt omzetten in bewerkbare en doorzoekbare tekstbestanden.
De technieken die je gaat leren, zijn toepasbaar in veel toepassingen:
De tutorial richt zich op de Tesseract OCR-engine en de Python-API daarvan: PyTesseract. Voordat we code gaan schrijven, bekijken we kort een paar populaire bibliotheken voor OCR.
Omdat OCR een populair en terugkerend probleem is, proberen veel open-sourcebibliotheken het op te lossen. In deze sectie behandelen we de bekendste dankzij hun hoge prestaties en nauwkeurigheid.
Tesseract OCR is een open-source engine voor optische tekenherkenning en is het populairst onder ontwikkelaars. Net als andere tools in deze lijst kan Tesseract tekstafbeeldingen omzetten naar bewerkbare tekst.
EasyOCR is een Python-bibliotheek die is ontworpen voor moeiteloze Optical Character Recognition (OCR). De naam zegt het al: het biedt een gebruiksvriendelijke manier om tekst uit afbeeldingen te halen.
Keras-OCR is een Python-bibliotheek gebouwd boven op Keras, een populair deep-learningframework. Het biedt kant-en-klare OCR-modellen en een end-to-end-trainingspipeline om nieuwe OCR-modellen te bouwen.
Hier is een tabel die de verschillen, voordelen en nadelen samenvat:
|
Pakketnaam |
Voordeel |
Nadelen |
|
Tesseract (pytesseract) |
Volwassen, veelgebruikt, brede ondersteuning |
Langzamer, lagere nauwkeurigheid bij complexe lay-outs |
|
EasyOCR |
Eenvoudig te gebruiken, meerdere modellen |
Lagere nauwkeurigheid, beperkte aanpasbaarheid |
|
Keras-OCR |
Hogere nauwkeurigheid, aanpasbaar |
Vereist GPU, steilere leercurve |
In deze tutorial focussen we op PyTesseract, de Python-API van Tesseract. We leren hoe je tekst uit eenvoudige afbeeldingen haalt, hoe je bounding boxes rond tekst tekent en we doen een casestudy met een gescand document.
PyTesseract draait boven op de officiële Tesseract-engine, die een aparte CLI-software is. Voordat je pytesseract installeert, moet de engine geïnstalleerd zijn. Hieronder vind je installatie-instructies voor verschillende platforms.
Voor Ubuntu of WSL2 (mijn keuze):
$ sudo apt update && sudo apt upgrade
$ sudo apt install tesseract-ocr
$ sudo apt install libtesseract-dev
Voor Mac met Homebrew:
$ brew install tesseract
Voor Windows volg je de instructies van deze GitHub-pagina.
Maak vervolgens een nieuwe virtuele omgeving. Ik gebruik Conda:
$ conda create -n ocr python==3.9 -y
$ conda activate ocr
Installeer daarna pytesseract voor OCR en opencv voor beeldbewerking:
$ pip install pytesseract
$ pip install opencv-python
Volg je deze tutorial in Jupyter, voer deze commando’s dan uit in dezelfde terminalsessie zodat je nieuwe virtuele omgeving als kernel wordt toegevoegd:
$ pip install ipykernel
$ ipython kernel install --user --name=ocr
Nu kunnen we beginnen met coderen.
We beginnen met het importeren van de benodigde bibliotheken:
import cv2
import pytesseract
Onze taak is om de tekst uit de volgende afbeelding te lezen:
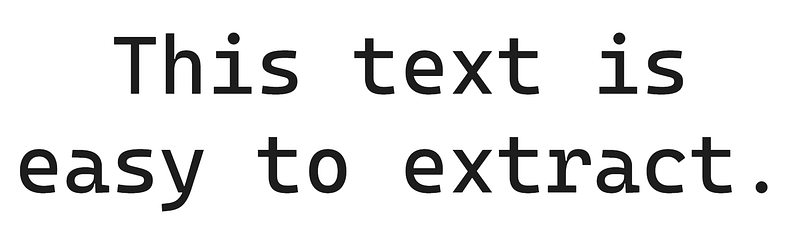
Eerst definiëren we het pad naar de afbeelding en geven dat door aan de functie cv2.imread:
# Read image
easy_text_path = "images/easy_text.png"
easy_img = cv2.imread(easy_text_path)
Daarna geven we de geladen afbeelding door aan de functie image_to_string van pytesseract om de tekst te extraheren:
# Convert to text
text = pytesseract.image_to_string(easy_img)
print(text)
This text is
easy to extract.
Zo simpel is het! Laten we omzetten wat we net deden in een functie:
def image_to_text(input_path):
   """
   A function to read text from images.
   """
   img = cv2.imread(input_path)
   text = pytesseract.image_to_string(img)

   return text.strip()
Laten we de functie gebruiken op een moeilijkere afbeelding:
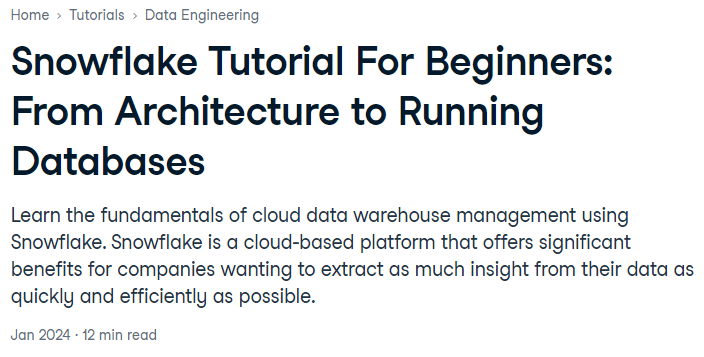
De afbeelding is uitdagender omdat er meer leestekens zijn en tekst in verschillende lettertypen.
# Define image path
medium_text_path = "images/medium_text.png"

# Extract text
extracted_text = image_to_text(medium_text_path)
print(extracted_text)
Home > Tutorials » Data Engineering

Snowflake Tutorial For Beginners:
From Architecture to Running
Databases

Learn the fundamentals of cloud data warehouse management using
Snowflake. Snowflake is a cloud-based platform that offers significant
benefits for companies wanting to extract as much insight from their data as
quickly and efficiently as possible.

Jan 2024 - 12 min read
Onze functie werkte bijna perfect. Er is verwarring tussen een van de punten en de tekens “>”, maar verder is het resultaat prima.
Een veelvoorkomende bewerking bij OCR is het tekenen van bounding boxes rond tekst. Deze bewerking wordt ondersteund in PyTesseract.
Eerst geven we een geladen afbeelding door aan de functie image_to_data:
from pytesseract import Output

# Extract recognized data from easy text
data = pytesseract.image_to_data(easy_img, output_type=Output.DICT)
Het deel Output.DICT zorgt ervoor dat de afbeeldingsdetails als een dictionary worden teruggegeven. Laten we binnenin kijken:
data{'level': [1, 2, 3, 4, 5, 5, 5, 4, 5, 5, 5],
'page_num': [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1],
'block_num': [0, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1],
'par_num': [0, 0, 1, 1, 1, 1, 1, 1, 1, 1, 1],
'line_num': [0, 0, 0, 1, 1, 1, 1, 2, 2, 2, 2],
'word_num': [0, 0, 0, 0, 1, 2, 3, 0, 1, 2, 3],
'left': [0, 41, 41, 236, 236, 734, 1242, 41, 41, 534, 841],
'top': [0, 68, 68, 68, 68, 80, 68, 284, 309, 284, 284],
'width': [1658, 1550, 1550, 1179, 380, 383, 173, 1550, 381, 184, 750],
'height': [469, 371, 371, 128, 128, 116, 128, 155, 130, 117, 117],
'conf': [-1, -1, -1, -1, 96, 95, 95, -1, 96, 96, 96],
'text': ['', '', '', '', 'This', 'text', 'is', '', 'easy', 'to', 'extract.']}
De dictionary bevat veel informatie over de afbeelding. Let eerst op de sleutels conf en text. Ze hebben allebei een lengte van 11:
len(data["text"])11Dit betekent dat pytesseract 11 vakken heeft getekend. conf staat voor confidence (zekerheid). Als deze gelijk is aan -1, dan is het betreffende vak rond tekstblokken getekend in plaats van individuele woorden.
Als je bijvoorbeeld naar de eerste vier waarden van width en height kijkt, zie je dat ze groot zijn vergeleken met de rest, omdat die vakken rond de volledige tekst in het midden zijn getekend, vervolgens per regel en tenslotte rond de hele afbeelding zelf.
Ook:
left is de afstand van de linkerbovenhoek van de bounding box tot de linkerrand van de afbeelding.top is de afstand van de linkerbovenhoek van de bounding box tot de bovenrand van de afbeelding.width en height zijn de breedte en hoogte van de bounding box.Met deze informatie tekenen we de vakken in OpenCV boven op de afbeelding.
Eerst extraheren we de data opnieuw en de lengte ervan:
from pytesseract import Output

# Extract recognized data
data = pytesseract.image_to_data(easy_img, output_type=Output.DICT)
n_boxes = len(data["text"])
Vervolgens maken we een lus voor het aantal gevonden vakken:
for i in range(n_boxes):
   if data["conf"][i] == -1:
       continue
Binnen de lus maken we een voorwaarde die de huidige iteratie overslaat als conf gelijk is aan -1. Door grotere bounding boxes over te slaan, blijft onze afbeelding overzichtelijk.
Daarna definiëren we de coördinaten van het huidige vak, specifiek de posities van de linkerboven- en rechteronderhoek:
for i in range(n_boxes):
   if data["conf"][i] == -1:
       continue
   # Coordinates
   x, y = data["left"][i], data["top"][i]
   w, h = data["width"][i], data["height"][i]

   # Corners
   top_left = (x, y)
   bottom_right = (x + w, y + h)
Na het definiëren van wat parameters, zoals de kleur en de lijndikte in pixels, geven we alles door aan de functie cv2.rectangle:
for i in range(n_boxes):
   if data["conf"][i] == -1:
       continue
   # Coordinates
   x, y = data["left"][i], data["top"][i]
   w, h = data["width"][i], data["height"][i]

   # Corners
   top_left = (x, y)
   bottom_right = (x + w, y + h)

   # Box params
   green = (0, 255, 0)
   thickness = 3  # pixels

   cv2.rectangle(
       img=easy_img, pt1=top_left, pt2=bottom_right, color=green, thickness=thickness
   )
De functie tekent de vakken boven op de originele afbeeldingen. Laten we de afbeelding opslaan en bekijken:
# Save the image
output_image_path = "images/text_with_boxes.jpg"
cv2.imwrite(output_image_path, easy_img)
True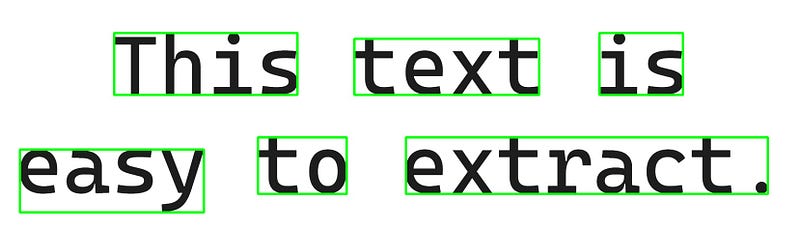
Het resultaat is precies wat we wilden!
Laten we nu alles wat we deden opnieuw in een functie gieten:
def draw_bounding_boxes(input_img_path, output_path):
   img = cv2.imread(input_img_path)

   # Extract data
   data = pytesseract.image_to_data(img, output_type=Output.DICT)
   n_boxes = len(data["text"])

   for i in range(n_boxes):
       if data["conf"][i] == -1:
           continue
       # Coordinates
       x, y = data["left"][i], data["top"][i]
       w, h = data["width"][i], data["height"][i]

       # Corners
       top_left = (x, y)
       bottom_right = (x + w, y + h)

       # Box params
       green = (0, 255, 0)
       thickness = 1  # The function-version uses thinner lines

       cv2.rectangle(img, top_left, bottom_right, green, thickness)

   # Save the image with boxes
   cv2.imwrite(output_path, img)
En gebruik de functie op de middelmoeilijke tekst:
output_path = "images/medium_text_with_boxes.png"

draw_bounding_boxes(medium_text_path, output_path)
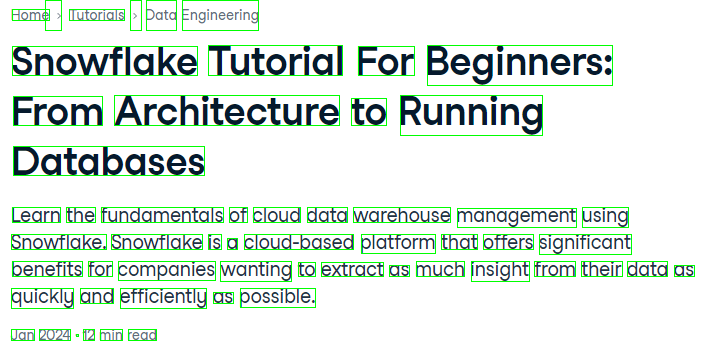
Zelfs bij de lastigere afbeelding is het resultaat perfect!
Laten we een casestudy doen op een voorbeeld van een gescand pdf-bestand. In de praktijk werk je zeer waarschijnlijk met gescande pdf’s in plaats van afbeeldingen, zoals deze:
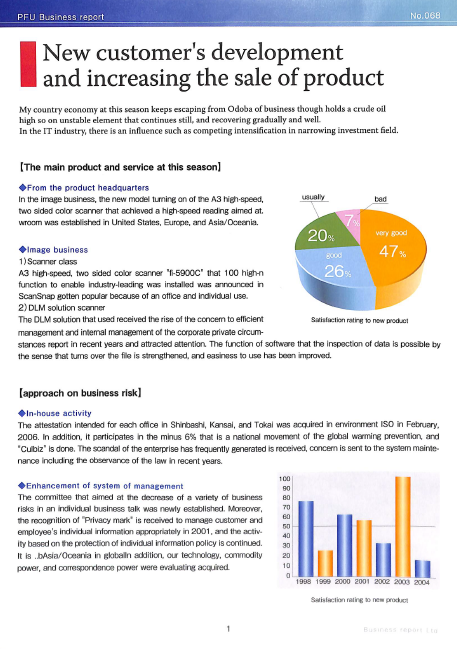
Je kunt de pdf downloaden van deze pagina van mijn GitHub.
De volgende stap is het installeren van de bibliotheek pdf2image, die PDF-verwerkingssoftware genaamd Poppler vereist. Hier zijn platformspecifieke instructies:
Voor Mac:
$ brew install poppler
$ pip install pdf2image
Voor Linux en WSL2:
$ sudo apt-get install -y poppler-utils
$ pip install pdf2image
Voor Windows kun je de instructies volgen uit de PDF2Image-documentatie.
Na de installatie importeren we de relevante modules:
import pathlib
from pathlib import Path

from pdf2image import convert_from_path
De functie convert_from_path zet een gegeven pdf om naar een reeks afbeeldingen. Hier is een functie die elke pagina van een pdf opslaat als afbeelding in een opgegeven map:
def pdf_to_image(pdf_path, output_folder: str = "."):
   """
   A function to convert PDF files to images
   """
   # Create the output folder if it doesn't exist
   if not Path(output_folder).exists():
       Path(output_folder).mkdir()

   pages = convert_from_path(pdf_path, output_folder=output_folder, fmt="png")

   return pages
Laten we dit uitvoeren op ons document:
pdf_path = "scanned_document.pdf"

pdf_to_image(pdf_path, output_folder="documents")
[<PIL.PngImagePlugin.PngImageFile image mode=RGB size=1662x2341>]
De output is een lijst met één PngImageFile-object. Laten we kijken naar de map documents:
$ ls documents
2d8f6922-99c4-4ef4-a475-ef81effe65a3-1.png
De afbeelding staat er, dus laten we deze door onze functie image_to_text halen die we aan het begin hebben gemaakt en de eerste paar honderd tekens van de geëxtraheerde tekst printen:
scanned_img_path = "documents/2d8f6922-99c4-4ef4-a475-ef81effe65a3-1.png"

print(image_to_text(scanned_img_path)[:377])
PEU Business report

New customer's development
and increasing the sale of product

My country economy at this season keeps escaping from Odoba of business though holds a crude oil
high so on unstable element that continues still, and recovering gradually and well.
In the IT industry, there is an influence such as competing intensification in narrowing investment field.
Als we de tekst met het bestand vergelijken, werkt alles goed — de opmaak en spatiëring blijven behouden en de tekst is accuraat. Hoe delen we de geëxtraheerde tekst?
Het beste formaat om geëxtraheerde pdf-tekst te delen is een nieuwe pdf! PyTesseract heeft een functie image_to_pdf_or_hocr die elke afbeelding met tekst omzet naar een ruwe, doorzoekbare pdf. Laten we die gebruiken op onze gescande afbeelding:
raw_pdf = pytesseract.image_to_pdf_or_hocr(scanned_img_path)

with open("searchable_pdf.pdf", "w+b") as f:
   f.write(bytearray(raw_pdf))
En zo ziet de searchable_pdf eruit:
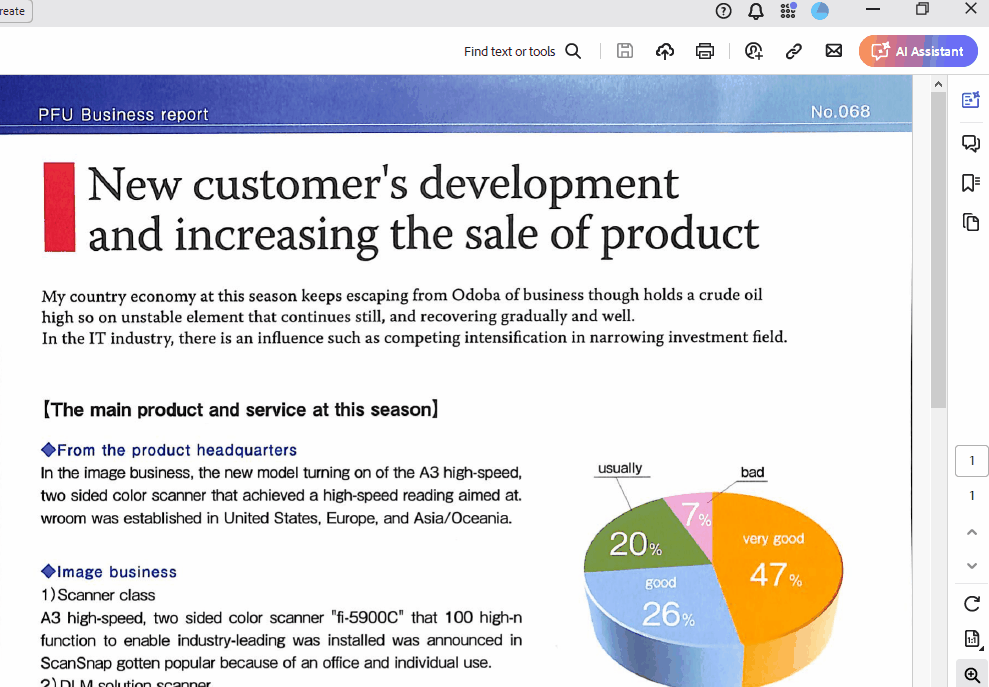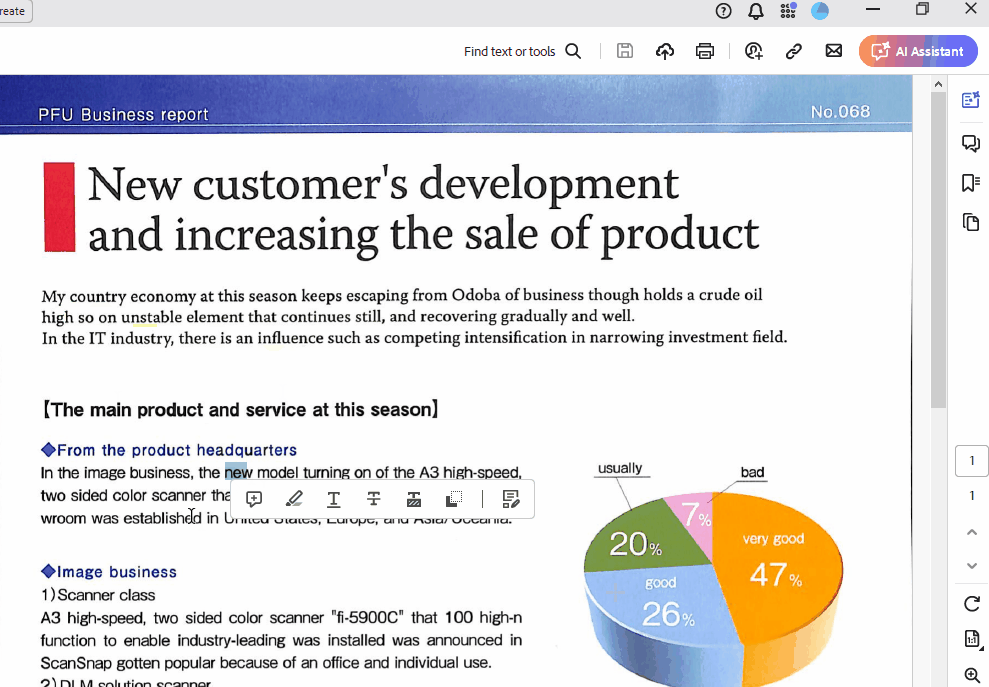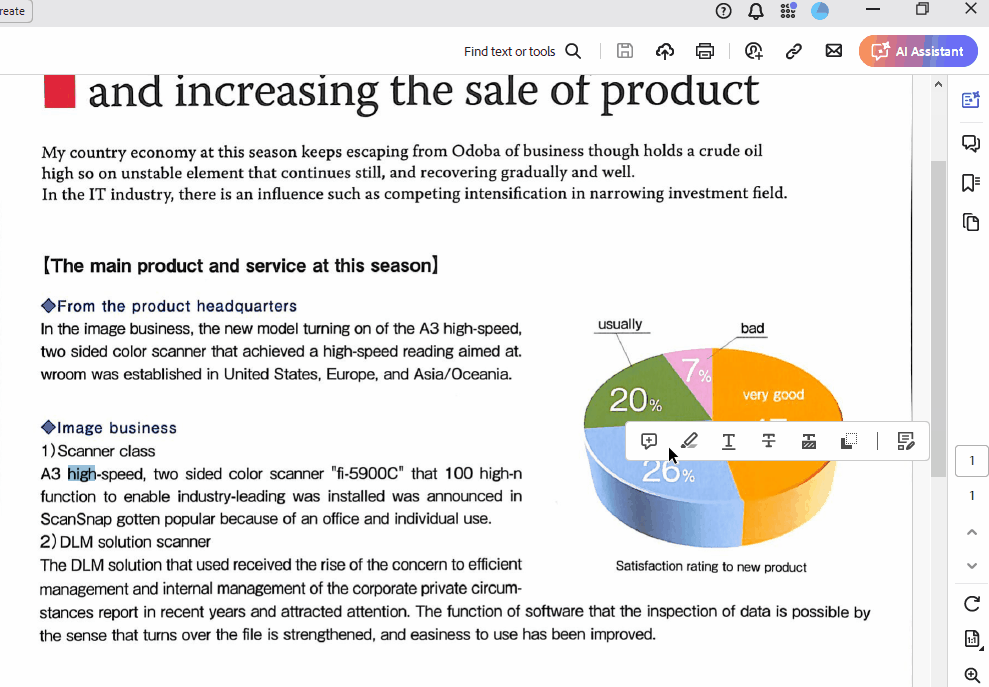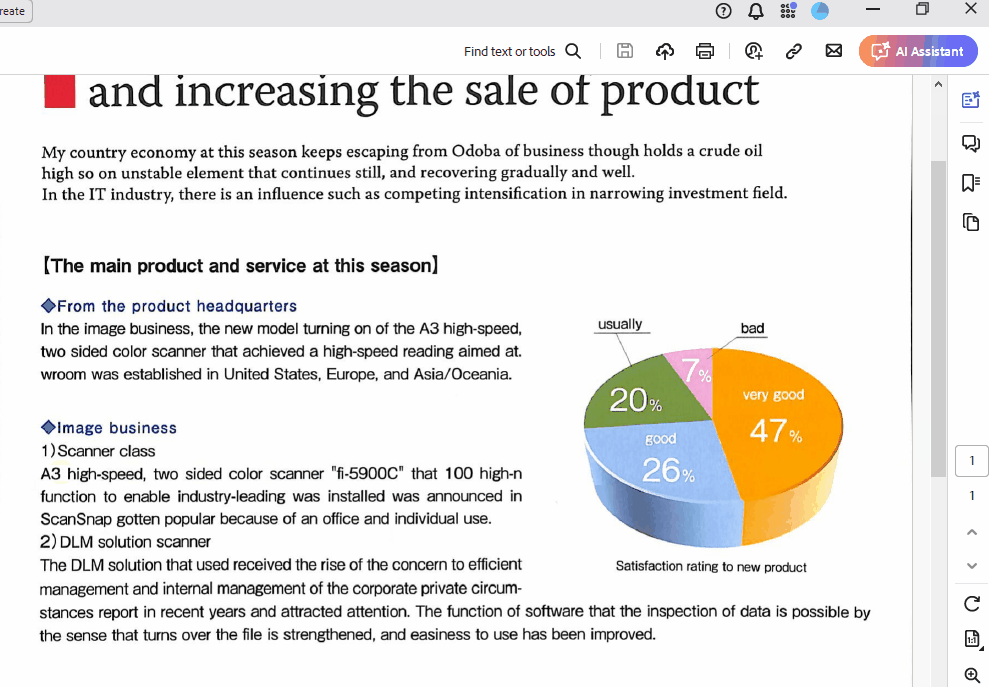
Zoals je ziet kan ik tekst markeren en kopiëren uit het bestand. Bovendien blijven alle elementen van de originele pdf behouden.
Er is geen one-size-fits-all-aanpak voor OCR. De technieken die we vandaag hebben behandeld, werken mogelijk niet voor andere soorten afbeeldingen. Ik raad je aan te experimenteren met verschillende technieken voor beeldvoorbewerking en Tesseract-configuraties om de optimale instellingen voor specifieke afbeeldingen te vinden.
De belangrijkste factor bij OCR is de beeldkwaliteit. Correct gescande, volledig verticale en contrastrijke (zwart-wit) afbeeldingen werken doorgaans het best met elke OCR-software. Onthoud: alleen omdat jij de tekst kunt lezen, betekent niet dat je computer dat ook kan.
Als je afbeeldingen niet aan de hoge kwaliteitsnormen van Tesseract voldoen en de output onsamenhangend is, kun je enkele voorbewerkingsstappen uitvoeren.
Begin met het omzetten van gekleurde afbeeldingen naar grijswaarden. Dit kan de nauwkeurigheid verbeteren door kleurvariaties te verwijderen die het herkenningsproces kunnen verwarren. In OpenCV ziet dat er zo uit:
def grayscale(image):
   """Converts an image to grayscale.

   Args:
       image: The input image in BGR format.

   Returns:
       The grayscale image.
   """
   return cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
Niet alle afbeeldingen, vooral gescande documenten, hebben vlekkeloze, egale achtergronden. Sommige afbeeldingen komen ook uit oude documenten waarvan de pagina’s door de jaren heen zijn aangetast. Hier is een voorbeeld:
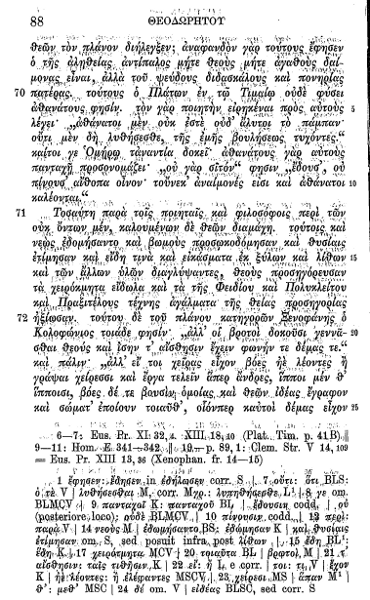
Pas technieken toe zoals denoise-filters (bijv. median blur) om ruisartefacten in de afbeelding te verminderen die tot verkeerde interpretaties tijdens OCR kunnen leiden. In OpenCV kun je de functie medianBlur gebruiken:
def denoise(image):
   """Reduces noise in the image using a median blur filter.

   Args:
       image: The input grayscale image.

   Returns:
       The denoised image.
   """
   return cv2.medianBlur(image, 5)  # Adjust kernel size as needed
In sommige gevallen kan het verscherpen van de afbeelding randen versterken en de tekenherkenning verbeteren, vooral bij vage of afbeeldingen met lage resolutie. Verscherpen kan worden uitgevoerd met een Laplace-filter in OpenCV:
def sharpen(image):
   """Sharpens the image using a Laplacian filter.

   Args:
       image: The input grayscale image.

   Returns:
       The sharpened image (be cautious with sharpening).
   """
   kernel = np.array([[0, -1, 0], [-1, 5, -1], [0, -1, 0]])
   return cv2.filter2D(image, -1, kernel)
Voor bepaalde afbeeldingen kan binarisatie (de afbeelding omzetten naar zwart-wit) nuttig zijn. Experimenteer met verschillende drempeltechnieken om de optimale scheiding tussen voorgrond (tekst) en achtergrond te vinden.
Binarisatie kan echter gevoelig zijn voor lichtvariaties en is niet altijd nodig. Hier is een voorbeeld van hoe een gebinariseerde afbeelding eruitziet:
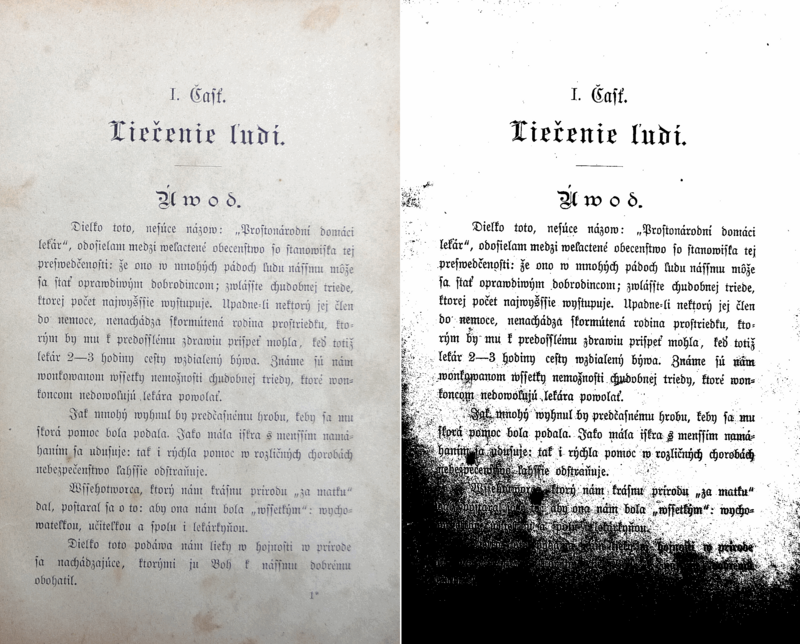
Om binarisatie in OpenCV uit te voeren, kun je de functie adaptiveThreshold gebruiken:
def binarize(image):
   """Binarizes the image using adaptive thresholding.

   Args:
       image: The input grayscale image.

   Returns:
       The binary image.
   """
   thresh = cv2.adaptiveThreshold(
       image, 255, cv2.ADAPTIVE_THRESH_MEAN_C, cv2.THRESH_BINARY, 11, 2
   )

   return thresh
Er zijn veel andere voorbewerkingstechnieken, zoals:
Je kunt meer leren over het verbeteren van beeldkwaliteit op deze pagina van de Tesseract-documentatie.
In dit artikel heb je de eerste stappen gezet om het dynamische probleem van OCR te leren kennen. We hebben eerst behandeld hoe je tekst uit eenvoudige afbeeldingen haalt, en zijn daarna overgestapt op moeilijkere afbeeldingen met complexe opmaak.
We hebben ook een end-to-end workflow geleerd om tekst uit gescande pdf’s te halen en hoe je de geëxtraheerde tekst weer als pdf opslaat zodat die doorzoekbaar wordt. We sloten af met wat tips om de beeldkwaliteit te verbeteren met OpenCV voordat je het aan Tesseract voert.
Wil je meer leren over het oplossen van beeldgerelateerde problemen, bekijk dan deze computer vision-bronnen:
Zet je Python-leerreis voort!
Cursus
Leerpad
Leerpad
blog
Adel Nehme
15 min

