
{count, plural, one {कोर्स} other {कोर्स}}
Python में इमेज प्रोसेसिंग
{hours} घंटा
57K
छवियों और दस्तावेज़ों से मैन्युअल रूप से पाठ निकालना बहुत थकाऊ और समय लेने वाला हो सकता है। सौभाग्य से, OCR (Optical Character Recognition) इस प्रक्रिया को स्वचालित कर सकता है, जिससे आप ऐसी छवियों को संपादन योग्य और खोज योग्य टेक्स्ट फ़ाइलों में बदल सकते हैं।
आप जिन तकनीकों को सीखने जा रहे हैं, वे कई अनुप्रयोगों में लागू की जा सकती हैं:
यह ट्यूटोरियल Tesseract OCR इंजन और उसके Python API - PyTesseract पर केंद्रित होगा। कोड लिखना शुरू करने से पहले, आइए संक्षेप में OCR के लिए समर्पित कुछ लोकप्रिय लाइब्रेरी की समीक्षा करें।
चूंकि OCR एक लोकप्रिय और निरंतर विकसित होती समस्या है, कई ओपन-सोर्स लाइब्रेरी इसे हल करने की कोशिश करती हैं। इस अनुभाग में, हम उन लाइब्रेरी को कवर करेंगे जो उच्च प्रदर्शन और सटीकता के कारण सबसे अधिक लोकप्रिय हुई हैं।
Tesseract OCR एक ओपन-सोर्स ऑप्टिकल कैरेक्टर रिकॉग्निशन इंजन है जो डेवलपर्स के बीच सबसे लोकप्रिय है। इस सूची के अन्य टूल्स की तरह, Tesseract टेक्स्ट वाली छवियों को लेकर उन्हें संपादन योग्य टेक्स्ट में बदल सकता है।
EasyOCR एक Python लाइब्रेरी है जिसे आसान Optical Character Recognition (OCR) के लिए डिज़ाइन किया गया है। यह अपनी नामानुसार छवियों से टेक्स्ट निकालने के लिए उपयोगकर्ता-अनुकूल तरीका प्रदान करती है।
Keras-OCR, Keras (एक लोकप्रिय डीप लर्निंग फ़्रेमवर्क) पर आधारित Python लाइब्रेरी है। यह आउट-ऑफ-द-बॉक्स OCR मॉडल्स और नए OCR मॉडल बनाने के लिए एंड-टू-एंड ट्रेनिंग पाइपलाइन प्रदान करती है।
यहाँ उनके अंतर, फायदे और नुकसान का सारांश देने वाली एक तालिका है:
|
पैकेज का नाम |
फायदा |
नुकसान |
|
Tesseract (pytesseract) |
परिपक्व, व्यापक रूप से उपयोगी, विस्तृत समर्थन |
धीमा, जटिल लेआउट पर कम सटीकता |
|
EasyOCR |
उपयोग में सरल, कई मॉडल |
कम सटीकता, सीमित कस्टमाइज़ेशन |
|
Keras-OCR |
उच्च सटीकता, कस्टमाइज़ेबल |
GPU आवश्यक, सीखने की ढलान अधिक |
इस ट्यूटोरियल में, हम PyTesseract पर ध्यान देंगे, जो Tesseract का Python API है। हम सीखेंगे कि साधारण छवियों से टेक्स्ट कैसे निकाला जाए, टेक्स्ट के चारों ओर बॉन्डिंग बॉक्स कैसे बनाए जाएँ, और एक स्कैन किए गए दस्तावेज़ के साथ केस स्टडी कैसे की जाए।
PyTesseract आधिकारिक Tesseract इंजन के ऊपर काम करता है, जो एक अलग CLI सॉफ़्टवेयर है। pytesseract इंस्टॉल करने से पहले, आपके सिस्टम में यह इंजन इंस्टॉल होना चाहिए। नीचे विभिन्न प्लेटफ़ॉर्म के लिए इंस्टॉलेशन निर्देश दिए गए हैं।
Ubuntu या WSL2 (मेरा चुनाव) के लिए:
$ sudo apt update && sudo apt upgrade
$ sudo apt install tesseract-ocr
$ sudo apt install libtesseract-dev
Mac के लिए (Homebrew के साथ):
$ brew install tesseract
Windows के लिए, इस GitHub पेज के निर्देशों का पालन करें।
इसके बाद, एक नया वर्चुअल एनवायरनमेंट बनाएँ। मैं Conda उपयोग करूँगा:
$ conda create -n ocr python==3.9 -y
$ conda activate ocr
फिर, आपको OCR के लिए pytesseract और इमेज मैनिपुलेशन के लिए opencv इंस्टॉल करना होगा:
$ pip install pytesseract
$ pip install opencv-python
यदि आप यह ट्यूटोरियल Jupyter में फॉलो कर रहे हैं, तो इन्हीं कमांड्स को उसी टर्मिनल सत्र में चलाएँ ताकि आपका नया वर्चुअल एनवायरनमेंट एक कर्नेल के रूप में जुड़ जाए:
$ pip install ipykernel
$ ipython kernel install --user --name=ocr
अब, हम कोड लिखना शुरू कर सकते हैं।
हम आवश्यक लाइब्रेरी आयात करके शुरू करते हैं:
import cv2
import pytesseract
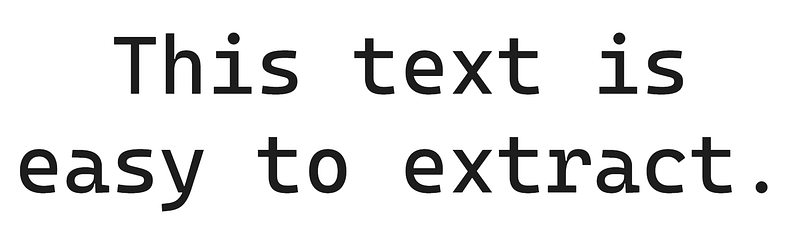
हमारा कार्य निम्न छवि से टेक्स्ट पढ़ना है:
सबसे पहले, हम इमेज पाथ परिभाषित करते हैं और उसे cv2.imread फ़ंक्शन को देते हैं:
# Read image
easy_text_path = "images/easy_text.png"
easy_img = cv2.imread(easy_text_path)
फिर, लोड की गई इमेज को pytesseract के image_to_string फ़ंक्शन में पास करके टेक্স्ट निकालते हैं:
# Convert to text
text = pytesseract.image_to_string(easy_img)
print(text)
This text is
easy to extract.
बिल्कुल इतना ही आसान! आइए जो हमने अभी किया उसे एक फ़ंक्शन में बदल दें:
def image_to_text(input_path):
   """
   A function to read text from images.
   """
   img = cv2.imread(input_path)
   text = pytesseract.image_to_string(img)

   return text.strip()
आइए इस फ़ंक्शन का उपयोग एक अधिक कठिन छवि पर करें:
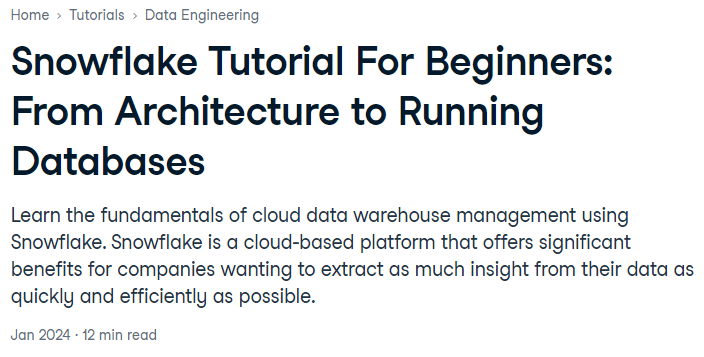
यह छवि अधिक चुनौतीपूर्ण है क्योंकि इसमें अधिक विराम चिह्न और अलग-अलग फ़ॉन्ट में टेक्स्ट है।
# Define image path
medium_text_path = "images/medium_text.png"

# Extract text
extracted_text = image_to_text(medium_text_path)
print(extracted_text)
Home > Tutorials » Data Engineering

Snowflake Tutorial For Beginners:
From Architecture to Running
Databases

Learn the fundamentals of cloud data warehouse management using
Snowflake. Snowflake is a cloud-based platform that offers significant
benefits for companies wanting to extract as much insight from their data as
quickly and efficiently as possible.

Jan 2024 - 12 min read
हमारा फ़ंक्शन लगभग पूरी तरह से काम कर गया। इसने एक डॉट और “>” चिह्न में भ्रम किया, लेकिन अन्यथा परिणाम स्वीकार्य है।
OCR में एक सामान्य क्रिया टेक्स्ट के चारों ओर बॉन्डिंग बॉक्स बनाना है। यह क्रिया PyTesseract में समर्थित है।
सबसे पहले, हम लोड की गई इमेज को image_to_data फ़ंक्शन में पास करते हैं:
from pytesseract import Output

# Extract recognized data from easy text
data = pytesseract.image_to_data(easy_img, output_type=Output.DICT)
Output.DICT भाग यह सुनिश्चित करता है कि इमेज विवरण एक डिक्शनरी के रूप में लौटे। आइए अंदर झाँकते हैं:
data{'level': [1, 2, 3, 4, 5, 5, 5, 4, 5, 5, 5],
'page_num': [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1],
'block_num': [0, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1],
'par_num': [0, 0, 1, 1, 1, 1, 1, 1, 1, 1, 1],
'line_num': [0, 0, 0, 1, 1, 1, 1, 2, 2, 2, 2],
'word_num': [0, 0, 0, 0, 1, 2, 3, 0, 1, 2, 3],
'left': [0, 41, 41, 236, 236, 734, 1242, 41, 41, 534, 841],
'top': [0, 68, 68, 68, 68, 80, 68, 284, 309, 284, 284],
'width': [1658, 1550, 1550, 1179, 380, 383, 173, 1550, 381, 184, 750],
'height': [469, 371, 371, 128, 128, 116, 128, 155, 130, 117, 117],
'conf': [-1, -1, -1, -1, 96, 95, 95, -1, 96, 96, 96],
'text': ['', '', '', '', 'This', 'text', 'is', '', 'easy', 'to', 'extract.']}
डिक्शनरी में इमेज के बारे में बहुत-सी जानकारी है। पहले, conf और text कुंजियों पर ध्यान दें। दोनों की लंबाई 11 है:
len(data["text"])11इसका मतलब है कि pytesseract ने 11 बॉक्स बनाए। conf का अर्थ confidence है। यदि यह -1 के बराबर है, तो संबंधित बॉक्स व्यक्तिगत शब्दों के बजाय टेक्स्ट ब्लॉक के चारों ओर बनाया जाता है।
उदाहरण के लिए, यदि आप पहले चार width और height मानों को देखें, तो वे बाकी की तुलना में बड़े हैं क्योंकि वे बॉक्स पूरे मध्य टेक्स्ट, फिर प्रत्येक पंक्ति और फिर पूरी इमेज के चारों ओर बनाए गए हैं।
साथ ही:
left बॉन्डिंग बॉक्स के ऊपरी-बाएँ कोने से इमेज की बाएँ सीमा तक की दूरी है।top बॉन्डिंग बॉक्स के ऊपरी-बाएँ कोने से इमेज की ऊपरी सीमा तक की दूरी है।width और height बॉन्डिंग बॉक्स की चौड़ाई और ऊँचाई हैं।इन जानकारियों का उपयोग करके, आइए OpenCV में इमेज पर बॉक्स बनाते हैं।
पहले, हम फिर से डेटा और उसकी लंबाई निकालते हैं:
from pytesseract import Output

# Extract recognized data
data = pytesseract.image_to_data(easy_img, output_type=Output.DICT)
n_boxes = len(data["text"])
फिर, हम मिले बॉक्सों की संख्या के लिए एक लूप बनाते हैं:
for i in range(n_boxes):
   if data["conf"][i] == -1:
       continue
लूप के अंदर, हम एक शर्त बनाते हैं जो conf -1 होने पर वर्तमान इटरेशन को छोड़ देती है। बड़े बॉन्डिंग बॉक्स छोड़ने से हमारी इमेज साफ़ रहेगी।
फिर, हम वर्तमान बॉक्स के निर्देशांक परिभाषित करते हैं, विशेषकर ऊपरी-बाएँ और निचले-दाएँ कोनों के स्थान:
for i in range(n_boxes):
   if data["conf"][i] == -1:
       continue
   # Coordinates
   x, y = data["left"][i], data["top"][i]
   w, h = data["width"][i], data["height"][i]

   # Corners
   top_left = (x, y)
   bottom_right = (x + w, y + h)
कुछ बॉक्स पैरामीटर (जैसे रंग और पिक्सेल में मोटाई) परिभाषित करने के बाद, हम सारी जानकारी cv2.rectangle फ़ंक्शन को पास करते हैं:
for i in range(n_boxes):
   if data["conf"][i] == -1:
       continue
   # Coordinates
   x, y = data["left"][i], data["top"][i]
   w, h = data["width"][i], data["height"][i]

   # Corners
   top_left = (x, y)
   bottom_right = (x + w, y + h)

   # Box params
   green = (0, 255, 0)
   thickness = 3  # pixels

   cv2.rectangle(
       img=easy_img, pt1=top_left, pt2=bottom_right, color=green, thickness=thickness
   )
यह फ़ंक्शन मूल इमेज के ऊपर बॉक्स बना देगा। आइए इमेज को सेव करें और देखें:
# Save the image
output_image_path = "images/text_with_boxes.jpg"
cv2.imwrite(output_image_path, easy_img)
True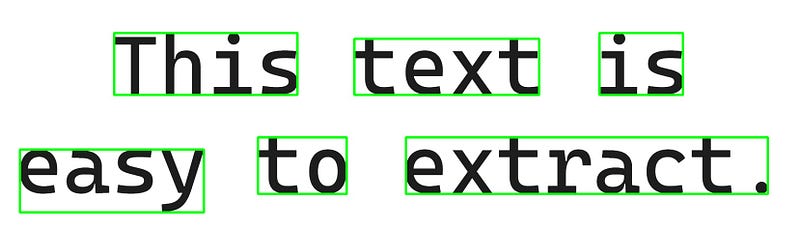
परिणाम बिल्कुल वैसा ही है जैसा हम चाहते थे!
अब, आइए जो कुछ भी हमने किया उसे फिर से एक फ़ंक्शन में डालते हैं:
def draw_bounding_boxes(input_img_path, output_path):
   img = cv2.imread(input_img_path)

   # Extract data
   data = pytesseract.image_to_data(img, output_type=Output.DICT)
   n_boxes = len(data["text"])

   for i in range(n_boxes):
       if data["conf"][i] == -1:
           continue
       # Coordinates
       x, y = data["left"][i], data["top"][i]
       w, h = data["width"][i], data["height"][i]

       # Corners
       top_left = (x, y)
       bottom_right = (x + w, y + h)

       # Box params
       green = (0, 255, 0)
       thickness = 1  # The function-version uses thinner lines

       cv2.rectangle(img, top_left, bottom_right, green, thickness)

   # Save the image with boxes
   cv2.imwrite(output_path, img)
और इस फ़ंक्शन का उपयोग मध्यम-कठिन टेक्स्ट पर करें:
output_path = "images/medium_text_with_boxes.png"

draw_bounding_boxes(medium_text_path, output_path)
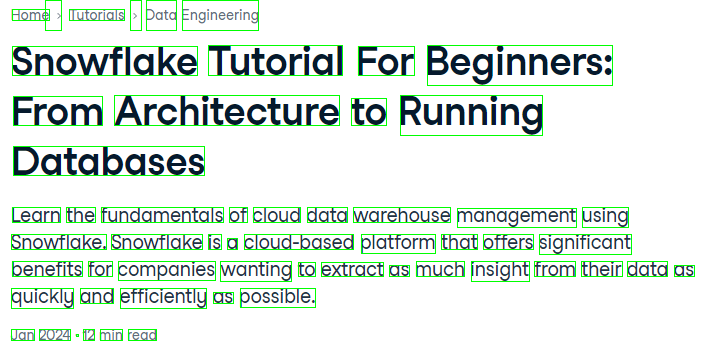
कठिन छवि के लिए भी, परिणाम बेहतरीन है!
आइए एक नमूना स्कैन किए गए PDF फ़ाइल पर केस स्टडी करें। व्यवहार में, संभावना है कि आप छवियों के बजाय स्कैन किए गए PDF के साथ काम करेंगे, जैसे यह:
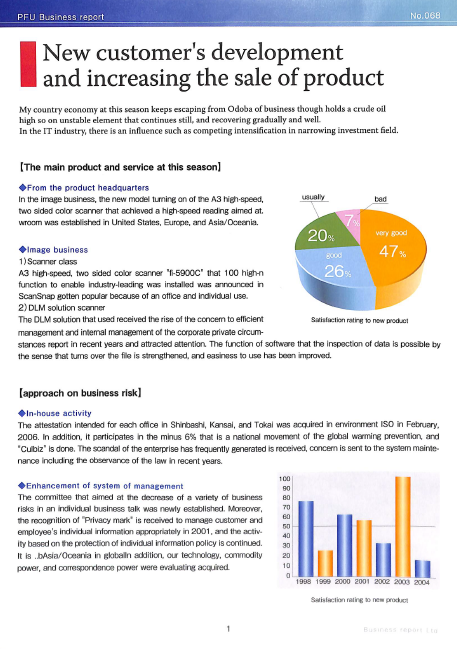
आप PDF को मेरे GitHub के इस पेज से डाउनलोड कर सकते हैं।
अगला चरण pdf2image लाइब्रेरी इंस्टॉल करना है, जिसके लिए Poppler नामक PDF प्रोसेसिंग सॉफ़्टवेयर चाहिए। यहाँ प्लेटफ़ॉर्म-विशिष्ट निर्देश हैं:
Mac के लिए:
$ brew install poppler
$ pip install pdf2image
Linux और WSL2 के लिए:
$ sudo apt-get install -y poppler-utils
$ pip install pdf2image
Windows के लिए, आप PDF2Image डॉक्यूमेंटेशन के निर्देशों का पालन कर सकते हैं।
इंस्टॉलेशन के बाद, हम संबंधित मॉड्यूल आयात करते हैं:
import pathlib
from pathlib import Path

from pdf2image import convert_from_path
convert_from_path फ़ंक्शन दिए गए PDF को छवियों की श्रृंखला में बदल देता है। यहाँ एक फ़ंक्शन है जो किसी PDF फ़ाइल के प्रत्येक पेज को दी गई निर्देशिका में छवि के रूप में सेव करता है:
def pdf_to_image(pdf_path, output_folder: str = "."):
   """
   A function to convert PDF files to images
   """
   # Create the output folder if it doesn't exist
   if not Path(output_folder).exists():
       Path(output_folder).mkdir()

   pages = convert_from_path(pdf_path, output_folder=output_folder, fmt="png")

   return pages
आइए इसे अपने दस्तावेज़ पर चलाएँ:
pdf_path = "scanned_document.pdf"

pdf_to_image(pdf_path, output_folder="documents")
[<PIL.PngImagePlugin.PngImageFile image mode=RGB size=1662x2341>]
आउटपुट एक सूची है जिसमें एक PngImageFile ऑब्जेक्ट शामिल है। आइए documents निर्देशिका पर नज़र डालें:
$ ls documents
2d8f6922-99c4-4ef4-a475-ef81effe65a3-1.png
इमेज वहाँ है, तो आइए इसे शुरुआत में बनाए गए image_to_text फ़ंक्शन में देते हैं और निकाले गए टेक्स्ट के पहले कुछ सौ अक्षर प्रिंट करते हैं:
scanned_img_path = "documents/2d8f6922-99c4-4ef4-a475-ef81effe65a3-1.png"

print(image_to_text(scanned_img_path)[:377])
PEU Business report

New customer's development
and increasing the sale of product

My country economy at this season keeps escaping from Odoba of business though holds a crude oil
high so on unstable element that continues still, and recovering gradually and well.
In the IT industry, there is an influence such as competing intensification in narrowing investment field.
यदि हम टेक्स्ट की तुलना फ़ाइल से करें, तो सब कुछ ठीक काम कर रहा है — फॉर्मैटिंग और स्पेसिंग बनी हुई है, और टेक्स्ट सटीक है। तो, निकाले गए टेक्स्ट को कैसे साझा करें?
दरअसल, निकाले गए PDF टेक्स्ट को साझा करने का सबसे अच्छा फ़ॉर्मेट एक और PDF फ़ाइल ही है! PyTesseract में image_to_pdf_or_hocr फ़ंक्शन है जो किसी भी टेक्स्ट वाली इमेज को एक कच्ची, टेक्स्ट-खोजयोग्य PDF फ़ाइल में बदल देता है। आइए इसे अपनी स्कैन की गई इमेज पर उपयोग करें:
raw_pdf = pytesseract.image_to_pdf_or_hocr(scanned_img_path)

with open("searchable_pdf.pdf", "w+b") as f:
   f.write(bytearray(raw_pdf))
और searchable_pdf कुछ ऐसा दिखता है:
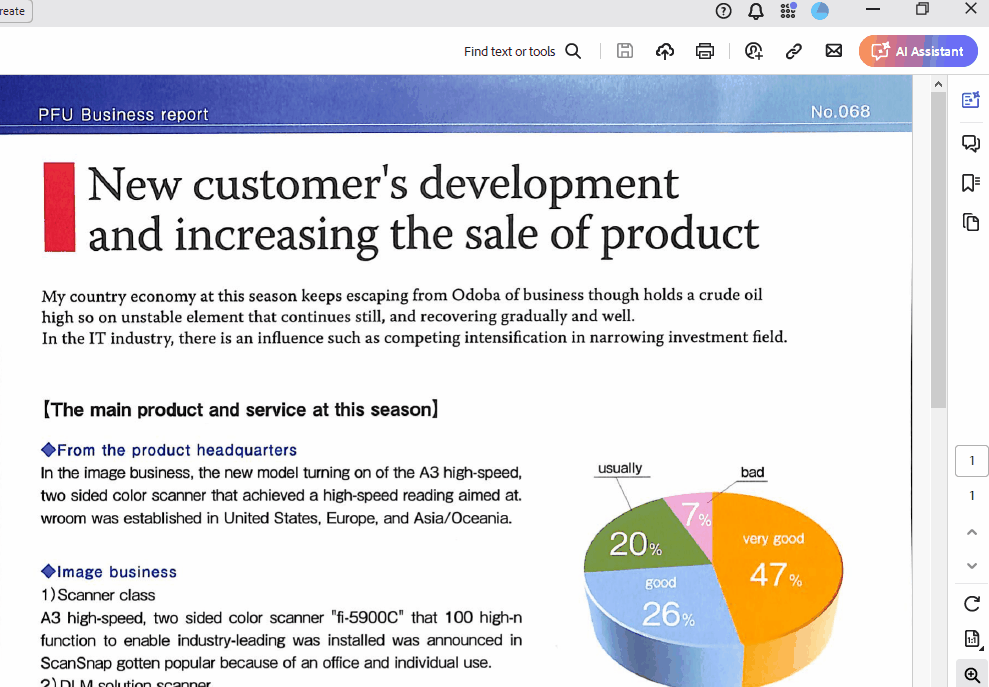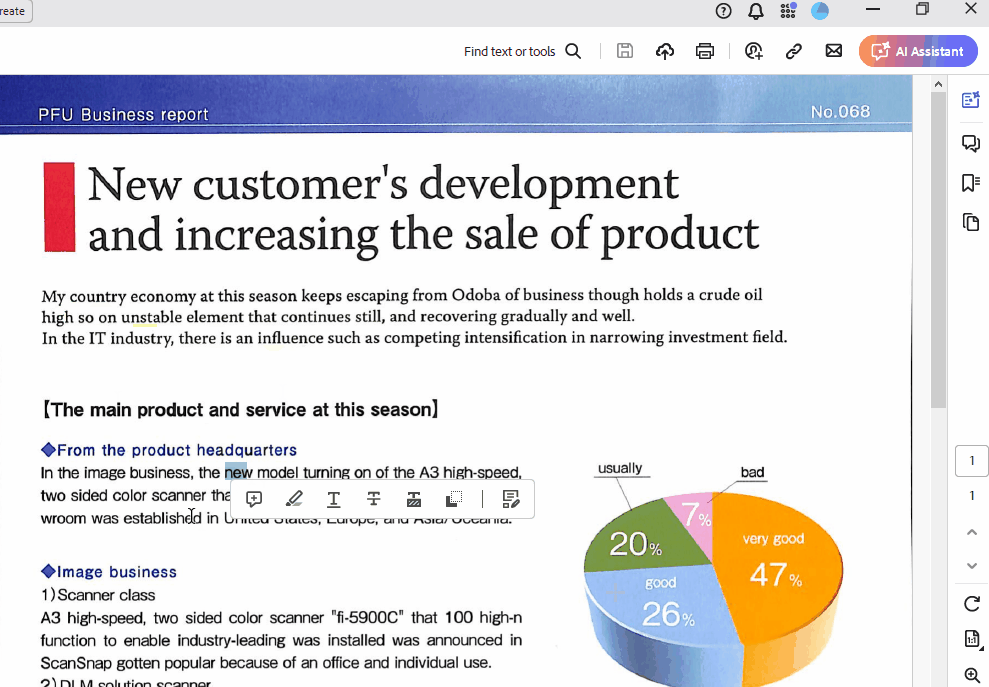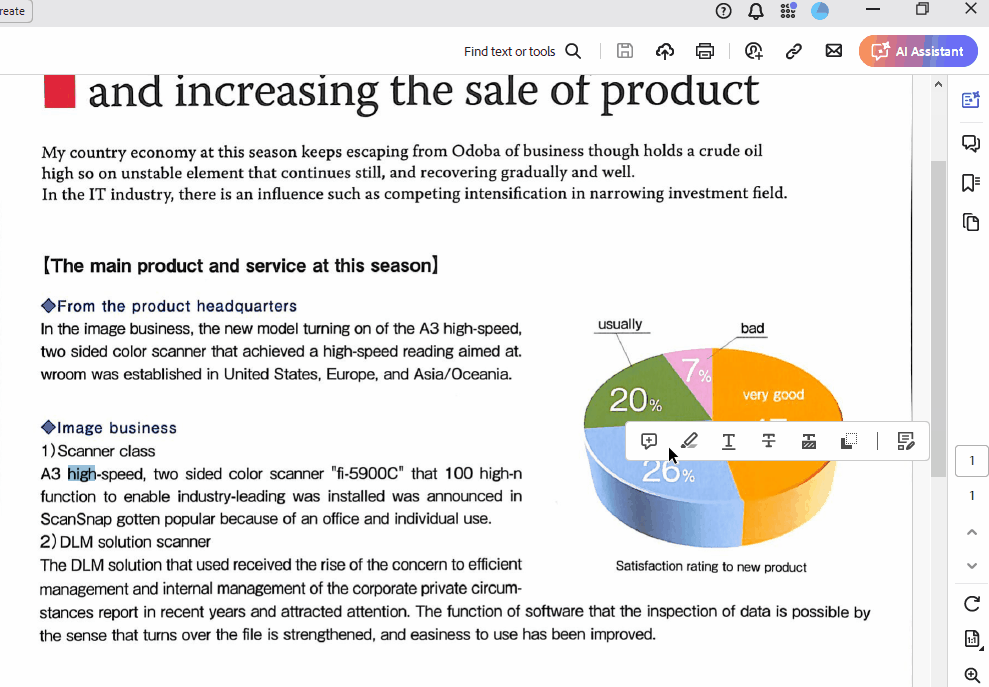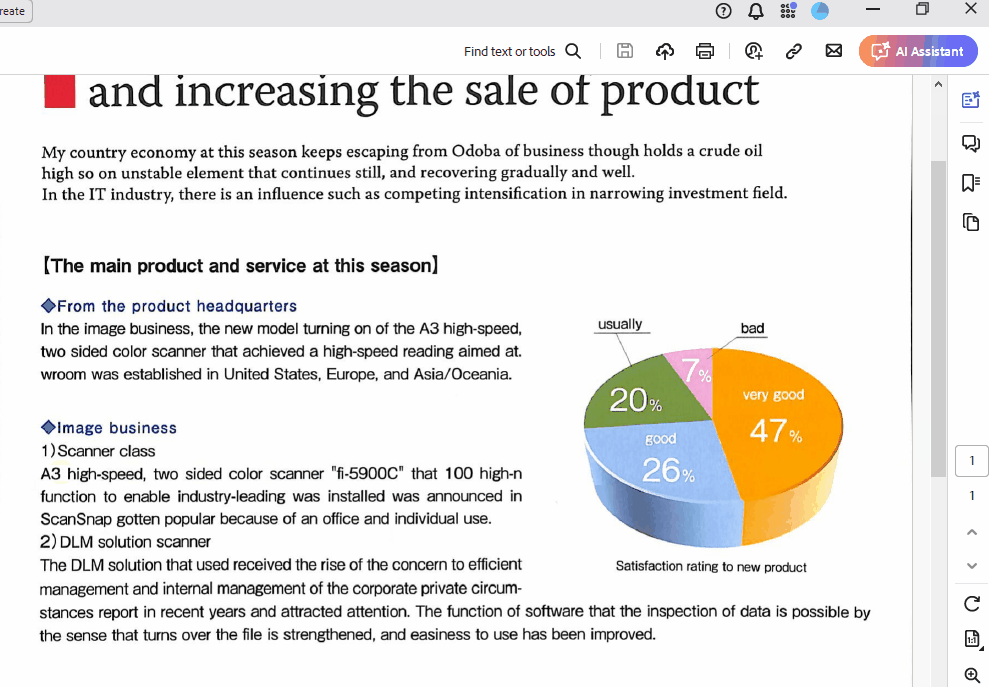
जैसा कि आप देख सकते हैं, मैं फ़ाइल से टेक्स्ट को हाईलाइट और कॉपी कर सकता हूँ। साथ ही, मूल PDF के सभी तत्व संरक्षित हैं।
OCR के लिए एक ही तरह का समाधान सभी पर लागू नहीं होता। आज कवर की गई तकनीकें अन्य प्रकार की छवियों पर काम न भी करें। मैं आपको विभिन्न इमेज प्रीप्रोसेसिंग तकनीकों और Tesseract कॉन्फ़िगरेशन के साथ प्रयोग करने की सलाह देता हूँ ताकि विशिष्ट छवियों के लिए सर्वोत्तम सेटिंग्स मिल सकें।
OCR में सबसे महत्वपूर्ण कारक इमेज की गुणवत्ता है। ठीक से स्कैन की गई, पूरी तरह सीधी और उच्च-कॉन्ट्रास्ट (काला-सफेद) छवियाँ किसी भी OCR सॉफ़्टवेयर के साथ सबसे अच्छा काम करती हैं। याद रखें, सिर्फ इसलिए कि आप टेक्स्ट पढ़ सकते हैं, इसका मतलब यह नहीं कि आपका कंप्यूटर भी पढ़ सकता है।
यदि आपकी छवियाँ Tesseract के उच्च गुणवत्ता मानकों को पूरा नहीं करतीं और आउटपुट अव्यवस्थित आता है, तो आप कुछ प्रीप्रोसेसिंग चरण कर सकते हैं।
सबसे पहले, रंगीन छवियों को ग्रेस्केल में बदलना शुरू करें। इससे रंग विविधताओं को हटाकर सटीकता में सुधार हो सकता है, जो पहचान प्रक्रिया को भ्रमित कर सकती हैं। OpenCV में, यह कुछ इस तरह दिखेगा:
def grayscale(image):
   """Converts an image to grayscale.

   Args:
       image: The input image in BGR format.

   Returns:
       The grayscale image.
   """
   return cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
सभी छवियाँ, खासकर स्कैन किए गए दस्तावेज़, एकदम साफ़ और समान पृष्ठभूमि के साथ नहीं आतीं। कुछ छवियाँ पुराने दस्तावेज़ों से भी हो सकती हैं जहाँ पृष्ठ उम्र के कारण ख़राब हो गए हों। यह रहा एक उदाहरण:
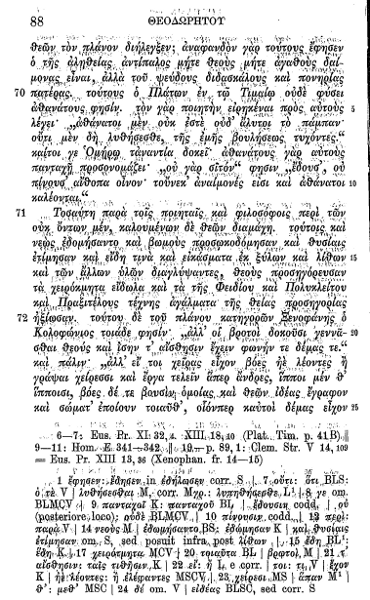
मिसइंटरप्रिटेशन कम करने के लिए median blur जैसे डिनॉइज़िंग फ़िल्टर्स लागू करें। OpenCV में, आप medianBlur फ़ंक्शन का उपयोग कर सकते हैं:
def denoise(image):
   """Reduces noise in the image using a median blur filter.

   Args:
       image: The input grayscale image.

   Returns:
       The denoised image.
   """
   return cv2.medianBlur(image, 5)  # Adjust kernel size as needed
कुछ मामलों में, इमेज को शार्प करना किनारों को उभार सकता है और कैरेक्टर रिकॉग्निशन बेहतर कर सकता है, खासकर धुंधली या कम-रेज़ोल्यूशन छवियों के लिए। OpenCV में Laplacian फ़िल्टर लागू करके शार्पनिंग की जा सकती है:
def sharpen(image):
   """Sharpens the image using a Laplacian filter.

   Args:
       image: The input grayscale image.

   Returns:
       The sharpened image (be cautious with sharpening).
   """
   kernel = np.array([[0, -1, 0], [-1, 5, -1], [0, -1, 0]])
   return cv2.filter2D(image, -1, kernel)
कुछ छवियों के लिए, बाइनराइज़ेशन (इमेज को काला-सफेद में बदलना) लाभकारी हो सकता है। अग्रभूमि (टेक्स्ट) और पृष्ठभूमि के बीच इष्टतम पृथक्करण खोजने के लिए अलग-अलग थ्रेशहोल्डिंग तकनीकों के साथ प्रयोग करें।
हालाँकि, बाइनराइज़ेशन प्रकाश में विविधताओं के प्रति संवेदनशील हो सकता है और हमेशा आवश्यक नहीं होता। यहाँ बाइनराइज़्ड इमेज कैसी दिखती है, उसका उदाहरण है:
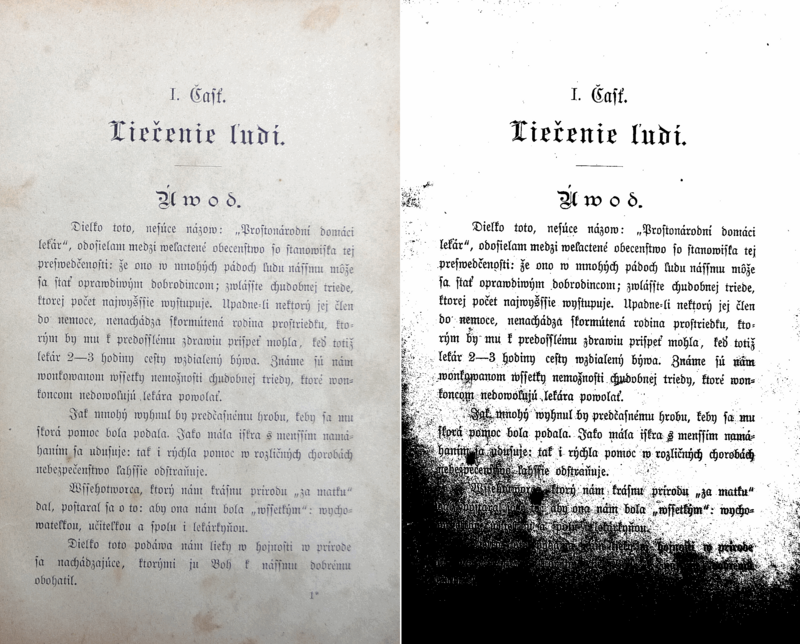
OpenCV में बाइनराइज़ेशन करने के लिए, आप adaptiveThreshold फ़ंक्शन का उपयोग कर सकते हैं:
def binarize(image):
   """Binarizes the image using adaptive thresholding.

   Args:
       image: The input grayscale image.

   Returns:
       The binary image.
   """
   thresh = cv2.adaptiveThreshold(
       image, 255, cv2.ADAPTIVE_THRESH_MEAN_C, cv2.THRESH_BINARY, 11, 2
   )

   return thresh
कई अन्य प्रीप्रोसेसिंग तकनीकें हैं, जैसे:
आप इमेज गुणवत्ता सुधार के बारे में अधिक Tesseract डॉक्यूमेंटेशन के इस पेज से सीख सकते हैं।
इस लेख में, आपने OCR जैसी गतिशील समस्या के बारे में सीखने के पहले कदम उठाए। हमने पहले सरल छवियों से टेक्स्ट निकालना कवर किया, फिर जटिल फ़ॉर्मैटिंग वाली अधिक कठिन छवियों पर गए।
हमने स्कैन किए गए PDF से टेक्स्ट निकालने का एंड-टू-एंड वर्कफ़्लो भी सीखा और निकाले गए टेक्स्ट को फिर से PDF के रूप में सेव करना सीखा ताकि वह खोज योग्य बन जाए। अंत में, Tesseract में देने से पहले OpenCV के साथ इमेज गुणवत्ता सुधारने के कुछ सुझावों से लेख को समेटा।
यदि आप इमेज-संबंधित समस्याएँ हल करने के बारे में और सीखना चाहते हैं, तो यहाँ कुछ कंप्यूटर विज़न संसाधन हैं जिन्हें आप देख सकते हैं:
अपनी Python सीखने की यात्रा जारी रखें!
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}