
Program
Pengembangan Aplikasi Kecerdasan Buatan
21 jam
PaliGemma 2 Mix adalah model AI multimodal yang dikembangkan oleh Google. Ini merupakan versi yang disempurnakan dari model vision-language (VLM) PaliGemma, yang mengintegrasikan kapabilitas lanjutan dari model visi SigLIP dan model bahasa Gemma 2.
Dalam tutorial ini, saya akan menjelaskan cara menggunakan PaliGemma 2 Mix untuk membangun pemindai tagihan dan penganalisis pengeluaran bertenaga AI yang mampu:
Walau fokus kita adalah membangun alat wawasan finansial, Anda dapat menggunakan apa yang dipelajari di blog ini untuk mengeksplorasi use case lain dari PaliGemma 2 Mix, seperti segmentasi gambar, deteksi objek, dan tanya jawab.
PaliGemma 2 Mix adalah model vision-language (VLM) tingkat lanjut yang memproses gambar dan teks sebagai input serta menghasilkan output berbasis teks. Model ini dirancang untuk menangani beragam tugas AI multimodal sekaligus mendukung banyak bahasa.
PaliGemma 2 dirancang untuk beragam tugas vision-language, termasuk pembuatan caption gambar dan video pendek, visual question answering, optical character recognition (OCR), deteksi objek, dan segmentasi.
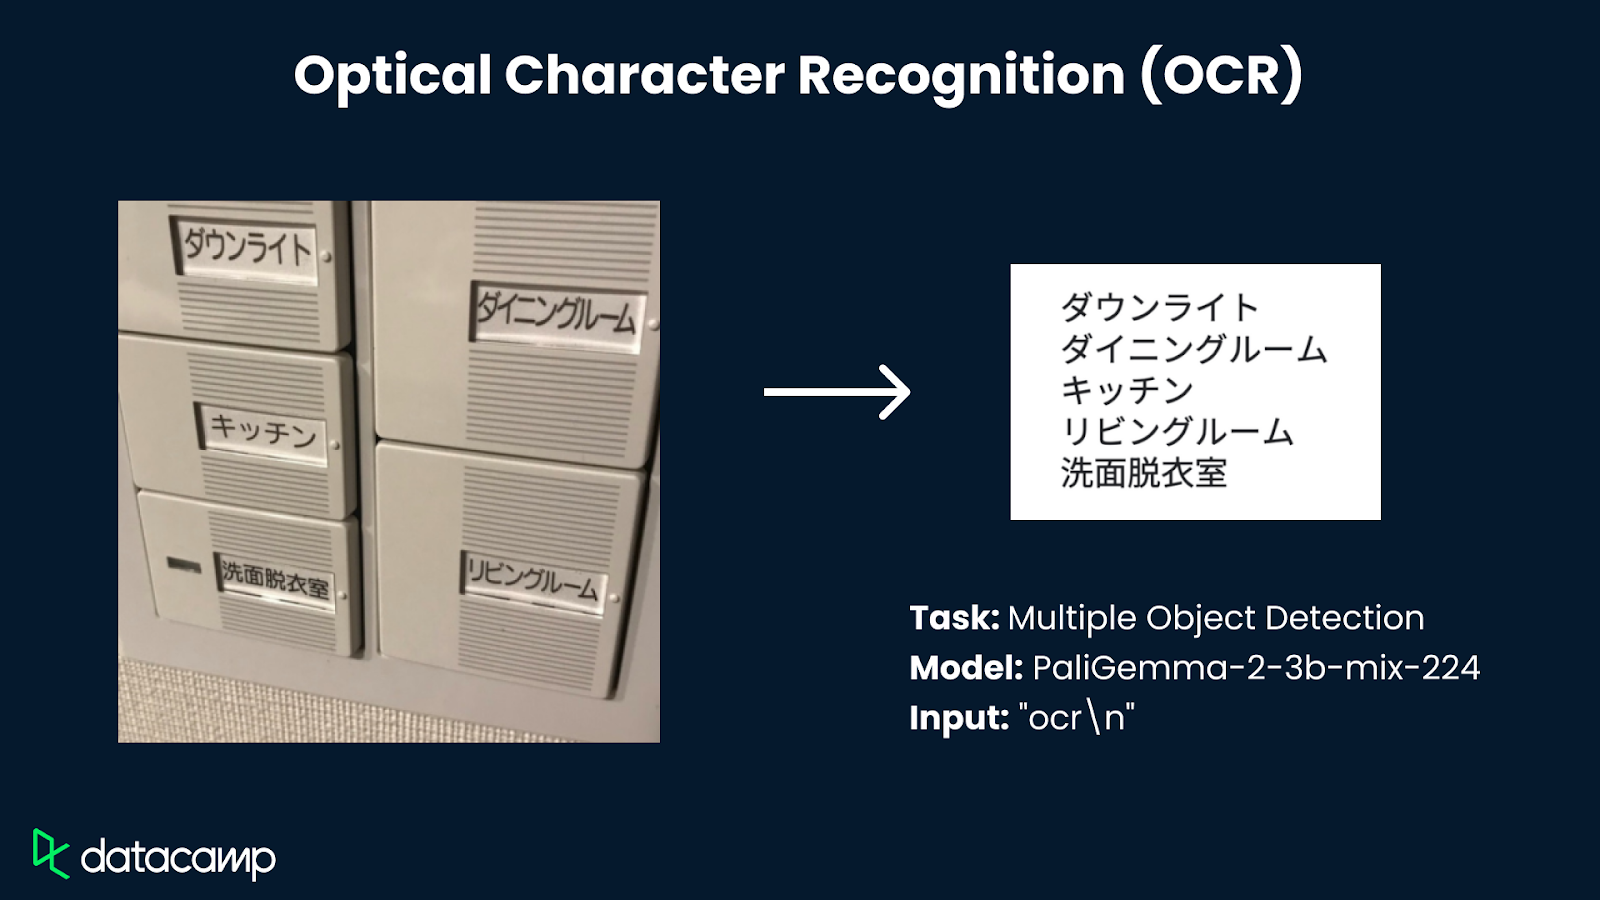
Sumber gambar yang digunakan pada diagram: Google
Model PaliGemma 2 Mix dirancang untuk:
Anda dapat menemukan informasi lebih lanjut tentang model PaliGemma 2 Mix dalam artikel rilis resmi.
Mari kita uraikan langkah utama yang akan kita lakukan:
Sebelum memulai, pastikan kita telah memasang alat dan pustaka berikut:
Jalankan perintah berikut untuk memasang dependensi yang diperlukan:
pip install gradio -U bitsandbytes -U transformers -qSetelah dependensi di atas terpasang, jalankan perintah impor berikut:
import gradio as gr
import torch
import pandas as pd
import matplotlib.pyplot as plt
from transformers import PaliGemmaForConditionalGeneration, PaliGemmaProcessor, BitsAndBytesConfig
from transformers import BitsAndBytesConfig
from PIL import Image
import reKita mengonfigurasi dan memuat model PaliGemma 2 Mix dengan kuantisasi untuk mengoptimalkan kinerja. Untuk demo ini, kita akan menggunakan model 10b parameter dengan resolusi input gambar 448 x 448. Anda memerlukan minimal GPU T4 dengan memori 40GB (konfigurasi Colab) untuk menjalankan model ini.
device = "cuda" if torch.cuda.is_available() else "cpu"
# Model setup
model_id = "google/paligemma2-10b-mix-448"
bnb_config = BitsAndBytesConfig(
    load_in_8bit=True,  # Change to load_in_4bit=True for even lower memory usage
    llm_int8_threshold=6.0,
)

# Load model with quantization
model = PaliGemmaForConditionalGeneration.from_pretrained(
    model_id, quantization_config=bnb_config
).eval()

# Load processor
processor = PaliGemmaProcessor.from_pretrained(model_id)
# Print success message
print("Model and processor loaded successfully!")
Kuantisasi BitsAndBytes membantu mengurangi penggunaan memori sambil mempertahankan kinerja, sehingga memungkinkan menjalankan model besar pada sumber daya GPU terbatas. Pada implementasi ini, kami menggunakan kuantisasi 4-bit untuk lebih mengoptimalkan efisiensi memori.
Kami memuat model menggunakan kelas PaliGemmaForConditionalGeneration dari pustaka transformers dengan meneruskan ID model dan konfigurasi kuantisasi. Serupa, kami memuat processor yang melakukan prapemrosesan input menjadi tensor sebelum diteruskan ke model.
Setelah shard model dimuat, kita memproses gambar sebelum meneruskannya ke model untuk menjaga kompatibilitas format gambar dan memperoleh keseragaman. Kita mengonversi gambar ke format RGB:
def ensure_rgb(image: Image.Image) -> Image.Image:
    if image.mode != "RGB":
        image = image.convert("RGB")
    return image
Sekarang, gambar kita siap untuk inferensi.
Sekarang, kita menyiapkan fungsi utama untuk menjalankan inferensi dengan model. Fungsi ini menerima gambar dan pertanyaan sebagai input, memasukkannya ke dalam prompt, lalu meneruskannya ke model melalui processor untuk inferensi.
def ask_model(image: Image.Image, question: str) -> str:
    prompt = f"<image> answer en {question}"
    inputs = processor(text=prompt, images=image, return_tensors="pt").to(device)
    with torch.inference_mode():
        generated_ids = model.generate(
            **inputs,
            max_new_tokens=50,
            do_sample=False
        )
    result = processor.batch_decode(generated_ids, skip_special_tokens=True)
return result[0].strip()Setelah fungsi utama siap, selanjutnya kita akan mengekstrak parameter kunci dari gambar—dalam kasus kita, yaitu total jumlah dan kategori barang.
 def extract_total_amount(image: Image.Image) -> float:
    question = "ocr\n what is the total amount? in numbers only"
    answer = ask_model(image, question)
    print(f"Answer from model: {answer}")
    try:
        amounts = re.findall(r'\d+\.\d+|\d+', answer)  # Capture both integer and decimal values
        if amounts:
            return float(amounts[-1])  # Get the last valid amount as the total
    except ValueError:
        pass
    return 0.0
Fungsi extract_total_amount() memproses gambar untuk mengekstrak total jumlah dari struk menggunakan OCR. Fungsi ini membentuk kueri (pertanyaan) yang menginstruksikan model untuk mengekstrak hanya nilai numerik, lalu memanggil fungsi ask_model() untuk menghasilkan respons dari model.
def categorize_goods(image: Image.Image) -> str:
    question = "what is the category of goods in the image - Grocery/ Clothing/ Electronics/ Other?"
    answer = ask_model(image, question)
    print(f"Category from model: {answer}")
    answer = answer.split("\n")[-1].strip().capitalize()
    valid_categories = ["Grocery", "Clothing", "Electronics", "Other"]
    return answer if answer in valid_categories else "Other"
Fungsi categorize_goods() mengklasifikasikan jenis barang dalam gambar dengan memicu model menggunakan pertanyaan yang telah ditentukan berisi kemungkinan kategori: kebutuhan sehari-hari, pakaian, elektronik, atau lainnya. Fungsi ask_model() kemudian memproses gambar dan mengembalikan respons tekstual. Jika respons yang diproses cocok dengan salah satu kategori valid yang telah ditentukan, fungsi akan mengembalikan kategori tersebut—jika tidak, akan menggunakan kategori "Other" secara default.
Semua fungsi kunci sudah siap, jadi mari kita analisis output-nya.
def generate_spending_chart(categories: dict):
    filtered_categories = {k: v for k, v in categories.items() if v > 0}  # Remove zero-value categories
    labels = list(filtered_categories.keys())
    values = list(filtered_categories.values())
    if not values or sum(values) == 0:
        fig, ax = plt.subplots()
        ax.text(0.5, 0.5, "No Spending Data", ha="center", va="center", fontsize=12)
        ax.axis("off")
        return fig
    fig, ax = plt.subplots()
    ax.pie(values, labels=labels, autopct='%1.1f%%', startangle=90)
    ax.axis('equal')
    plt.title("Spending Distribution")
    return fig
Fungsi di atas membuat diagram pai untuk memvisualisasikan distribusi pengeluaran di berbagai kategori. Jika tidak ada data pengeluaran yang valid, fungsi akan menghasilkan figur kosong dengan pesan "No Spending Data." Jika ada, fungsi akan membuat diagram pai dengan label kategori dan nilai persentase, memastikan visualisasi yang proporsional dan selaras.
Biasanya kita memiliki banyak tagihan untuk dianalisis, jadi mari kita buat fungsi untuk memproses semua tagihan sekaligus.
def process_multiple_bills(files: list):
    results = []
    images = []
    total_spending = 0
    category_totals = {"Grocery": 0, "Clothing": 0, "Electronics": 0, "Other": 0}
    for file in files:
        image = Image.open(file)
        image = ensure_rgb(image)
        images.append(image)
        total_amount = extract_total_amount(image)
        category = categorize_goods(image)
        total_spending += total_amount
        category_totals[category] += total_amount
        results.append({"Bill": len(results) + 1, "Category": category, "Total Amount": f"₹{total_amount:.2f}"})
    pie_chart = generate_spending_chart(category_totals)
    summary_text = f"**Total Spending Across All Bills:** ₹{total_spending:.2f}"
    return images, pd.DataFrame(results), summary_text, pie_chart
Untuk menganalisis banyak tagihan sekaligus, kita melakukan langkah-langkah berikut:
DataFrame ringkasan tagihan, ringkasan total pengeluaran, dan bagan pengeluaran.Kini semua fungsi logika kunci sudah siap. Selanjutnya, kita membangun UI interaktif dengan Gradio.
def gradio_demo():
    with gr.Blocks() as demo:
        gr.Markdown("## PaliGemma 2 Mix Powered- Multiple Bill Scanner\nUpload multiple bill images, and this demo will extract text, categorize spending, and generate insights.")
        with gr.Row():
            with gr.Column():
                image_input = gr.File(file_count="multiple", file_types=["image"], label="Upload Bill Images")
                submit_button = gr.Button("Process Bills")
            with gr.Column():
                image_output = gr.Gallery(label="Uploaded Bills")
                table_output = gr.Dataframe(label="Bill Summary")
                summary_output = gr.Text(label="Total Spending Summary")
                chart_output = gr.Plot(label="Aggregated Spending Distribution")
        submit_button.click(
            fn=process_multiple_bills,
            inputs=image_input,
            outputs=[image_output, table_output, summary_output, chart_output]
        )
    demo.launch(debug=True)

if __name__ == "__main__":
    gradio_demo()
Kode di atas membuat UI Gradio terstruktur dengan pengunggah berkas untuk banyak gambar dan tombol kirim untuk memicu pemrosesan. Setelah dikirim, gambar tagihan yang diunggah ditampilkan dalam galeri, data yang diekstrak ditampilkan dalam tabel, total pengeluaran diringkas dalam teks, dan diagram pai distribusi pengeluaran dihasilkan.
Fungsi ini menghubungkan input pengguna ke fungsi process_multiple_bills(), memastikan ekstraksi dan visualisasi data berjalan mulus. Terakhir, fungsi demo.launch() menjalankan aplikasi Gradio untuk interaksi real-time.
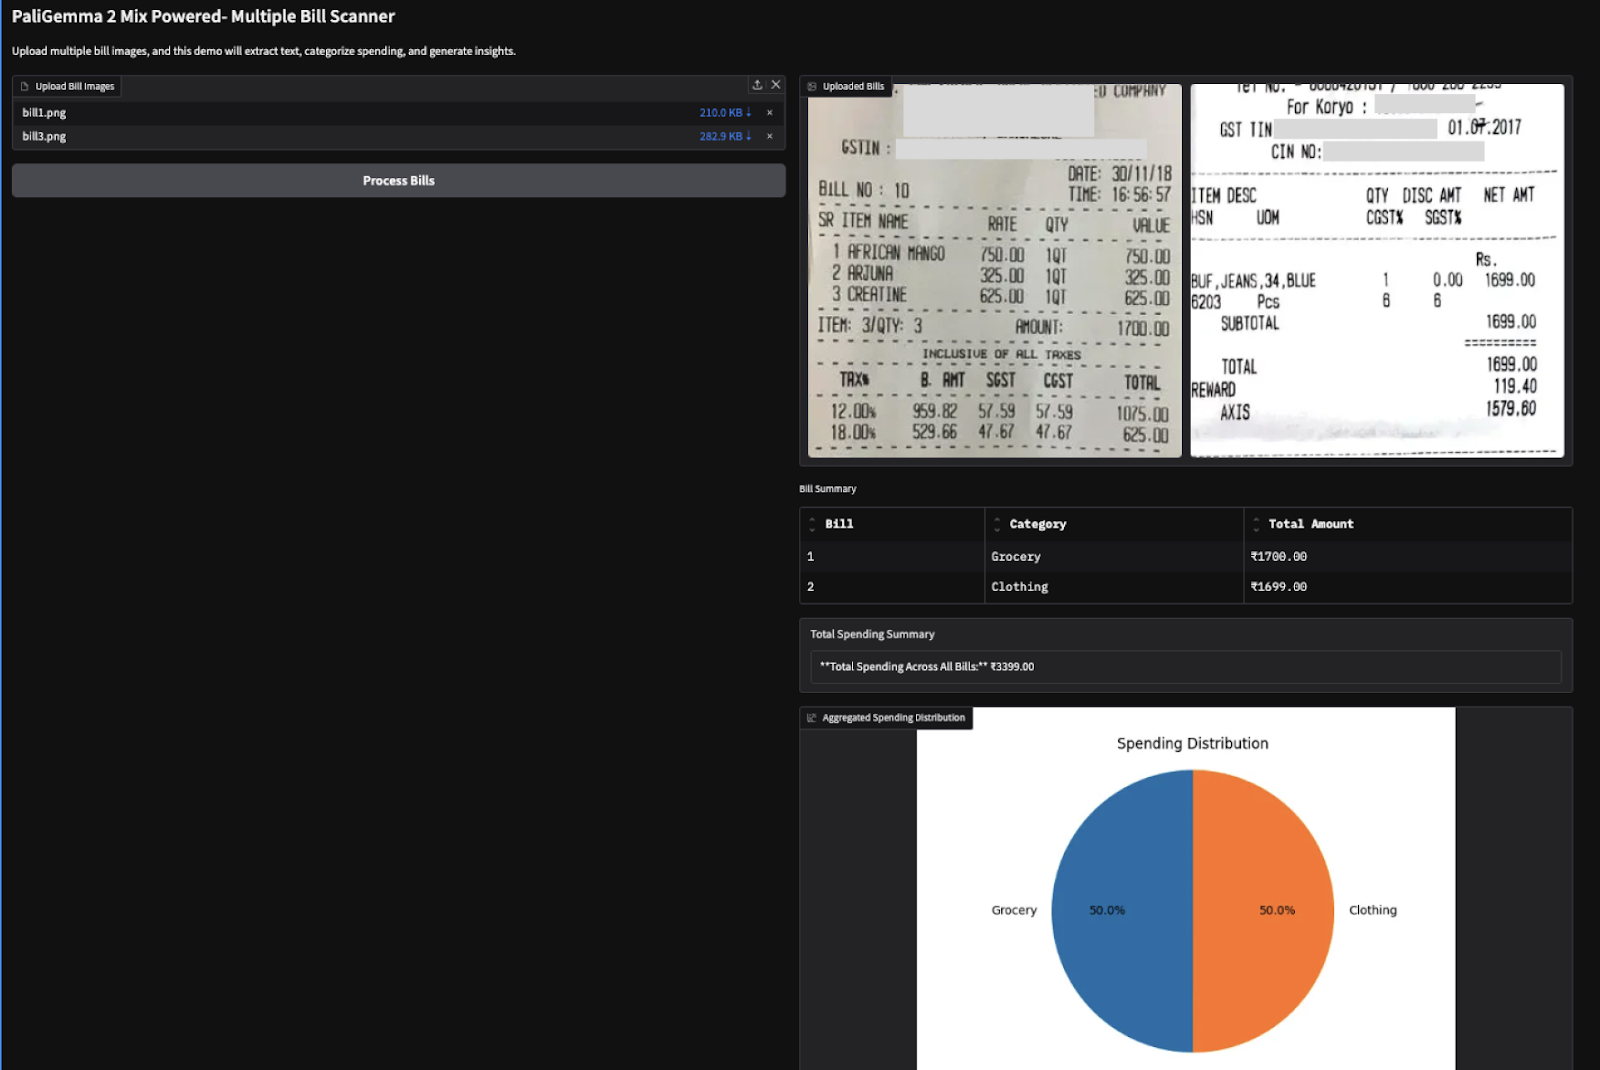
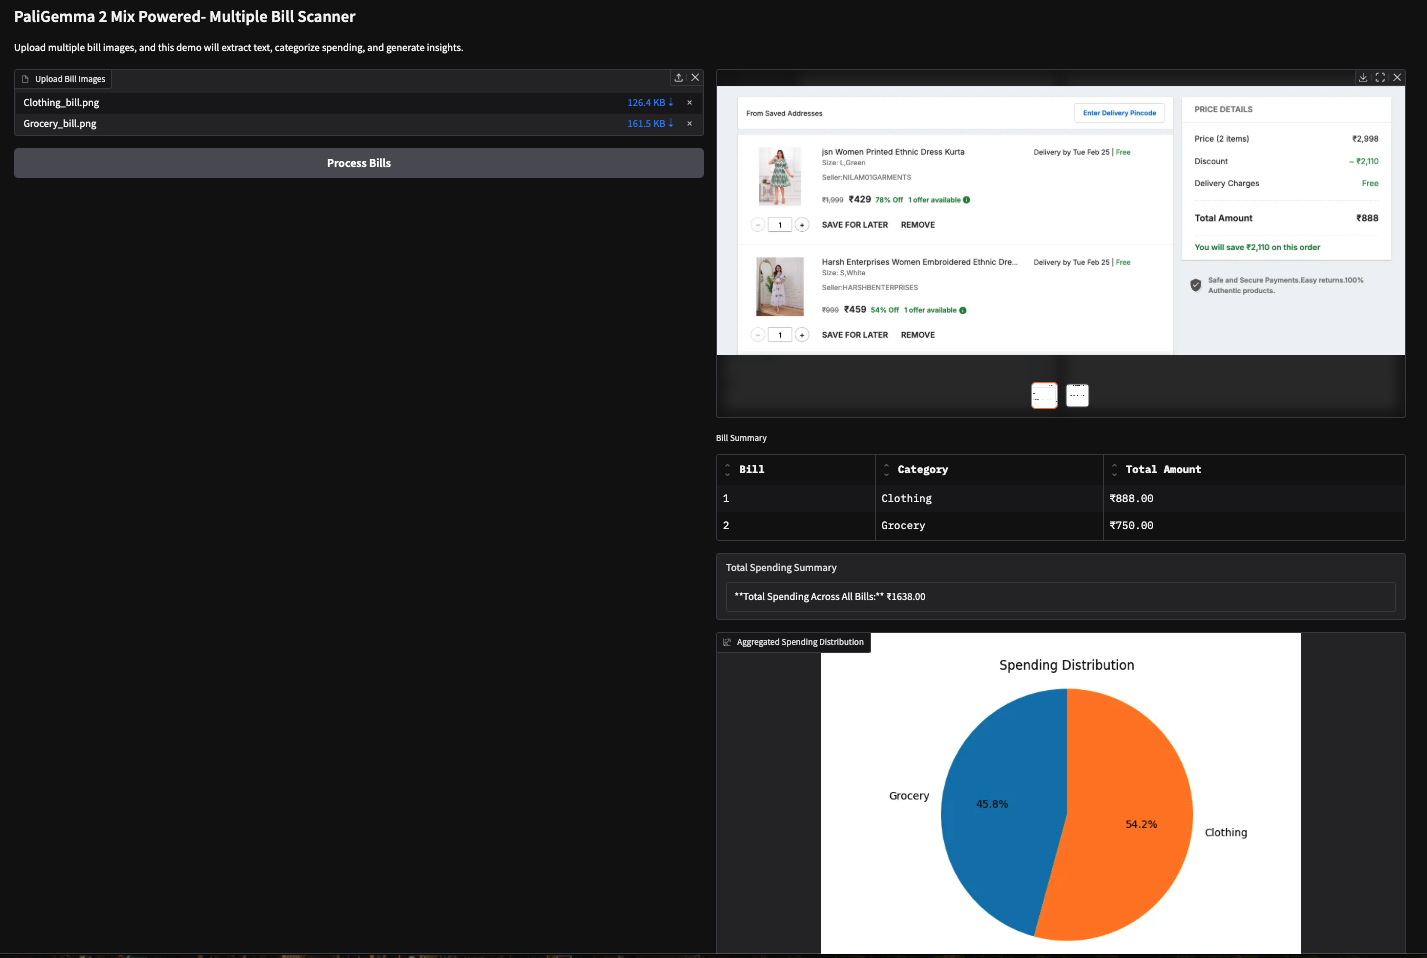
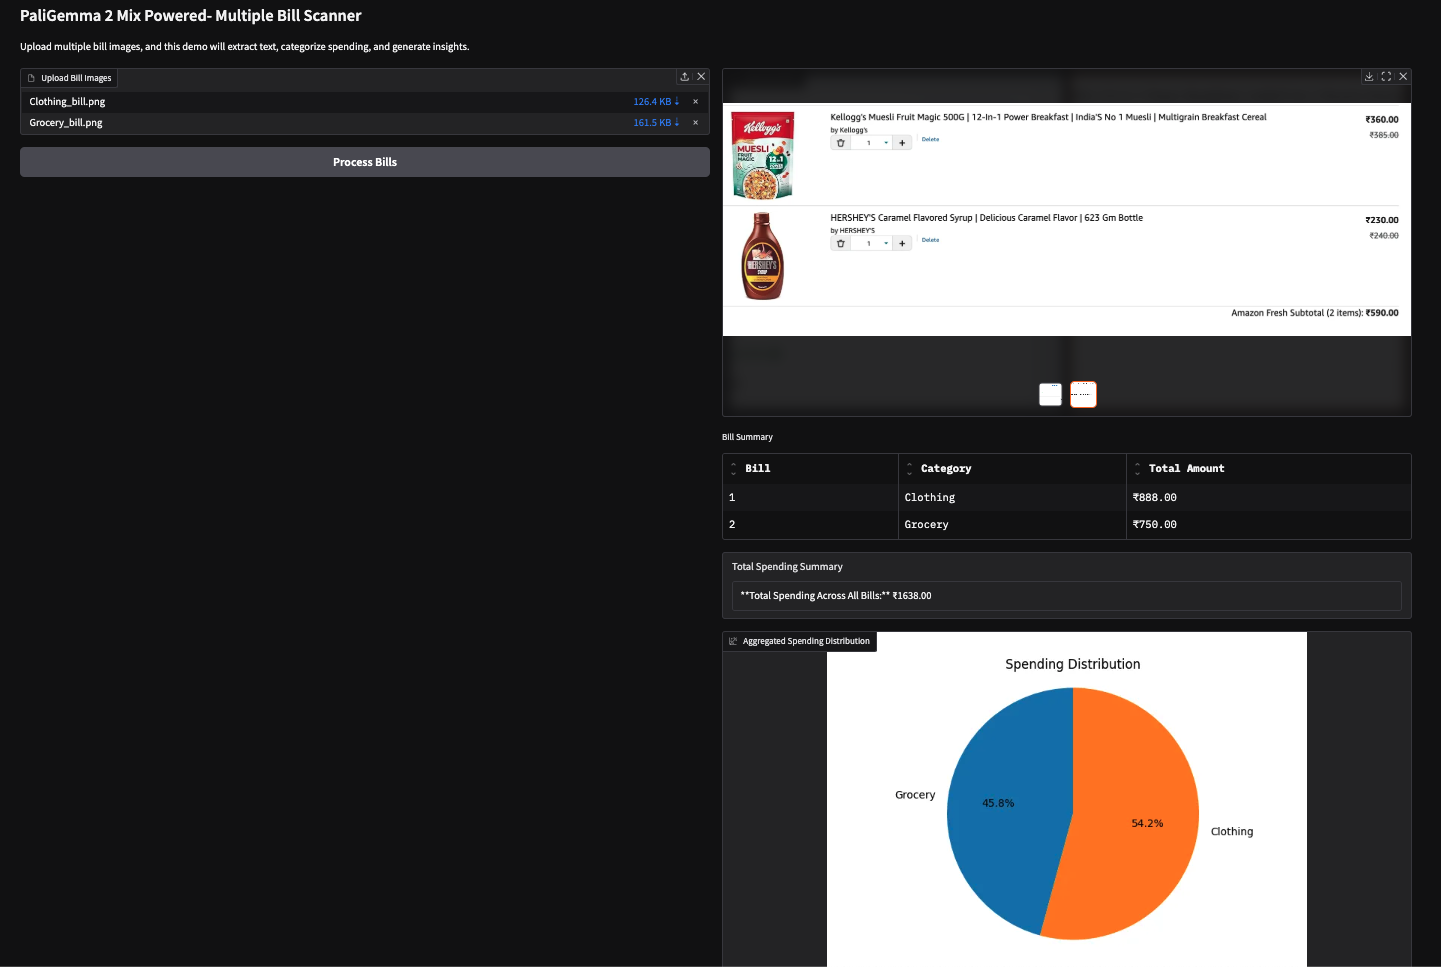
Saya juga mencoba demo ini dengan dua tagihan berbasis gambar (faktur belanja Amazon) dan mendapatkan hasil berikut.
Catatan: VLM kesulitan mengekstrak angka, yang sesekali dapat menghasilkan hasil yang tidak tepat. Misalnya, model mengekstrak total jumlah yang salah untuk tagihan kedua di bawah ini. Hal ini dapat diperbaiki dengan menggunakan model yang lebih besar atau sekadar fine-tuning pada model yang ada.
Dalam tutorial ini, kita membangun pemindai banyak tagihan bertenaga AI menggunakan PaliGemma 2 Mix, yang dapat membantu kita mengekstrak dan mengategorikan pengeluaran dari struk. Kita memanfaatkan kapabilitas vision-language PaliGemma 2 Mix untuk OCR dan klasifikasi guna menganalisis wawasan pengeluaran secara mudah. Saya mendorong Anda untuk menyesuaikan tutorial ini dengan use case Anda sendiri.
Pelajari AI dengan kursus-kursus ini!
Program
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt



