
Last chance! 50% off DataCamp Premium
Sale ends in
PaliGemma 2 Mix Google द्वारा विकसित एक मल्टीमॉडल AI मॉडल है। यह PaliGemma विज़न लैंग्वेज मॉडल (VLM) का उन्नत संस्करण है, जो SigLIP विज़न मॉडल और Gemma 2 भाषा मॉडलों की उन्नत क्षमताओं को एकीकृत करता है।
इस ट्यूटोरियल में, मैं बताऊंगा कि PaliGemma 2 Mix का उपयोग करके एक AI-संचालित बिल स्कैनर और स्पेंडिंग एनालाइज़र कैसे बनाया जाए, जो सक्षम हो:
हालाँकि हमारा फोकस एक वित्तीय इनसाइट्स टूल बनाने पर होगा, आप इस ब्लॉग में सीखी बातों का उपयोग PaliGemma 2 Mix के अन्य उपयोग मामलों—जैसे इमेज सेगमेंटेशन, ऑब्जेक्ट डिटेक्शन, और प्रश्नोत्तर—की खोज के लिए कर सकते हैं।
PaliGemma 2 Mix एक उन्नत विज़न-लैंग्वेज मॉडल (VLM) है जो इनपुट के रूप में छवियाँ और पाठ—दोनों—प्रोसेस करता है और टेक्स्ट-आधारित आउटपुट जनरेट करता है। इसे विभिन्न प्रकार के मल्टीमॉडल AI कार्यों को संभालने के लिए डिज़ाइन किया गया है और यह कई भाषाओं का समर्थन करता है।
PaliGemma 2 को अनेक विज़न-लैंग्वेज कार्यों के लिए डिज़ाइन किया गया है, जिनमें इमेज और शॉर्ट वीडियो कैप्शनिंग, विज़ुअल प्रश्नोत्तर, ऑप्टिकल कैरेक्टर रिकग्निशन (OCR), ऑब्जेक्ट डिटेक्शन, और सेगमेंटेशन शामिल हैं।
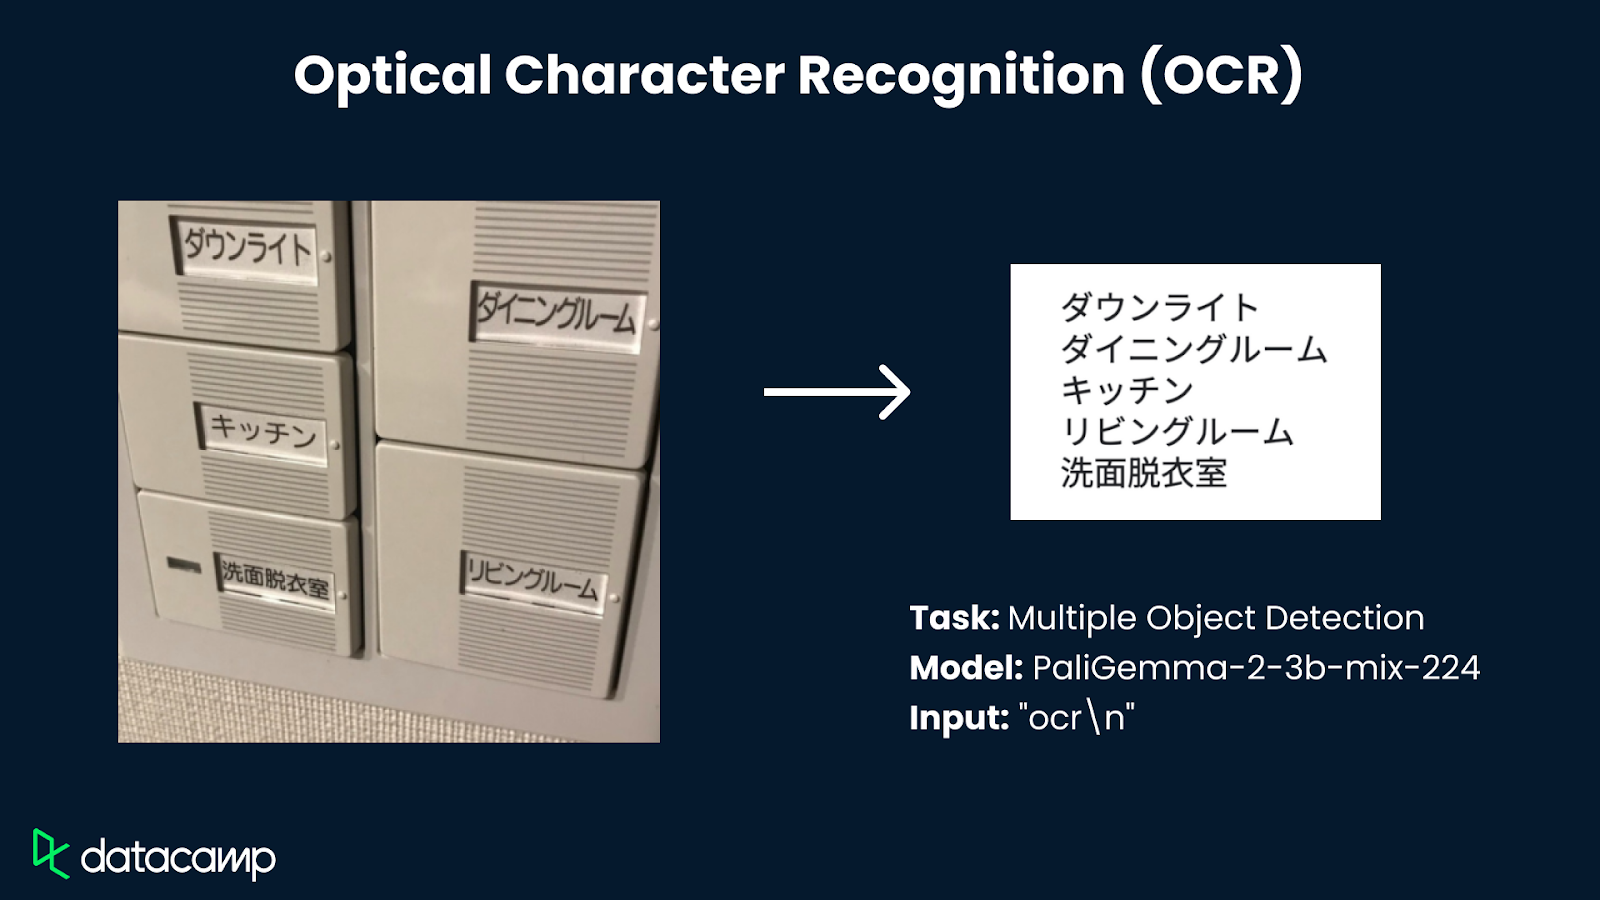
आरेख में उपयोग की गई छवियों का स्रोत: Google
PaliGemma 2 Mix मॉडल निम्नलिखित के लिए डिज़ाइन किया गया है:
PaliGemma 2 Mix मॉडल के बारे में अधिक जानकारी आपको आधिकारिक रिलीज़ लेख में मिल सकती है।
आइए मुख्य चरणों का खाका तैयार करें जो हम अपनाने वाले हैं:
शुरू करने से पहले, सुनिश्चित करें कि हमारे पास निम्नलिखित टूल और लाइब्रेरी इंस्टॉल हैं:
आवश्यक डिपेंडेंसियाँ इंस्टॉल करने के लिए निम्नलिखित कमांड चलाएँ:
pip install gradio -U bitsandbytes -U transformers -qऊपर दी गई डिपेंडेंसियाँ इंस्टॉल होने के बाद, निम्नलिखित इम्पोर्ट कमांड चलाएँ:
import gradio as gr
import torch
import pandas as pd
import matplotlib.pyplot as plt
from transformers import PaliGemmaForConditionalGeneration, PaliGemmaProcessor, BitsAndBytesConfig
from transformers import BitsAndBytesConfig
from PIL import Image
import reहम प्रदर्शन को ऑप्टिमाइज़ करने के लिए क्वांटाइज़ेशन के साथ PaliGemma 2 Mix मॉडल को कॉन्फ़िगर और लोड करते हैं। इस डेमो के लिए, हम 10b पैरामीटर मॉडल का उपयोग करेंगे, जिसकी इनपुट इमेज रेज़ोल्यूशन 448 x 448 है। इस मॉडल को चलाने के लिए आपको कम-से-कम 40GB मेमोरी वाला T4 GPU (Colab कॉन्फ़िगरेशन) चाहिए।
device = "cuda" if torch.cuda.is_available() else "cpu"
# Model setup
model_id = "google/paligemma2-10b-mix-448"
bnb_config = BitsAndBytesConfig(
    load_in_8bit=True,  # Change to load_in_4bit=True for even lower memory usage
    llm_int8_threshold=6.0,
)

# Load model with quantization
model = PaliGemmaForConditionalGeneration.from_pretrained(
    model_id, quantization_config=bnb_config
).eval()

# Load processor
processor = PaliGemmaProcessor.from_pretrained(model_id)
# Print success message
print("Model and processor loaded successfully!")
BitsAndBytes क्वांटाइज़ेशन मेमोरी उपयोग को कम करते हुए प्रदर्शन बनाए रखने में मदद करता है, जिससे सीमित GPU संसाधनों पर बड़े मॉडल चलाना संभव हो जाता है। इस इम्प्लीमेंटेशन में, हम मेमोरी दक्षता और बढ़ाने के लिए 4-बिट क्वांटाइज़ेशन का उपयोग करते हैं।
हम transformers लाइब्रेरी की PaliGemmaForConditionalGeneration क्लास का उपयोग करके मॉडल लोड करते हैं, जिसमें मॉडल ID और क्वांटाइज़ेशन कॉन्फ़िग पास किया जाता है। इसी तरह, हम प्रोसेसर लोड करते हैं, जो इनपुट्स को मॉडल को पास करने से पहले टेंसर में प्रीप्रोसेस करता है।
मॉडल शार्ड्स लोड होने के बाद, हम छवियों को मॉडल को पास करने से पहले प्रोसेस करते हैं ताकि इमेज फ़ॉर्मेट अनुकूलता बनी रहे और एकरूपता मिले। हम छवियों को RGB फ़ॉर्मेट में कन्वर्ट करते हैं:
def ensure_rgb(image: Image.Image) -> Image.Image:
    if image.mode != "RGB":
        image = image.convert("RGB")
    return image
अब हमारी छवियाँ इन्फ़रेंस के लिए तैयार हैं।
अब, हम मॉडल के साथ इन्फ़रेंस चलाने के लिए मुख्य फ़ंक्शन सेट अप करते हैं। यह फ़ंक्शन इनपुट छवियों और प्रश्नों को लेता है, उन्हें प्रॉम्प्ट में सम्मिलित करता है, और प्रोसेसर के माध्यम से मॉडल को इन्फ़रेंस के लिए पास करता है।
def ask_model(image: Image.Image, question: str) -> str:
    prompt = f"<image> answer en {question}"
    inputs = processor(text=prompt, images=image, return_tensors="pt").to(device)
    with torch.inference_mode():
        generated_ids = model.generate(
            **inputs,
            max_new_tokens=50,
            do_sample=False
        )
    result = processor.batch_decode(generated_ids, skip_special_tokens=True)
return result[0].strip()अब जब हमारे पास मुख्य फ़ंक्शन तैयार है, तो हम छवि से प्रमुख पैरामीटर निकालने पर काम करेंगे—हमारे मामले में ये हैं कुल राशि और वस्तुओं की श्रेणी।
 def extract_total_amount(image: Image.Image) -> float:
    question = "ocr\n what is the total amount? in numbers only"
    answer = ask_model(image, question)
    print(f"Answer from model: {answer}")
    try:
        amounts = re.findall(r'\d+\.\d+|\d+', answer)  # Capture both integer and decimal values
        if amounts:
            return float(amounts[-1])  # Get the last valid amount as the total
    except ValueError:
        pass
    return 0.0
extract_total_amount() फ़ंक्शन OCR का उपयोग करके रसीद से कुल राशि निकालने के लिए एक छवि को प्रोसेस करता है। यह एक क्वेरी (प्रश्न) बनाता है जो मॉडल को केवल संख्यात्मक मान निकालने का निर्देश देता है, और फिर मॉडल से उत्तर जनरेट कराने के लिए ask_model() फ़ंक्शन को कॉल करता है।
def categorize_goods(image: Image.Image) -> str:
    question = "what is the category of goods in the image - Grocery/ Clothing/ Electronics/ Other?"
    answer = ask_model(image, question)
    print(f"Category from model: {answer}")
    answer = answer.split("\n")[-1].strip().capitalize()
    valid_categories = ["Grocery", "Clothing", "Electronics", "Other"]
    return answer if answer in valid_categories else "Other"
categorize_goods() फ़ंक्शन किसी छवि में वस्तुओं के प्रकार को एक पूर्वनिर्धारित प्रश्न के माध्यम से वर्गीकृत करता है, जिसमें संभावित श्रेणियाँ सूचीबद्ध हैं: ग्रॉसरी, कपड़े, इलेक्ट्रॉनिक्स, या अन्य। इसके बाद ask_model() फ़ंक्शन छवि को प्रोसेस करता है और टेक्स्टुअल उत्तर लौटाता है। यदि प्रोसेस किया गया उत्तर किसी भी पूर्वनिर्धारित मान्य श्रेणी से मेल खाता है, तो वही श्रेणी रिटर्न होती है—अन्यथा, डिफ़ॉल्ट रूप से "Other" श्रेणी रिटर्न होती है।
हमारे पास सभी प्रमुख फ़ंक्शन तैयार हैं, तो आइए आउटपुट का विश्लेषण करें।
def generate_spending_chart(categories: dict):
    filtered_categories = {k: v for k, v in categories.items() if v > 0}  # Remove zero-value categories
    labels = list(filtered_categories.keys())
    values = list(filtered_categories.values())
    if not values or sum(values) == 0:
        fig, ax = plt.subplots()
        ax.text(0.5, 0.5, "No Spending Data", ha="center", va="center", fontsize=12)
        ax.axis("off")
        return fig
    fig, ax = plt.subplots()
    ax.pie(values, labels=labels, autopct='%1.1f%%', startangle=90)
    ax.axis('equal')
    plt.title("Spending Distribution")
    return fig
ऊपर दिया गया फ़ंक्शन विभिन्न श्रेणियों में खर्च के वितरण को विज़ुअलाइज़ करने के लिए पाई चार्ट बनाता है। यदि कोई मान्य स्पेंडिंग डेटा मौजूद नहीं है, तो यह "No Spending Data" संदेश के साथ एक खाली फ़िगर बनाता है। अन्यथा, यह श्रेणी लेबल और प्रतिशत मानों के साथ पाई चार्ट बनाता है, जिससे अनुपातिक और सुव्यवस्थित विज़ुअलाइज़ेशन सुनिश्चित होता है।
आमतौर पर हमारे पास विश्लेषण के लिए कई बिल होते हैं, इसलिए आइए एक फ़ंक्शन बनाते हैं जो हमारे सभी बिलों को एक साथ प्रोसेस करे।
def process_multiple_bills(files: list):
    results = []
    images = []
    total_spending = 0
    category_totals = {"Grocery": 0, "Clothing": 0, "Electronics": 0, "Other": 0}
    for file in files:
        image = Image.open(file)
        image = ensure_rgb(image)
        images.append(image)
        total_amount = extract_total_amount(image)
        category = categorize_goods(image)
        total_spending += total_amount
        category_totals[category] += total_amount
        results.append({"Bill": len(results) + 1, "Category": category, "Total Amount": f"₹{total_amount:.2f}"})
    pie_chart = generate_spending_chart(category_totals)
    summary_text = f"**Total Spending Across All Bills:** ₹{total_spending:.2f}"
    return images, pd.DataFrame(results), summary_text, pie_chart
एक साथ कई बिलों का विश्लेषण करने के लिए हम निम्नलिखित चरण करते हैं:
DataFrame, कुल खर्च का सारांश, और स्पेंडिंग चार्ट लौटाते हैं।अब हमारे पास सभी प्रमुख लॉजिक फ़ंक्शन मौजूद हैं। अगला कदम है Gradio के साथ इंटरैक्टिव UI बनाना।
def gradio_demo():
    with gr.Blocks() as demo:
        gr.Markdown("## PaliGemma 2 Mix Powered- Multiple Bill Scanner\nUpload multiple bill images, and this demo will extract text, categorize spending, and generate insights.")
        with gr.Row():
            with gr.Column():
                image_input = gr.File(file_count="multiple", file_types=["image"], label="Upload Bill Images")
                submit_button = gr.Button("Process Bills")
            with gr.Column():
                image_output = gr.Gallery(label="Uploaded Bills")
                table_output = gr.Dataframe(label="Bill Summary")
                summary_output = gr.Text(label="Total Spending Summary")
                chart_output = gr.Plot(label="Aggregated Spending Distribution")
        submit_button.click(
            fn=process_multiple_bills,
            inputs=image_input,
            outputs=[image_output, table_output, summary_output, chart_output]
        )
    demo.launch(debug=True)

if __name__ == "__main__":
    gradio_demo()
ऊपर दिया गया कोड कई छवियों के लिए फ़ाइल अपलोडर और प्रोसेसिंग ट्रिगर करने के लिए एक सबमिट बटन के साथ एक संरचित Gradio UI बनाता है। सबमिट करने पर, अपलोड की गई बिल छवियाँ गैलरी में दिखाई जाती हैं, निकाला गया डेटा एक टेबल में दिखता है, कुल खर्च टेक्स्ट में संक्षेपित होता है, और स्पेंडिंग डिस्ट्रीब्यूशन का पाई चार्ट जनरेट होता है।
यह फ़ंक्शन उपयोगकर्ता इनपुट्स को process_multiple_bills() फ़ंक्शन से जोड़ता है, ताकि डेटा निष्कर्षण और विज़ुअलाइज़ेशन सहज रूप से हो। अंत में, demo.launch() फ़ंक्शन रीयल-टाइम इंटरेक्शन के लिए Gradio ऐप शुरू करता है।
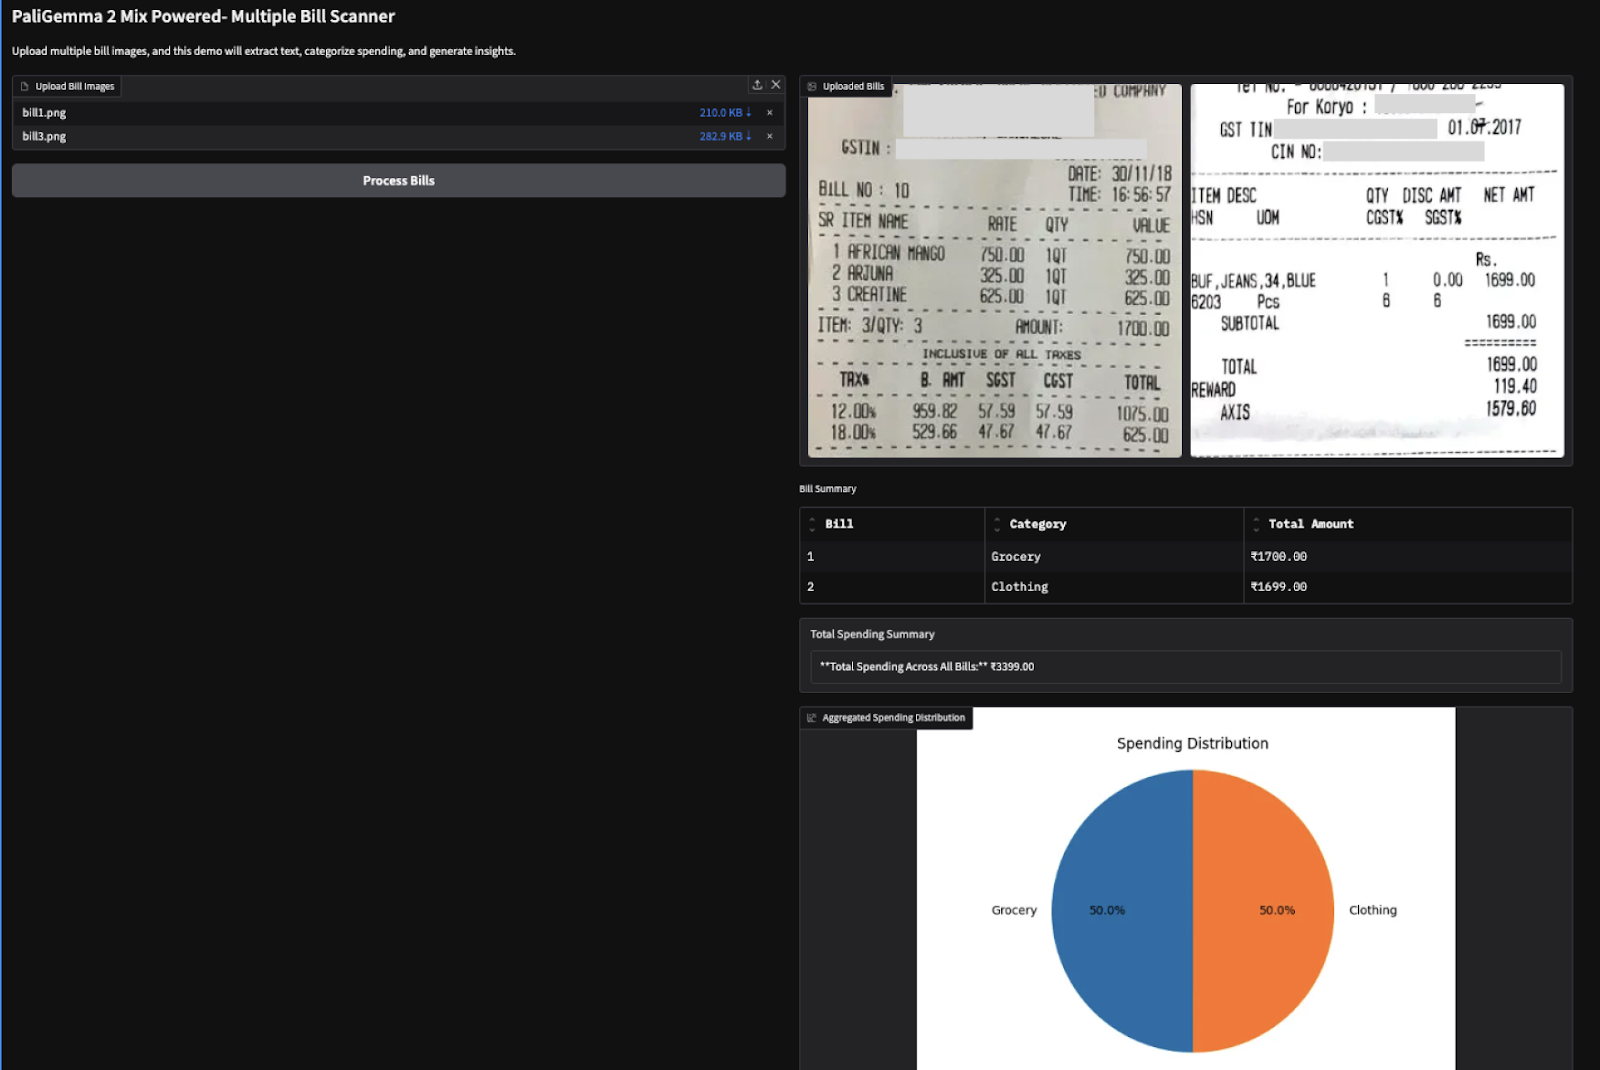
मैंने इस डेमो को दो इमेज-आधारित बिलों (Amazon शॉपिंग इनवॉइस) के साथ भी आज़माया और निम्नलिखित परिणाम प्राप्त किए।
ध्यान दें: VLMs के लिए संख्याएँ निकालना कठिन होता है, जिससे कभी-कभी गलत परिणाम आ सकते हैं। उदाहरण के लिए, नीचे दूसरे बिल की कुल राशि गलत निकाली गई। इसे बड़े मॉडलों के उपयोग या मौजूदा मॉडलों को फाइन-ट्यून करके सुधारा जा सकता है।
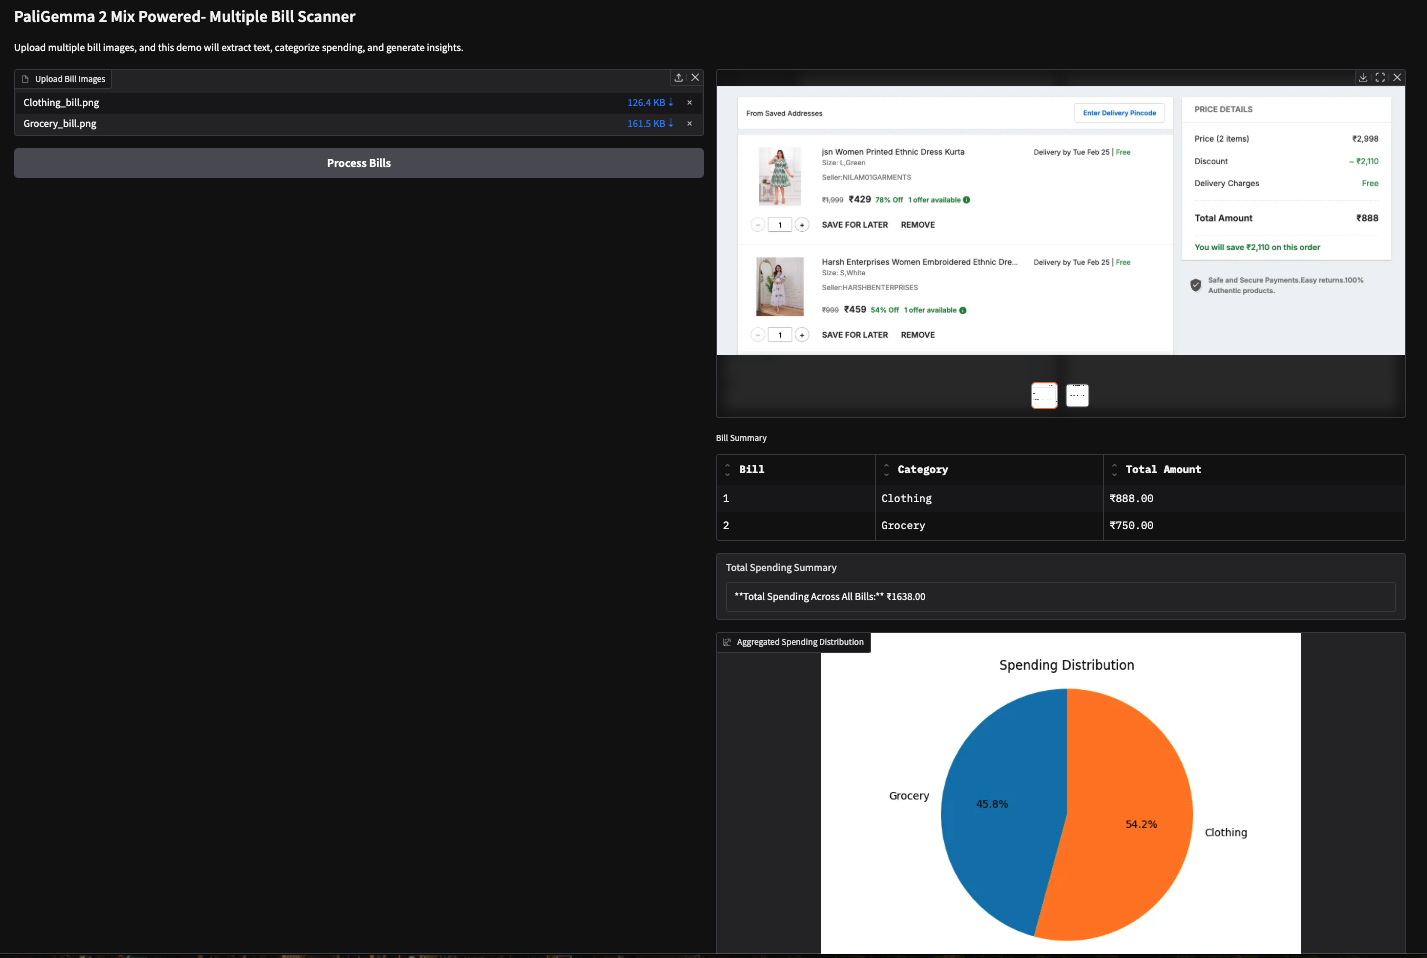
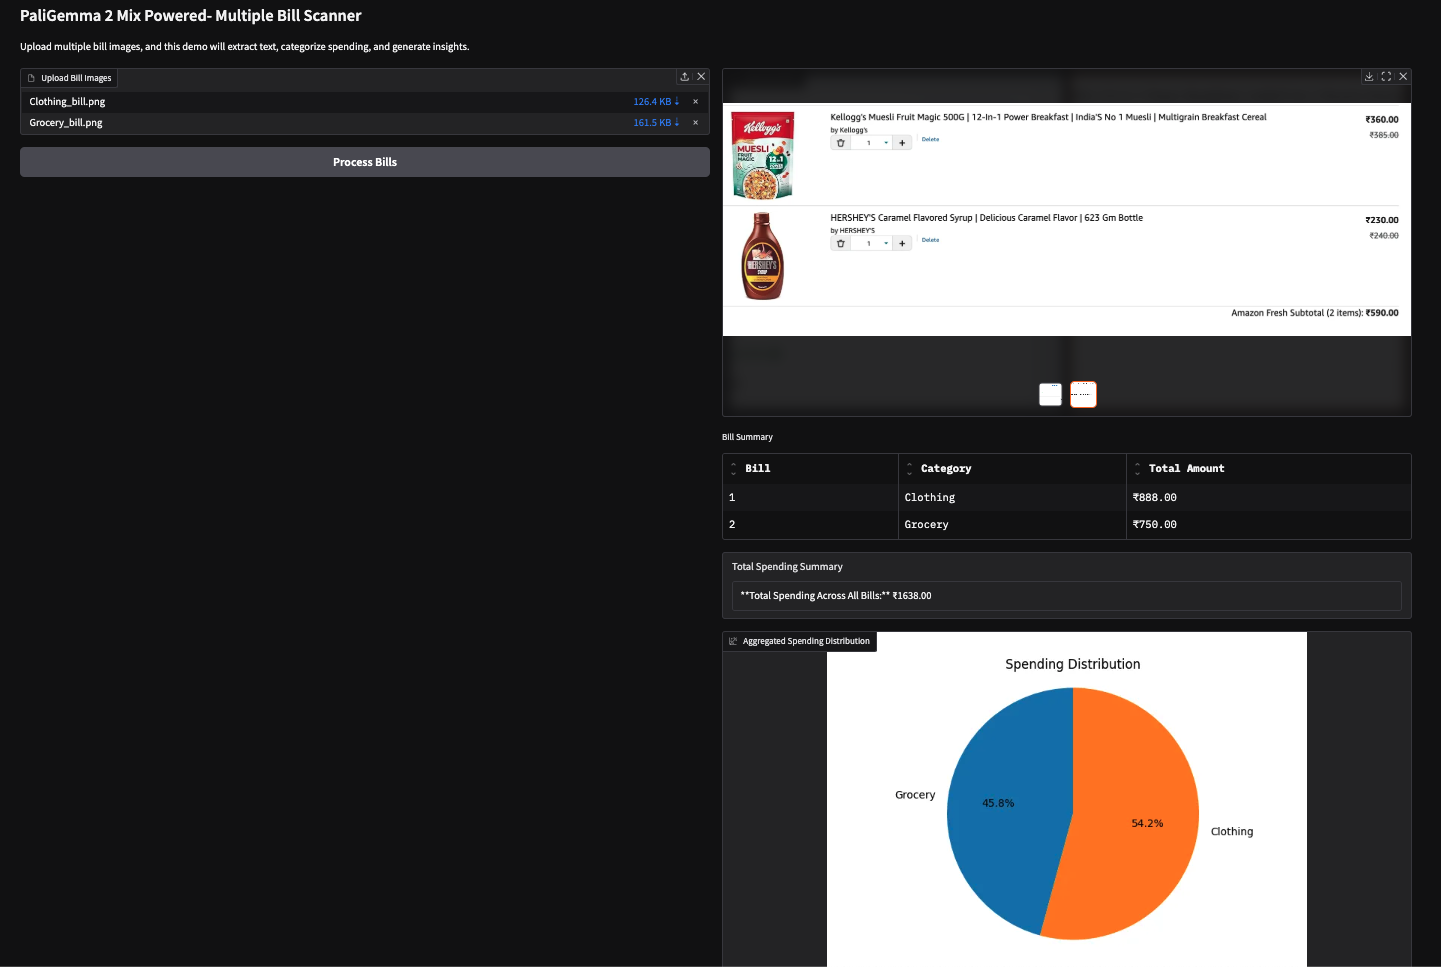
इस ट्यूटोरियल में, हमने PaliGemma 2 Mix का उपयोग करके एक AI-संचालित मल्टिपल बिल स्कैनर बनाया, जो हमें रसीदों से हमारे खर्चों को निकालने और श्रेणीबद्ध करने में मदद करता है। हमने खर्च इनसाइट्स का सहज विश्लेषण करने के लिए OCR और वर्गीकरण हेतु PaliGemma 2 Mix की विज़न-लैंग्वेज क्षमताओं का उपयोग किया। मैं आपको प्रोत्साहित करता/करती हूँ कि आप इस ट्यूटोरियल को अपने उपयोग-केस के अनुरूप ढालें।
इन कोर्सेज़ से AI सीखें!
लर्निंग पाथ
कोर्स
कोर्स
