
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
PaliGemma 2 Mix is een multimodaal AI-model ontwikkeld door Google. Het is een verbeterde versie van het PaliGemma-vision-language model (VLM), waarin geavanceerde mogelijkheden uit het SigLIP-visionmodel en de Gemma 2-taalmodellen zijn geïntegreerd.
In deze tutorial leg ik uit hoe je PaliGemma 2 Mix gebruikt om een AI-aangestuurde bonnenscanner en uitgavenanalysator te bouwen die het volgende kan:
Hoewel we ons richten op het bouwen van een tool voor financiële inzichten, kun je wat je hier leert ook toepassen op andere use-cases van PaliGemma 2 Mix, zoals beeldsegmentatie, objectdetectie en vraagbeantwoording.
PaliGemma 2 Mix is een geavanceerd vision-language model (VLM) dat zowel afbeeldingen als tekst als input verwerkt en tekstgebaseerde output genereert. Het is ontworpen voor een breed scala aan multimodale AI-taken en ondersteunt meerdere talen.
PaliGemma 2 is ontwikkeld voor een breed spectrum aan vision-language taken, waaronder het maken van onderschriften bij afbeeldingen en korte video’s, visuele vraagbeantwoording, optische tekenherkenning (OCR), objectdetectie en segmentatie.
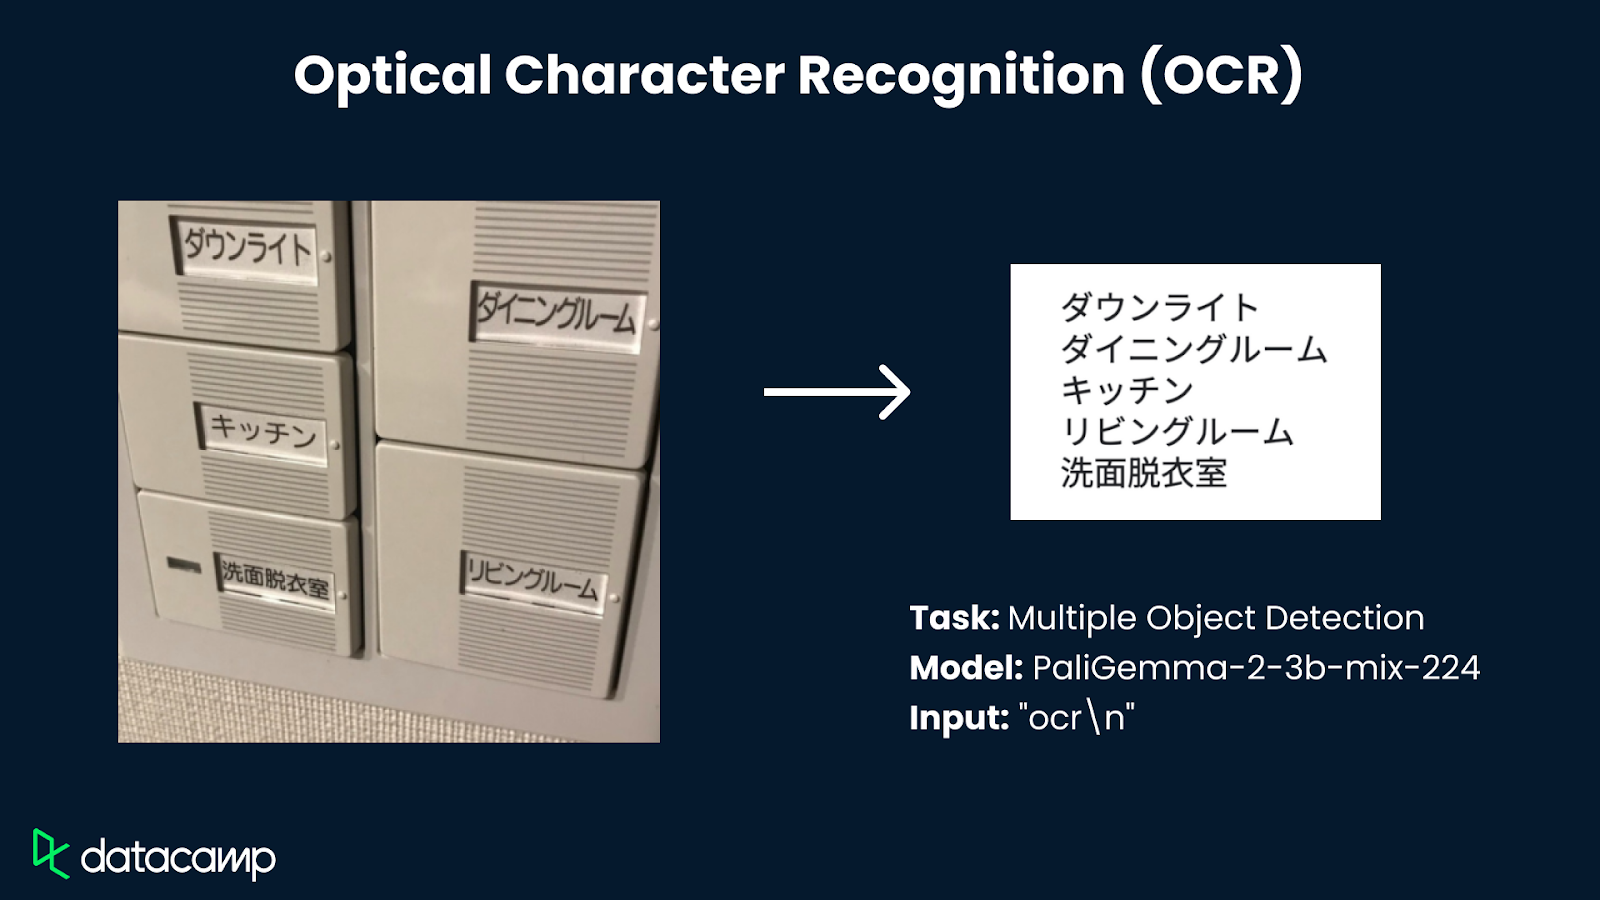
Bron van de afbeeldingen in het schema: Google
Het PaliGemma 2 Mix-model is ontworpen voor:
Meer informatie over het PaliGemma 2 Mix-model vind je in het officiële introductieartikel.
Laten we de belangrijkste stappen schetsen die we gaan nemen:
Voordat we beginnen, zorgen we dat we de volgende tools en libraries hebben geïnstalleerd:
Voer de volgende commando’s uit om de benodigde dependencies te installeren:
pip install gradio -U bitsandbytes -U transformers -qZodra de bovenstaande dependencies zijn geïnstalleerd, voer je de volgende import-commando’s uit:
import gradio as gr
import torch
import pandas as pd
import matplotlib.pyplot as plt
from transformers import PaliGemmaForConditionalGeneration, PaliGemmaProcessor, BitsAndBytesConfig
from transformers import BitsAndBytesConfig
from PIL import Image
import reWe configureren en laden het PaliGemma 2 Mix-model met kwantisatie om de prestaties te optimaliseren. Voor deze demo gebruiken we het 10b-parameter-model met een inputafbeeldingsresolutie van 448 x 448. Je hebt minimaal een T4-GPU met 40 GB geheugen (Colab-configuratie) nodig om dit model te draaien.
device = "cuda" if torch.cuda.is_available() else "cpu"
# Model setup
model_id = "google/paligemma2-10b-mix-448"
bnb_config = BitsAndBytesConfig(
    load_in_8bit=True,  # Change to load_in_4bit=True for even lower memory usage
    llm_int8_threshold=6.0,
)

# Load model with quantization
model = PaliGemmaForConditionalGeneration.from_pretrained(
    model_id, quantization_config=bnb_config
).eval()

# Load processor
processor = PaliGemmaProcessor.from_pretrained(model_id)
# Print success message
print("Model and processor loaded successfully!")
BitsAndBytes-kwantisatie helpt het geheugenverbruik te verlagen met behoud van prestaties, zodat grote modellen op beperkte GPU-middelen kunnen draaien. In deze implementatie gebruiken we 4-bit kwantisatie om het geheugengebruik verder te optimaliseren.
We laden het model met de klasse PaliGemmaForConditionalGeneration uit de transformers-bibliotheek door het model-ID en de kwantisatieconfiguratie door te geven. Op dezelfde manier laden we de processor, die de input voorbewerkt tot tensors voordat deze aan het model wordt doorgegeven.
Zodra de modelshards zijn geladen, verwerken we de afbeeldingen voordat we ze aan het model doorgeven, om compatibiliteit van het afbeeldingsformaat te behouden en uniformiteit te krijgen. We converteren afbeeldingen naar RGB-formaat:
def ensure_rgb(image: Image.Image) -> Image.Image:
    if image.mode != "RGB":
        image = image.convert("RGB")
    return image
Onze afbeeldingen zijn nu klaar voor inferentie.
We richten nu de hoofdfunctie in voor het draaien van inferentie met het model. Deze functie neemt invoerafbeeldingen en vragen, verwerkt die tot prompts en geeft ze via de processor door aan het model voor inferentie.
def ask_model(image: Image.Image, question: str) -> str:
    prompt = f"<image> answer en {question}"
    inputs = processor(text=prompt, images=image, return_tensors="pt").to(device)
    with torch.inference_mode():
        generated_ids = model.generate(
            **inputs,
            max_new_tokens=50,
            do_sample=False
        )
    result = processor.batch_decode(generated_ids, skip_special_tokens=True)
return result[0].strip()Nu de hoofdfunctie klaar is, gaan we aan de slag met het extraheren van de belangrijkste parameters uit de afbeelding— in ons geval zijn dat het totaalbedrag en de productcategorie.
 def extract_total_amount(image: Image.Image) -> float:
    question = "ocr\n what is the total amount? in numbers only"
    answer = ask_model(image, question)
    print(f"Answer from model: {answer}")
    try:
        amounts = re.findall(r'\d+\.\d+|\d+', answer)  # Capture both integer and decimal values
        if amounts:
            return float(amounts[-1])  # Get the last valid amount as the total
    except ValueError:
        pass
    return 0.0
De functie extract_total_amount() verwerkt een afbeelding om met OCR het totaalbedrag uit een bon te halen. Hij bouwt een query (vraag) die het model instrueert om alleen numerieke waarden te extraheren en roept vervolgens de functie ask_model() aan om een antwoord van het model te genereren.
def categorize_goods(image: Image.Image) -> str:
    question = "what is the category of goods in the image - Grocery/ Clothing/ Electronics/ Other?"
    answer = ask_model(image, question)
    print(f"Category from model: {answer}")
    answer = answer.split("\n")[-1].strip().capitalize()
    valid_categories = ["Grocery", "Clothing", "Electronics", "Other"]
    return answer if answer in valid_categories else "Other"
De functie categorize_goods() classificeert het type goederen in een afbeelding door het model te vragen te kiezen uit vooraf gedefinieerde categorieën: grocery, clothing, electronics of other. De functie ask_model() verwerkt vervolgens de afbeelding en geeft een tekstueel antwoord terug. Als het verwerkte antwoord overeenkomt met een van de vooraf gedefinieerde geldige categorieën, retourneert de functie die categorie—anders wordt standaard de categorie "Other" gebruikt.
We hebben alle kernfuncties klaar, dus laten we de outputs analyseren.
def generate_spending_chart(categories: dict):
    filtered_categories = {k: v for k, v in categories.items() if v > 0}  # Remove zero-value categories
    labels = list(filtered_categories.keys())
    values = list(filtered_categories.values())
    if not values or sum(values) == 0:
        fig, ax = plt.subplots()
        ax.text(0.5, 0.5, "No Spending Data", ha="center", va="center", fontsize=12)
        ax.axis("off")
        return fig
    fig, ax = plt.subplots()
    ax.pie(values, labels=labels, autopct='%1.1f%%', startangle=90)
    ax.axis('equal')
    plt.title("Spending Distribution")
    return fig
Bovenstaande functie maakt een cirkeldiagram om de verdeling van uitgaven over verschillende categorieën te visualiseren. Als er geen geldige uitgavendata zijn, wordt een lege figuur gegenereerd met de melding "No Spending Data". Anders wordt een cirkeldiagram gemaakt met categorielabels en percentagewaarden, voor een proportionele en netjes uitgelijnde visualisatie.
We hebben meestal meerdere bonnetjes om te analyseren, dus laten we een functie maken die al onze bonnetjes tegelijk verwerkt.
def process_multiple_bills(files: list):
    results = []
    images = []
    total_spending = 0
    category_totals = {"Grocery": 0, "Clothing": 0, "Electronics": 0, "Other": 0}
    for file in files:
        image = Image.open(file)
        image = ensure_rgb(image)
        images.append(image)
        total_amount = extract_total_amount(image)
        category = categorize_goods(image)
        total_spending += total_amount
        category_totals[category] += total_amount
        results.append({"Bill": len(results) + 1, "Category": category, "Total Amount": f"₹{total_amount:.2f}"})
    pie_chart = generate_spending_chart(category_totals)
    summary_text = f"**Total Spending Across All Bills:** ₹{total_spending:.2f}"
    return images, pd.DataFrame(results), summary_text, pie_chart
Voor het in één keer analyseren van meerdere bonnetjes voeren we de volgende stappen uit:
DataFrame met bonoverzichten, de samenvatting van de totale uitgaven en het diagram.We hebben nu alle kernlogica klaar. Vervolgens bouwen we een interactieve UI met Gradio.
def gradio_demo():
    with gr.Blocks() as demo:
        gr.Markdown("## PaliGemma 2 Mix Powered- Multiple Bill Scanner\nUpload multiple bill images, and this demo will extract text, categorize spending, and generate insights.")
        with gr.Row():
            with gr.Column():
                image_input = gr.File(file_count="multiple", file_types=["image"], label="Upload Bill Images")
                submit_button = gr.Button("Process Bills")
            with gr.Column():
                image_output = gr.Gallery(label="Uploaded Bills")
                table_output = gr.Dataframe(label="Bill Summary")
                summary_output = gr.Text(label="Total Spending Summary")
                chart_output = gr.Plot(label="Aggregated Spending Distribution")
        submit_button.click(
            fn=process_multiple_bills,
            inputs=image_input,
            outputs=[image_output, table_output, summary_output, chart_output]
        )
    demo.launch(debug=True)

if __name__ == "__main__":
    gradio_demo()
Bovenstaande code maakt een gestructureerde Gradio-UI met een bestandsuploader voor meerdere afbeeldingen en een verzendknop om de verwerking te starten. Na het indienen worden geüploade bonafbeeldingen weergegeven in een galerij, geëxtraheerde data in een tabel, de totale uitgaven samengevat in tekst en een cirkeldiagram met de uitgavenverdeling gegenereerd.
De functie koppelt gebruikersinvoer aan de functie process_multiple_bills(), voor naadloze data-extractie en visualisatie. Tot slot start demo.launch() de Gradio-app voor interactie in real time.
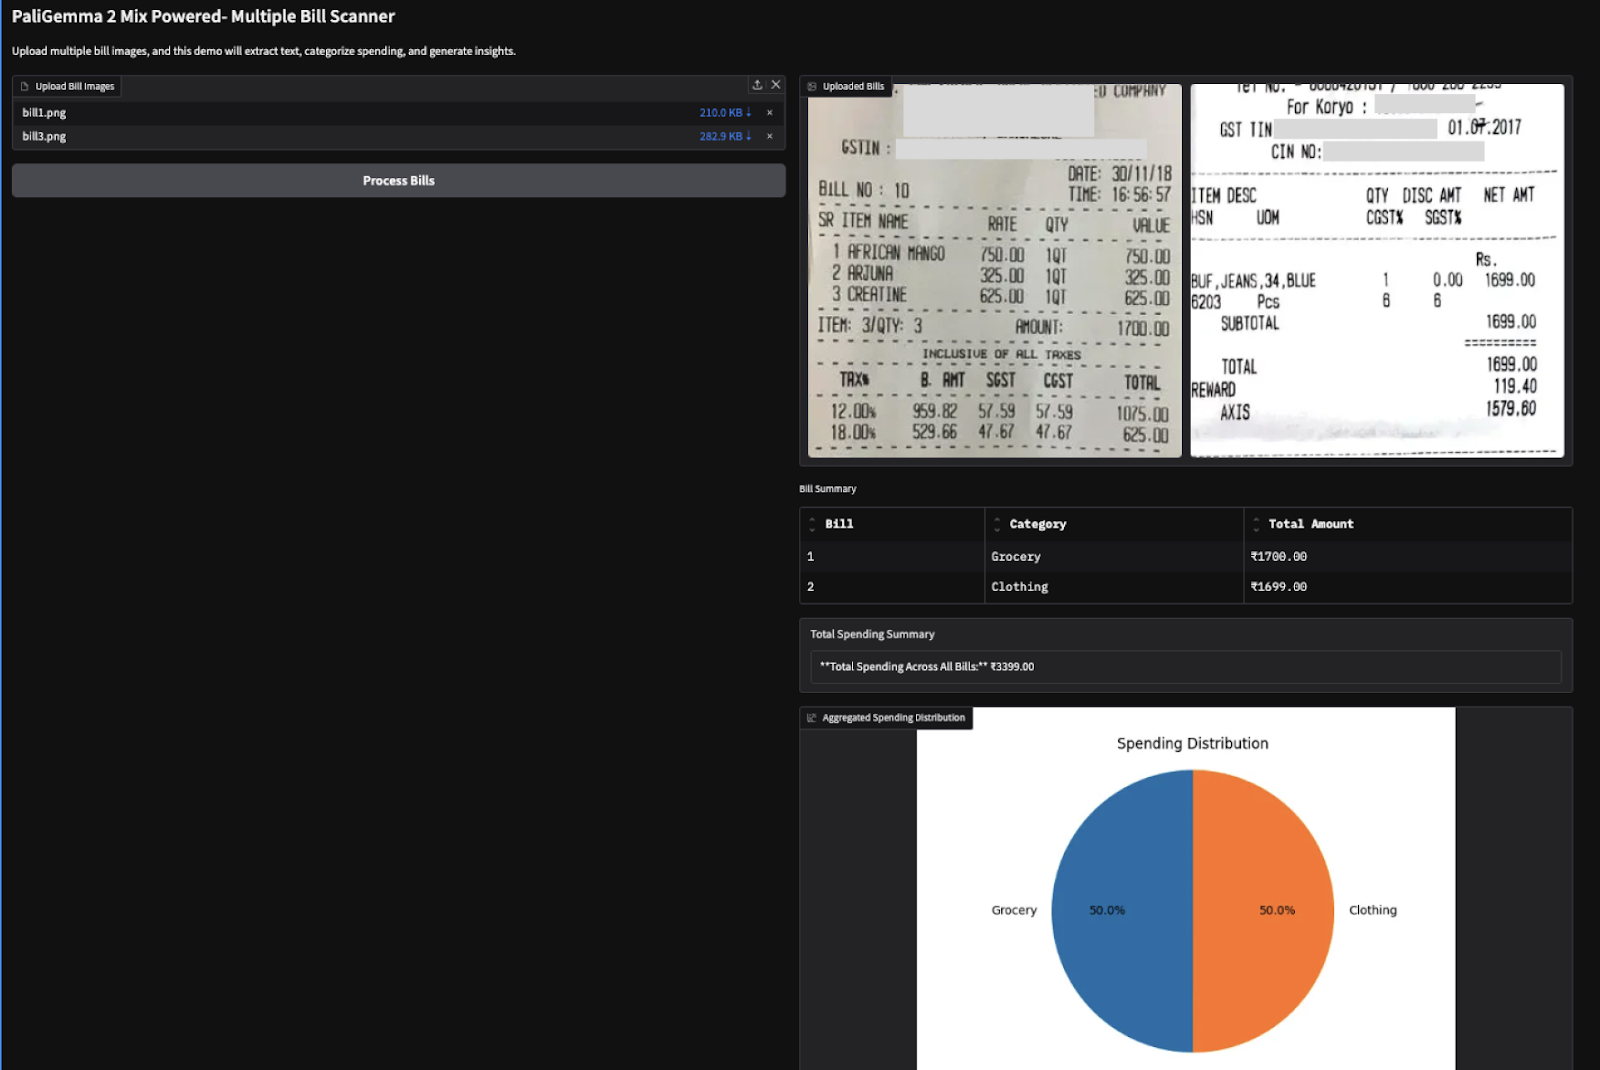
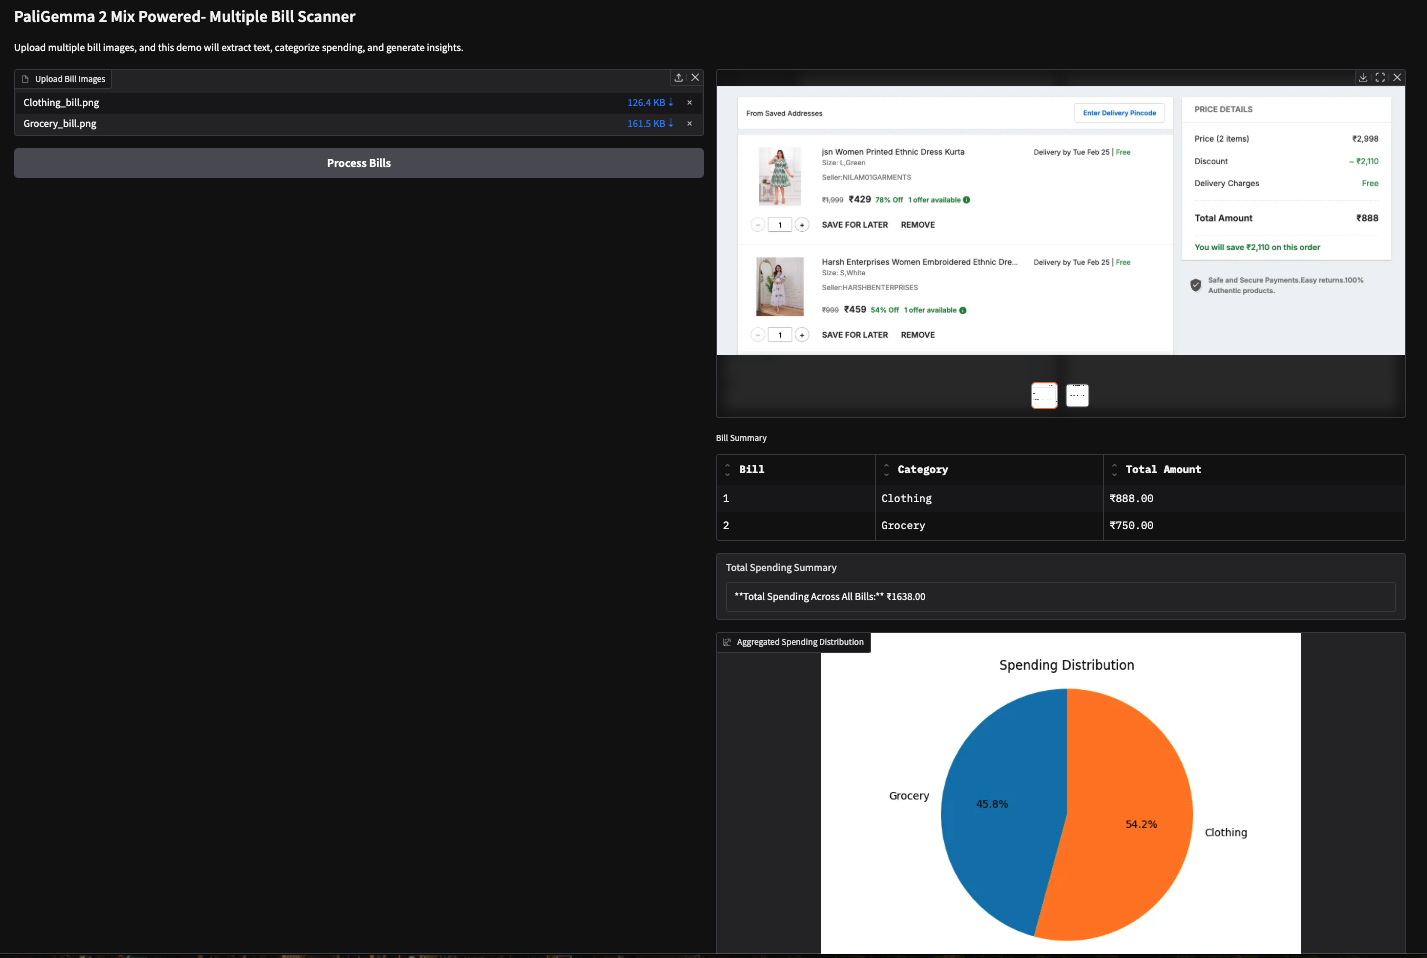
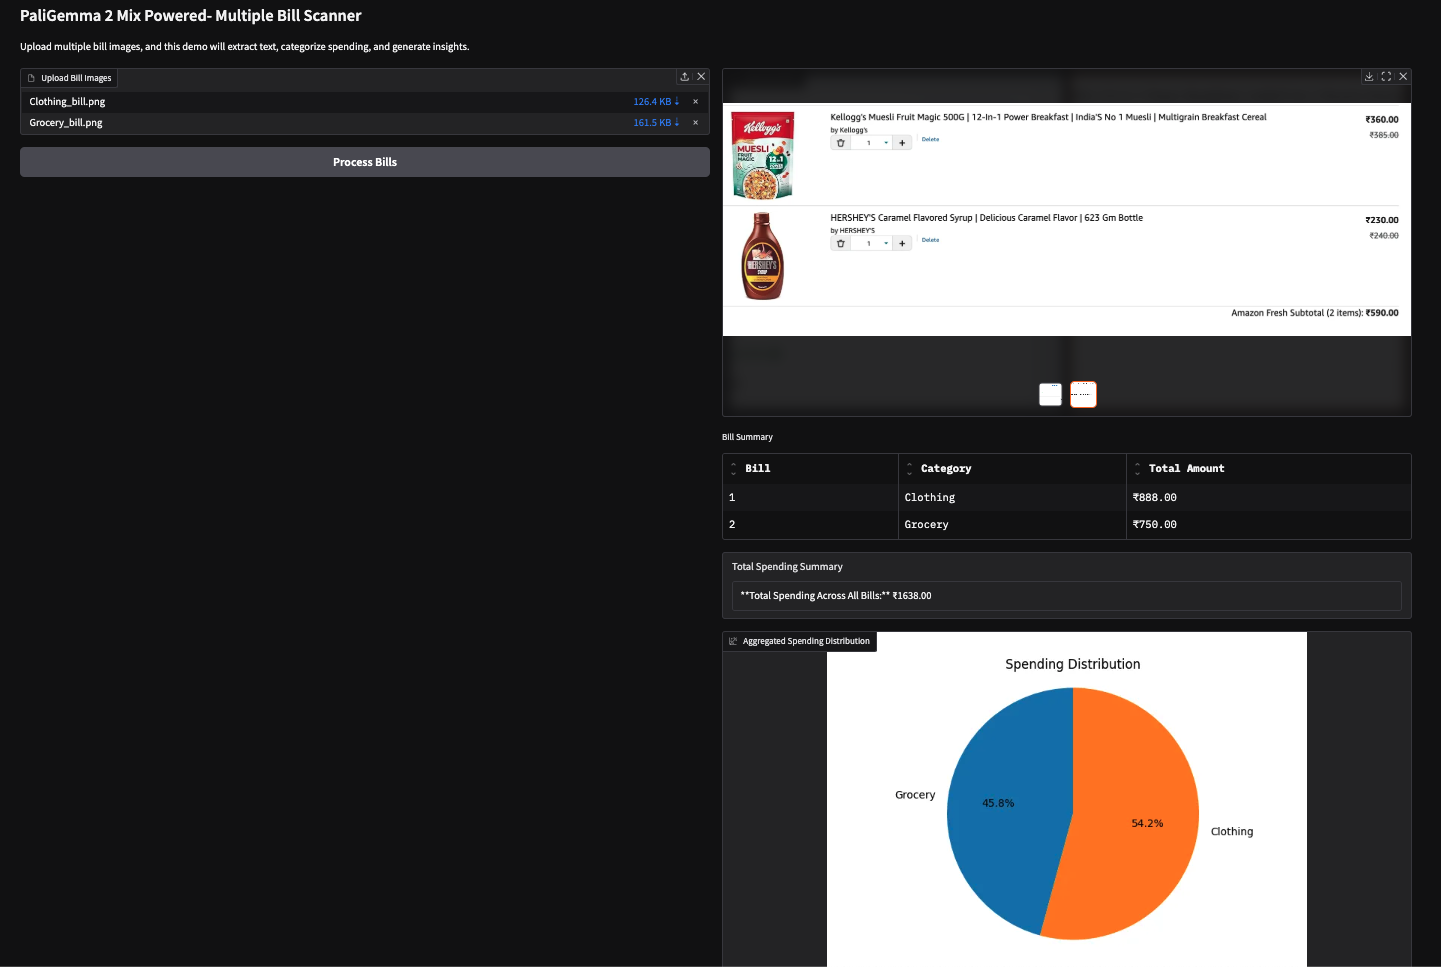
Ik heb deze demo ook getest met twee beeldgebaseerde bonnetjes (Amazon-aankoopfactuur) en kreeg de volgende resultaten.
Let op: VLM’s hebben moeite met het extraheren van getallen, wat soms tot onjuiste resultaten kan leiden. Zo haalde het voor de tweede bon hieronder het verkeerde totaalbedrag op. Dit is te corrigeren met grotere modellen of door het bestaande model te fine-tunen.
In deze tutorial hebben we een AI-aangestuurde meervoudige bonnenscanner gebouwd met PaliGemma 2 Mix, die ons helpt uitgaven uit bonnetjes te extraheren en te categoriseren. We hebben de vision-language mogelijkheden van PaliGemma 2 Mix gebruikt voor OCR en classificatie om moeiteloos uitgaveninzichten te analyseren. Ik moedig je aan om deze tutorial aan te passen aan jouw eigen use-case.
Leer AI met deze cursussen!
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


