Kursus
Pemrosesan Citra dengan Python
4 jam
56.9K
Inti dari vision language models adalah integrasi computer vision dan natural language processing.
Computer vision berfokus pada memungkinkan mesin menafsirkan dan menganalisis data visual, seperti gambar dan video, dengan mengenali objek, pola, dan elemen visual lainnya.
Di sisi lain, natural language processing berkaitan dengan memahami dan menghasilkan bahasa manusia, sehingga mesin dapat memahami, menganalisis, dan menghasilkan teks.
VLM menjembatani kesenjangan antara kedua bidang ini dengan menciptakan model yang dapat secara bersamaan memproses dan memahami masukan visual dan tekstual. Hal ini dicapai melalui arsitektur deep learning tingkat lanjut, khususnya model transformer, yang sangat berperan dalam keberhasilan large language model seperti GPT-4o, Llama, Gemini, dan Gemma.
Arsitektur berbasis transformer ini telah diadaptasi untuk menangani masukan multimodal, memungkinkan VLM menangkap hubungan kompleks antara data visual dan linguistik.
Model transformer, yang awalnya diperkenalkan untuk tugas NLP, telah menjadi tulang punggung banyak sistem AI canggih karena kemampuannya menangani ketergantungan jangka panjang dan menangkap hubungan kontekstual dalam data.
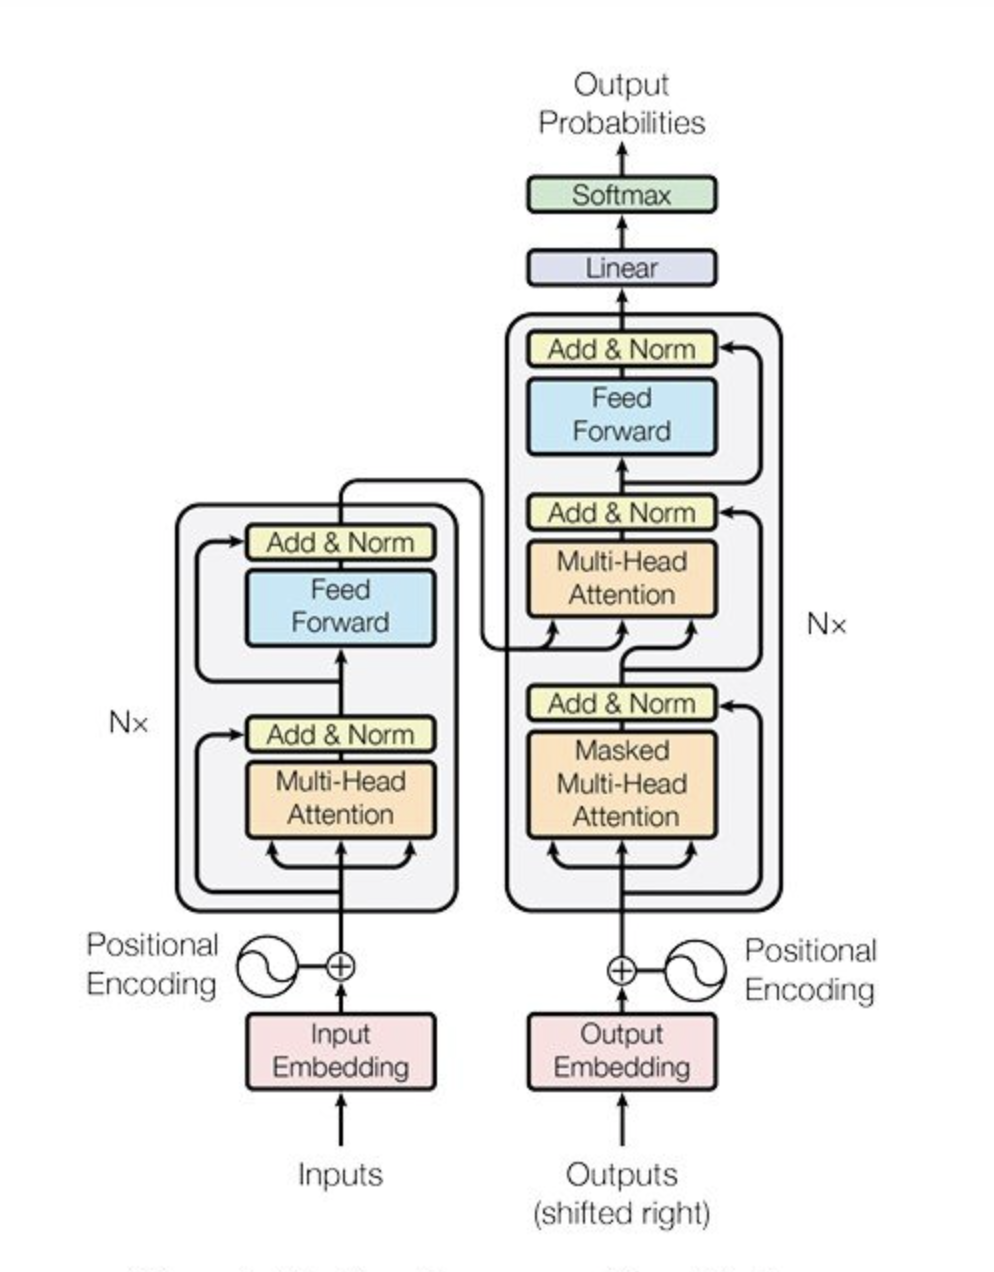
Sumber: Vaswani dkk., 2017
Dalam konteks VLM, transformer telah diadaptasi untuk memproses gambar dan teks sekaligus, sehingga integrasi kedua modalitas ini berlangsung mulus.
Arsitektur VLM yang umum melibatkan dua komponen utama: image encoder dan text decoder:
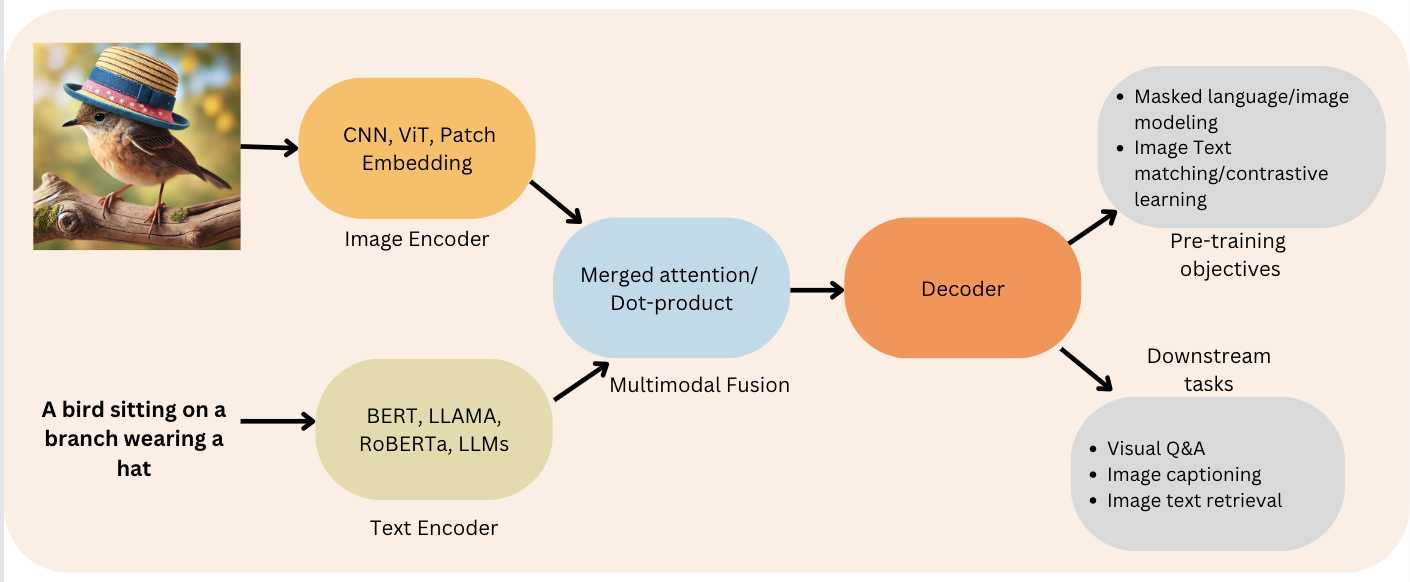
Gambar 2: Fungsi Encoder-Decoder (Sumber: Viso.ai)
Dengan menggabungkan kedua bagian ini, VLM dapat melakukan hal-hal hebat seperti mendeskripsikan gambar secara detail, menjawab pertanyaan tentang apa yang terlihat, dan bahkan membuat gambar baru berdasarkan deskripsi teks! Proses yang diikuti VLM meliputi langkah-langkah berikut:
Sebagian besar VLM memanfaatkan Vision Transformer (ViT) sebagai image encoder, yang telah dipra-latih pada dataset gambar skala besar agar mampu menangkap fitur visual yang diperlukan untuk tugas multimodal secara efektif.
Text decoder berbasis model bahasa, yang telah di-fine-tune untuk menangani seluk-beluk generasi bahasa dalam konteks data visual. Kombinasi kemampuan pemrosesan visual dan linguistik yang maju ini menghasilkan VLM yang sangat serbaguna dan kuat.
Salah satu tantangan paling signifikan dalam mengembangkan VLM adalah kebutuhan akan dataset yang besar dan beragam yang memuat informasi visual dan tekstual. Dataset ini penting untuk melatih model agar dapat memahami dan menghasilkan konten multimodal.
Proses pelatihan VLM melibatkan pemberian pasangan gambar dan deskripsi tekstualnya kepada model, sehingga model dapat mempelajari hubungan rumit antara elemen visual dan ekspresi linguistik.
Untuk menangani data ini, VLM sering menggunakan lapisan embedding yang mengubah masukan visual dan tekstual ke dalam ruang berdimensi tinggi tempat keduanya dapat dibandingkan dan digabungkan.
Proses embedding ini memungkinkan model memahami keterkaitan antara kedua modalitas dan menghasilkan keluaran yang koheren serta relevan secara kontekstual.
Lanskap vision language models (VLM) sangat luas, dengan banyak model sumber terbuka tersedia di Hugging Face Hub. Model-model ini bervariasi dalam ukuran, kapabilitas, dan lisensi, memberi pengguna beragam opsi yang sesuai dengan berbagai aplikasi. Berikut gambaran beberapa VLM sumber terbuka terkemuka beserta fitur utamanya:
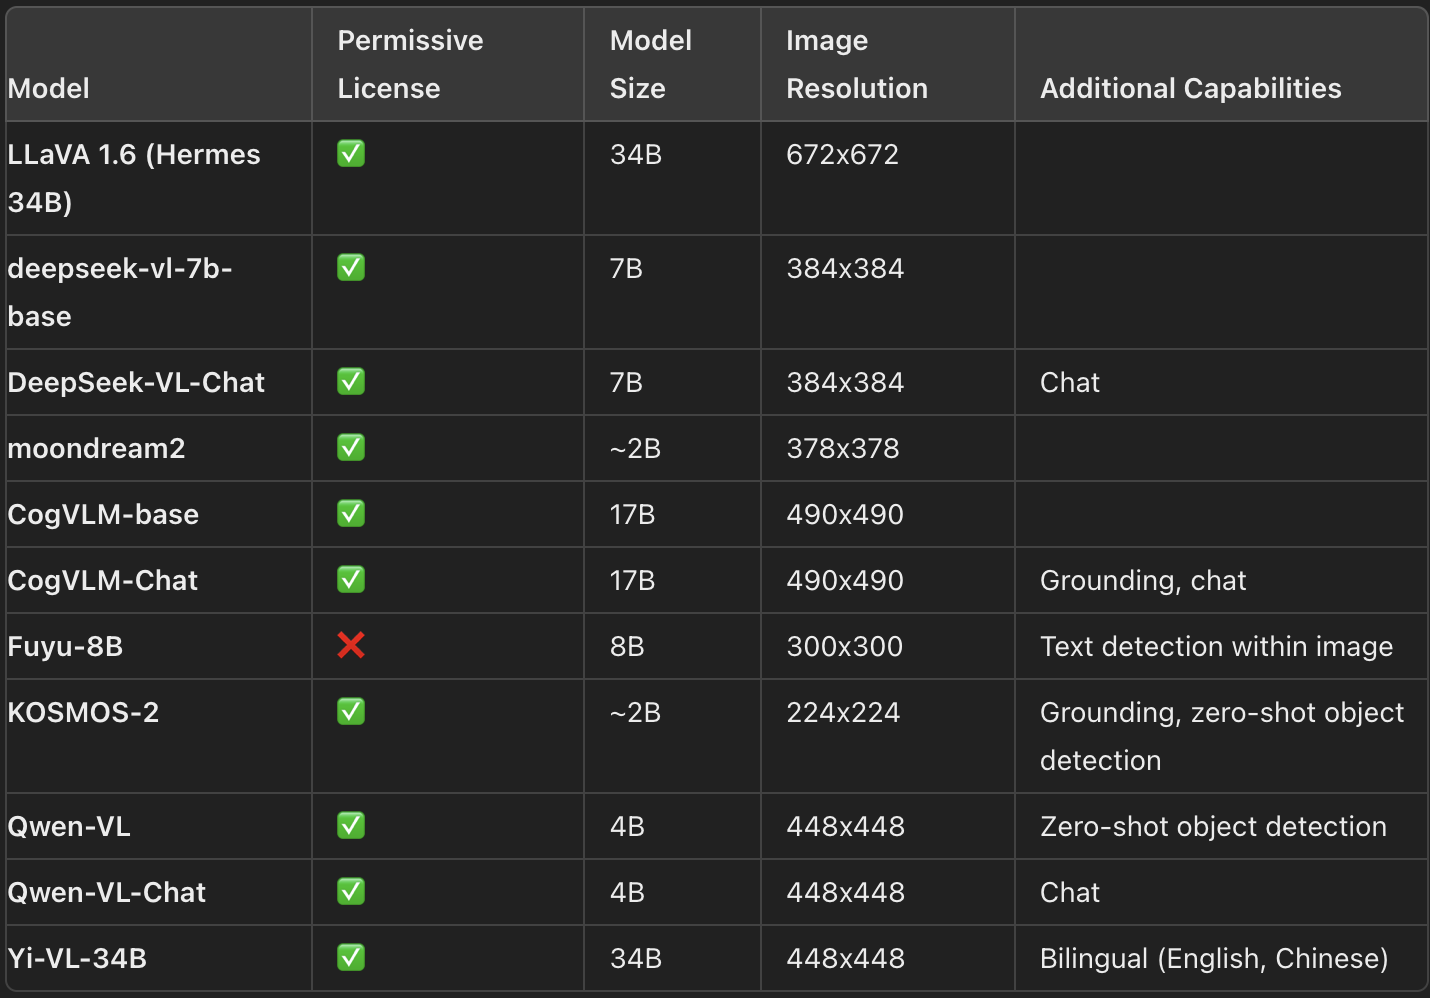
VLM terbaru dan fitur utamanya (Sumber: HuggingFace)
Memilih VLM yang paling sesuai untuk kasus penggunaan spesifik Anda bisa menjadi tantangan, mengingat banyaknya opsi yang tersedia. Beberapa alat dan sumber daya dapat membantu dalam proses seleksi ini:
Meskipun Vision Arena dan Open VLM Leaderboard sama-sama menyediakan wawasan berharga, keduanya terbatas pada model yang telah dikirimkan dan memerlukan pembaruan rutin untuk memasukkan model-model baru.
Beberapa tolok ukur yang umum digunakan untuk mengevaluasi kinerja VLM:
Pretraining VLM melibatkan penyatuan representasi gambar dan teks untuk diberi ke text decoder guna generasi. Strukturnya biasanya mencakup image encoder, embedding projector untuk menyelaraskan representasi gambar dan teks, serta text decoder. Namun, model yang berbeda menerapkan strategi pretraining yang berbeda.
Dalam banyak kasus, pretraining VLM bahkan tidak diperlukan jika Anda dapat melakukan fine-tune pada model yang ada untuk kasus penggunaan spesifik Anda. Alat seperti Transformers dan SFTTrainer menyederhanakan proses fine-tuning model untuk tugas tertentu, sehingga dapat diakses bahkan bagi mereka yang memiliki sumber daya terbatas.
Berikut adalah implementasi HuggingFace untuk menggunakan model VLM sumber terbuka LlavaNext secara gratis di Colab atau mesin lokal Anda dengan pustaka Transformers dari HuggingFace.
from transformers import LlavaNextProcessor, LlavaNextForConditionalGeneration
import torch
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
processor = LlavaNextProcessor.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf"
)
model = LlavaNextForConditionalGeneration.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf",
    torch_dtype=torch.float16,
    low_cpu_mem_usage=True
)
model.to(device)Kapabilitas vision language models jauh melampaui pembuatan caption gambar. VLM membuka pintu bagi banyak aplikasi yang memanfaatkan kemampuan mereka menjembatani informasi visual dan tekstual. Mari jelajahi beberapa aplikasi VLM yang paling berdampak di berbagai industri.
Visual question answering (VQA) adalah tugas yang melibatkan menjawab pertanyaan tentang konten sebuah gambar.
Aplikasi ini mengharuskan model memahami elemen visual dalam gambar dan konteks linguistik dari pertanyaan. Misalnya, dengan gambar lanskap kota yang ramai, VLM dapat menjawab pertanyaan seperti "Apa warna gedung tertinggi?" atau "Berapa banyak orang yang terlihat dalam gambar?"
VQA memiliki banyak aplikasi praktis, khususnya di industri yang sangat bergantung pada data visual. Dalam layanan kesehatan, misalnya, VQA dapat digunakan untuk menganalisis citra medis dan memberikan jawaban atas pertanyaan yang membantu diagnosis dan perencanaan perawatan. Di ritel, VQA dapat meningkatkan pengalaman berbelanja dengan memungkinkan pelanggan berinteraksi dengan gambar produk secara lebih natural dan intuitif.
Salah satu kemampuan VLM yang paling menarik adalah pembuatan gambar dari teks. Tugas ini melibatkan pembuatan representasi visual dari suatu skena atau objek berdasarkan deskripsi tekstual. Misalnya, VLM dapat mengambil prompt seperti "Senja yang tenang di atas pegunungan dengan sungai yang mengalir melalui lembah" dan menghasilkan gambar yang sesuai.
Pembuatan gambar dari teks memiliki potensi besar di bidang kreatif seperti desain dan periklanan. Desainer dan pengiklan dapat menggunakan teknologi ini untuk dengan cepat menghasilkan ide visual berdasarkan prompt tekstual. Pembuatan gambar dari teks dapat memperlancar proses pembuatan konten visual yang selaras dengan pesan pemasaran tertentu.
Pencarian gambar adalah proses menemukan gambar yang relevan berdasarkan kueri tekstual. VLM unggul dalam tugas ini dengan memanfaatkan kemampuannya memahami konten visual gambar dan konteks linguistik dari kueri.
Kemampuan ini membuat mesin telusur lebih andal dan presisi, sehingga pengguna lebih mudah menemukan gambar yang mereka cari dengan tepat.
Pencarian gambar memiliki aplikasi di berbagai domain, dari e-commerce hingga analisis citra medis. Dalam e-commerce, pencarian gambar dapat membantu pelanggan menemukan produk yang sesuai preferensi berdasarkan deskripsi visual dan tekstual. Dalam layanan kesehatan, pencarian gambar dapat membantu tenaga medis menemukan citra medis yang relevan untuk penelitian atau tujuan diagnostik.
Walaupun contoh di atas berfokus pada gambar, VLM juga dapat diperluas untuk memahami dan menghasilkan caption untuk video. Pemahaman video melibatkan analisis konten visual dari sebuah video dan menghasilkan teks deskriptif yang menangkap esensi adegan yang ditampilkan.
Pemahaman video memiliki aplikasi dalam penelusuran video, peringkasan, dan moderasi konten. Dalam penelusuran video, VLM dapat membantu pengguna menemukan klip video tertentu berdasarkan kueri tekstual. Dalam tugas peringkasan, VLM dapat menghasilkan ringkasan singkat dari video panjang, sehingga memudahkan pengguna memahami konten dengan cepat. Dalam moderasi konten, VLM dapat membantu mengidentifikasi konten yang tidak pantas atau berbahaya dalam video, memastikan platform tetap aman dan ramah pengguna.
Sekarang mari pertimbangkan tantangan yang terkait dengan VLM, serta aspek etisnya.
Melatih dan menerapkan VLM memerlukan sumber daya komputasi yang signifikan, terutama untuk model besar seperti PaliGemma. Ini bisa menjadi hambatan bagi organisasi dengan akses terbatas ke infrastruktur komputasi berkinerja tinggi.
Untuk mengatasi tantangan ini, peneliti mengeksplorasi cara membuat VLM lebih efisien, seperti menggunakan teknik kompresi model, mengoptimalkan arsitektur model, dan memanfaatkan akselerator perangkat keras seperti GPU dan TPU.
Pengembangan VLM menimbulkan beberapa kekhawatiran etis, khususnya terkait potensi bias dalam keluaran model. VLM yang dilatih pada data gambar-teks skala besar dari dunia nyata dapat mencerminkan bias sosial-budaya yang tertanam dalam materi pelatihan. Bias ini dapat muncul dalam keluaran model, menghasilkan konten yang merugikan atau menyinggung.
Untuk mengatasi kekhawatiran ini, peneliti menerapkan berbagai teknik mitigasi bias, seperti menggunakan dataset pelatihan yang seimbang, memasukkan algoritma pembelajaran yang memperhatikan keadilan, dan melakukan evaluasi ketat atas keluaran model untuk mengidentifikasi dan menangani potensi bias.
Selain itu, organisasi seperti Google menerapkan filter keamanan konten untuk memastikan bahwa data pelatihan yang digunakan untuk model seperti PaliGemma bersih dan bebas dari konten berbahaya.
Pertimbangan penting lainnya dalam pengembangan VLM adalah privasi dan keamanan data. VLM sering memerlukan akses ke sejumlah besar data, termasuk informasi yang berpotensi sensitif. Memastikan data ini ditangani dengan aman dan sesuai dengan regulasi privasi sangat penting untuk menjaga kepercayaan pengguna dan pemangku kepentingan.
Untuk mengatasi kekhawatiran privasi, peneliti mengeksplorasi teknik seperti federated learning, yang memungkinkan model dilatih pada data terdesentralisasi tanpa perlu mentransfer informasi sensitif ke server pusat.
Selain itu, organisasi seperti Google menerapkan langkah tanggung jawab data, seperti menyaring informasi pribadi dan data sensitif dari dataset pelatihan, untuk melindungi privasi individu.
Vision language models merupakan lompatan besar dalam kecerdasan buatan, menawarkan potensi untuk meningkatkan berbagai aplikasi melalui kemampuan mereka memproses data visual dan tekstual.
Seiring kemajuan riset di bidang ini, kita dapat mengantisipasi pengembangan VLM yang lebih canggih yang mampu menjalankan tugas kompleks dan memberikan wawasan berharga.
Integrasi pemahaman visual dan tekstual membuka kemungkinan baru untuk inovasi, menjadikan VLM sebagai area penelitian dan pengembangan yang menjanjikan.
Pelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




