
Programma
Sviluppare applicazioni AI
21 ore
PaliGemma 2 Mix è un modello di IA multimodale sviluppato da Google. È una versione migliorata del modello linguistico di visione (VLM) PaliGemma, che integra funzionalità avanzate dal modello di visione SigLIP e dai modelli linguistici Gemma 2.
In questo tutorial ti spiegherò come usare PaliGemma 2 Mix per creare uno scanner di scontrini e un analizzatore di spese basati sull’IA in grado di:
Anche se ci concentreremo sulla creazione di uno strumento per insight finanziari, quello che impari in questo blog può servirti per esplorare altri casi d’uso di PaliGemma 2 Mix, come segmentazione di immagini, rilevamento di oggetti e question answering.
PaliGemma 2 Mix è un avanzato modello visione-linguaggio (VLM) che elabora sia immagini sia testo in input e genera output testuali. È progettato per gestire una vasta gamma di compiti di IA multimodale supportando più lingue.
PaliGemma 2 è pensato per un’ampia serie di task visione-linguaggio, tra cui didascalie per immagini e brevi video, visual question answering, riconoscimento ottico dei caratteri (OCR), rilevamento di oggetti e segmentazione.
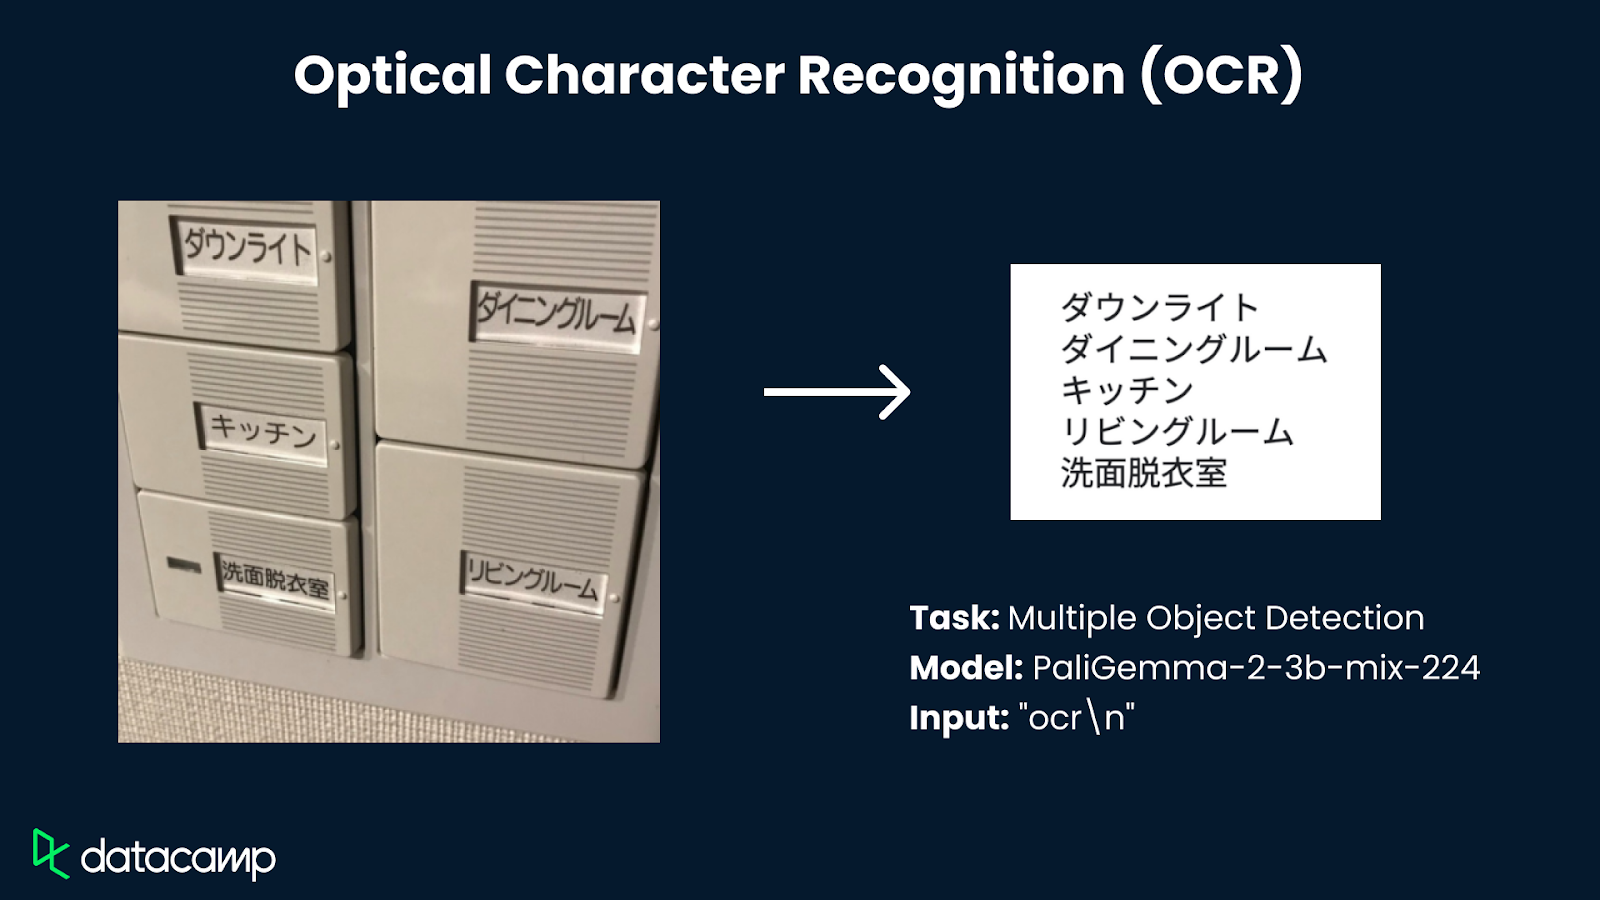
Fonte delle immagini usate nello schema: Google
Il modello PaliGemma 2 Mix è pensato per:
Puoi trovare maggiori informazioni sul modello PaliGemma 2 Mix nell’articolo di rilascio ufficiale.
Vediamo i passaggi principali che seguiremo:
Prima di iniziare, assicuriamoci di avere installati i seguenti strumenti e librerie:
Esegui i seguenti comandi per installare le dipendenze necessarie:
pip install gradio -U bitsandbytes -U transformers -qUna volta installate le dipendenze sopra, esegui i seguenti comandi di import:
import gradio as gr
import torch
import pandas as pd
import matplotlib.pyplot as plt
from transformers import PaliGemmaForConditionalGeneration, PaliGemmaProcessor, BitsAndBytesConfig
from transformers import BitsAndBytesConfig
from PIL import Image
import reConfiguriamo e carichiamo il modello PaliGemma 2 Mix con la quantizzazione per ottimizzare le prestazioni. Per questa demo useremo il modello da 10 miliardi di parametri con risoluzione d’ingresso delle immagini 448 x 448. Ti serve almeno una GPU T4 con 40GB di memoria (configurazione Colab) per eseguire questo modello.
device = "cuda" if torch.cuda.is_available() else "cpu"
# Model setup
model_id = "google/paligemma2-10b-mix-448"
bnb_config = BitsAndBytesConfig(
    load_in_8bit=True,  # Change to load_in_4bit=True for even lower memory usage
    llm_int8_threshold=6.0,
)

# Load model with quantization
model = PaliGemmaForConditionalGeneration.from_pretrained(
    model_id, quantization_config=bnb_config
).eval()

# Load processor
processor = PaliGemmaProcessor.from_pretrained(model_id)
# Print success message
print("Model and processor loaded successfully!")
La quantizzazione BitsAndBytes aiuta a ridurre l’uso di memoria mantenendo le prestazioni, rendendo possibile eseguire modelli grandi su risorse GPU limitate. In questa implementazione usiamo la quantizzazione a 4 bit per ottimizzare ulteriormente l’efficienza della memoria.
Carichiamo il modello usando la classe PaliGemmaForConditionalGeneration della libreria transformers, passando l’ID del modello e la configurazione di quantizzazione. In modo analogo carichiamo il processor, che preelabora gli input in tensori prima di passarli al modello.
Una volta caricati gli shard del modello, elaboriamo le immagini prima di passarle al modello per mantenere la compatibilità del formato e ottenere uniformità. Convertiamo le immagini in formato RGB:
def ensure_rgb(image: Image.Image) -> Image.Image:
    if image.mode != "RGB":
        image = image.convert("RGB")
    return image
Ora le nostre immagini sono pronte per l’inferenza.
Ora impostiamo la funzione principale per eseguire l’inferenza con il modello. Questa funzione prende immagini e domande in input, le incorpora in prompt e le passa al modello tramite il processor per l’inferenza.
def ask_model(image: Image.Image, question: str) -> str:
    prompt = f"<image> answer en {question}"
    inputs = processor(text=prompt, images=image, return_tensors="pt").to(device)
    with torch.inference_mode():
        generated_ids = model.generate(
            **inputs,
            max_new_tokens=50,
            do_sample=False
        )
    result = processor.batch_decode(generated_ids, skip_special_tokens=True)
return result[0].strip()Ora che abbiamo pronta la funzione principale, passiamo all’estrazione dei parametri chiave dall’immagine: nel nostro caso, importo totale e categoria merceologica.
 def extract_total_amount(image: Image.Image) -> float:
    question = "ocr\n what is the total amount? in numbers only"
    answer = ask_model(image, question)
    print(f"Answer from model: {answer}")
    try:
        amounts = re.findall(r'\d+\.\d+|\d+', answer)  # Capture both integer and decimal values
        if amounts:
            return float(amounts[-1])  # Get the last valid amount as the total
    except ValueError:
        pass
    return 0.0
La funzione extract_total_amount() elabora un’immagine per estrarre l’importo totale da una ricevuta tramite OCR. Costruisce una query (domanda) che istruisce il modello a estrarre solo valori numerici, quindi chiama la funzione ask_model() per generare una risposta dal modello.
def categorize_goods(image: Image.Image) -> str:
    question = "what is the category of goods in the image - Grocery/ Clothing/ Electronics/ Other?"
    answer = ask_model(image, question)
    print(f"Category from model: {answer}")
    answer = answer.split("\n")[-1].strip().capitalize()
    valid_categories = ["Grocery", "Clothing", "Electronics", "Other"]
    return answer if answer in valid_categories else "Other"
La funzione categorize_goods() classifica il tipo di merce in un’immagine chiedendo al modello tramite una domanda predefinita con le possibili categorie: alimentari, abbigliamento, elettronica o altro. La funzione ask_model() elabora l’immagine e restituisce una risposta testuale. Se la risposta elaborata corrisponde a una delle categorie valide predefinite, restituisce quella categoria, altrimenti imposta "Other" come predefinita.
Abbiamo tutte le funzioni chiave pronte, quindi analizziamo gli output.
def generate_spending_chart(categories: dict):
    filtered_categories = {k: v for k, v in categories.items() if v > 0}  # Remove zero-value categories
    labels = list(filtered_categories.keys())
    values = list(filtered_categories.values())
    if not values or sum(values) == 0:
        fig, ax = plt.subplots()
        ax.text(0.5, 0.5, "No Spending Data", ha="center", va="center", fontsize=12)
        ax.axis("off")
        return fig
    fig, ax = plt.subplots()
    ax.pie(values, labels=labels, autopct='%1.1f%%', startangle=90)
    ax.axis('equal')
    plt.title("Spending Distribution")
    return fig
La funzione qui sopra crea un grafico a torta per visualizzare la distribuzione delle spese tra le diverse categorie. Se non ci sono dati di spesa validi, genera un grafico vuoto con il messaggio "No Spending Data". Altrimenti, crea un grafico a torta con etichette di categoria e valori percentuali, garantendo una visualizzazione proporzionata e ben allineata.
Di solito abbiamo più scontrini da analizzare, quindi creiamo una funzione per elaborare tutti i nostri scontrini contemporaneamente.
def process_multiple_bills(files: list):
    results = []
    images = []
    total_spending = 0
    category_totals = {"Grocery": 0, "Clothing": 0, "Electronics": 0, "Other": 0}
    for file in files:
        image = Image.open(file)
        image = ensure_rgb(image)
        images.append(image)
        total_amount = extract_total_amount(image)
        category = categorize_goods(image)
        total_spending += total_amount
        category_totals[category] += total_amount
        results.append({"Bill": len(results) + 1, "Category": category, "Total Amount": f"₹{total_amount:.2f}"})
    pie_chart = generate_spending_chart(category_totals)
    summary_text = f"**Total Spending Across All Bills:** ₹{total_spending:.2f}"
    return images, pd.DataFrame(results), summary_text, pie_chart
Per analizzare più scontrini in una volta, eseguiamo i seguenti passaggi:
DataFrame con i riepiloghi degli scontrini, il riepilogo della spesa totale e il grafico delle spese.Ora che abbiamo tutte le funzioni logiche chiave, passiamo a costruire una UI interattiva con Gradio.
def gradio_demo():
    with gr.Blocks() as demo:
        gr.Markdown("## PaliGemma 2 Mix Powered- Multiple Bill Scanner\nUpload multiple bill images, and this demo will extract text, categorize spending, and generate insights.")
        with gr.Row():
            with gr.Column():
                image_input = gr.File(file_count="multiple", file_types=["image"], label="Upload Bill Images")
                submit_button = gr.Button("Process Bills")
            with gr.Column():
                image_output = gr.Gallery(label="Uploaded Bills")
                table_output = gr.Dataframe(label="Bill Summary")
                summary_output = gr.Text(label="Total Spending Summary")
                chart_output = gr.Plot(label="Aggregated Spending Distribution")
        submit_button.click(
            fn=process_multiple_bills,
            inputs=image_input,
            outputs=[image_output, table_output, summary_output, chart_output]
        )
    demo.launch(debug=True)

if __name__ == "__main__":
    gradio_demo()
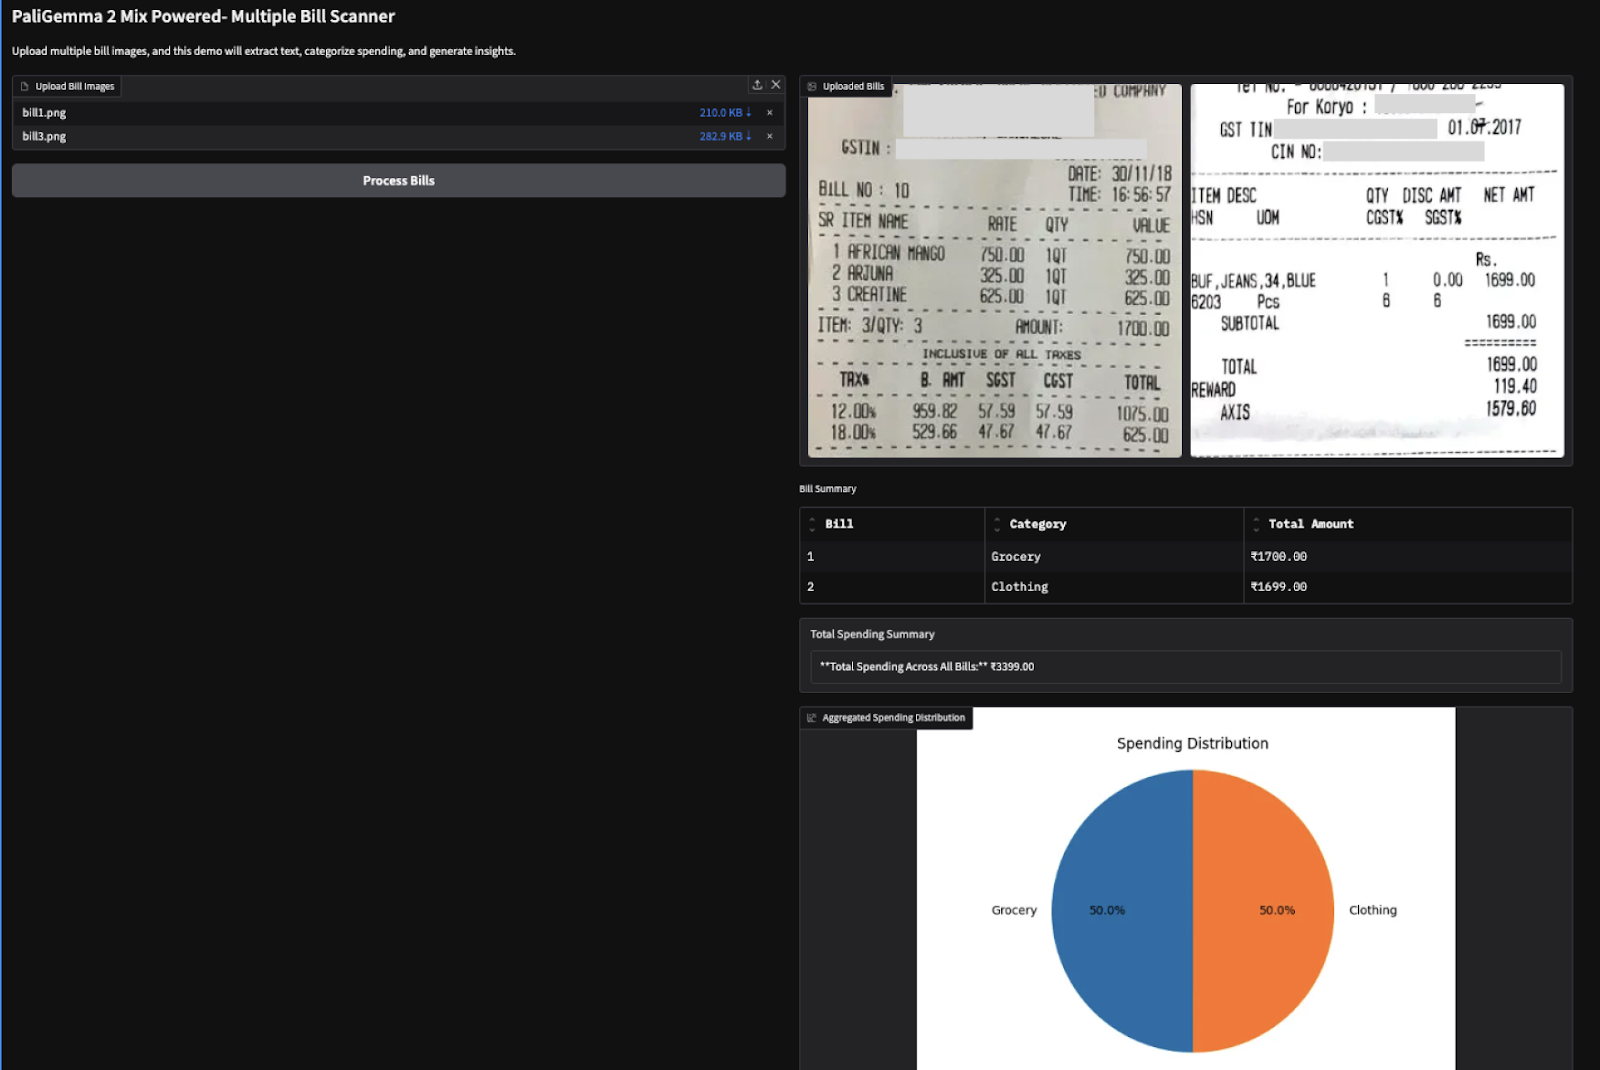
Il codice sopra crea una UI strutturata in Gradio con un uploader di file per più immagini e un pulsante di invio per avviare l’elaborazione. Al momento dell’invio, le immagini caricate vengono mostrate in una galleria, i dati estratti in una tabella, la spesa totale in un testo riepilogativo e viene generato un grafico a torta della distribuzione delle spese.
La funzione collega gli input dell’utente alla funzione process_multiple_bills(), garantendo un’estrazione e visualizzazione dei dati senza interruzioni. Infine, la funzione demo.launch() avvia l’app Gradio per l’interazione in tempo reale.
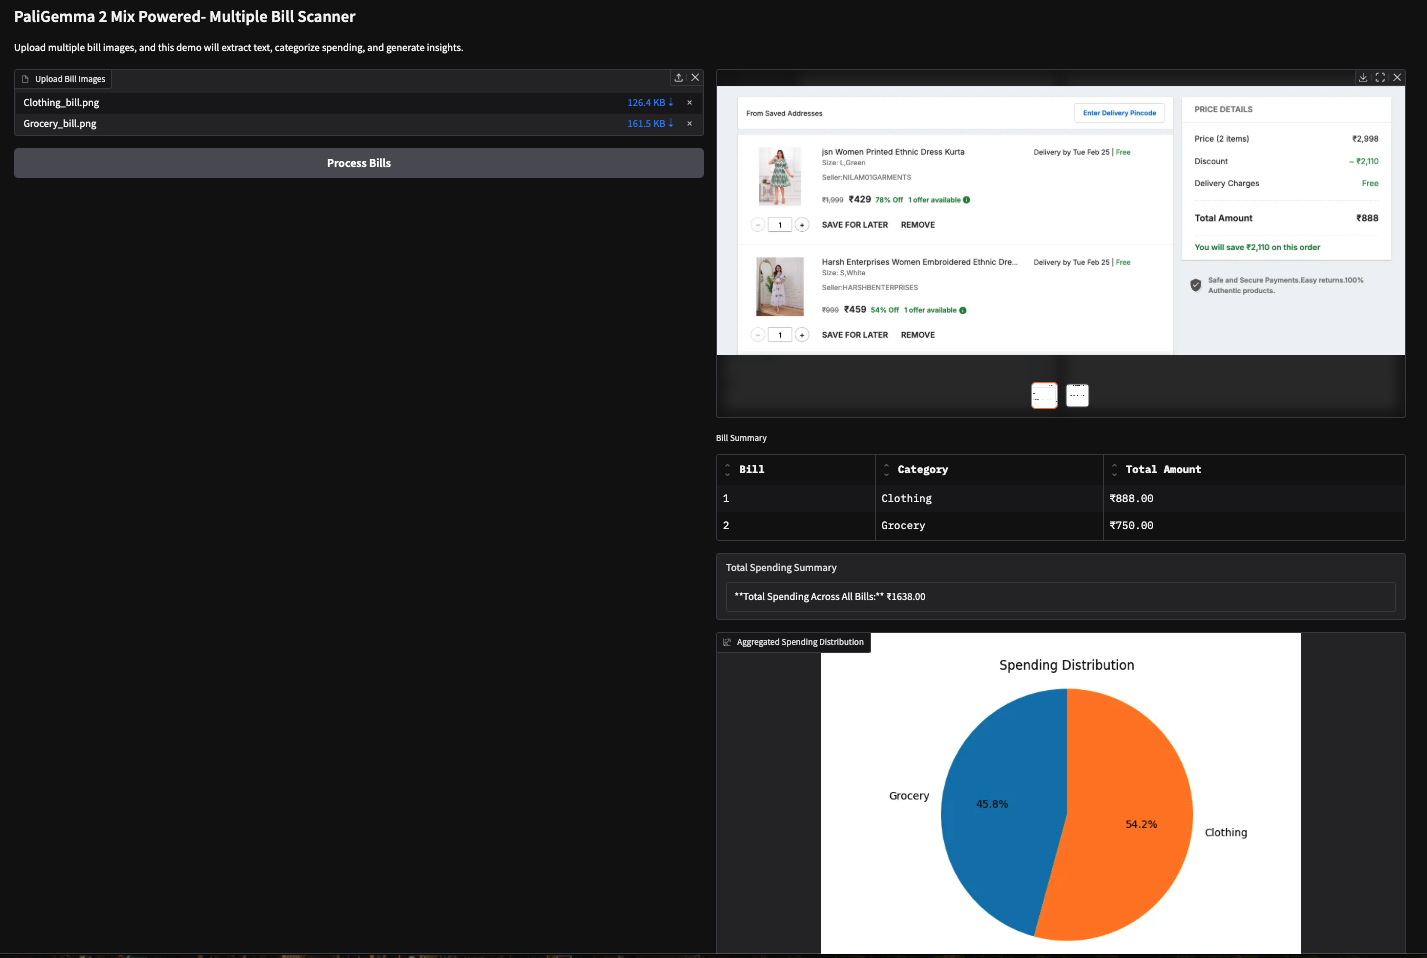
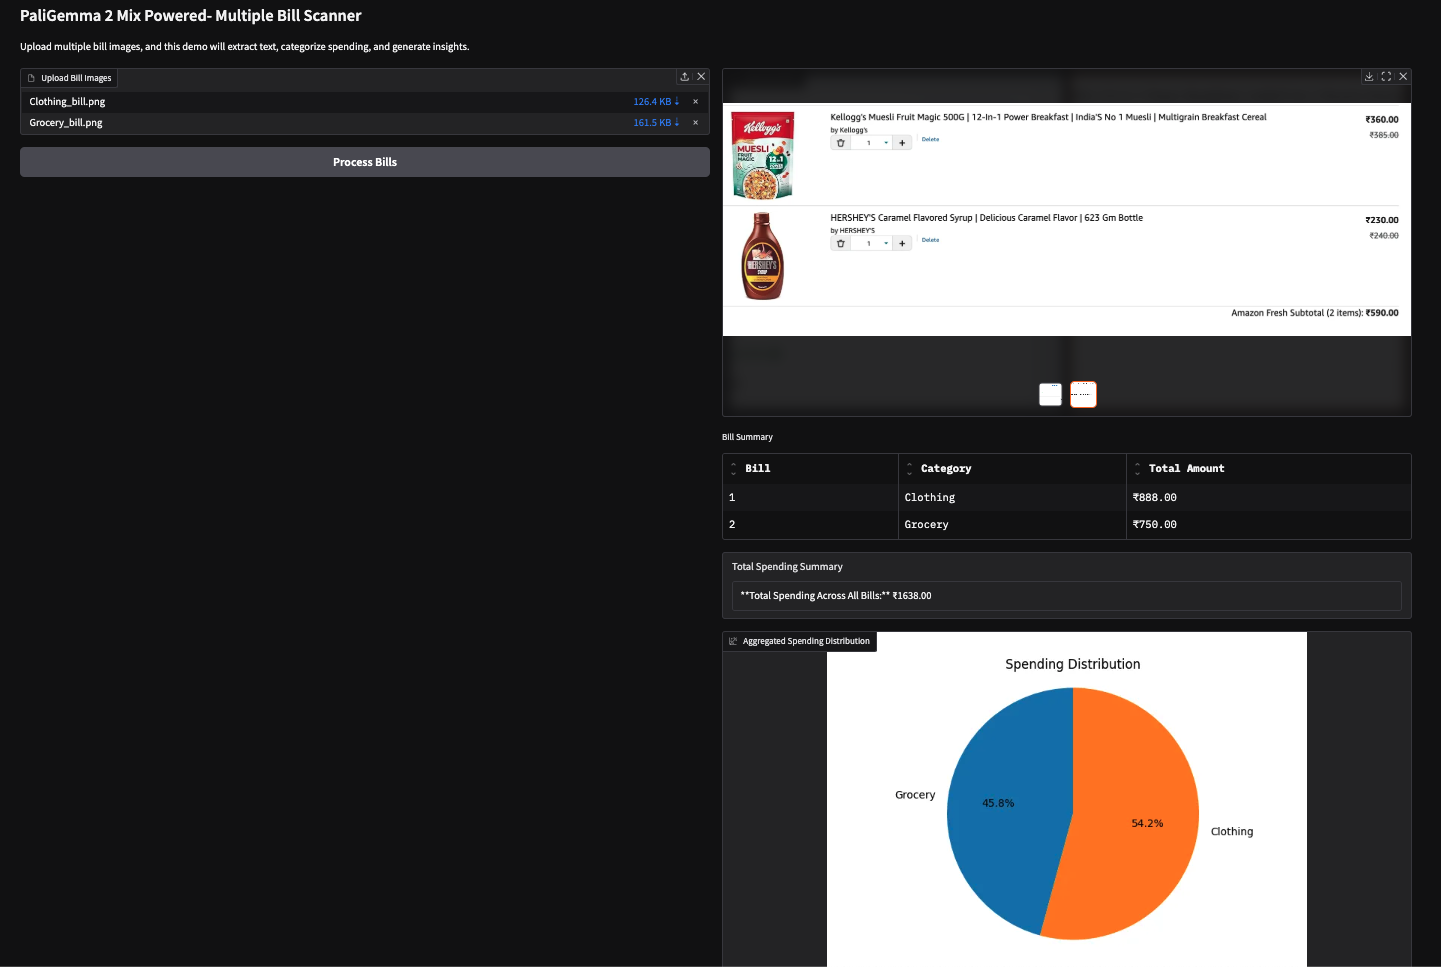
Ho provato anche questa demo con due scontrini basati su immagine (fattura di acquisto Amazon) e ho ottenuto i seguenti risultati.
Nota: i VLM fanno fatica a estrarre i numeri, il che può portare a risultati errati talvolta. Ad esempio, ha estratto l’importo totale sbagliato per il secondo scontrino qui sotto. Questo è correggibile usando modelli più grandi o semplicemente facendo fine-tuning di quelli esistenti.
In questo tutorial abbiamo creato uno scanner per più scontrini basato su IA utilizzando PaliGemma 2 Mix, che può aiutarci a estrarre e categorizzare le spese dalle ricevute. Abbiamo sfruttato le capacità visione-linguaggio di PaliGemma 2 Mix per OCR e classificazione, così da analizzare facilmente gli insight di spesa. Ti incoraggio ad adattare questo tutorial al tuo caso d’uso.
Impara l’IA con questi corsi!
Programma
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



