
Last chance! 50% off DataCamp Premium
Sale ends in
PaliGemma 2 Mix, Google tarafından geliştirilen çok modlu bir yapay zekâ modelidir. SigLIP görsel modeli ve Gemma 2 dil modellerinin gelişmiş yeteneklerini entegre eden PaliGemma görsel-dil modeli (VLM)nin iyileştirilmiş bir sürümüdür.
Bu eğitimde, PaliGemma 2 Mix kullanarak aşağıdakileri yapabilen yapay zekâ destekli bir fatura tarayıcı ve harcama analizörü oluşturmayı anlatacağım:
Odak noktamız finansal içgörü aracı oluşturmak olsa da, bu yazıda öğrendiklerinizi PaliGemma 2 Mix’in görüntü segmentasyonu, nesne tespiti ve soru-cevap gibi diğer kullanım alanlarında da uygulayabilirsiniz.
PaliGemma 2 Mix, girdi olarak hem görselleri hem de metni işleyip metin tabanlı çıktılar üreten gelişmiş bir görsel-dil modelidir (VLM). Çeşitli çok modlu yapay zekâ görevlerini ele alırken birden fazla dili destekleyecek şekilde tasarlanmıştır.
PaliGemma 2; görüntü ve kısa video altyazılama, görsel soru-cevap, optik karakter tanıma (OCR), nesne tespiti ve segmentasyon dahil geniş bir yelpazedeki görsel-dil görevleri için tasarlanmıştır.
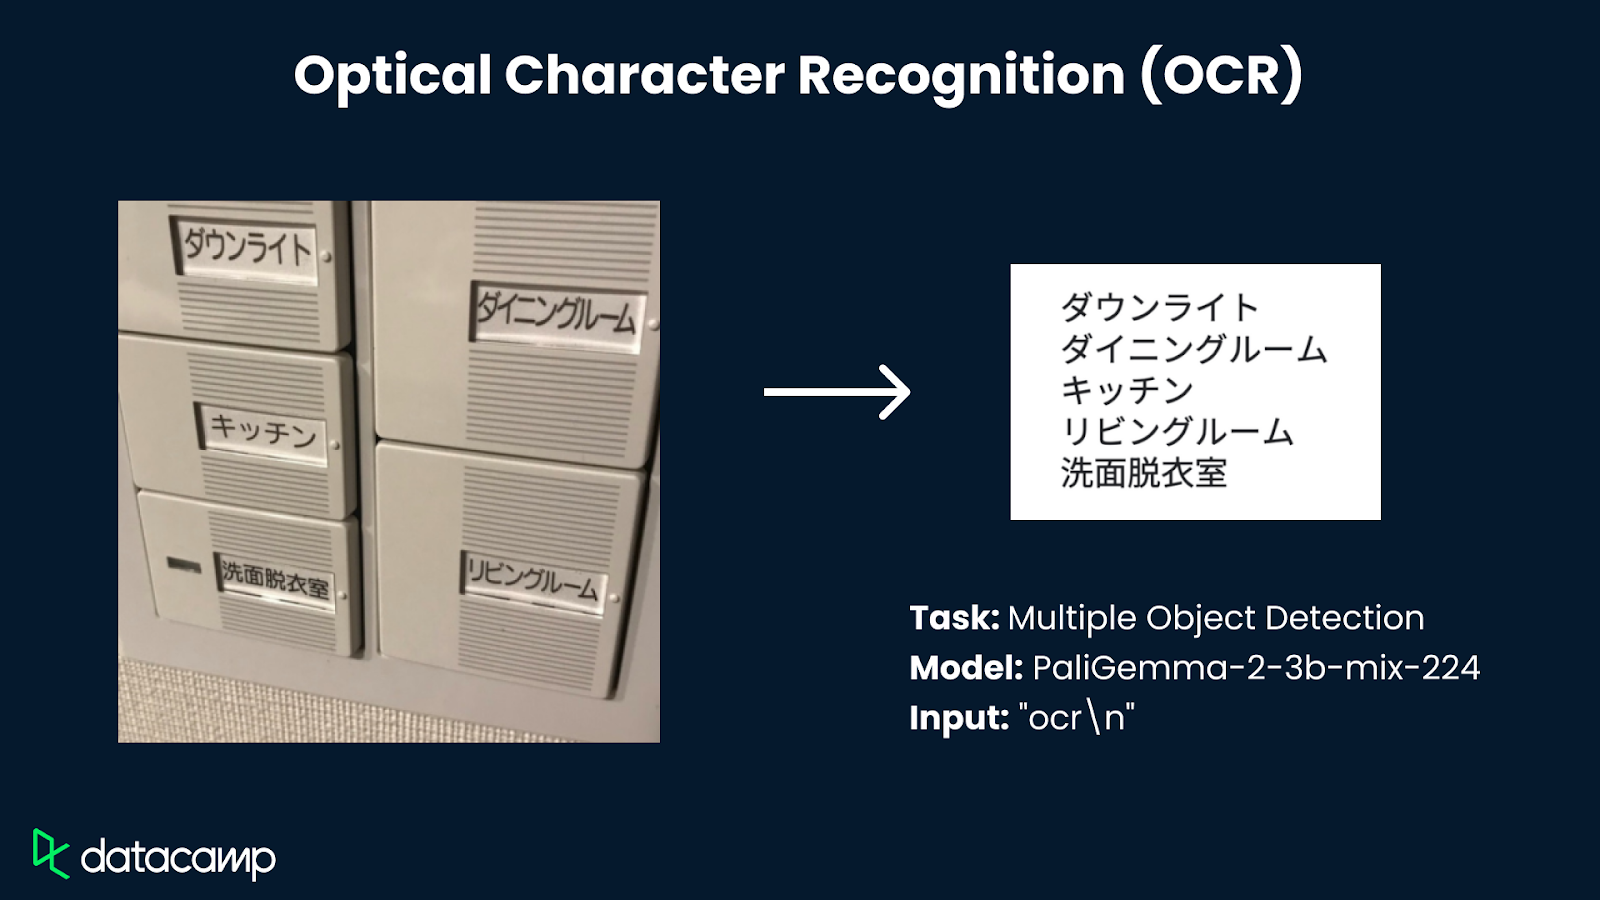
Diyagramda kullanılan görsellerin kaynağı: Google
PaliGemma 2 Mix modeli şu amaçlar için tasarlanmıştır:
PaliGemma 2 Mix modeli hakkında daha fazla bilgiyi resmi duyuru yazısında bulabilirsiniz.
İzleyeceğimiz ana adımları özetleyelim:
Başlamadan önce aşağıdaki araç ve kütüphanelerin kurulu olduğundan emin olalım:
Gerekli bağımlılıkları yüklemek için aşağıdaki komutları çalıştırın:
pip install gradio -U bitsandbytes -U transformers -qYukarıdaki bağımlılıklar kurulduktan sonra şu içe aktarma komutlarını çalıştırın:
import gradio as gr
import torch
import pandas as pd
import matplotlib.pyplot as plt
from transformers import PaliGemmaForConditionalGeneration, PaliGemmaProcessor, BitsAndBytesConfig
from transformers import BitsAndBytesConfig
from PIL import Image
import rePaliGemma 2 Mix modelini performansı optimize etmek için kuantizasyon ile yapılandırıp yüklüyoruz. Bu demo için, 10b parametreli modeli ve 448 x 448 girdi görsel çözünürlüğünü kullanacağız. Bu modeli çalıştırmak için en az 40 GB belleğe sahip T4 GPU’ya (Colab yapılandırması) ihtiyacınız var.
device = "cuda" if torch.cuda.is_available() else "cpu"
# Model setup
model_id = "google/paligemma2-10b-mix-448"
bnb_config = BitsAndBytesConfig(
    load_in_8bit=True,  # Change to load_in_4bit=True for even lower memory usage
    llm_int8_threshold=6.0,
)

# Load model with quantization
model = PaliGemmaForConditionalGeneration.from_pretrained(
    model_id, quantization_config=bnb_config
).eval()

# Load processor
processor = PaliGemmaProcessor.from_pretrained(model_id)
# Print success message
print("Model and processor loaded successfully!")
BitsAndBytes kuantizasyonu, performansı korurken bellek kullanımını azaltmaya yardımcı olur; bu da büyük modelleri sınırlı GPU kaynaklarında çalıştırmayı mümkün kılar. Bu uygulamada, bellek verimliliğini daha da artırmak için 4 bit kuantizasyon kullanıyoruz.
Modeli, transformers kütüphanesindeki PaliGemmaForConditionalGeneration sınıfını kullanarak; model kimliğini ve kuantizasyon yapılandırmasını geçirerek yüklüyoruz. Benzer şekilde, girdileri modele iletmeden önce tensörlere dönüştüren işlemciyi de yüklüyoruz.
Model parçaları yüklendikten sonra, görsel format uyumluluğunu korumak ve birlik sağlamak için görselleri modele iletmeden önce işliyoruz. Görselleri RGB formata dönüştürüyoruz:
def ensure_rgb(image: Image.Image) -> Image.Image:
    if image.mode != "RGB":
        image = image.convert("RGB")
    return image
Artık görsellerimiz çıkarım için hazır.
Şimdi, modelle çıkarım yapmak için ana fonksiyonu kuruyoruz. Bu fonksiyon, girdi görsellerini ve soruları alır, bunları istemlere dahil eder ve çıkarım için işlemci üzerinden modele iletir.
def ask_model(image: Image.Image, question: str) -> str:
    prompt = f"<image> answer en {question}"
    inputs = processor(text=prompt, images=image, return_tensors="pt").to(device)
    with torch.inference_mode():
        generated_ids = model.generate(
            **inputs,
            max_new_tokens=50,
            do_sample=False
        )
    result = processor.batch_decode(generated_ids, skip_special_tokens=True)
return result[0].strip()Artık ana fonksiyon hazır olduğuna göre, görselden temel parametreleri çıkarmaya geçiyoruz—bizim durumumuzda bunlar toplam tutar ve ürün kategorisi.
 def extract_total_amount(image: Image.Image) -> float:
    question = "ocr\n what is the total amount? in numbers only"
    answer = ask_model(image, question)
    print(f"Answer from model: {answer}")
    try:
        amounts = re.findall(r'\d+\.\d+|\d+', answer)  # Capture both integer and decimal values
        if amounts:
            return float(amounts[-1])  # Get the last valid amount as the total
    except ValueError:
        pass
    return 0.0
extract_total_amount() fonksiyonu, bir fişten toplam tutarı OCR ile çıkarmak için bir görseli işler. Yalnızca sayısal değerlerin çıkarılmasını isteyen bir sorgu (soru) oluşturur ve ardından modelden yanıt üretmek için ask_model() fonksiyonunu çağırır.
def categorize_goods(image: Image.Image) -> str:
    question = "what is the category of goods in the image - Grocery/ Clothing/ Electronics/ Other?"
    answer = ask_model(image, question)
    print(f"Category from model: {answer}")
    answer = answer.split("\n")[-1].strip().capitalize()
    valid_categories = ["Grocery", "Clothing", "Electronics", "Other"]
    return answer if answer in valid_categories else "Other"
categorize_goods() fonksiyonu, modeli market, giyim, elektronik veya diğer kategorilerini listeleyen ön tanımlı bir soruyla yönlendirerek görseldeki ürün türünü sınıflandırır. ask_model() fonksiyonu görseli işleyip metin yanıtı döndürür. İşlenen yanıt önceden tanımlı geçerli kategorilerden biriyle eşleşirse o kategori döndürülür; aksi halde varsayılan olarak "Other" seçilir.
Tüm temel fonksiyonlar hazır, şimdi çıktıları analiz edelim.
def generate_spending_chart(categories: dict):
    filtered_categories = {k: v for k, v in categories.items() if v > 0}  # Remove zero-value categories
    labels = list(filtered_categories.keys())
    values = list(filtered_categories.values())
    if not values or sum(values) == 0:
        fig, ax = plt.subplots()
        ax.text(0.5, 0.5, "No Spending Data", ha="center", va="center", fontsize=12)
        ax.axis("off")
        return fig
    fig, ax = plt.subplots()
    ax.pie(values, labels=labels, autopct='%1.1f%%', startangle=90)
    ax.axis('equal')
    plt.title("Spending Distribution")
    return fig
Yukarıdaki fonksiyon, farklı kategorilerdeki harcama dağılımını görselleştirmek için bir pasta grafiği oluşturur. Geçerli harcama verisi yoksa, ortada "No Spending Data" mesajı bulunan boş bir figür üretir. Aksi takdirde, kategori etiketleri ve yüzde değerleriyle orantılı ve hizalı bir pasta grafiği oluşturur.
Genellikle analiz edilecek birden fazla faturamız olur; bu nedenle tüm faturalarımızı aynı anda işlemek için bir fonksiyon oluşturalım.
def process_multiple_bills(files: list):
    results = []
    images = []
    total_spending = 0
    category_totals = {"Grocery": 0, "Clothing": 0, "Electronics": 0, "Other": 0}
    for file in files:
        image = Image.open(file)
        image = ensure_rgb(image)
        images.append(image)
        total_amount = extract_total_amount(image)
        category = categorize_goods(image)
        total_spending += total_amount
        category_totals[category] += total_amount
        results.append({"Bill": len(results) + 1, "Category": category, "Total Amount": f"₹{total_amount:.2f}"})
    pie_chart = generate_spending_chart(category_totals)
    summary_text = f"**Total Spending Across All Bills:** ₹{total_spending:.2f}"
    return images, pd.DataFrame(results), summary_text, pie_chart
Birden fazla faturayı aynı anda analiz etmek için şu adımları uygularız:
DataFrame’ini, toplam harcama özetini ve harcama grafiğini döndürürüz.Artık tüm kilit mantık fonksiyonları hazır. Sırada Gradio ile etkileşimli bir arayüz oluşturmak var.
def gradio_demo():
    with gr.Blocks() as demo:
        gr.Markdown("## PaliGemma 2 Mix Powered- Multiple Bill Scanner\nUpload multiple bill images, and this demo will extract text, categorize spending, and generate insights.")
        with gr.Row():
            with gr.Column():
                image_input = gr.File(file_count="multiple", file_types=["image"], label="Upload Bill Images")
                submit_button = gr.Button("Process Bills")
            with gr.Column():
                image_output = gr.Gallery(label="Uploaded Bills")
                table_output = gr.Dataframe(label="Bill Summary")
                summary_output = gr.Text(label="Total Spending Summary")
                chart_output = gr.Plot(label="Aggregated Spending Distribution")
        submit_button.click(
            fn=process_multiple_bills,
            inputs=image_input,
            outputs=[image_output, table_output, summary_output, chart_output]
        )
    demo.launch(debug=True)

if __name__ == "__main__":
    gradio_demo()
Yukarıdaki kod, birden fazla görsel için dosya yükleyici ve işlemi tetikleyen bir gönder düğmesi içeren yapılandırılmış bir Gradio arayüzü oluşturur. Gönderimin ardından yüklenen faturalar galeri olarak gösterilir, çıkarılan veriler tabloda listelenir, toplam harcama metin olarak özetlenir ve bir harcama dağılımı pasta grafiği üretilir.
Fonksiyon, kullanıcı girdilerini process_multiple_bills() fonksiyonuna bağlayarak sorunsuz veri çıkarımı ve görselleştirme sağlar. Son olarak demo.launch() fonksiyonu, gerçek zamanlı etkileşim için Gradio uygulamasını başlatır.
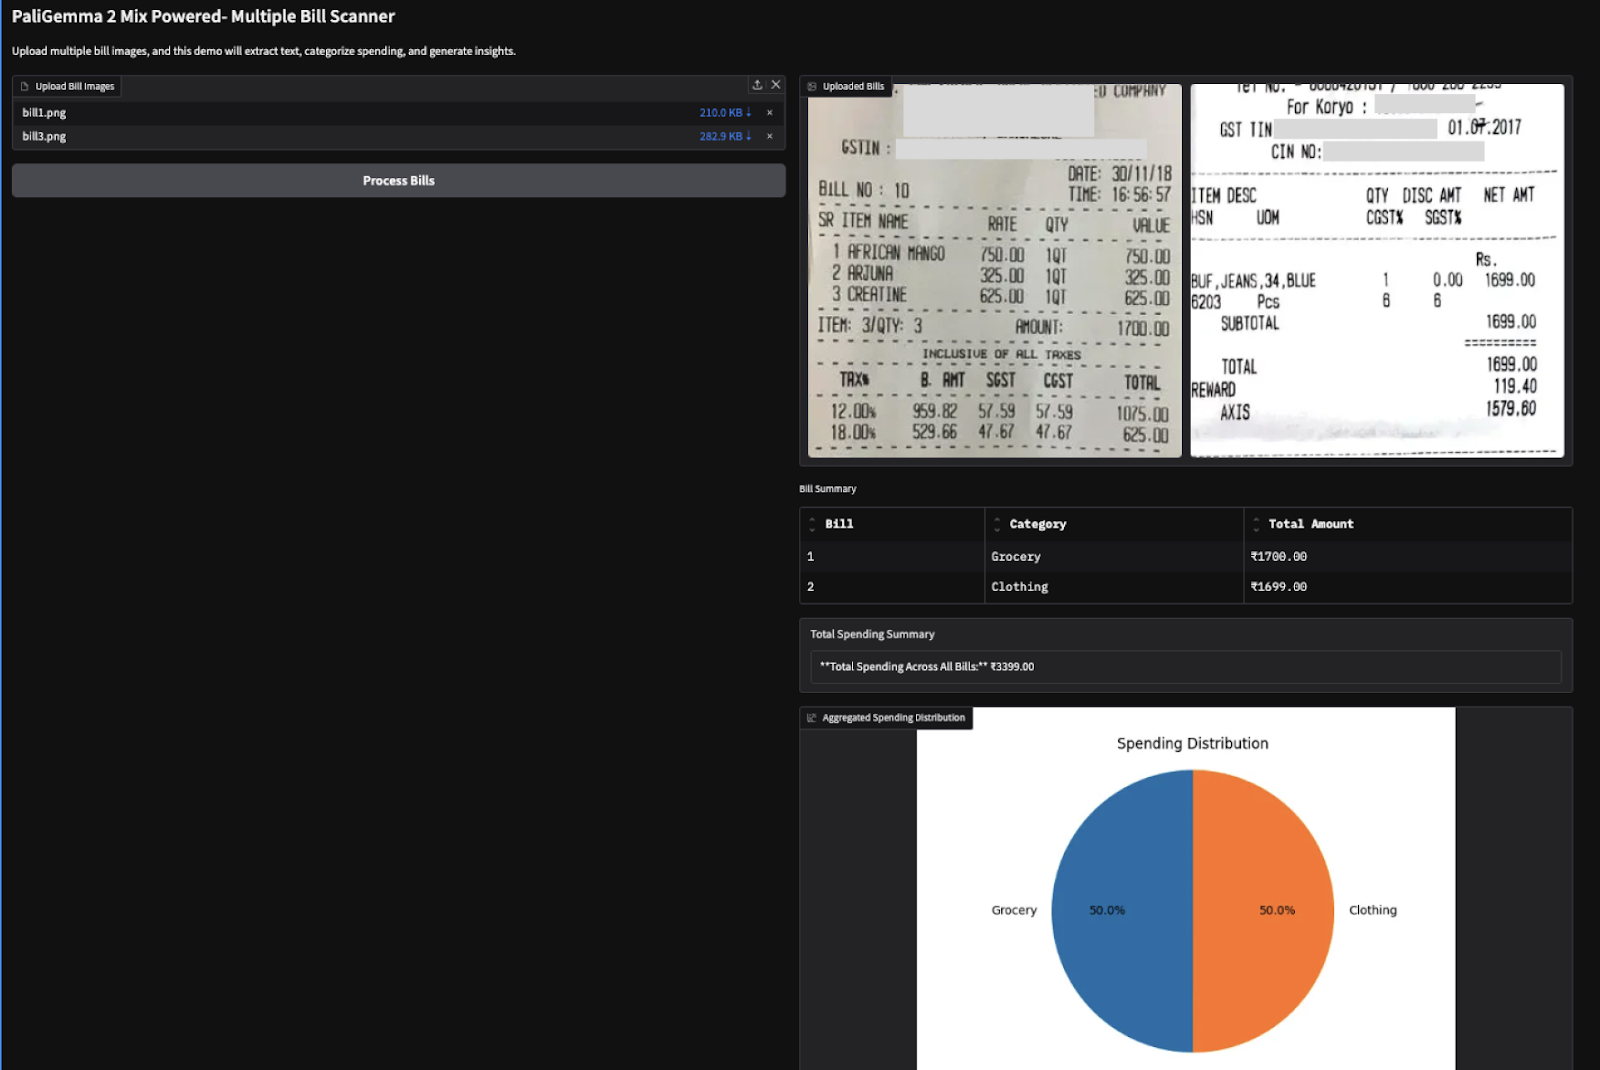
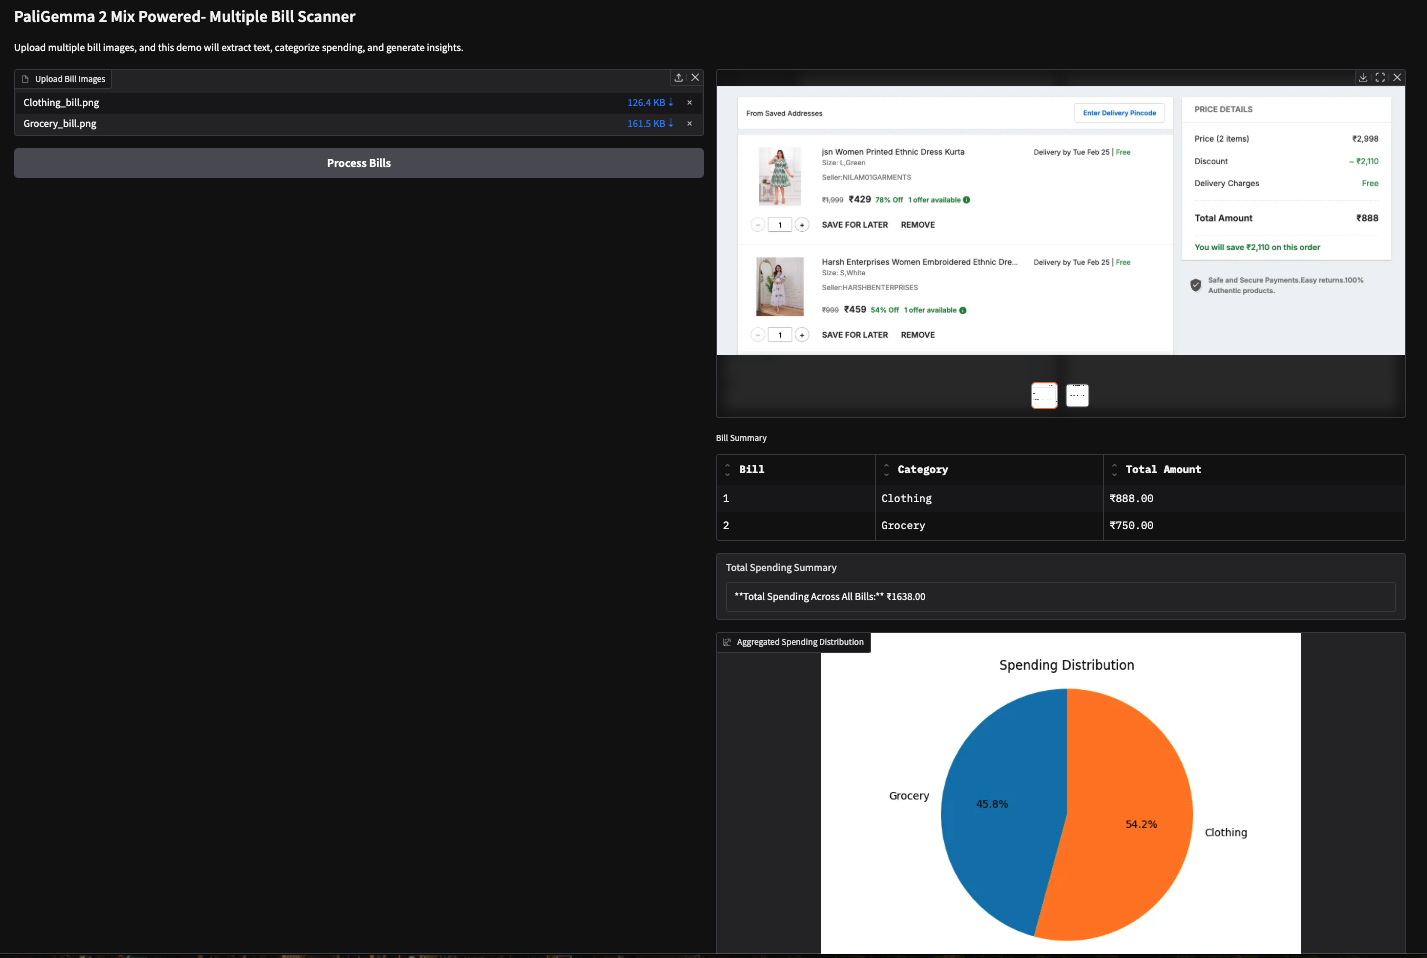
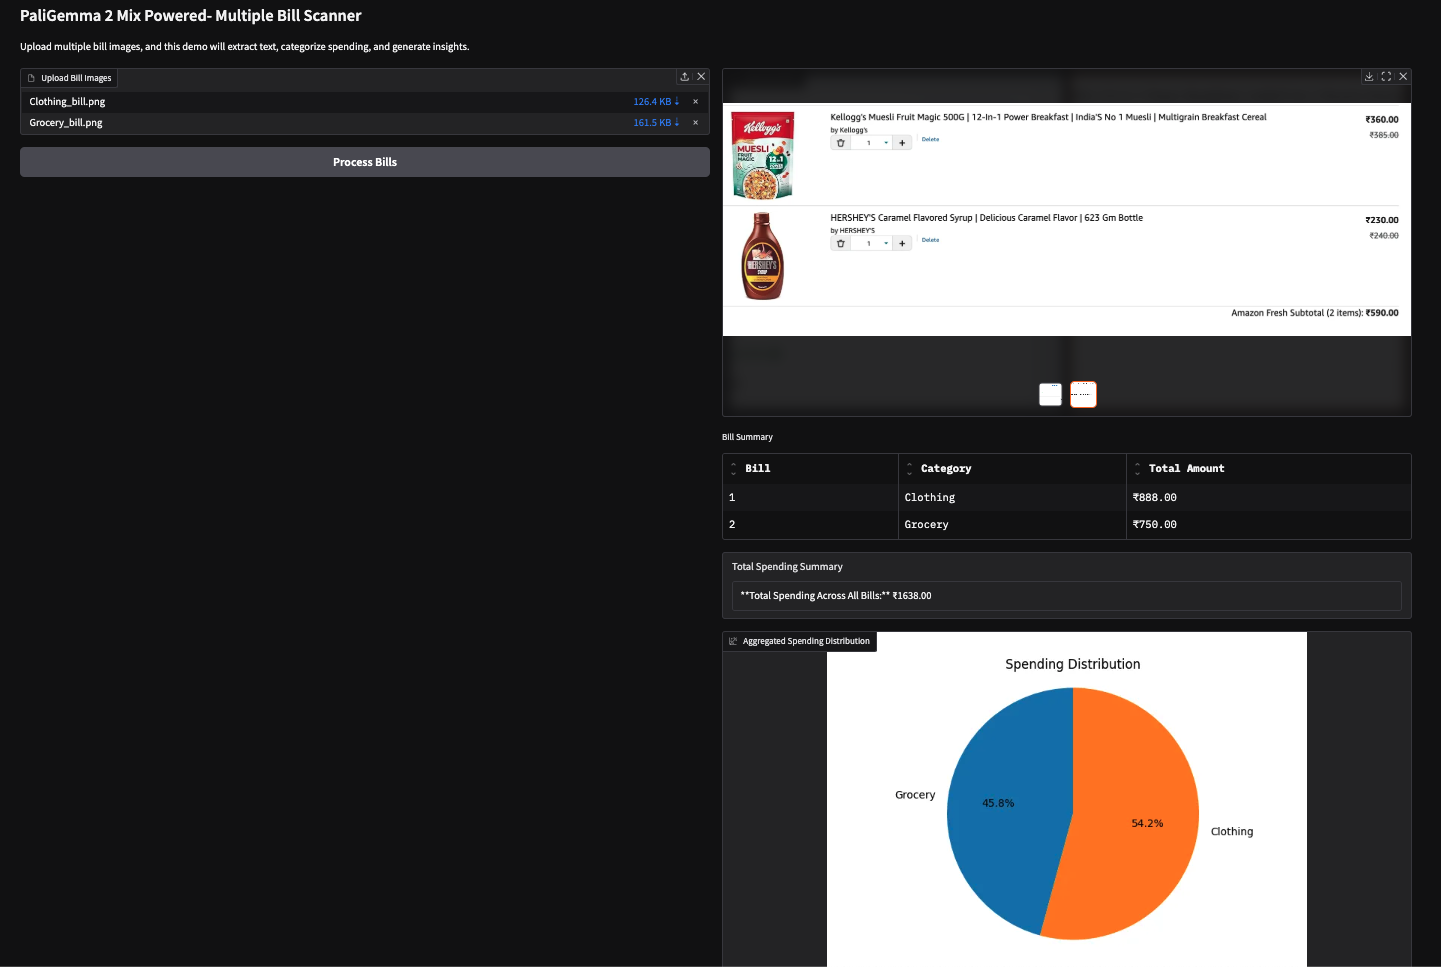
Bu demoyu iki görsel tabanlı faturayla (Amazon alışveriş faturası) da denedim ve aşağıdaki sonuçları aldım.
Not: VLM’ler sayı çıkarmakta zorlanabilir ve bu durum zaman zaman hatalı sonuçlara yol açabilir. Örneğin, aşağıdaki ikinci fatura için yanlış toplam tutarı çıkardı. Bu, daha büyük modeller kullanılarak ya da mevcut olanların ince ayarı ile düzeltilebilir.
Bu eğitimde, PaliGemma 2 Mix kullanarak birden fazla faturayı işleyebilen yapay zekâ destekli bir tarayıcı geliştirdik; bu sayede fişlerden harcamaları çıkarıp kategorize edebildik. PaliGemma 2 Mix’in görsel-dil yeteneklerini OCR ve sınıflandırma için kullanarak harcama içgörülerini zahmetsizce analiz ettik. Bu eğitimi kendi kullanım senaryonuza uyarlamanızı öneririm.
Bu kurslarla yapay zekâyı öğrenin!
{count, plural, one {Program} other {Program}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.





