Cursus
Introductie tot Python
4 uur
7.1M
In twee eerdere posts onderzocht ik de rol van het preprocessen van data in de machinelearning-pijplijn. Ik bekeek met name de algoritmes k-Nearest Neighbors (k-NN) en logistische regressie en zag hoe het schalen van numerieke data de prestaties van het eerste sterk beïnvloedde, maar niet die van het tweede, gemeten bijvoorbeeld aan de hand van accuracy (zie de woordenlijst hieronder of eerdere artikelen voor definities van schalen, k-NN en andere relevante termen). De echte kernboodschap hier was dat preprocessing niet in een vacuüm plaatsvindt; je kunt je data tot in den treure preprocesen, maar het bewijs zit in het resultaat: hoe goed presteert je model vervolgens?
Het schalen van numerieke data (oftewel: alle instanties van een variabele met een constante vermenigvuldigen om het bereik van die variabele te veranderen) heeft twee verwante doelen: i) als jouw metingen in meters zijn en die van mij in mijlen, dan worden ze, als we allebei schalen, hetzelfde & ii) als twee variabelen zeer verschillende bereiken hebben, kan die met het grotere bereik je voorspellend model domineren, ook al is die misschien minder belangrijk voor je doelvariabele dan de variabele met het kleinere bereik. We zagen dat dit probleem uit ii) optreedt bij k-NN, dat expliciet kijkt naar hoe dicht data bij elkaar liggen, maar niet bij logistische regressie, dat tijdens training de relevante coëfficiënt zal verkleinen om het gebrek aan schaling te compenseren.
Omdat de data die we in de vorige artikelen gebruikten echte data waren, konden we alleen zien hoe de modellen presteerden vóór en na het schalen. Hier zal ik, om te zien hoe ruis in de vorm van stoorvariabelen (variabelen die de doelvariabele niet beïnvloeden, maar wel je model kunnen beïnvloeden) de modelprestaties verandert, zowel vóór als na schalen, een dataset synthetiseren waarin ik de precieze aard van de stoorvariabele kan controleren. We zullen zien dat hoe ‘ruisachtiger’ de gesynthetiseerde data, hoe belangrijker schalen wordt voor k-NN. Alle voorbeelden zijn in Python. Als je niet bekend bent met Python, bekijk dan onze DataCamp-cursussen hier. Ik maak gebruik van de bibliotheken pandas voor onze DataFrame-behoeften en scikit-learn voor onze machinelearning-behoeften.
In de code hieronder gebruiken we scikit-learns make_blobs-functie om 2000 datapunten te genereren die in 4 clusters liggen (elk datapunt heeft 2 voorspellers en 1 doelvariabele).
# Generate some clustered data (blobs!)
import numpy as np
from sklearn.datasets.samples_generator import make_blobs
n_samples=2000
X, y = make_blobs(n_samples, centers=4, n_features=2,
random_state=0)We gaan nu in het vlak de data plotten die we hebben gesynthetiseerd. Elke as is een voorspellende variabele en de kleur is een sleutel tot de doelvariabele:
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(X[:,0] , X[:,1],  c = y, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.hist(y)
plt.show()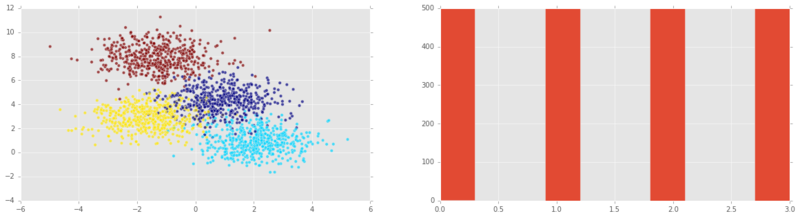
Opmerking: in de tweede plot zien we dat alle mogelijke doelvariabelen evenredig vertegenwoordigd zijn. In dit geval (of zelfs als ze ongeveer evenredig vertegenwoordigd zijn) zeggen we dat de klasse y in balans is.
Ik wil nu histogrammen van de features (voorspellende variabelen) plotten:
import pandas as pd
df = pd.DataFrame(X)
pd.DataFrame.hist(df, figsize=(20,5));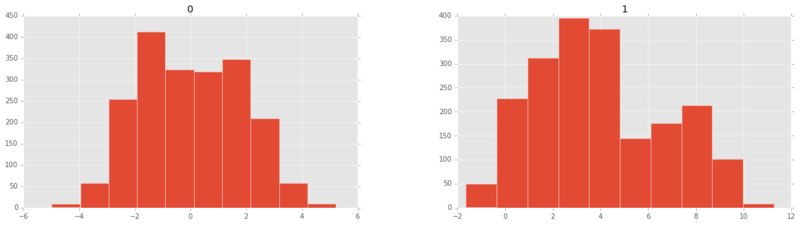
Laten we nu splitsen in test- & trainingsets en beide sets plotten:
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.title('training set')
plt.scatter(X_train[:,0] , X_train[:,1],  c = y_train, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.scatter(X_test[:,0] , X_test[:,1],  c = y_test, alpha = 0.7);
plt.title('test set')
plt.show()
Ziet er goed uit! Laten we nu een k-Nearest Neighbors-stemclassifier instantieren en trainen op onze trainingsset:
from sklearn import neighbors, linear_model
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(X_train, y_train)
Nu we ons model hebben getraind, kunnen we het op onze testset toepassen en de accuracy berekenen:
print('k-NN score for test set: %f' % knn_model.score(X_test, y_test))`k-NN score for test set: 0.935000`We kunnen het ook opnieuw op onze trainingsset fitten en de accuracy berekenen. We verwachten dat het beter presteert op de trainingsset dan op de testset:
print('k-NN score for training set: %f' % knn_model.score(X_train, y_train))`k-NN score for training set: 0.941875`Het is het vermelden waard dat de standaard scoringsmethode voor k-NN in scikit-learn accuracy is. Om een reeks andere metriek te bekijken, kunnen we ook het classification report van scikit-learn gebruiken:
from sklearn.metrics import classification_report
y_true, y_pred = y_test, knn_model.predict(X_test)
print(classification_report(y_true, y_pred))
precision recall f1-score support
0 0.87 0.90 0.88 106
1 0.98 0.93 0.95 102
2 0.90 0.92 0.91 100
3 1.00 1.00 1.00 92
avg / total 0.94 0.94 0.94 400Ik ga nu de voorspellers schalen en vervolgens opnieuw k-NN gebruiken:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(Xs_train[:,0] , Xs_train[:,1],  c = y_train, alpha = 0.7);
plt.title('scaled training set')
plt.subplot(1, 2, 2);
plt.scatter(Xs_test[:,0] , Xs_test[:,1],  c = y_test, alpha = 0.7);
plt.title('scaled test set')
plt.show()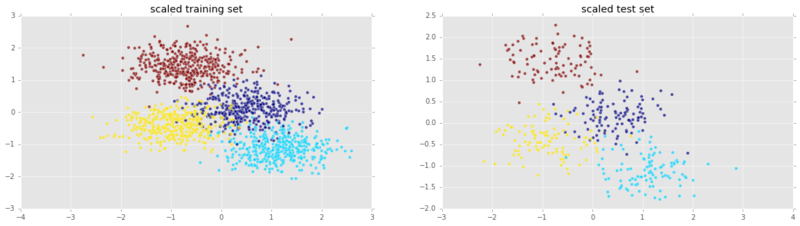
knn_model_s = knn.fit(Xs_train, y_train)
print('k-NN score for test set: %f' % knn_model_s.score(Xs_test, y_test))
`k-NN score for test set: 0.935000`Het presteert niet beter met schalen! Dit komt waarschijnlijk doordat beide features al ongeveer in hetzelfde bereik zaten. Schalen is vooral logisch wanneer variabelen sterk verschillende bereiken hebben. Om dit in actie te zien, voegen we een extra feature toe. Bovendien heeft deze feature geen enkele relevantie voor de doelvariabele: het is pure ruis.
We voegen een derde variabele toe met Gaussische ruis met gemiddelde 0 en variabele standaarddeviatie \(\sigma\). We noemen \(\sigma\) de sterkte van de ruis en we zullen zien dat hoe sterker de ruis, hoe slechter de prestaties van k-Nearest Neighbours.
# Add noise column to predictor variables
ns = 10**(3) # Strength of noise term
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
We gebruiken nu het mplot3d-pakket om de 3D-data te plotten:
from mpl_toolkits.mplot3d import Axes3D
fig = plt.figure(figsize=(15,10));
ax = fig.add_subplot(111, projection='3d' , alpha = 0.5);
ax.scatter(Xn[:,0], Xn[:,1], Xn[:,2], c = y);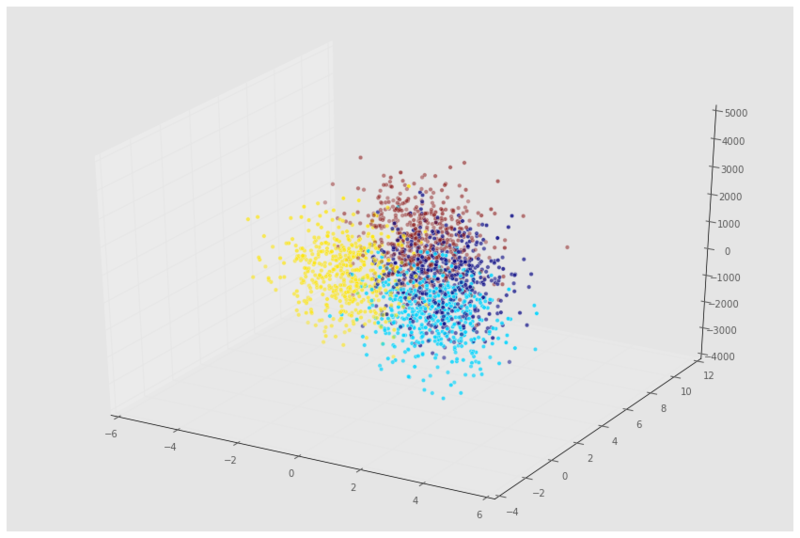
Laten we nu kijken hoe ons model presteert op de nieuwe data:
Xn_train, Xn_test, y_train, y_test = train_test_split(Xn, y, test_size=0.2, random_state=42)
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(Xn_train, y_train)
print('k-NN score for test set: %f' % knn_model.score(Xn_test, y_test))
k-NN score for test set: 0.400000
Dit is een verschrikkelijk model! Hoe zit het als we schalen en de prestaties opnieuw bekijken?
Xns = scale(Xn)
s = int(.2*n_samples)
Xns_train = Xns[s:]
y_train = y[s:]
Xns_test = Xns[:s]
y_test = y[:s]
knn = neighbors.KNeighborsClassifier()
knn_models = knn.fit(Xns_train, y_train)
print('k-NN score for test set: %f' % knn_models.score(Xns_test, y_test))
`k-NN score for test set: 0.907500`Mooi, na het schalen van de data presteert het model bijna net zo goed als zonder de geïntroduceerde ruis. Laten we nu de modelprestatie bekijken als functie van de ruissterkte.
We gaan nu bekijken hoe de ruissterkte de modelaccuracy beïnvloedt. Omdat we dezelfde code meerdere keren moeten gebruiken, wikkelen we de belangrijkste delen in een kleine functie:
def accu( X, y):
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    knn = neighbors.KNeighborsClassifier()
    knn_model = knn.fit(X_train, y_train)
    return(knn_model.score(X_test, y_test))
noise = [10**i for i in np.arange(-1,6)]
A1 = np.zeros(len(noise))
A2 = np.zeros(len(noise))
count = 0
for ns in noise:
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Xns = scale(Xn)
A1[count] = accu( Xn, y)
A2[count] = accu( Xns, y)
count += 1We plotten nu de accuracy als functie van de ruissterkte (let op de logaritmische x-as):
plt.scatter( noise, A1 )
plt.plot( noise, A1, label = 'unscaled', linewidth = 2)
plt.scatter( noise, A2 , c = 'r')
plt.plot( noise, A2 , label = 'scaled', linewidth = 2)
plt.xscale('log')
plt.xlabel('Noise strength')
plt.ylabel('Accuracy')
plt.legend(loc=3);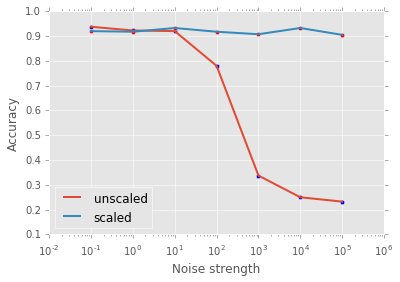
Zie in de bovenstaande figuur dat hoe meer ruis er in de stoorvariabele zit, hoe belangrijker het is om je data te schalen voor het k-NN-model! Hieronder krijg je de kans om hetzelfde te doen voor logistische regressie. Ter afsluiting hebben we de essentiële plaats gezien die preprocessing inneemt in de data science-pijplijn, in de gedaante van schalen en centreren, en deden we dit om een holistische benadering van de uitdagingen van machine learning te bevorderen. In toekomstige artikelen hoop ik deze discussie uit te breiden naar andere vormen van preprocessing, zoals transformaties van numerieke data en preprocessing van categorische data, beide essentiële onderdelen van de gereedschapskist van elke data scientist.
Oefening voor de leergierige lezer: probeer een logistisch regressiemodel te fitten op de bovenstaande gesynthetiseerde datasets en bekijk de modelprestaties. Hoe is de accuracy een functie van de ruissterkte voor respectievelijk geschaalde en ongeschaalde data? Je kunt dit doen in de DataCamp Light-widget hieronder! Verander de macht van 10 om de hoeveelheid ruis aan te passen (probeer eerst het bereik dat ik hierboven gebruikte voor k-NN) en zet sc = True als je je features wilt schalen. Je kunt ook DataCamp Light op Github bekijken!
Supervised learning: De taak om een doelvariabele af te leiden uit voorspellende variabelen. Bijvoorbeeld: de doelvariabele ‘aanwezigheid van hartziekte’ afleiden uit voorspellende variabelen zoals ‘leeftijd’, ‘geslacht’ en ‘rookstatus’.
Classificatietaak: Een supervised learning-taak is een classificatietaak als de doelvariabele uit categorieën bestaat (bijv. ‘klik’ of ‘geen klik’, ‘maligne’ of ‘benigne’ tumor).
Regressietaak: Een supervised learning-taak is een regressietaak als de doelvariabele een continu variërende variabele is (bijv. prijs van een huis) of een geordende categorische variabele zoals ‘kwaliteitsbeoordeling van wijn’.
k-Nearest Neighbors: Een algoritme voor classificatietaken, waarin een datapunt het label krijgt dat wordt bepaald door een meerderheid van stemmen van de k dichtstbijzijnde buren.
Preprocessing: Allerlei bewerkingen die data scientists gebruiken om hun data in een vorm te krijgen die geschikter is voor wat ze ermee willen doen. Bijvoorbeeld: voordat je sentimentanalyse uitvoert op Twitter-data, wil je misschien alle html-tags en witruimtes verwijderen, afkortingen uitschrijven en tweets splitsen in lijsten met woorden.
Centreren en schalen: Dit zijn beide vormen van preprocessing van numerieke data, dat wil zeggen data die uit getallen bestaat, in tegenstelling tot bijvoorbeeld categorieën of strings; een variabele centreren is het gemiddelde van de variabele van elk datapunt aftrekken zodat het gemiddelde van de nieuwe variabele 0 is; een variabele schalen is elk datapunt met een constante vermenigvuldigen om het bereik van de data te veranderen. Zie de hoofdtekst voor het belang hiervan, met voorbeelden.
Dit artikel is gegenereerd vanuit een Jupyter-notebook. Je kunt het notebook hier downloaden.
Python-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

