Cours
Introduction à Python
4 h
7M
Dans deux articles précédents, j’ai exploré le rôle du prétraitement des données dans un pipeline d’apprentissage automatique. J’ai notamment étudié les algorithmes k plus proches voisins (k-NN) et la régression logistique, et montré comment la mise à l’échelle des variables numériques influençait fortement les performances du premier, mais peu celles de la seconde, si l’on se fie par exemple à l’exactitude (voir le glossaire ci-dessous ou les articles précédents pour les définitions de la mise à l’échelle, de k-NN et d’autres termes utiles). Le message essentiel à retenir est que le prétraitement ne se fait pas en vase clos : vous pouvez bichonner vos données autant que vous voulez, la vérité se mesure aux résultats : quelle performance votre modèle atteint-il réellement ?
La mise à l’échelle des données numériques (c’est-à-dire multiplier toutes les observations d’une variable par une constante afin d’en modifier l’intervalle de valeurs) poursuit deux objectifs liés : i) si vos mesures sont en mètres et les miennes en miles, alors, en mettant nos données à l’échelle, nous les rendons comparables ; ii) si deux variables ont des échelles très différentes, celle avec la plage la plus large peut dominer votre modèle prédictif, même si elle est moins pertinente pour la variable cible que celle avec la plage la plus réduite. Nous avons vu que ce problème évoqué en ii) se pose avec k-NN, qui s’appuie explicitement sur la proximité entre points de données, mais pas avec la régression logistique qui, à l’entraînement, ajuste les coefficients pour compenser l’absence de mise à l’échelle.
Comme les données utilisées dans les articles précédents étaient réelles, nous ne pouvions observer que la performance des modèles avant et après mise à l’échelle. Ici, pour analyser l’impact d’un « bruit » sous forme de variables parasites (celles qui n’influencent pas la cible mais peuvent perturber votre modèle) sur la performance, avant et après mise à l’échelle, je vais synthétiser un jeu de données où je contrôle précisément la nature de la variable parasite. Nous verrons que plus les données synthétisées sont bruyantes, plus la mise à l’échelle devient cruciale pour k-NN. Tous les exemples sont en Python. Si vous n’êtes pas à l’aise avec Python, découvrez nos cours DataCamp ici. Nous utiliserons les bibliothèques pandas pour manipuler des DataFrame et scikit-learn pour l’apprentissage automatique.
Dans le bloc de code ci-dessous, nous utilisons la fonction make_blobs de scikit-learn pour générer 2000 points répartis en 4 amas (chaque point possède 2 variables prédictives et 1 variable cible).
# Generate some clustered data (blobs!)
import numpy as np
from sklearn.datasets.samples_generator import make_blobs
n_samples=2000
X, y = make_blobs(n_samples, centers=4, n_features=2,
random_state=0)Traçons maintenant dans le plan les données que nous avons synthétisées. Chaque axe correspond à une variable prédictive et la couleur indique la variable cible :
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(X[:,0] , X[:,1],  c = y, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.hist(y)
plt.show()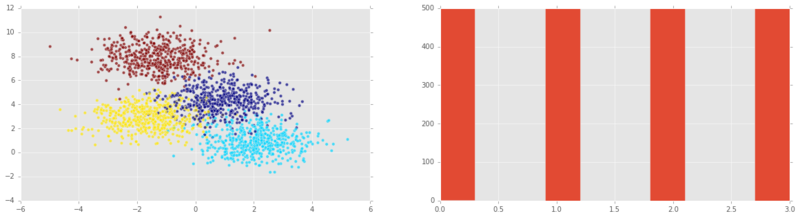
Remarque : on constate sur le 2ᵉ graphique que toutes les classes cibles sont représentées de manière équivalente. Dans ce cas (ou si elles sont approximativement équilibrées), on dit que la classe y est équilibrée.
Traçons à présent les histogrammes des variables explicatives :
import pandas as pd
df = pd.DataFrame(X)
pd.DataFrame.hist(df, figsize=(20,5));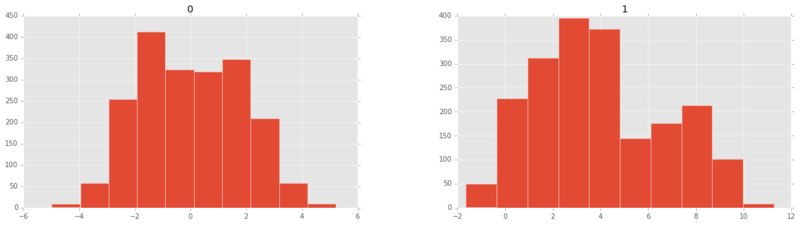
Séparons maintenant en ensembles d’entraînement et de test, puis traçons-les :
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.title('training set')
plt.scatter(X_train[:,0] , X_train[:,1],  c = y_train, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.scatter(X_test[:,0] , X_test[:,1],  c = y_test, alpha = 0.7);
plt.title('test set')
plt.show()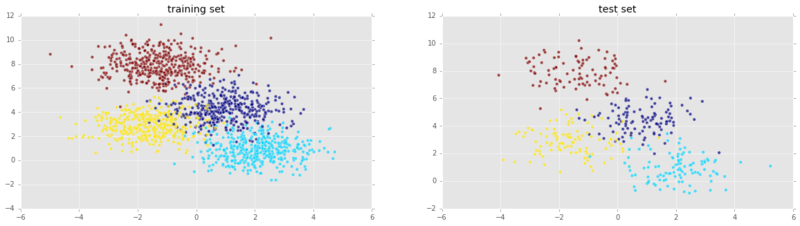
Parfait ! Instancions maintenant un classificateur k plus proches voisins et entraînons-le sur l’ensemble d’entraînement :
from sklearn import neighbors, linear_model
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(X_train, y_train)
Une fois le modèle entraîné, évaluons-le sur l’ensemble de test et calculons l’exactitude :
print('k-NN score for test set: %f' % knn_model.score(X_test, y_test))`k-NN score for test set: 0.935000`On peut aussi le réajuster sur l’ensemble d’entraînement et calculer l’exactitude. On s’attend généralement à de meilleures performances sur l’entraînement que sur le test :
print('k-NN score for training set: %f' % knn_model.score(X_train, y_train))`k-NN score for training set: 0.941875`Rappelons que la métrique par défaut de k-NN dans scikit-learn est l’exactitude. Pour examiner d’autres métriques, utilisons aussi le rapport de classification de scikit-learn :
from sklearn.metrics import classification_report
y_true, y_pred = y_test, knn_model.predict(X_test)
print(classification_report(y_true, y_pred))
precision recall f1-score support
0 0.87 0.90 0.88 106
1 0.98 0.93 0.95 102
2 0.90 0.92 0.91 100
3 1.00 1.00 1.00 92
avg / total 0.94 0.94 0.94 400Mettons à présent les variables prédictives à l’échelle, puis réappliquons k-NN :
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(Xs_train[:,0] , Xs_train[:,1],  c = y_train, alpha = 0.7);
plt.title('scaled training set')
plt.subplot(1, 2, 2);
plt.scatter(Xs_test[:,0] , Xs_test[:,1],  c = y_test, alpha = 0.7);
plt.title('scaled test set')
plt.show()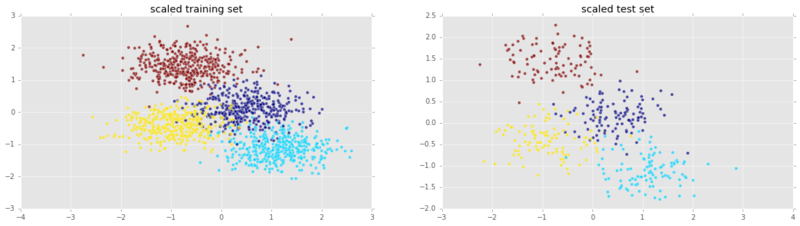
knn_model_s = knn.fit(Xs_train, y_train)
print('k-NN score for test set: %f' % knn_model_s.score(Xs_test, y_test))
`k-NN score for test set: 0.935000`Pas de gain avec la mise à l’échelle ! Très probablement parce que les deux caractéristiques étaient déjà sur des plages similaires. La mise à l’échelle prend tout son sens lorsque les variables ont des amplitudes très différentes. Pour l’illustrer, ajoutons une autre caractéristique. De plus, elle n’aura aucun lien avec la cible : ce sera du pur bruit.
Nous ajoutons une troisième variable de bruit gaussien de moyenne 0 et d’écart-type variable \(\sigma\). Nous appellerons \(\sigma\) l’intensité du bruit, et nous verrons que plus le bruit est fort, plus les performances de k-NN se dégradent.
# Add noise column to predictor variables
ns = 10**(3) # Strength of noise term
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Utilisons maintenant le module mplot3d pour tracer les données en 3D :
from mpl_toolkits.mplot3d import Axes3D
fig = plt.figure(figsize=(15,10));
ax = fig.add_subplot(111, projection='3d' , alpha = 0.5);
ax.scatter(Xn[:,0], Xn[:,1], Xn[:,2], c = y);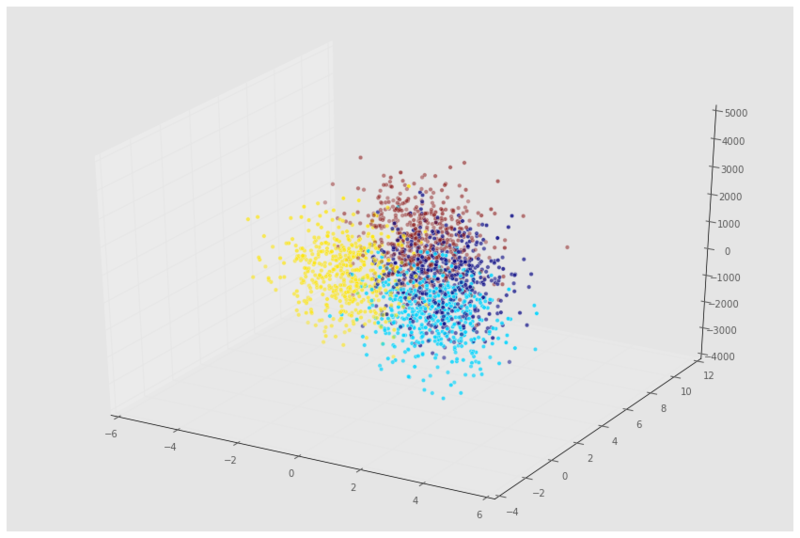
Voyons maintenant comment le modèle se comporte sur ces nouvelles données :
Xn_train, Xn_test, y_train, y_test = train_test_split(Xn, y, test_size=0.2, random_state=42)
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(Xn_train, y_train)
print('k-NN score for test set: %f' % knn_model.score(Xn_test, y_test))
k-NN score for test set: 0.400000
Un modèle catastrophique ! Et si nous mettions à l’échelle pour voir l’impact ?
Xns = scale(Xn)
s = int(.2*n_samples)
Xns_train = Xns[s:]
y_train = y[s:]
Xns_test = Xns[:s]
y_test = y[:s]
knn = neighbors.KNeighborsClassifier()
knn_models = knn.fit(Xns_train, y_train)
print('k-NN score for test set: %f' % knn_models.score(Xns_test, y_test))
`k-NN score for test set: 0.907500`Excellent : après mise à l’échelle, le modèle retrouve quasiment le niveau qu’il avait sans bruit. Observons maintenant la performance du modèle en fonction de l’intensité du bruit.
Nous allons étudier comment l’intensité du bruit affecte l’exactitude du modèle. Comme nous allons réutiliser plusieurs fois le même code, encapsulons l’essentiel dans une petite fonction :
def accu( X, y):
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    knn = neighbors.KNeighborsClassifier()
    knn_model = knn.fit(X_train, y_train)
    return(knn_model.score(X_test, y_test))
noise = [10**i for i in np.arange(-1,6)]
A1 = np.zeros(len(noise))
A2 = np.zeros(len(noise))
count = 0
for ns in noise:
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Xns = scale(Xn)
A1[count] = accu( Xn, y)
A2[count] = accu( Xns, y)
count += 1Traçons maintenant l’exactitude en fonction de l’intensité du bruit (échelle logarithmique en abscisse) :
plt.scatter( noise, A1 )
plt.plot( noise, A1, label = 'unscaled', linewidth = 2)
plt.scatter( noise, A2 , c = 'r')
plt.plot( noise, A2 , label = 'scaled', linewidth = 2)
plt.xscale('log')
plt.xlabel('Noise strength')
plt.ylabel('Accuracy')
plt.legend(loc=3);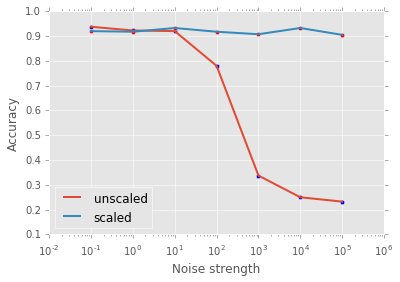
Comme on le voit ci-dessus, plus la variable parasite est bruyante, plus il est essentiel de mettre vos données à l’échelle pour le modèle k-NN ! Ci-dessous, vous pourrez faire le même exercice avec la régression logistique. En conclusion, nous avons mis en évidence le rôle clé du prétraitement dans un pipeline de data science, en particulier la mise à l’échelle et le centrage, dans une approche globale des défis de l’apprentissage automatique. Dans de futurs articles, j’espère étendre cette discussion à d’autres types de prétraitements, comme les transformations de données numériques et le prétraitement des variables catégorielles, deux briques indispensables de la boîte à outils de tout data scientist.
Exercice pour les lecteurs motivés : entraînez un modèle de régression logistique sur les jeux de données synthétisés ci-dessus et évaluez ses performances. Comment l’exactitude varie-t-elle en fonction de l’intensité du bruit pour des données mises à l’échelle et non mises à l’échelle ? Vous pouvez le faire dans le widget DataCamp Light ci-dessous ! Modifiez l’exposant de 10 pour ajuster la quantité de bruit (essayez d’abord la même plage que plus haut pour k-NN) et définissez sc = True si vous souhaitez mettre vos variables à l’échelle. Vous pouvez aussi consulter DataCamp Light sur Github !
Apprentissage supervisé : tâche consistant à inférer une variable cible à partir de variables prédictives. Par exemple, prédire la variable cible « présence d’une maladie cardiaque » à partir de variables prédictives telles que l’« âge », le « sexe » et le « statut fumeur ».
Tâche de classification : une tâche d’apprentissage supervisé est une classification si la variable cible est catégorielle (p. ex. « clic » ou « non », tumeur « maligne » ou « bénigne »).
Tâche de régression : une tâche d’apprentissage supervisé est une régression si la variable cible est continue (p. ex. le prix d’une maison) ou une variable ordinale telle que la « note de qualité d’un vin ».
k plus proches voisins : algorithme de classification qui attribue à un point la classe décidée par vote majoritaire de ses k voisins les plus proches.
Prétraitement : ensemble d’opérations utilisées par les data scientists pour mettre les données dans une forme plus adaptée à l’objectif visé. Par exemple, avant d’effectuer une analyse de sentiment sur des tweets, vous pouvez supprimer les balises HTML, les espaces superflus, développer les abréviations et segmenter les tweets en listes de mots.
Centrage et mise à l’échelle : deux formes de prétraitement des données numériques (par opposition aux catégories ou chaînes de caractères). Centrer une variable consiste à soustraire sa moyenne de chaque observation afin que la nouvelle moyenne soit 0 ; mettre à l’échelle une variable consiste à multiplier chaque observation par une constante pour modifier l’intervalle de valeurs. Voir le corps de l’article pour l’intérêt de ces opérations et des exemples.
Cet article a été généré à partir d’un notebook Jupyter. Vous pouvez télécharger le notebook ici.
Cours Python
Cours
Cours
Cours