Khóa học
Nhập môn Python
4 giờ
7.1M
Trong hai bài viết trước, tôi đã khám phá vai trò của việc tiền xử lý dữ liệu trong pipeline học máy. Cụ thể, tôi đã xem xét các thuật toán k-láng giềng gần nhất (k-NN) và hồi quy logistic, và thấy rằng việc chuẩn hóa dữ liệu số ảnh hưởng mạnh đến hiệu năng của thuật toán thứ nhất nhưng không phải của thuật toán thứ hai, được đo, chẳng hạn, bằng độ chính xác (xem Bảng thuật ngữ bên dưới hoặc các bài trước để biết định nghĩa về chuẩn hóa, k-NN và các thuật ngữ liên quan khác). Thông điệp rút ra thực sự ở đây là tiền xử lý không diễn ra trong chân không, tức là bạn có thể tiền xử lý dữ liệu rất kỹ nhưng điều quan trọng là: mô hình của bạn sau đó hoạt động tốt đến mức nào?
Chuẩn hóa dữ liệu số (tức là nhân mọi quan sát của một biến với một hằng số để thay đổi miền giá trị của biến đó) có hai mục đích liên quan: i) nếu phép đo của bạn dùng mét còn của tôi dùng dặm, thì nếu cả hai chúng ta đều chuẩn hóa dữ liệu, chúng sẽ trở nên tương đồng & ii) nếu hai biến có miền giá trị rất khác nhau, biến có miền lớn hơn có thể chi phối mô hình dự đoán, dù nó kém quan trọng hơn đối với biến mục tiêu so với biến có miền nhỏ hơn. Chúng ta đã thấy vấn đề nêu ở ii) xảy ra với k-NN, vốn xét rõ ràng độ gần của các điểm dữ liệu với nhau, nhưng không xảy ra với hồi quy logistic, vốn trong quá trình huấn luyện sẽ làm co hệ số tương ứng để bù cho việc thiếu chuẩn hóa.
Vì dữ liệu dùng trong các bài trước là dữ liệu thực tế, tất cả những gì chúng ta thấy chỉ là hiệu năng mô hình trước và sau khi chuẩn hóa. Ở đây, để xem nhiễu dưới dạng biến phiền nhiễu (những biến không ảnh hưởng đến biến mục tiêu nhưng có thể ảnh hưởng đến mô hình) thay đổi hiệu năng mô hình trước và sau khi chuẩn hóa ra sao, tôi sẽ tổng hợp một tập dữ liệu trong đó tôi có thể kiểm soát chính xác bản chất của biến phiền nhiễu. Chúng ta sẽ thấy rằng dữ liệu tổng hợp càng nhiễu thì chuẩn hóa càng quan trọng đối với k-NN. Tất cả ví dụ trong bài dùng Python. Nếu bạn chưa quen với Python, bạn có thể xem các khóa học của DataCamp tại đây. Tôi sẽ dùng thư viện pandas cho nhu cầu DataFrame và scikit-learn cho nhu cầu học máy.
Trong khối mã dưới đây, chúng ta dùng hàm make_blobs của scikit-learn để tạo 2000 điểm dữ liệu thuộc 4 cụm (mỗi điểm dữ liệu có 2 biến dự báo và 1 biến mục tiêu).
# Generate some clustered data (blobs!)
import numpy as np
from sklearn.datasets.samples_generator import make_blobs
n_samples=2000
X, y = make_blobs(n_samples, centers=4, n_features=2,
random_state=0)Bây giờ chúng ta sẽ vẽ dữ liệu đã tổng hợp trên mặt phẳng. Mỗi trục là một biến dự báo và màu sắc biểu thị biến mục tiêu:
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(X[:,0] , X[:,1],  c = y, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.hist(y)
plt.show()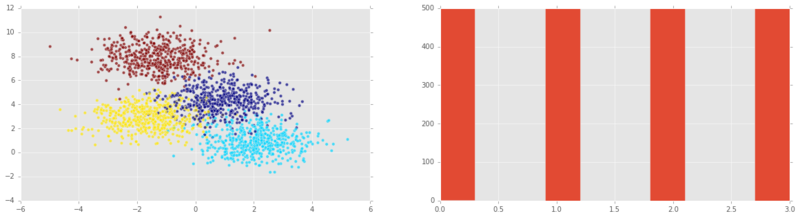
Lưu ý: ở biểu đồ thứ 2, ta thấy tất cả các giá trị mục tiêu khả dĩ đều được đại diện như nhau. Trong trường hợp này (hoặc xấp xỉ như vậy), ta nói rằng lớp y là cân bằng.
Giờ tôi muốn vẽ các biểu đồ tần suất của các đặc trưng (biến dự báo):
import pandas as pd
df = pd.DataFrame(X)
pd.DataFrame.hist(df, figsize=(20,5));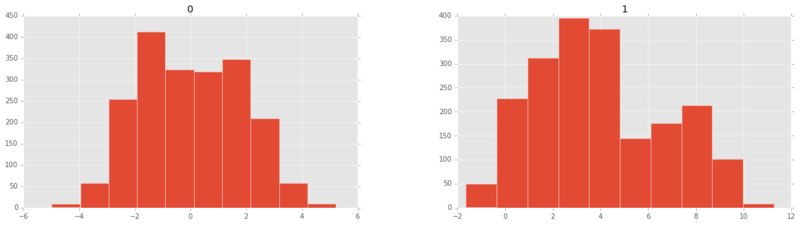
Bây giờ hãy chia thành tập huấn luyện & kiểm tra và vẽ cả hai tập:
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.title('training set')
plt.scatter(X_train[:,0] , X_train[:,1],  c = y_train, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.scatter(X_test[:,0] , X_test[:,1],  c = y_test, alpha = 0.7);
plt.title('test set')
plt.show()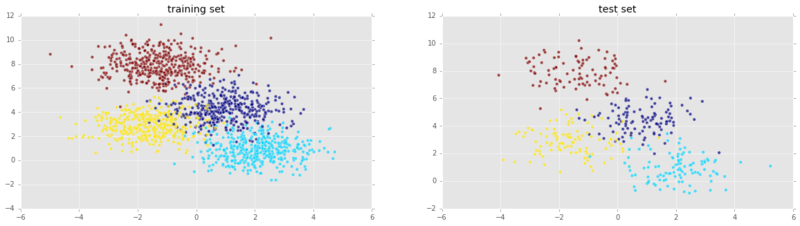
Trông ổn đấy! Giờ hãy khởi tạo một bộ phân loại bỏ phiếu k-láng giềng gần nhất và huấn luyện nó trên tập huấn luyện của chúng ta:
from sklearn import neighbors, linear_model
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(X_train, y_train)
Giờ khi đã huấn luyện mô hình, chúng ta có thể khớp nó với tập kiểm tra và tính độ chính xác:
print('k-NN score for test set: %f' % knn_model.score(X_test, y_test))`k-NN score for test set: 0.935000`Ta cũng có thể khớp lại với tập huấn luyện và tính độ chính xác. Ta kỳ vọng mô hình sẽ hoạt động tốt hơn trên tập huấn luyện so với tập kiểm tra:
print('k-NN score for training set: %f' % knn_model.score(X_train, y_train))`k-NN score for training set: 0.941875`Cũng đáng nhắc lại rằng phương pháp chấm điểm mặc định cho k-NN trong scikit-learn là độ chính xác. Để xem nhiều thước đo khác, ta cũng có thể dùng báo cáo phân loại của scikit-learn:
from sklearn.metrics import classification_report
y_true, y_pred = y_test, knn_model.predict(X_test)
print(classification_report(y_true, y_pred))
precision recall f1-score support
0 0.87 0.90 0.88 106
1 0.98 0.93 0.95 102
2 0.90 0.92 0.91 100
3 1.00 1.00 1.00 92
avg / total 0.94 0.94 0.94 400Tôi sẽ chuẩn hóa các biến dự báo rồi lại dùng k-NN:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(Xs_train[:,0] , Xs_train[:,1],  c = y_train, alpha = 0.7);
plt.title('scaled training set')
plt.subplot(1, 2, 2);
plt.scatter(Xs_test[:,0] , Xs_test[:,1],  c = y_test, alpha = 0.7);
plt.title('scaled test set')
plt.show()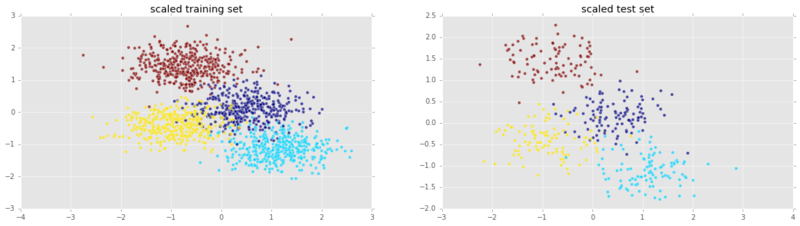
knn_model_s = knn.fit(Xs_train, y_train)
print('k-NN score for test set: %f' % knn_model_s.score(Xs_test, y_test))
`k-NN score for test set: 0.935000`Kết quả không tốt hơn khi chuẩn hóa! Nhiều khả năng bởi cả hai đặc trưng vốn đã có miền giá trị tương đương. Việc chuẩn hóa thực sự có ý nghĩa khi các biến có miền giá trị chênh lệch lớn. Để thấy điều này, chúng ta sẽ thêm một đặc trưng khác. Hơn nữa, đặc trưng này hoàn toàn không liên quan đến biến mục tiêu: nó chỉ là nhiễu.
Chúng ta thêm biến thứ ba là nhiễu Gauss với kỳ vọng 0 và độ lệch chuẩn biến thiên \(\sigma\). Ta sẽ gọi \(\sigma\) là cường độ nhiễu và sẽ thấy rằng nhiễu càng mạnh, hiệu năng của k-láng giềng gần nhất càng giảm.
# Add noise column to predictor variables
ns = 10**(3) # Strength of noise term
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Bây giờ chúng ta sẽ dùng gói mplot3d để vẽ dữ liệu 3D:
from mpl_toolkits.mplot3d import Axes3D
fig = plt.figure(figsize=(15,10));
ax = fig.add_subplot(111, projection='3d' , alpha = 0.5);
ax.scatter(Xn[:,0], Xn[:,1], Xn[:,2], c = y);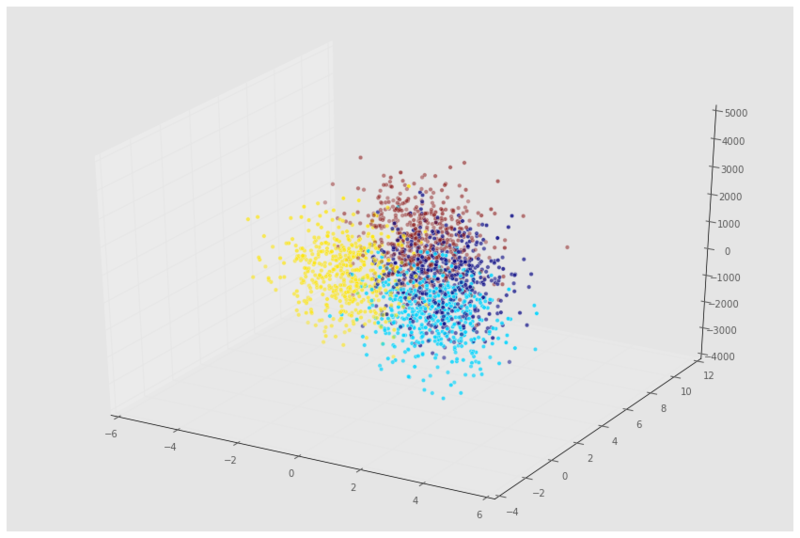
Giờ hãy xem mô hình của chúng ta hoạt động thế nào trên dữ liệu mới:
Xn_train, Xn_test, y_train, y_test = train_test_split(Xn, y, test_size=0.2, random_state=42)
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(Xn_train, y_train)
print('k-NN score for test set: %f' % knn_model.score(Xn_test, y_test))
k-NN score for test set: 0.400000
Mô hình này tệ thật! Vậy thử chuẩn hóa rồi kiểm tra hiệu năng nhé?
Xns = scale(Xn)
s = int(.2*n_samples)
Xns_train = Xns[s:]
y_train = y[s:]
Xns_test = Xns[:s]
y_test = y[:s]
knn = neighbors.KNeighborsClassifier()
knn_models = knn.fit(Xns_train, y_train)
print('k-NN score for test set: %f' % knn_models.score(Xns_test, y_test))
`k-NN score for test set: 0.907500`Tuyệt, sau khi chuẩn hóa dữ liệu, mô hình hoạt động gần như tốt như khi không có nhiễu. Giờ hãy xem hiệu năng mô hình là hàm của cường độ nhiễu.
Chúng ta sẽ xem cường độ nhiễu ảnh hưởng đến độ chính xác của mô hình thế nào. Vì sẽ cần dùng lại cùng đoạn mã vài lần, hãy gói các phần chính vào một hàm nhỏ:
def accu( X, y):
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    knn = neighbors.KNeighborsClassifier()
    knn_model = knn.fit(X_train, y_train)
    return(knn_model.score(X_test, y_test))
noise = [10**i for i in np.arange(-1,6)]
A1 = np.zeros(len(noise))
A2 = np.zeros(len(noise))
count = 0
for ns in noise:
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Xns = scale(Xn)
A1[count] = accu( Xn, y)
A2[count] = accu( Xns, y)
count += 1Giờ ta vẽ độ chính xác theo hàm cường độ nhiễu (lưu ý trục x log):
plt.scatter( noise, A1 )
plt.plot( noise, A1, label = 'unscaled', linewidth = 2)
plt.scatter( noise, A2 , c = 'r')
plt.plot( noise, A2 , label = 'scaled', linewidth = 2)
plt.xscale('log')
plt.xlabel('Noise strength')
plt.ylabel('Accuracy')
plt.legend(loc=3);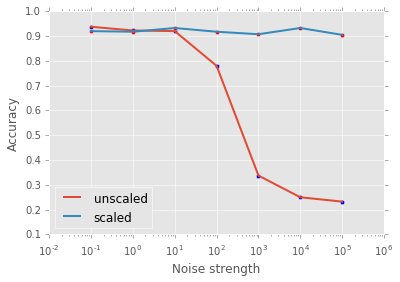
Hãy xem ở hình trên: nhiễu ở biến phiền nhiễu càng nhiều thì việc chuẩn hóa dữ liệu cho mô hình k-NN càng quan trọng! Bên dưới, bạn sẽ có cơ hội làm điều tương tự với hồi quy logistic. Kết lại, chúng ta đã thấy vị trí thiết yếu của tiền xử lý trong pipeline khoa học dữ liệu, ở phiên bản chuẩn hóa và đặt về trung bình, và chúng ta làm vậy để thúc đẩy một cách tiếp cận tổng thể với các thách thức của học máy. Trong các bài sau, tôi hy vọng mở rộng thảo luận sang những kiểu tiền xử lý khác, như biến đổi dữ liệu số và tiền xử lý dữ liệu phân loại, đều là những phần thiết yếu trong bộ công cụ của mọi nhà khoa học dữ liệu.
Bài tập cho độc giả ham học: hãy thử khớp một mô hình hồi quy logistic với các tập dữ liệu tổng hợp ở trên và kiểm tra hiệu năng mô hình. Độ chính xác là hàm của cường độ nhiễu ra sao với dữ liệu đã chuẩn hóa và chưa chuẩn hóa, tương ứng? Bạn có thể làm điều này trong widget DataCamp Light bên dưới! Thay đổi số mũ của 10 để điều chỉnh lượng nhiễu (trước tiên hãy thử phạm vi tôi đã thử ở trên cho k-NN) và đặt sc = True nếu bạn muốn chuẩn hóa các đặc trưng. Bạn cũng có thể xem DataCamp Light trên Github!
Học có giám sát (Supervised learning): Nhiệm vụ suy luận một biến mục tiêu từ các biến dự báo. Ví dụ, suy luận biến mục tiêu ‘có bệnh tim hay không’ từ các biến dự báo như ‘tuổi’, ‘giới tính’ và ‘tình trạng hút thuốc’.
Bài toán phân loại (Classification task): Một nhiệm vụ học có giám sát là bài toán phân loại nếu biến mục tiêu gồm các hạng mục (ví dụ ‘nhấp’ hoặc ‘không’, khối u ‘ác tính’ hoặc ‘lành tính’).
Bài toán hồi quy (Regression task): Một nhiệm vụ học có giám sát là bài toán hồi quy nếu biến mục tiêu là biến thay đổi liên tục (ví dụ giá nhà) hoặc biến phân loại có thứ tự như ‘điểm chất lượng rượu vang’.
k-láng giềng gần nhất: Một thuật toán cho bài toán phân loại, trong đó một điểm dữ liệu được gán nhãn theo lá phiếu đa số của k láng giềng gần nhất của nó.
Tiền xử lý (Preprocessing): Bất kỳ tập hợp thao tác nào mà các nhà khoa học dữ liệu sử dụng để đưa dữ liệu vào dạng phù hợp hơn cho mục đích của họ. Ví dụ, trước khi thực hiện phân tích cảm xúc dữ liệu Twitter, bạn có thể muốn loại bỏ thẻ html, khoảng trắng, mở rộng chữ viết tắt và tách tweet thành danh sách các từ chứa trong đó.
Đặt về trung bình và Chuẩn hóa (Centering and Scaling): Cả hai đều là dạng tiền xử lý dữ liệu số, tức dữ liệu là các con số, trái ngược với hạng mục hay chuỗi, chẳng hạn; đặt về trung bình một biến là trừ đi giá trị trung bình của biến đó khỏi mỗi điểm dữ liệu để biến mới có trung bình bằng 0; chuẩn hóa một biến là nhân mỗi điểm dữ liệu với một hằng số để thay đổi miền giá trị của dữ liệu. Xem phần nội dung bài viết để biết tầm quan trọng của chúng kèm ví dụ.
Bài viết này được tạo từ một sổ tay Jupyter. Bạn có thể tải sổ tay tại đây.
Khóa học Python
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
