Curso
Introdução ao Python
4 h
7M
Em dois artigos anteriores, explorei o papel do pré-processamento de dados no pipeline de machine learning. Em especial, analisei os algoritmos de k-Nearest Neighbors (k-NN) e regressão logística e vi como o scaling de dados numéricos influencia bastante o desempenho do primeiro, mas não do segundo, medido, por exemplo, por acurácia (consulte o glossário abaixo ou os artigos anteriores para as definições de scaling, k-NN e outros termos relevantes). A grande mensagem aqui é: pré-processamento não acontece no vácuo. Ou seja, você pode caprichar no pré-processamento dos seus dados, mas o que vale é o resultado: como o seu modelo performa no fim das contas?
Aplicar scaling em dados numéricos (isto é, multiplicar todas as ocorrências de uma variável por uma constante para alterar o seu intervalo) tem dois objetivos relacionados: i) se suas medidas estão em metros e as minhas em milhas, ao escalarmos os dados de ambos, eles passam a ser comparáveis & ii) se duas variáveis têm faixas de valores muito diferentes, a de maior amplitude pode dominar o modelo preditivo, mesmo sendo menos importante para a variável alvo do que a variável de menor amplitude. Vimos que o problema do item ii) ocorre com k-NN, que olha explicitamente para quão próximos os dados estão entre si, mas não com regressão logística que, durante o treino, ajusta o coeficiente relevante para compensar a falta de scaling.
Como os dados usados nos artigos anteriores eram do mundo real, só conseguimos observar o desempenho dos modelos antes e depois do scaling. Aqui, para enxergar como o ruído na forma de variáveis incômodo (aquelas que não afetam a variável alvo, mas podem afetar seu modelo) muda o desempenho do modelo, tanto pré quanto pós-scaling, vou sintetizar um conjunto de dados no qual consigo controlar a natureza exata da variável incômodo. Veremos que quanto mais ruidosos forem os dados sintetizados, mais importante será aplicar scaling para k-NN. Todos os exemplos serão em Python. Se você não está familiarizado com Python, pode conferir nossos cursos da DataCamp aqui. Vou usar as bibliotecas pandas para manipulação de DataFrame e scikit-learn para machine learning.
No trecho de código abaixo, usamos a função make_blobs do scikit-learn para gerar 2000 pontos de dados em 4 clusters (cada ponto tem 2 variáveis preditoras e 1 variável alvo).
# Generate some clustered data (blobs!)
import numpy as np
from sklearn.datasets.samples_generator import make_blobs
n_samples=2000
X, y = make_blobs(n_samples, centers=4, n_features=2,
random_state=0)Agora vamos plotar no plano os dados que sintetizamos. Cada eixo é uma variável preditora e a cor indica a variável alvo:
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(X[:,0] , X[:,1],  c = y, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.hist(y)
plt.show()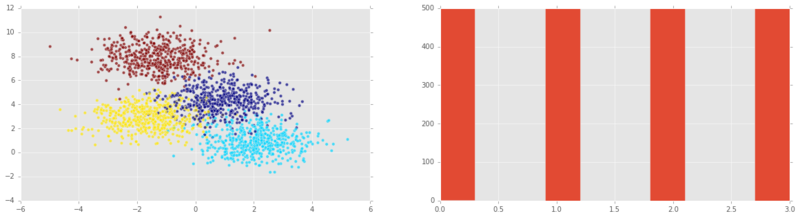
Observação: vemos no 2º gráfico que todas as classes alvo possíveis estão igualmente representadas. Nesse caso (ou mesmo se estiverem aproximadamente equilibradas), dizemos que a classe y é balanceada.
Agora quero plotar histogramas das features (variáveis preditoras):
import pandas as pd
df = pd.DataFrame(X)
pd.DataFrame.hist(df, figsize=(20,5));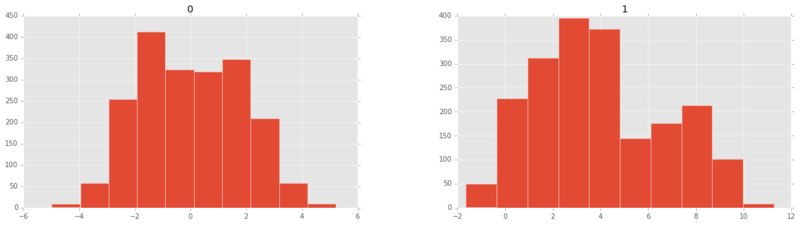
Vamos dividir em conjuntos de treino e teste e plotar ambos:
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.title('training set')
plt.scatter(X_train[:,0] , X_train[:,1],  c = y_train, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.scatter(X_test[:,0] , X_test[:,1],  c = y_test, alpha = 0.7);
plt.title('test set')
plt.show()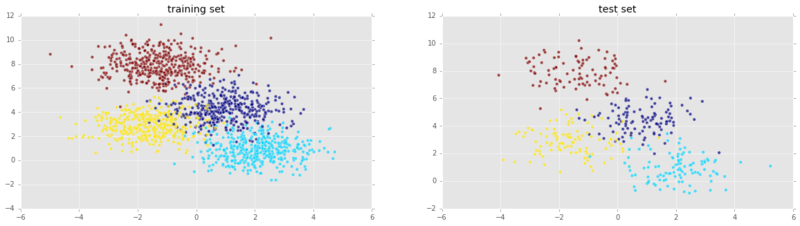
Ótimo! Agora vamos instanciar um classificador k-Nearest Neighbors por votação e treiná-lo no conjunto de treino:
from sklearn import neighbors, linear_model
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(X_train, y_train)
Com o modelo treinado, podemos avaliá-lo no conjunto de teste e calcular a acurácia:
print('k-NN score for test set: %f' % knn_model.score(X_test, y_test))`k-NN score for test set: 0.935000`Também podemos reavaliá-lo no conjunto de treino e calcular a acurácia. Esperamos um desempenho melhor no treino do que no teste:
print('k-NN score for training set: %f' % knn_model.score(X_train, y_train))`k-NN score for training set: 0.941875`Vale lembrar que o método de pontuação padrão para k-NN no scikit-learn é a acurácia. Para explorar outras métricas, podemos usar também o classification report do scikit-learn:
from sklearn.metrics import classification_report
y_true, y_pred = y_test, knn_model.predict(X_test)
print(classification_report(y_true, y_pred))
precision recall f1-score support
0 0.87 0.90 0.88 106
1 0.98 0.93 0.95 102
2 0.90 0.92 0.91 100
3 1.00 1.00 1.00 92
avg / total 0.94 0.94 0.94 400Vou escalar as variáveis preditoras e aplicar k-NN novamente:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(Xs_train[:,0] , Xs_train[:,1],  c = y_train, alpha = 0.7);
plt.title('scaled training set')
plt.subplot(1, 2, 2);
plt.scatter(Xs_test[:,0] , Xs_test[:,1],  c = y_test, alpha = 0.7);
plt.title('scaled test set')
plt.show()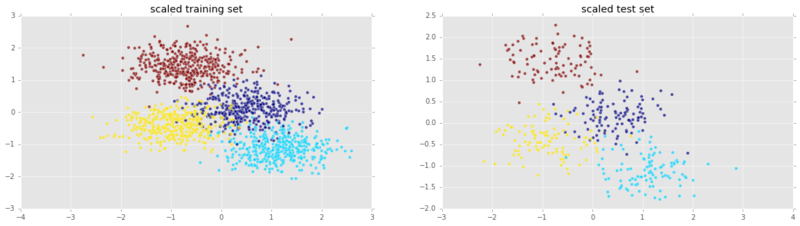
knn_model_s = knn.fit(Xs_train, y_train)
print('k-NN score for test set: %f' % knn_model_s.score(Xs_test, y_test))
`k-NN score for test set: 0.935000`Não melhorou com scaling! Muito provavelmente porque as duas features já tinham faixas semelhantes. Faz mais sentido escalar quando as variáveis têm amplitudes bem diferentes. Para ver isso na prática, vamos adicionar outra feature. Além disso, essa feature não terá nenhuma relação com a variável alvo: será apenas ruído.
Adicionamos uma terceira variável de ruído gaussiano com média 0 e desvio padrão variável \(\sigma\). Vamos chamar \(\sigma\) de intensidade do ruído e veremos que, quanto maior o ruído, pior o desempenho do k-Nearest Neighbours.
# Add noise column to predictor variables
ns = 10**(3) # Strength of noise term
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Agora vamos usar o pacote mplot3d para plotar os dados em 3D:
from mpl_toolkits.mplot3d import Axes3D
fig = plt.figure(figsize=(15,10));
ax = fig.add_subplot(111, projection='3d' , alpha = 0.5);
ax.scatter(Xn[:,0], Xn[:,1], Xn[:,2], c = y);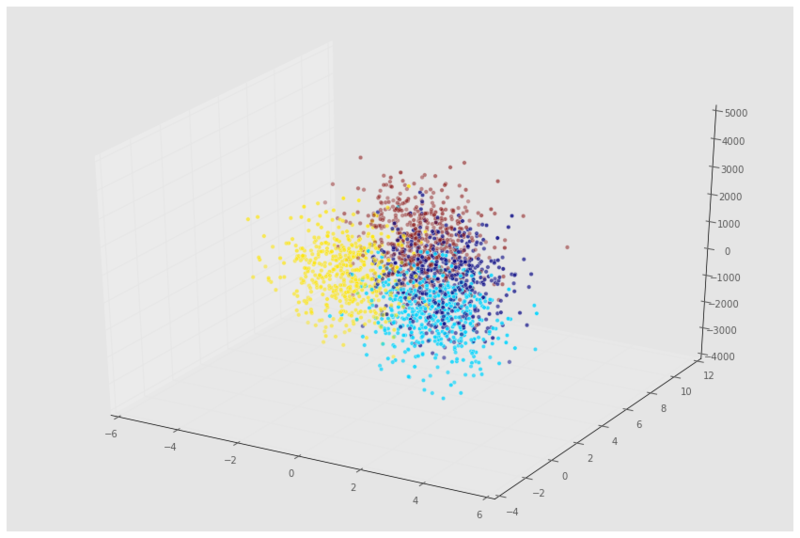
Agora vamos ver como o modelo se sai com os novos dados:
Xn_train, Xn_test, y_train, y_test = train_test_split(Xn, y, test_size=0.2, random_state=42)
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(Xn_train, y_train)
print('k-NN score for test set: %f' % knn_model.score(Xn_test, y_test))
k-NN score for test set: 0.400000
Que modelo péssimo! E se aplicarmos scaling e testarmos de novo?
Xns = scale(Xn)
s = int(.2*n_samples)
Xns_train = Xns[s:]
y_train = y[s:]
Xns_test = Xns[:s]
y_test = y[:s]
knn = neighbors.KNeighborsClassifier()
knn_models = knn.fit(Xns_train, y_train)
print('k-NN score for test set: %f' % knn_models.score(Xns_test, y_test))
`k-NN score for test set: 0.907500`Ótimo, depois do scaling, o modelo quase alcança o desempenho do cenário sem ruído. Agora vamos analisar o desempenho do modelo em função da intensidade do ruído.
Agora vamos ver como a intensidade do ruído afeta a acurácia. Como vamos reutilizar o mesmo código várias vezes, vamos encapsular as partes principais em uma pequena função:
def accu( X, y):
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    knn = neighbors.KNeighborsClassifier()
    knn_model = knn.fit(X_train, y_train)
    return(knn_model.score(X_test, y_test))
noise = [10**i for i in np.arange(-1,6)]
A1 = np.zeros(len(noise))
A2 = np.zeros(len(noise))
count = 0
for ns in noise:
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Xns = scale(Xn)
A1[count] = accu( Xn, y)
A2[count] = accu( Xns, y)
count += 1Agora plotamos a acurácia em função da intensidade do ruído (note o eixo x em escala log):
plt.scatter( noise, A1 )
plt.plot( noise, A1, label = 'unscaled', linewidth = 2)
plt.scatter( noise, A2 , c = 'r')
plt.plot( noise, A2 , label = 'scaled', linewidth = 2)
plt.xscale('log')
plt.xlabel('Noise strength')
plt.ylabel('Accuracy')
plt.legend(loc=3);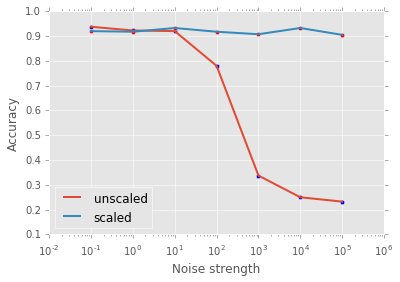
Veja na figura acima: quanto mais ruído existe na variável incômodo, mais importante é escalar seus dados para o modelo k-NN! A seguir, você pode fazer o mesmo para regressão logística. Para concluir, vimos o papel essencial do pré-processamento no pipeline de ciência de dados, especialmente nas etapas de scaling e centralização, reforçando uma visão holística dos desafios de machine learning. Em textos futuros, pretendo ampliar essa discussão para outros tipos de pré-processamento, como transformações de dados numéricos e tratamento de dados categóricos, ambos fundamentais no kit de ferramentas de qualquer cientista de dados.
Exercício para quem ficou com vontade de ir além: ajuste um modelo de regressão logística aos conjuntos de dados sintetizados acima e avalie o desempenho. Como a acurácia varia em função da intensidade do ruído para dados escalados e não escalados, respectivamente? Você pode fazer isso no widget DataCamp Light abaixo! Altere o expoente de 10 para mudar a quantidade de ruído (comece pelo intervalo que usei acima para k-NN) e defina sc = True se quiser aplicar scaling às suas features. Você também pode conferir o DataCamp Light no Github!
Aprendizado supervisionado: tarefa de inferir uma variável alvo a partir de variáveis preditoras. Exemplo: inferir a variável alvo "presença de doença cardíaca" a partir de variáveis preditoras como "idade", "sexo" e "tabagismo".
Tarefa de classificação: uma tarefa de aprendizado supervisionado é de classificação quando a variável alvo é categórica (por exemplo, "clique" ou "não clique", tumor "maligno" ou "benigno").
Tarefa de regressão: uma tarefa de aprendizado supervisionado é de regressão quando a variável alvo é contínua (por exemplo, preço de um imóvel) ou uma variável categórica ordenada, como "nota de qualidade do vinho".
k-Nearest Neighbors: algoritmo para tarefas de classificação em que um ponto de dados recebe o rótulo decidido pela maioria dos seus k vizinhos mais próximos.
Pré-processamento: conjunto de operações que cientistas de dados usam para deixar os dados no formato mais adequado ao objetivo da análise. Por exemplo, antes de fazer análise de sentimento em dados do Twitter, você pode querer remover tags HTML, espaços em branco, expandir abreviações e dividir os tweets nas listas de palavras que contêm.
Centralização e scaling: ambos são formas de pré-processar dados numéricos, isto é, dados compostos por números, em oposição a categorias ou strings, por exemplo; centralizar uma variável é subtrair a média da variável de cada observação para que a nova variável tenha média 0; escalar uma variável é multiplicar cada observação por uma constante para alterar a faixa dos dados. Veja no corpo do artigo a importância dessas técnicas, com exemplos.
Este artigo foi gerado a partir de um notebook Jupyter. Você pode baixar o notebook aqui.
Cursos de Python
Curso
Curso
Curso
Tutorial
Moez Ali
14 min
Tutorial
Moez Ali
9 min
Tutorial
Kevin Babitz
8 min
Tutorial
Moez Ali
12 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Kurtis Pykes
11 min


