Corso
Introduzione a Python
4 ore
7M
In due articoli precedenti ho esplorato il ruolo del preprocessing dei dati nella pipeline di machine learning. In particolare, ho analizzato gli algoritmi k-Nearest Neighbors (k-NN) e regressione logistica e ho visto come il scaling dei dati numerici influenzi fortemente le prestazioni del primo ma non del secondo, misurate per esempio tramite l’accuratezza (vedi Glossario sotto o gli articoli precedenti per le definizioni di scaling, k-NN e altri termini rilevanti). Il vero messaggio da portare a casa è che il preprocessing non avviene nel vuoto: puoi fare preprocessing a più non posso, ma la prova del nove è nel risultato: quanto bene performa poi il tuo modello?
Scalare i dati numerici (cioè moltiplicare tutte le istanze di una variabile per una costante per cambiarne l’intervallo) ha due scopi correlati: i) se le tue misure sono in metri e le mie in miglia, allora, se entrambi scaliamo i dati, finiscono per essere confrontabili & ii) se due variabili hanno intervalli molto diversi, quella con l’intervallo maggiore può dominare il tuo modello predittivo, anche se potrebbe essere meno importante per la variabile target rispetto a quella con l’intervallo minore. Abbiamo visto che questo problema identificato in ii) si manifesta con k-NN, che guarda esplicitamente a quanto i dati siano vicini tra loro, ma non nella regressione logistica che, durante l’addestramento, ridimensiona il coefficiente rilevante per compensare la mancanza di scaling.
Poiché i dati usati negli articoli precedenti erano dati del mondo reale, tutto ciò che potevamo osservare era come i modelli performavano prima e dopo lo scaling. Qui, per vedere come il rumore sotto forma di variabili di disturbo (cioè quelle che non influenzano la variabile target ma possono influenzare il tuo modello) cambi le prestazioni del modello sia prima che dopo lo scaling, sintetizzerò un dataset in cui posso controllare la natura precisa della variabile di disturbo. Vedremo che più i dati sintetizzati sono rumorosi, più lo scaling sarà importante per k-NN. Tutti gli esempi qui sono in Python. Se non conosci Python, puoi dare un’occhiata ai nostri corsi DataCamp qui. Userò le librerie pandas per le esigenze sui DataFrame e scikit-learn per le esigenze di machine learning.
Nel blocco di codice qui sotto, usiamo la funzione make_blobs di scikit-learn per generare 2000 punti dati disposti in 4 cluster (ogni punto dati ha 2 variabili predittive e 1 variabile target).
# Generate some clustered data (blobs!)
import numpy as np
from sklearn.datasets.samples_generator import make_blobs
n_samples=2000
X, y = make_blobs(n_samples, centers=4, n_features=2,
random_state=0)Ora rappresenteremo nel piano i dati che abbiamo sintetizzato. Ogni asse è una variabile predittiva e il colore fa da legenda per la variabile target:
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(X[:,0] , X[:,1],  c = y, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.hist(y)
plt.show()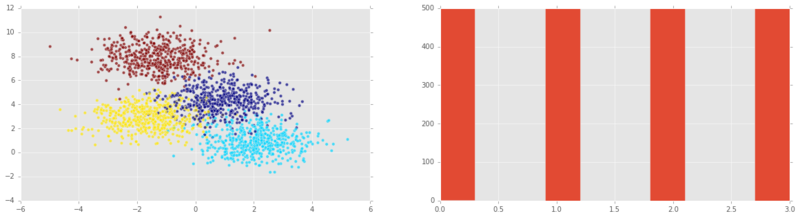
Nota: possiamo vedere nel secondo grafico che tutte le possibili variabili target sono rappresentate in egual misura. In questo caso (o anche se sono approssimativamente bilanciate), diciamo che la classe y è bilanciata.
Ora voglio tracciare gli istogrammi delle feature (variabili predittive):
import pandas as pd
df = pd.DataFrame(X)
pd.DataFrame.hist(df, figsize=(20,5));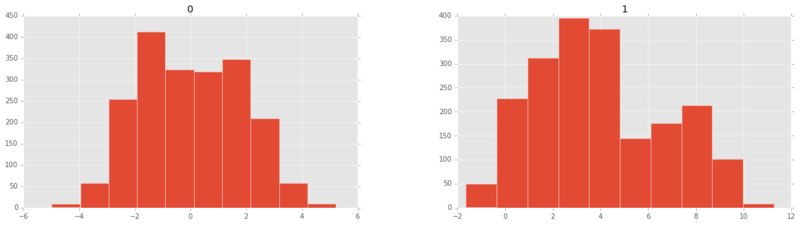
Ora dividiamo in set di test e training e rappresentiamo entrambi i set:
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.title('training set')
plt.scatter(X_train[:,0] , X_train[:,1],  c = y_train, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.scatter(X_test[:,0] , X_test[:,1],  c = y_test, alpha = 0.7);
plt.title('test set')
plt.show()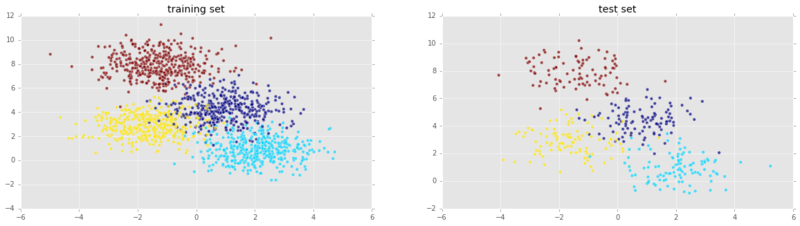
Benissimo! Ora istanziamo un classificatore k-Nearest Neighbors a voto di maggioranza e addestriamolo sul set di training:
from sklearn import neighbors, linear_model
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(X_train, y_train)
Ora che abbiamo addestrato il modello possiamo applicarlo al set di test e calcolare l’accuratezza:
print('k-NN score for test set: %f' % knn_model.score(X_test, y_test))`k-NN score for test set: 0.935000`Possiamo anche ri-adattarlo al set di training e calcolare l’accuratezza. Ci aspetteremmo che vada meglio sul training che sul test:
print('k-NN score for training set: %f' % knn_model.score(X_train, y_train))`k-NN score for training set: 0.941875`Vale la pena ribadire che il metodo di scoring predefinito per k-NN in scikit-learn è l’accuratezza. Per esplorare altre metriche, possiamo usare anche il classification report di scikit-learn:
from sklearn.metrics import classification_report
y_true, y_pred = y_test, knn_model.predict(X_test)
print(classification_report(y_true, y_pred))
precision recall f1-score support
0 0.87 0.90 0.88 106
1 0.98 0.93 0.95 102
2 0.90 0.92 0.91 100
3 1.00 1.00 1.00 92
avg / total 0.94 0.94 0.94 400Ora scalerò le variabili predittive e poi userò di nuovo k-NN:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(Xs_train[:,0] , Xs_train[:,1],  c = y_train, alpha = 0.7);
plt.title('scaled training set')
plt.subplot(1, 2, 2);
plt.scatter(Xs_test[:,0] , Xs_test[:,1],  c = y_test, alpha = 0.7);
plt.title('scaled test set')
plt.show()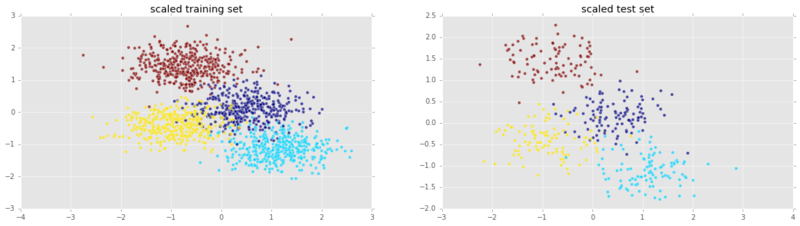
knn_model_s = knn.fit(Xs_train, y_train)
print('k-NN score for test set: %f' % knn_model_s.score(Xs_test, y_test))
`k-NN score for test set: 0.935000`Non performa meglio con lo scaling! Molto probabilmente perché entrambe le feature erano già su intervalli simili. Ha davvero senso scalare quando le variabili hanno intervalli molto diversi. Per vederlo in azione, aggiungeremo un’altra feature. Inoltre, questa feature non avrà alcuna rilevanza per la variabile target: sarà puro rumore.
Aggiungiamo una terza variabile di rumore gaussiano con media 0 e deviazione standard variabile \(\sigma\). Chiameremo \(\sigma\) l’intensità del rumore e vedremo che più il rumore è forte, peggiori saranno le prestazioni dei k-Nearest Neighbours.
# Add noise column to predictor variables
ns = 10**(3) # Strength of noise term
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Ora useremo il pacchetto mplot3d per rappresentare i dati 3D:
from mpl_toolkits.mplot3d import Axes3D
fig = plt.figure(figsize=(15,10));
ax = fig.add_subplot(111, projection='3d' , alpha = 0.5);
ax.scatter(Xn[:,0], Xn[:,1], Xn[:,2], c = y);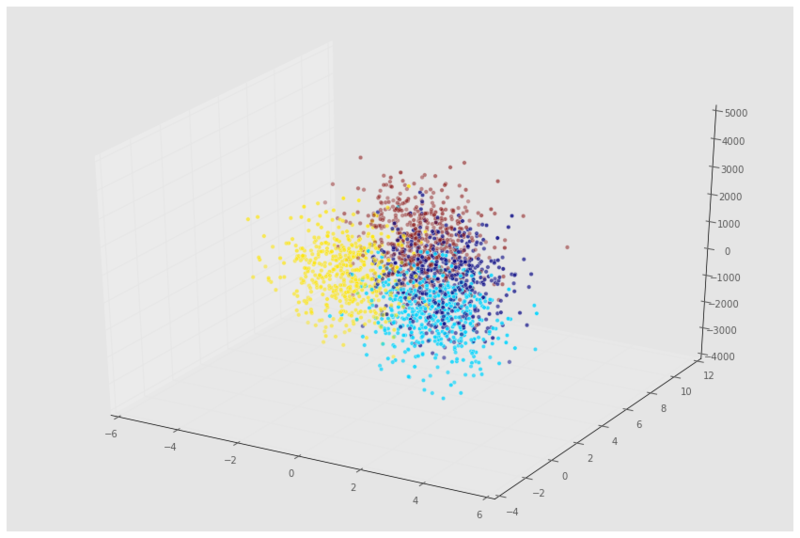
Vediamo ora come performa il nostro modello sui nuovi dati:
Xn_train, Xn_test, y_train, y_test = train_test_split(Xn, y, test_size=0.2, random_state=42)
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(Xn_train, y_train)
print('k-NN score for test set: %f' % knn_model.score(Xn_test, y_test))
k-NN score for test set: 0.400000
Questo è un modello pessimo! E se scalassimo e verificassimo le prestazioni?
Xns = scale(Xn)
s = int(.2*n_samples)
Xns_train = Xns[s:]
y_train = y[s:]
Xns_test = Xns[:s]
y_test = y[:s]
knn = neighbors.KNeighborsClassifier()
knn_models = knn.fit(Xns_train, y_train)
print('k-NN score for test set: %f' % knn_models.score(Xns_test, y_test))
`k-NN score for test set: 0.907500`Ottimo, quindi dopo aver scalato i dati, il modello performa quasi come se non fosse stato introdotto alcun rumore. Ora vediamo le prestazioni del modello in funzione dell’intensità del rumore.
Ora vedremo come l’intensità del rumore influisce sull’accuratezza del modello. Dato che dovremo usare più volte lo stesso codice, impacchettiamo le parti principali in una piccola funzione:
def accu( X, y):
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    knn = neighbors.KNeighborsClassifier()
    knn_model = knn.fit(X_train, y_train)
    return(knn_model.score(X_test, y_test))
noise = [10**i for i in np.arange(-1,6)]
A1 = np.zeros(len(noise))
A2 = np.zeros(len(noise))
count = 0
for ns in noise:
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Xns = scale(Xn)
A1[count] = accu( Xn, y)
A2[count] = accu( Xns, y)
count += 1Ora tracciamo l’accuratezza in funzione dell’intensità del rumore (nota l’asse x in scala logaritmica):
plt.scatter( noise, A1 )
plt.plot( noise, A1, label = 'unscaled', linewidth = 2)
plt.scatter( noise, A2 , c = 'r')
plt.plot( noise, A2 , label = 'scaled', linewidth = 2)
plt.xscale('log')
plt.xlabel('Noise strength')
plt.ylabel('Accuracy')
plt.legend(loc=3);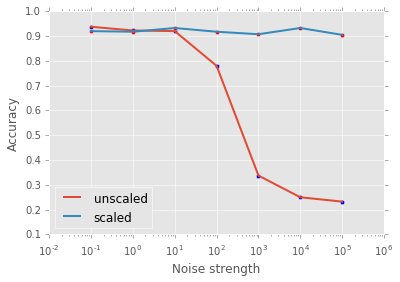
Come vedi nella figura sopra, più rumore c’è nella variabile di disturbo, più è importante scalare i dati per il modello k-NN! Qui sotto avrai l’opportunità di fare lo stesso con la regressione logistica. In conclusione, abbiamo visto il ruolo essenziale ricoperto dal preprocessing nella pipeline di data science, nelle sue forme di scaling e centering, e lo abbiamo fatto per promuovere un approccio olistico alle sfide del machine learning. In futuri articoli, spero di estendere questa discussione ad altri tipi di preprocessing, come le trasformazioni dei dati numerici e il preprocessing dei dati categorici, entrambi aspetti fondamentali del toolkit di ogni data scientist.
Esercizio per chi vuole approfondire: prova a adattare un modello di regressione logistica ai dataset sintetizzati sopra e verifica le prestazioni del modello. Com’è l’accuratezza in funzione dell’intensità del rumore, rispettivamente per dati scalati e non scalati? Puoi farlo nel widget DataCamp Light qui sotto! Modifica l’esponente di 10 per variare la quantità di rumore (prova prima l’intervallo che ho usato sopra per k-NN) e imposta sc = True se vuoi scalare le feature. Puoi anche dare un’occhiata a DataCamp Light su Github!
Apprendimento supervisionato: Il compito di inferire una variabile target a partire da variabili predittive. Per esempio, inferire la variabile target “presenza di malattia cardiaca” da variabili predittive come “età”, “sesso” e “fumatore”.
Task di classificazione: Un compito di apprendimento supervisionato è un task di classificazione se la variabile target è composta da categorie (ad es. “click” o “no”, “maligno” o “benigno” per un tumore).
Task di regressione: Un compito di apprendimento supervisionato è un task di regressione se la variabile target è una variabile a variazione continua (ad es. il prezzo di una casa) o una variabile categoriale ordinata come “valutazione della qualità del vino”.
k-Nearest Neighbors: Un algoritmo per task di classificazione, in cui a un punto dati viene assegnata l’etichetta decisa dal voto di maggioranza dei suoi k vicini più prossimi.
Preprocessing: Qualsiasi insieme di operazioni che i data scientist usano per portare i dati in una forma più adatta a ciò che vogliono farci. Per esempio, prima di eseguire l’analisi del sentiment su dati di Twitter, potresti voler rimuovere eventuali tag HTML, spazi bianchi, espandere le abbreviazioni e suddividere i tweet nelle liste di parole che contengono.
Centering e Scaling: Entrambe sono forme di preprocessing di dati numerici, cioè dati costituiti da numeri, in contrasto con categorie o stringhe, per esempio; il centering di una variabile consiste nel sottrarre la media della variabile da ogni punto dati così che la media della nuova variabile sia 0; lo scaling di una variabile consiste nel moltiplicare ogni punto dati per una costante per modificarne l’intervallo. Vedi il corpo dell’articolo per l’importanza di questi passaggi, con esempi.
Questo articolo è stato generato da un notebook Jupyter. Puoi scaricare il notebook qui.
Corsi Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



