Kurs
Einführung in Python
4 Std.
7M
In zwei früheren Beiträgen habe ich die Rolle der Datenvorverarbeitung in der Machine-Learning-Pipeline beleuchtet. Konkret habe ich die Algorithmen k-Nearest Neighbors (k-NN) und logistische Regression betrachtet und gezeigt, dass die Skalierung numerischer Daten die Performance des ersten, gemessen etwa an der Accuracy (siehe Glossar unten bzw. frühere Artikel für Definitionen von Skalierung, k-NN und weiteren Begriffen), deutlich beeinflusst, nicht jedoch die des zweiten. Die eigentliche Erkenntnis: Vorverarbeitung passiert nicht im luftleeren Raum. Du kannst deine Daten bis ins Detail vorbereiten – entscheidend ist am Ende, wie gut dein Modell tatsächlich performt.
Die Skalierung numerischer Daten (also das Multiplizieren aller Ausprägungen einer Variablen mit einer Konstante, um deren Wertebereich zu verändern) verfolgt zwei verwandte Ziele: i) Wenn deine Messungen in Metern und meine in Meilen vorliegen, erhalten wir durch Skalierung vergleichbare Daten & ii) Haben zwei Variablen sehr unterschiedliche Wertebereiche, kann die mit dem größeren Bereich dein Vorhersagemodell dominieren, obwohl sie für die Zielvariable weniger wichtig ist als die Variable mit kleinerem Bereich. Wir haben gesehen, dass dieses Problem aus ii) bei k-NN auftritt, das explizit Datenähnlichkeiten berücksichtigt, nicht jedoch bei der logistischen Regression, die beim Training den entsprechenden Koeffizienten verkleinert und so fehlende Skalierung teilweise ausgleicht.
Da wir in den vorigen Artikeln mit Realweltdaten gearbeitet haben, konnten wir nur beobachten, wie die Modelle vor und nach dem Skalieren abschneiden. Um nun zu sehen, wie sich Rauschen in Form von Störvariablen (die die Zielvariable nicht beeinflussen, aber dein Modell beeinflussen können) auf die Modellleistung vor und nach dem Skalieren auswirkt, synthese ich ein Dataset, in dem ich die exakte Natur der Störvariablen kontrolliere. Wir werden sehen: Je „rauschiger“ die synthetischen Daten, desto wichtiger ist das Skalieren für k-NN. Alle Beispiele sind in Python. Wenn du Python noch nicht kennst, findest du unsere DataCamp-Kurse hier. Ich verwende die Bibliotheken pandas für DataFrames und scikit-learn für Machine Learning.
Im folgenden Code-Block nutzen wir die make_blobs-Funktion von scikit-learn, um 2000 Datenpunkte in 4 Clustern zu erzeugen (jeder Datenpunkt hat 2 Prädiktorvariablen und 1 Zielvariable).
# Generate some clustered data (blobs!)
import numpy as np
from sklearn.datasets.samples_generator import make_blobs
n_samples=2000
X, y = make_blobs(n_samples, centers=4, n_features=2,
random_state=0)Wir zeichnen die synthetischen Daten nun in der Ebene. Jede Achse ist eine Prädiktorvariable, die Farbe steht für die Zielvariable:
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(X[:,0] , X[:,1],  c = y, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.hist(y)
plt.show()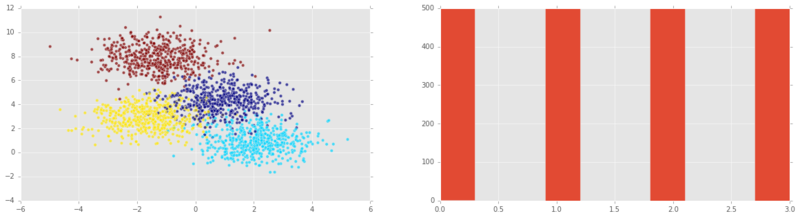
Hinweis: Im zweiten Plot sehen wir, dass alle möglichen Zielklassen gleich stark vertreten sind. In diesem Fall (oder auch bei annähernd gleicher Verteilung) sagen wir, dass die Klasse y ausgewogen ist.
Als Nächstes möchte ich Histogramme der Features (Prädiktorvariablen) darstellen:
import pandas as pd
df = pd.DataFrame(X)
pd.DataFrame.hist(df, figsize=(20,5));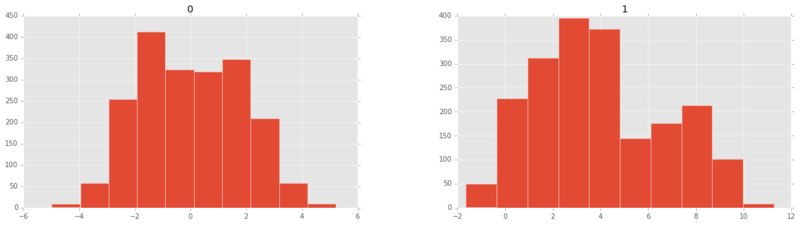
Jetzt teilen wir in Trainings- und Testset und plotten beide:
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.title('training set')
plt.scatter(X_train[:,0] , X_train[:,1],  c = y_train, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.scatter(X_test[:,0] , X_test[:,1],  c = y_test, alpha = 0.7);
plt.title('test set')
plt.show()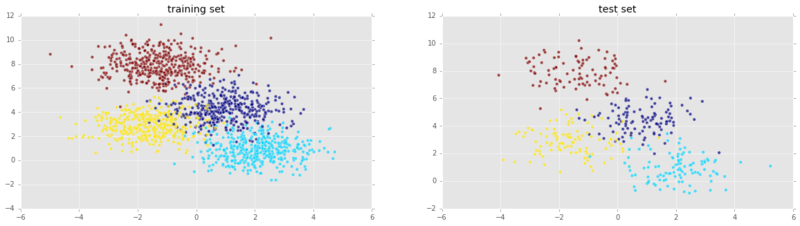
Sieht gut aus! Jetzt instanziieren wir einen k-Nearest-Neighbors-Voting-Classifier und trainieren ihn auf dem Trainingsset:
from sklearn import neighbors, linear_model
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(X_train, y_train)
Nun, da das Modell trainiert ist, wenden wir es auf das Testset an und berechnen die Accuracy:
print('k-NN score for test set: %f' % knn_model.score(X_test, y_test))`k-NN score for test set: 0.935000`Wir können es auch erneut auf das Trainingsset fitten und die Accuracy berechnen. Wir erwarten eine bessere Performance auf dem Trainings- als auf dem Testset:
print('k-NN score for training set: %f' % knn_model.score(X_train, y_train))`k-NN score for training set: 0.941875`Zur Erinnerung: Die Standardmetrik für k-NN in scikit-learn ist die Accuracy. Für weitere Metriken nutzen wir zusätzlich den Classification Report von scikit-learn:
from sklearn.metrics import classification_report
y_true, y_pred = y_test, knn_model.predict(X_test)
print(classification_report(y_true, y_pred))
precision recall f1-score support
0 0.87 0.90 0.88 106
1 0.98 0.93 0.95 102
2 0.90 0.92 0.91 100
3 1.00 1.00 1.00 92
avg / total 0.94 0.94 0.94 400Ich skaliere nun die Prädiktorvariablen und verwende erneut k-NN:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(Xs_train[:,0] , Xs_train[:,1],  c = y_train, alpha = 0.7);
plt.title('scaled training set')
plt.subplot(1, 2, 2);
plt.scatter(Xs_test[:,0] , Xs_test[:,1],  c = y_test, alpha = 0.7);
plt.title('scaled test set')
plt.show()
knn_model_s = knn.fit(Xs_train, y_train)
print('k-NN score for test set: %f' % knn_model_s.score(Xs_test, y_test))
`k-NN score for test set: 0.935000`Mit Skalierung ist es nicht besser! Das liegt sehr wahrscheinlich daran, dass beide Features ohnehin ähnliche Wertebereiche hatten. Skalieren lohnt sich vor allem, wenn Variablen stark unterschiedliche Skalen haben. Um das zu demonstrieren, fügen wir ein weiteres Feature hinzu – eines, das keinerlei Bezug zur Zielvariable hat: reines Rauschen.
Wir fügen eine dritte Variable mit gausschem Rauschen und Mittelwert 0 sowie variabler Standardabweichung \(\sigma\) hinzu. Wir bezeichnen \(\sigma\) als Rauschstärke und werden sehen: Je stärker das Rauschen, desto schlechter performt k-Nearest Neighbours.
# Add noise column to predictor variables
ns = 10**(3) # Strength of noise term
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Wir plotten die 3D-Daten nun mit dem mplot3d-Package:
from mpl_toolkits.mplot3d import Axes3D
fig = plt.figure(figsize=(15,10));
ax = fig.add_subplot(111, projection='3d' , alpha = 0.5);
ax.scatter(Xn[:,0], Xn[:,1], Xn[:,2], c = y);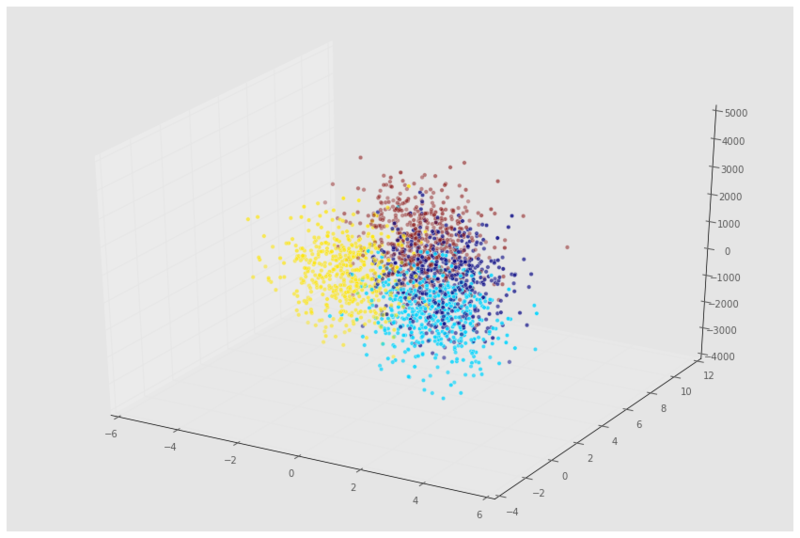
Schauen wir uns an, wie das Modell auf den neuen Daten abschneidet:
Xn_train, Xn_test, y_train, y_test = train_test_split(Xn, y, test_size=0.2, random_state=42)
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(Xn_train, y_train)
print('k-NN score for test set: %f' % knn_model.score(Xn_test, y_test))
k-NN score for test set: 0.400000
Das ist ein grottiges Modell! Wie sieht es nach Skalierung aus?
Xns = scale(Xn)
s = int(.2*n_samples)
Xns_train = Xns[s:]
y_train = y[s:]
Xns_test = Xns[:s]
y_test = y[:s]
knn = neighbors.KNeighborsClassifier()
knn_models = knn.fit(Xns_train, y_train)
print('k-NN score for test set: %f' % knn_models.score(Xns_test, y_test))
`k-NN score for test set: 0.907500`Super: Nach dem Skalieren performt das Modell fast so gut, als hätten wir gar kein Rauschen hinzugefügt. Als Nächstes betrachten wir die Modellleistung in Abhängigkeit von der Rauschstärke.
Wir untersuchen nun, wie sich die Rauschstärke auf die Accuracy auswirkt. Da wir denselben Code mehrfach brauchen, kapseln wir die Kernschritte in eine kleine Funktion:
def accu( X, y):
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    knn = neighbors.KNeighborsClassifier()
    knn_model = knn.fit(X_train, y_train)
    return(knn_model.score(X_test, y_test))
noise = [10**i for i in np.arange(-1,6)]
A1 = np.zeros(len(noise))
A2 = np.zeros(len(noise))
count = 0
for ns in noise:
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Xns = scale(Xn)
A1[count] = accu( Xn, y)
A2[count] = accu( Xns, y)
count += 1Wir plotten nun die Accuracy in Abhängigkeit von der Rauschstärke (x-Achse logarithmisch):
plt.scatter( noise, A1 )
plt.plot( noise, A1, label = 'unscaled', linewidth = 2)
plt.scatter( noise, A2 , c = 'r')
plt.plot( noise, A2 , label = 'scaled', linewidth = 2)
plt.xscale('log')
plt.xlabel('Noise strength')
plt.ylabel('Accuracy')
plt.legend(loc=3);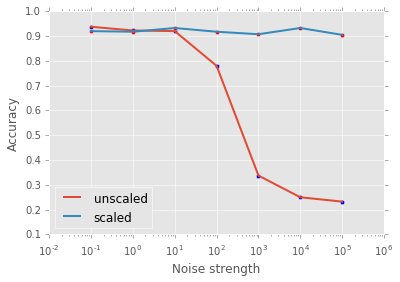
Die Abbildung zeigt: Je mehr Rauschen in der Störvariable, desto wichtiger ist das Skalieren der Daten für das k-NN-Modell! Unten hast du die Gelegenheit, dasselbe für die logistische Regression auszuprobieren. Zusammenfassend haben wir gesehen, welchen zentralen Platz die Vorverarbeitung in der Data-Science-Pipeline einnimmt – insbesondere in Form von Skalierung und Zentrierung – und damit einen ganzheitlichen Blick auf die ML-Herausforderungen gefördert. In künftigen Artikeln werde ich andere Arten der Vorverarbeitung beleuchten, etwa Transformationen numerischer Daten und die Vorverarbeitung kategorialer Daten – beides essenzielle Bausteine im Werkzeugkasten jeder Data Scientist.
Übung für Neugierige: Fitte eine logistische Regression auf die obigen synthetischen Datasets und prüfe die Modellleistung. Wie verhält sich die Accuracy als Funktion der Rauschstärke – jeweils für skalierte und unskalierte Daten? Du kannst das im DataCamp-Light-Widget unten ausprobieren! Ändere den Zehnerexponenten, um die Rauschmenge zu variieren (probiere zuerst den Bereich aus, den ich oben für k-NN genutzt habe), und setze sc = True, wenn du deine Features skalieren möchtest. Schau dir auch DataCamp Light auf Github an!
Überwachtes Lernen (Supervised Learning): Die Aufgabe, aus Prädiktorvariablen auf eine Zielvariable zu schließen. Beispiel: Vorhersage der Zielvariable „Herzerkrankung vorhanden“ aus Prädiktorvariablen wie „Alter“, „Geschlecht“ und „Raucherstatus“.
Klassifikationsaufgabe: Eine Aufgabe des überwachten Lernens ist eine Klassifikationsaufgabe, wenn die Zielvariable aus Kategorien besteht (z. B. „Klick“ oder „kein Klick“, „bösartig“ oder „gutartig“ bei Tumoren).
Regressionsaufgabe: Eine Aufgabe des überwachten Lernens ist eine Regressionsaufgabe, wenn die Zielvariable stetig ist (z. B. Hauspreis) oder eine geordnete kategoriale Variable wie „Qualitätsbewertung von Wein“.
k-Nearest Neighbors: Ein Algorithmus für Klassifikationsaufgaben, bei dem ein Datenpunkt das Label erhält, das durch Mehrheitsabstimmung seiner k nächsten Nachbarn bestimmt wird.
Vorverarbeitung (Preprocessing): Alle Schritte, mit denen Data Scientists Daten in eine Form bringen, die für das eigentliche Vorhaben besser geeignet ist. Beispiel: Bevor du Sentiment-Analysen für Twitter-Daten durchführst, möchtest du eventuell HTML-Tags und Whitespaces entfernen, Abkürzungen auflösen und Tweets in Wortlisten zerlegen.
Zentrieren und Skalieren: Beides sind Formen der Vorverarbeitung von numerischen Daten, also Daten aus Zahlen im Gegensatz zu Kategorien oder Strings. Zentrieren bedeutet, vom jeweiligen Wert den Mittelwert der Variablen zu subtrahieren, sodass der neue Mittelwert 0 ist. Skalieren bedeutet, jeden Datenpunkt mit einer Konstante zu multiplizieren, um den Wertebereich zu verändern. Warum das wichtig ist, zeigen die Beispiele im Artikel.
Dieser Artikel wurde aus einem Jupyter-Notebook erzeugt. Du kannst das Notebook hier herunterladen.
Python-Kurse
Kurs
Kurs
Kurs