Curso
Introducción a Python
4 h
7M
En dos artículos anteriores, exploré el papel del preprocesamiento de datos en el pipeline de machine learning. En concreto, analicé los algoritmos de k-Nearest Neighbors (k-NN) y regresión logística y vimos cómo escalar datos numéricos influía mucho en el rendimiento del primero, pero no tanto en el del segundo, medido, por ejemplo, con la precisión (consulta el glosario más abajo o los artículos previos para las definiciones de escalado, k-NN y otros términos relevantes). La idea clave aquí es que el preprocesamiento no ocurre en el vacío: puedes preprocesar tus datos todo lo que quieras, pero lo que manda es el resultado: ¿qué tal rinde tu modelo después?
Escalar datos numéricos (es decir, multiplicar todas las instancias de una variable por una constante para cambiar su rango) tiene dos objetivos relacionados: i) si tus medidas están en metros y las mías en millas, al escalar ambos datos acaban estando en la misma escala; y ii) si dos variables tienen rangos muy distintos, la de mayor rango puede dominar tu modelo predictivo, aunque sea menos importante para la variable objetivo que la de menor rango. Vimos que este problema de ii) se da con k-NN, que evalúa explícitamente la cercanía entre datos, pero no con la regresión logística que, durante el entrenamiento, ajusta el coeficiente correspondiente para compensar la falta de escalado.
Como los datos que usamos en los artículos anteriores eran datos reales, solo pudimos observar cómo rendían los modelos antes y después de escalar. Aquí, para ver cómo el ruido en forma de variables molestas (las que no afectan a la variable objetivo pero sí pueden afectar a tu modelo) cambia el rendimiento tanto antes como después de escalar, voy a sintetizar un conjunto de datos en el que pueda controlar la naturaleza exacta de esa variable molesta. Veremos que cuanto más ruidosos sean los datos sintetizados, más importante será escalar para k-NN. Todos los ejemplos estarán en Python. Si no te manejas con Python, puedes echar un vistazo a nuestros cursos de DataCamp aquí. Utilizaré las librerías pandas para trabajar con DataFrames y scikit-learn para las tareas de machine learning.
En el bloque de código siguiente, usamos la función make_blobs de scikit-learn para generar 2000 puntos en 4 clústeres (cada punto tiene 2 variables predictoras y 1 variable objetivo).
# Generate some clustered data (blobs!)
import numpy as np
from sklearn.datasets.samples_generator import make_blobs
n_samples=2000
X, y = make_blobs(n_samples, centers=4, n_features=2,
random_state=0)Ahora vamos a representar en el plano los datos que hemos sintetizado. Cada eje es una variable predictora y el color indica la variable objetivo:
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(X[:,0] , X[:,1],  c = y, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.hist(y)
plt.show()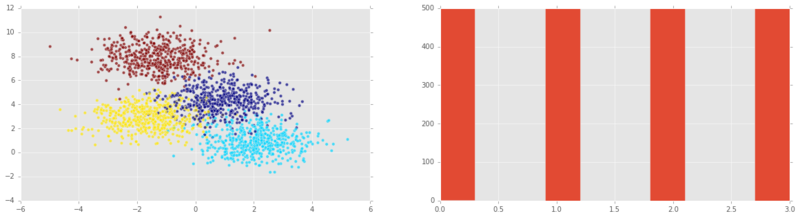
Nota: en el segundo gráfico vemos que todas las clases objetivo están igualmente representadas. En este caso (o incluso si están aproximadamente equilibradas) decimos que la clase y está balanceada.
Ahora quiero representar histogramas de las variables (predictoras):
import pandas as pd
df = pd.DataFrame(X)
pd.DataFrame.hist(df, figsize=(20,5));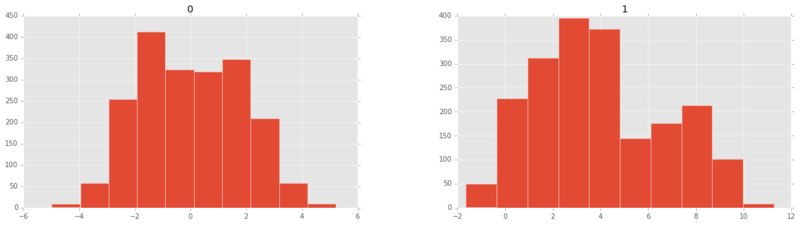
Vamos a dividir ahora en conjuntos de entrenamiento y de prueba y a representarlos:
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.title('training set')
plt.scatter(X_train[:,0] , X_train[:,1],  c = y_train, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.scatter(X_test[:,0] , X_test[:,1],  c = y_test, alpha = 0.7);
plt.title('test set')
plt.show()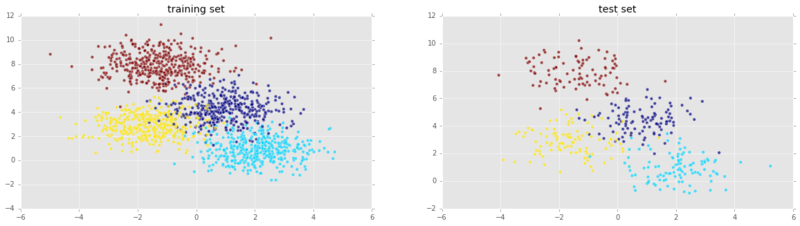
¡Buena pinta! Ahora vamos a instanciar un clasificador de votación k-Nearest Neighbors y entrenarlo con el conjunto de entrenamiento:
from sklearn import neighbors, linear_model
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(X_train, y_train)
Con el modelo entrenado, podemos ajustarlo al conjunto de prueba y calcular la precisión:
print('k-NN score for test set: %f' % knn_model.score(X_test, y_test))`k-NN score for test set: 0.935000`También podemos volver a ajustarlo al conjunto de entrenamiento y calcular la precisión. Esperamos que rinda mejor en entrenamiento que en prueba:
print('k-NN score for training set: %f' % knn_model.score(X_train, y_train))`k-NN score for training set: 0.941875`Conviene recordar que el método de evaluación por defecto de k-NN en scikit-learn es la precisión. Para consultar otras métricas, también podemos usar el classification report de scikit-learn:
from sklearn.metrics import classification_report
y_true, y_pred = y_test, knn_model.predict(X_test)
print(classification_report(y_true, y_pred))
precision recall f1-score support
0 0.87 0.90 0.88 106
1 0.98 0.93 0.95 102
2 0.90 0.92 0.91 100
3 1.00 1.00 1.00 92
avg / total 0.94 0.94 0.94 400Voy a escalar las variables predictoras y volver a usar k-NN:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(Xs_train[:,0] , Xs_train[:,1],  c = y_train, alpha = 0.7);
plt.title('scaled training set')
plt.subplot(1, 2, 2);
plt.scatter(Xs_test[:,0] , Xs_test[:,1],  c = y_test, alpha = 0.7);
plt.title('scaled test set')
plt.show()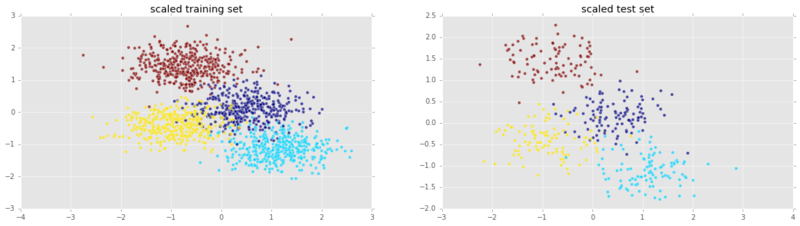
knn_model_s = knn.fit(Xs_train, y_train)
print('k-NN score for test set: %f' % knn_model_s.score(Xs_test, y_test))
`k-NN score for test set: 0.935000`¡No rinde mejor con escalado! Probablemente porque ambas características ya estaban en rangos similares. Tiene sentido escalar cuando las variables tienen rangos muy distintos. Para verlo en acción, vamos a añadir otra característica. Además, esta no tendrá ninguna relación con la variable objetivo: será puro ruido.
Añadimos una tercera variable de ruido gaussiano con media 0 y desviación estándar variable \(\sigma\). Llamaremos a \(\sigma\) la intensidad del ruido y veremos que cuanto mayor sea el ruido, peor será el rendimiento de k-Nearest Neighbours.
# Add noise column to predictor variables
ns = 10**(3) # Strength of noise term
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Ahora usaremos el paquete mplot3d para representar los datos en 3D:
from mpl_toolkits.mplot3d import Axes3D
fig = plt.figure(figsize=(15,10));
ax = fig.add_subplot(111, projection='3d' , alpha = 0.5);
ax.scatter(Xn[:,0], Xn[:,1], Xn[:,2], c = y);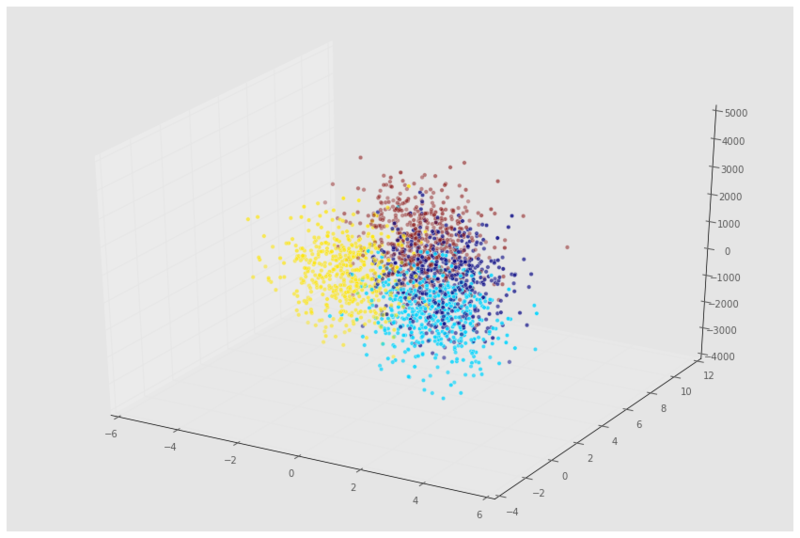
Veamos ahora cómo rinde el modelo con los nuevos datos:
Xn_train, Xn_test, y_train, y_test = train_test_split(Xn, y, test_size=0.2, random_state=42)
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(Xn_train, y_train)
print('k-NN score for test set: %f' % knn_model.score(Xn_test, y_test))
k-NN score for test set: 0.400000
¡Este modelo es malísimo! ¿Y si escalamos y comprobamos el rendimiento?
Xns = scale(Xn)
s = int(.2*n_samples)
Xns_train = Xns[s:]
y_train = y[s:]
Xns_test = Xns[:s]
y_test = y[:s]
knn = neighbors.KNeighborsClassifier()
knn_models = knn.fit(Xns_train, y_train)
print('k-NN score for test set: %f' % knn_models.score(Xns_test, y_test))
`k-NN score for test set: 0.907500`Genial, tras escalar los datos, el modelo rinde casi tan bien como si no hubiéramos introducido ruido. Ahora vamos a ver el rendimiento del modelo en función de la intensidad del ruido.
Ahora veremos cómo afecta la intensidad del ruido a la precisión del modelo. Como necesitaremos reutilizar el mismo código varias veces, vamos a encapsular las partes principales en una pequeña función:
def accu( X, y):
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    knn = neighbors.KNeighborsClassifier()
    knn_model = knn.fit(X_train, y_train)
    return(knn_model.score(X_test, y_test))
noise = [10**i for i in np.arange(-1,6)]
A1 = np.zeros(len(noise))
A2 = np.zeros(len(noise))
count = 0
for ns in noise:
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Xns = scale(Xn)
A1[count] = accu( Xn, y)
A2[count] = accu( Xns, y)
count += 1Ahora representamos la precisión en función de la intensidad del ruido (eje x en escala logarítmica):
plt.scatter( noise, A1 )
plt.plot( noise, A1, label = 'unscaled', linewidth = 2)
plt.scatter( noise, A2 , c = 'r')
plt.plot( noise, A2 , label = 'scaled', linewidth = 2)
plt.xscale('log')
plt.xlabel('Noise strength')
plt.ylabel('Accuracy')
plt.legend(loc=3);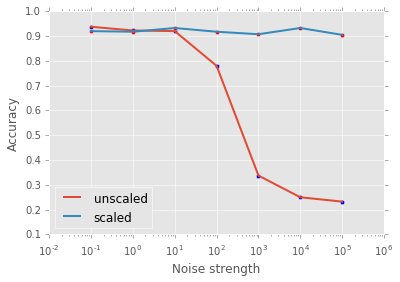
En la figura anterior se aprecia que cuanto más ruido hay en la variable molesta, más importante es escalar los datos para el modelo k-NN. A continuación tendrás la oportunidad de hacer lo mismo con regresión logística. Para terminar, hemos visto el lugar esencial que ocupa el preprocesamiento en el pipeline de ciencia de datos, en su vertiente de escalado y centrado, y lo hemos hecho para impulsar un enfoque holístico a los retos del machine learning. En futuros artículos, espero ampliar este debate a otros tipos de preprocesamiento, como transformaciones de datos numéricos y preprocesamiento de datos categóricos, ambos aspectos fundamentales del conjunto de herramientas de cualquier data scientist.
Ejercicio para quien quiera profundizar: prueba a ajustar un modelo de regresión logística a los conjuntos de datos sintetizados anteriores y comprueba el rendimiento. ¿Cómo varía la precisión en función de la intensidad del ruido para datos escalados y sin escalar, respectivamente? ¡Puedes hacerlo en el widget de DataCamp Light de abajo! Cambia el exponente de 10 para variar la cantidad de ruido (prueba primero el rango que usé arriba para k-NN) y pon sc = True si quieres escalar tus características. También puedes consultar DataCamp Light en Github.
Aprendizaje supervisado: tarea de inferir una variable objetivo a partir de variables predictoras. Por ejemplo, inferir la variable objetivo «presencia de enfermedad cardiaca» a partir de variables predictoras como «edad», «sexo» y «fumador/no fumador».
Tarea de clasificación: una tarea de aprendizaje supervisado es de clasificación si la variable objetivo consiste en categorías (p. ej., «clic» o «no clic», «tumor maligno» o «benigno»).
Tarea de regresión: una tarea de aprendizaje supervisado es de regresión si la variable objetivo es continua (p. ej., el precio de una vivienda) o una variable categórica ordenada como la «calidad de un vino».
k-Nearest Neighbors: algoritmo para tareas de clasificación en el que a un punto de datos se le asigna la etiqueta decidida por la mayoría de sus k vecinos más cercanos.
Preprocesamiento: conjunto de operaciones que usan los data scientists para dejar los datos en una forma más adecuada para su objetivo. Por ejemplo, antes de realizar análisis de sentimiento de datos de Twitter, puede interesarte eliminar etiquetas HTML, espacios en blanco, expandir abreviaturas y dividir los tuits en listas de palabras.
Centrado y escalado: ambas son formas de preprocesar datos numéricos, es decir, datos que son números, frente a categorías o cadenas; centrar una variable consiste en restar la media a cada punto de datos para que la nueva variable tenga media 0; escalar una variable consiste en multiplicar cada punto de datos por una constante para modificar el rango de los datos. Consulta el cuerpo del artículo para ver su importancia, con ejemplos.
Este artículo se generó a partir de un cuaderno de Jupyter. Puedes descargarlo aquí.
Curso
Curso
Curso
Tutorial
Moez Ali
14 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Moez Ali
9 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Kevin Babitz
8 min
Tutorial
Moez Ali
12 min