कोर्स
Python परिचय
4 घंटा
7.1M
पिछली दो पोस्टों में, मैंने मशीन लर्निंग पाइपलाइन में डेटा के प्रीप्रोसेसिंग की भूमिका पर चर्चा की। खास तौर पर, मैंने k-Nearest Neighbors (k-NN) और लॉजिस्टिक रिग्रेशन एल्गोरिद्म देखे और समझा कि संख्यात्मक डेटा का स्केलिंग पहले वाले के प्रदर्शन को बहुत प्रभावित करता है, पर दूसरे वाले को नहीं — जैसे कि एक्यूरेसी से मापा जाए (स्केलिंग, k-NN और अन्य संबंधित शब्दों की परिभाषाएँ नीचे दिए ग्लॉसरी या पिछली लेखों में देखें)। यहाँ असल सीख यह थी कि प्रीप्रोसेसिंग निर्वात में नहीं होती — आप चाहें जितना डेटा को प्रीप्रोसेस कर लें, असली कसौटी यह है कि आपका मॉडल आखिरकार कितना अच्छा चलता है।
संख्यात्मक डेटा को स्केल करना (अर्थात, किसी चर की सभी प्रविष्टियों को एक स्थिरांक से गुणा करना ताकि उसके मानों की सीमा बदल जाए) दो जुड़े हुए उद्देश्य पूरे करता है: i) अगर आपकी माप मीटर में और मेरी मील में है, तो दोनों के डेटा को स्केल करने पर वे समान पैमाने पर आ जाते हैं, और ii) अगर दो चरों की रेंज बहुत अलग है, तो बड़ी रेंज वाला चर भविष्यवाणी मॉडल पर हावी हो सकता है, भले ही वह लक्ष्य चर के लिए छोटे रेंज वाले चर जितना महत्वपूर्ण न हो। हमने देखा कि ii) में बताई समस्या k-NN में आती है, जो साफ़ तौर पर डेटा बिंदुओं की आपसी निकटता देखता है, पर लॉजिस्टिक रिग्रेशन में नहीं, क्योंकि उसका प्रशिक्षण संबंधित गुणांक को इस कमी (स्केलिंग न होने) की भरपाई के लिए सिकोड़ देता है।
पिछले लेखों में हमने वास्तविक-विश्व डेटा इस्तेमाल किया था, इसलिए हम केवल इतना देख पाए कि स्केलिंग से पहले और बाद में मॉडल कैसे चलते हैं। यहाँ, गड़बड़ी (nuisance) चरों के रूप में शोर — जो लक्ष्य चर को प्रभावित नहीं करते, पर आपके मॉडल को कर सकते हैं — का मॉडल प्रदर्शन पर स्केलिंग से पहले और बाद में क्या असर पड़ता है, यह देखने के लिए मैं एक ऐसा डेटासेट सिंथेसाइज़ करूँगा जिसमें मैं गड़बड़ी चर की प्रकृति को नियंत्रित कर सकूँ। हम देखेंगे कि जितना अधिक सिंथेसाइज़्ड डेटा शोरयुक्त होगा, k-NN के लिए स्केलिंग उतनी ही महत्वपूर्ण होगी। नीचे दिए सारे उदाहरण Python में हैं। अगर आप Python से परिचित नहीं हैं, तो हमारे DataCamp के कोर्सेज यहाँ देख सकते हैं। मैं pandas लाइब्रेरी का उपयोग DataFrame के लिए और scikit-learn का उपयोग मशीन लर्निंग के लिए करूँगा।
नीचे के कोड खंड में, हम scikit-learn की make_blobs फ़ंक्शन का उपयोग करके 4 क्लस्टर में 2000 डेटा बिंदु जेनरेट करते हैं (हर डेटा बिंदु में 2 प्रेडिक्टर वेरिएबल और 1 टारगेट वेरिएबल है)।
# Generate some clustered data (blobs!)
import numpy as np
from sklearn.datasets.samples_generator import make_blobs
n_samples=2000
X, y = make_blobs(n_samples, centers=4, n_features=2,
random_state=0)अब हम प्लेन में अपने सिंथेसाइज़ किए गए डेटा को प्लॉट करेंगे। प्रत्येक एक्सिस एक प्रेडिक्टर वेरिएबल है और रंग लक्ष्य वेरिएबल की कुंजी दर्शाता है:
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(X[:,0] , X[:,1],  c = y, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.hist(y)
plt.show()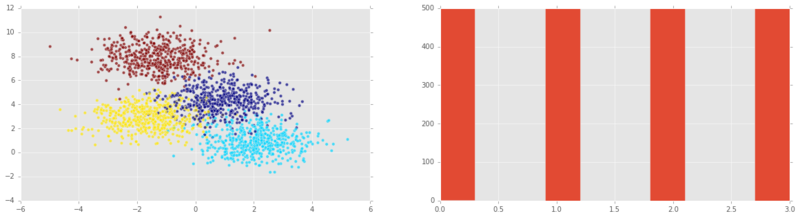
नोट: दूसरे प्लॉट में हम देख सकते हैं कि सभी संभावित लक्ष्य वर्ग समान रूप से प्रस्तुत हैं। इस स्थिति में (या अगर वे लगभग समान हों), हम कहते हैं कि y क्लास बैलेंस्ड है।
अब मैं फीचर्स (प्रेडिक्टर वेरिएबल) के हिस्टोग्राम प्लॉट करना चाहता हूँ:
import pandas as pd
df = pd.DataFrame(X)
pd.DataFrame.hist(df, figsize=(20,5));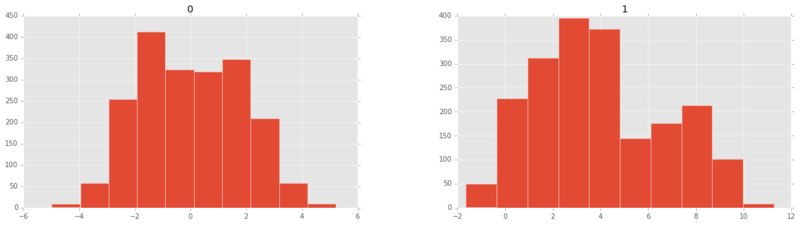
अब टेस्टिंग और ट्रेनिंग सेट में बाँटते हैं और दोनों सेट प्लॉट करते हैं:
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.title('training set')
plt.scatter(X_train[:,0] , X_train[:,1],  c = y_train, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.scatter(X_test[:,0] , X_test[:,1],  c = y_test, alpha = 0.7);
plt.title('test set')
plt.show()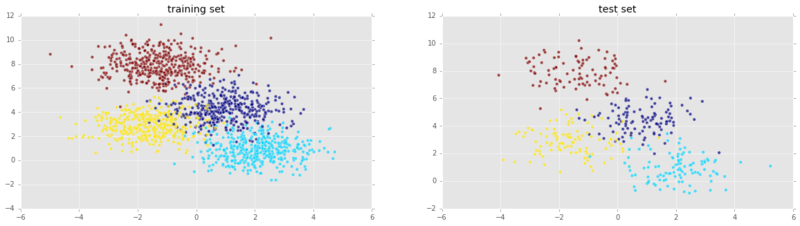
सब ठीक दिख रहा है! अब k-Nearest Neighbors वोटिंग क्लासिफायर को इंस्टैंशिएट करते हैं और उसे अपने ट्रेनिंग सेट पर ट्रेन करते हैं:
from sklearn import neighbors, linear_model
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(X_train, y_train)
अब जब हमारा मॉडल ट्रेन हो गया है, तो हम इसे टेस्ट सेट पर फिट कर के एक्यूरेसी निकाल सकते हैं:
print('k-NN score for test set: %f' % knn_model.score(X_test, y_test))`k-NN score for test set: 0.935000`हम इसे दोबारा ट्रेनिंग सेट पर भी फिट कर एक्यूरेसी निकाल सकते हैं। हमें अपेक्षा है कि ट्रेनिंग सेट पर प्रदर्शन टेस्ट सेट से बेहतर होगा:
print('k-NN score for training set: %f' % knn_model.score(X_train, y_train))`k-NN score for training set: 0.941875`यह दोहराना उपयोगी है कि scikit-learn में k-NN की डिफ़ॉल्ट स्कोरिंग विधि एक्यूरेसी है। अन्य कई मेट्रिक्स देखने के लिए, हम scikit-learn की क्लासिफिकेशन रिपोर्ट भी इस्तेमाल कर सकते हैं:
from sklearn.metrics import classification_report
y_true, y_pred = y_test, knn_model.predict(X_test)
print(classification_report(y_true, y_pred))
precision recall f1-score support
0 0.87 0.90 0.88 106
1 0.98 0.93 0.95 102
2 0.90 0.92 0.91 100
3 1.00 1.00 1.00 92
avg / total 0.94 0.94 0.94 400अब मैं प्रेडिक्टर वेरिएबल्स को स्केल करूँगा और फिर से k-NN का उपयोग करूँगा:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(Xs_train[:,0] , Xs_train[:,1],  c = y_train, alpha = 0.7);
plt.title('scaled training set')
plt.subplot(1, 2, 2);
plt.scatter(Xs_test[:,0] , Xs_test[:,1],  c = y_test, alpha = 0.7);
plt.title('scaled test set')
plt.show()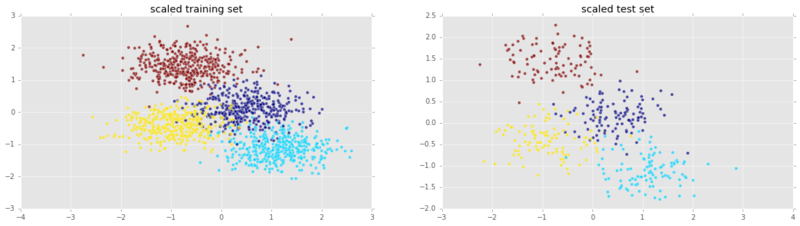
knn_model_s = knn.fit(Xs_train, y_train)
print('k-NN score for test set: %f' % knn_model_s.score(Xs_test, y_test))
`k-NN score for test set: 0.935000`स्केलिंग के साथ प्रदर्शन बेहतर नहीं हुआ! संभवतः इसलिए कि दोनों फीचर्स पहले से ही लगभग समान रेंज में थे। स्केलिंग का मतलब तब ज्यादा बनता है जब चरों की रेंज बहुत अलग-अलग हो। इसे क्रिया में देखने के लिए, हम एक और फीचर जोड़ने जा रहे हैं। साथ ही, यह फीचर लक्ष्य वेरिएबल के लिए कोई प्रासंगिकता नहीं रखेगा: यह शुद्ध शोर होगा।
हम तीसरा वेरिएबल जोड़ते हैं जो गॉसियन शोर है, जिसका माध्य 0 और मानक विचलन \(\sigma\) परिवर्तनीय है। हम \(\sigma\) को शोर की तीव्रता कहेंगे और देखेंगे कि शोर जितना प्रबल होगा, k-Nearest Neighbours का प्रदर्शन उतना ही खराब होगा।
# Add noise column to predictor variables
ns = 10**(3) # Strength of noise term
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
अब हम mplot3d पैकेज का उपयोग करके 3D डेटा प्लॉट करेंगे:
from mpl_toolkits.mplot3d import Axes3D
fig = plt.figure(figsize=(15,10));
ax = fig.add_subplot(111, projection='3d' , alpha = 0.5);
ax.scatter(Xn[:,0], Xn[:,1], Xn[:,2], c = y);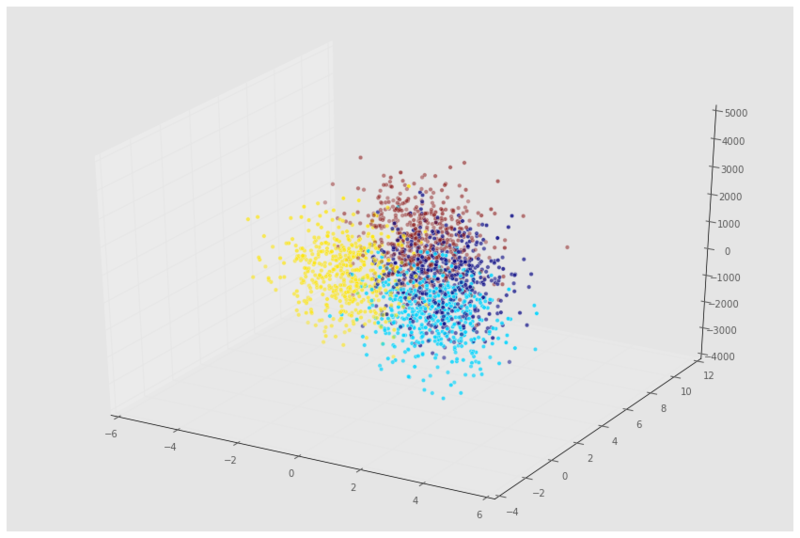
अब देखते हैं कि नया डेटा पर हमारा मॉडल कैसा चलता है:
Xn_train, Xn_test, y_train, y_test = train_test_split(Xn, y, test_size=0.2, random_state=42)
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(Xn_train, y_train)
print('k-NN score for test set: %f' % knn_model.score(Xn_test, y_test))
k-NN score for test set: 0.400000
यह तो बहुत खराब मॉडल है! क्यों न स्केलिंग करके प्रदर्शन देखें?
Xns = scale(Xn)
s = int(.2*n_samples)
Xns_train = Xns[s:]
y_train = y[s:]
Xns_test = Xns[:s]
y_test = y[:s]
knn = neighbors.KNeighborsClassifier()
knn_models = knn.fit(Xns_train, y_train)
print('k-NN score for test set: %f' % knn_models.score(Xns_test, y_test))
`k-NN score for test set: 0.907500`अच्छा हुआ—डेटा को स्केल करने के बाद, मॉडल का प्रदर्शन लगभग उतना ही अच्छा है जितना कि शोर जोड़े बिना था। अब शोर की तीव्रता के फलन के रूप में मॉडल के प्रदर्शन को देखें।
अब हम देखेंगे कि शोर की तीव्रता मॉडल की एक्यूरेसी को कैसे प्रभावित करती है। क्योंकि हमें वही कोड कई बार चलाना होगा, तो मुख्य हिस्सों को एक छोटी फ़ंक्शन में समेट लेते हैं:
def accu( X, y):
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    knn = neighbors.KNeighborsClassifier()
    knn_model = knn.fit(X_train, y_train)
    return(knn_model.score(X_test, y_test))
noise = [10**i for i in np.arange(-1,6)]
A1 = np.zeros(len(noise))
A2 = np.zeros(len(noise))
count = 0
for ns in noise:
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Xns = scale(Xn)
A1[count] = accu( Xn, y)
A2[count] = accu( Xns, y)
count += 1अब हम एक्यूरेसी को शोर की तीव्रता के फलन के रूप में प्लॉट करते हैं (ध्यान दें: x-अक्ष लघुगणकीय है):
plt.scatter( noise, A1 )
plt.plot( noise, A1, label = 'unscaled', linewidth = 2)
plt.scatter( noise, A2 , c = 'r')
plt.plot( noise, A2 , label = 'scaled', linewidth = 2)
plt.xscale('log')
plt.xlabel('Noise strength')
plt.ylabel('Accuracy')
plt.legend(loc=3);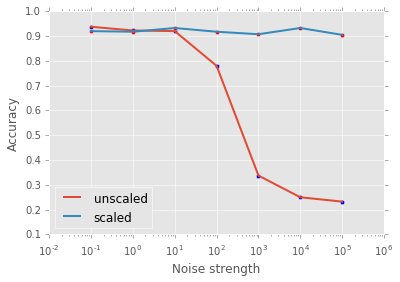
ऊपर के चित्र में देखें कि गड़बड़ी वाले चर में शोर जितना अधिक होगा, k-NN मॉडल के लिए डेटा को स्केल करना उतना ही महत्वपूर्ण होगा! नीचे आपको लॉजिस्टिक रिग्रेशन के लिए भी यही करने का मौका मिलेगा। अंत में, हमने डेटा साइंटिफिक पाइपलाइन में प्रीप्रोसेसिंग — उसके स्केलिंग और सेंटरिंग रूप — की अनिवार्य जगह को देखा है, और ऐसा मशीन लर्निंग की चुनौतियों के समग्र दृष्टिकोण को बढ़ावा देने के लिए किया है। आने वाले लेखों में, मैं इस चर्चा को अन्य प्रकार की प्रीप्रोसेसिंग, जैसे संख्यात्मक डेटा के रूपांतरण और श्रेणीबद्ध डेटा के प्रीप्रोसेसिंग तक बढ़ाने की आशा करता हूँ — जो किसी भी डेटा साइंटिस्ट के टूलकिट के आवश्यक पहलू हैं।
उत्सुक पाठकों के लिए अभ्यास: ऊपर दिए सिंथेसाइज़्ड डेटासेट्स पर एक लॉजिस्टिक रिग्रेशन मॉडल फिट करके मॉडल प्रदर्शन जाँचें। स्केल्ड और अनस्केल्ड डेटा के लिए एक्यूरेसी, शोर की तीव्रता का फलन कैसे है? आप यह नीचे दिए DataCamp Light विजेट में कर सकते हैं! शोर की मात्रा बदलने के लिए 10 के घातांक को बदलें (पहले वह रेंज आज़माएँ जो मैंने ऊपर k-NN के लिए ली थी) और अगर आप अपने फीचर्स को स्केल करना चाहते हैं, तो sc = True सेट करें। आप Github पर DataCamp Light भी देख सकते हैं!
सुपरवाइज़्ड लर्निंग: प्रेडिक्टर वेरिएबल्स से टारगेट वेरिएबल का अनुमान लगाने का कार्य। उदाहरण के लिए, टारगेट वेरिएबल ‘हृदय रोग की उपस्थिति’ का अनुमान ‘आयु’, ‘लिंग’ और ‘धूम्रपान स्थिति’ जैसे प्रेडिक्टर वेरिएबल्स से लगाना।
क्लासिफिकेशन टास्क: कोई सुपरवाइज़्ड लर्निंग कार्य क्लासिफिकेशन टास्क होता है अगर टारगेट वेरिएबल श्रेणियों से बना हो (जैसे ‘क्लिक’ या ‘नहीं’, ‘मैलिग्नेंट’ या ‘बेनाइन’ ट्यूमर)।
रिग्रेशन टास्क: कोई सुपरवाइज़्ड लर्निंग कार्य रिग्रेशन टास्क होता है अगर टारगेट वेरिएबल सतत रूप से बदलने वाला चर हो (जैसे घर की कीमत) या किसी क्रमबद्ध श्रेणीबद्ध चर जैसा ‘वाइन की गुणवत्ता रेटिंग’।
k-Nearest Neighbors: क्लासिफिकेशन टास्क के लिए एक एल्गोरिद्म, जिसमें किसी डेटा बिंदु को उसके k निकटतम पड़ोसियों के बहुमत वोट से तय लेबल सौंपा जाता है।
प्रीप्रोसेसिंग: वे विविध क्रियाएँ जिन्हें डेटा साइंटिस्ट अपने डेटा को उस काम के लिए अधिक उपयुक्त रूप में लाने के लिए करते हैं जो वे करना चाहते हैं। उदाहरण के लिए, ट्विटर डेटा का सेंटिमेंट विश्लेषण करने से पहले आप कोई भी html टैग और अतिरिक्त स्पेसेज़ हटा सकते हैं, संक्षेपों का विस्तार कर सकते हैं और ट्वीट्स को उनमें मौजूद शब्दों की सूचियों में बाँट सकते हैं।
सेंटरिंग और स्केलिंग: ये दोनों संख्यात्मक डेटा के प्रीप्रोसेसिंग के तरीके हैं, यानी ऐसा डेटा जो संख्याओं से बना हो, न कि श्रेणियों या स्ट्रिंग्स से, उदाहरण के लिए; किसी चर का सेंटरिंग मतलब प्रत्येक डेटा बिंदु से उस चर का औसत घटाना ताकि नए चर का औसत 0 हो; किसी चर का स्केलिंग मतलब प्रत्येक डेटा बिंदु को एक स्थिरांक से गुणा करना ताकि डेटा की रेंज बदले। इनके महत्त्व को उदाहरणों सहित लेख के मुख्य भाग में देखें।
यह लेख एक Jupyter नोटबुक से जेनरेट किया गया है। आप नोटबुक को यहाँ से डाउनलोड कर सकते हैं।
Python कोर्स
कोर्स
कोर्स
कोर्स