Kursus
Supervised Learning dengan scikit-learn
4 jam
306K
Mendeteksi apa yang disebut “berita palsu” bukanlah tugas mudah. Pertama, mendefinisikan apa itu berita palsu—mengingat istilah ini kini juga menjadi pernyataan politik. Jika Anda dapat menemukan atau menyepakati definisinya, maka Anda harus mengumpulkan dan memberi label dengan benar untuk berita nyata dan palsu (sebaiknya pada topik serupa agar perbedaannya terlihat jelas). Setelah dikumpulkan, Anda harus menemukan fitur yang berguna untuk membedakan berita palsu dari yang asli.
Untuk tinjauan yang lebih mendalam tentang ruang masalah ini, saya merekomendasikan tulisan Miguel Martinez-Alvarez “How can Machine Learning and AI Help Solve the Fake News Problem”.
Kira-kira pada waktu yang sama saya membaca tulisan Miguel yang penuh wawasan, saya menemukan artikel open data science tentang membangun detektor berita palsu yang sukses dengan model Bayesian. Penulisnya bahkan membuat repositori dengan dataset contoh berita palsu dan nyata yang sudah ditandai. Saya penasaran apakah saya bisa dengan mudah mereproduksi hasilnya, dan apakah saya kemudian bisa mengetahui apa yang dipelajari model tersebut.
Di tutorial ini, Anda akan menelusuri sebagian eksplorasi awal saya dan melihat apakah Anda bisa membangun detektor berita palsu yang berhasil!
Tip: jika Anda ingin mempelajari lebih lanjut dasar-dasar Natural Language Processing (NLP), pertimbangkan untuk mengambil kursus Natural Language Processing Fundamentals in Python.
Untuk memulai, Anda sebaiknya selalu melihat sekilas data dan memahami isinya. Untuk itu, gunakan Pandas DataFrame dan periksa shape, head, serta terapkan transformasi yang diperlukan.
Sekarang setelah DataFrame terlihat lebih sesuai kebutuhan, Anda ingin memisahkan label dan menyiapkan dataset pelatihan serta pengujian.
Untuk notebook ini, saya memutuskan berfokus pada penggunaan teks artikel yang lebih panjang. Karena saya tahu akan menggunakan bag-of-words dan Term Frequency–Inverse Document Frequency (TF-IDF) untuk mengekstrak fitur, ini tampak seperti pilihan yang baik. Menggunakan teks yang lebih panjang semoga memungkinkan adanya kata dan fitur yang berbeda untuk data berita nyata dan palsu saya.
Sekarang setelah Anda memiliki data pelatihan dan pengujian, Anda dapat membangun pengklasifikasi. Untuk mengetahui apakah kata dan token dalam artikel berdampak signifikan pada status berita palsu atau asli, Anda mulai dengan menggunakan CountVectorizer dan TfidfVectorizer.
Anda akan melihat contoh memiliki ambang maksimum diatur pada .7 untuk vektorisasi TF-IDF tfidf_vectorizer menggunakan argumen max_df. Ini menghapus kata yang muncul di lebih dari 70% artikel. Selain itu, parameter stop_words bawaan akan menghapus stop words bahasa Inggris dari data sebelum membuat vektor.
Masih banyak parameter lain yang tersedia dan Anda dapat membacanya di dokumentasi scikit-learn untuk TfidfVectorizer dan CountVectorizer.
Sekarang setelah Anda memiliki vektor, Anda dapat melihat fitur vektor yang tersimpan di count_vectorizer dan tfidf_vectorizer.
Apakah ada masalah yang terlihat? (Ya!)
Jelas ada komentar, satuan ukur, atau kata-kata tak bermakna lainnya serta artikel multibahasa dalam dataset yang Anda gunakan. Biasanya, Anda ingin meluangkan lebih banyak waktu untuk prapemrosesan dan menghapus noise, tetapi karena tutorial ini hanya menampilkan bukti konsep kecil, Anda akan melihat apakah model dapat mengatasi noise dan tetap mengklasifikasikan dengan benar meski ada masalah ini.
Saya penasaran apakah vektorisasi count dan TF-IDF saya mengekstrak token yang berbeda. Untuk melihat dan membandingkan fitur, Anda dapat mengekstrak kembali informasi vektor ke dalam DataFrame agar mudah dibandingkan dengan Python.
Seperti yang terlihat saat menjalankan sel di bawah, kedua vektorisasi mengekstrak token yang sama, tetapi jelas memiliki bobot berbeda. Kemungkinan, mengubah max_df dan min_df pada vektorisasi TF-IDF dapat mengubah hasil dan menghasilkan fitur yang berbeda pada masing-masing.
count_df = pd.DataFrame(count_train.A, columns=count_vectorizer.get_feature_names())tfidf_df = pd.DataFrame(tfidf_train.A, columns=tfidf_vectorizer.get_feature_names())difference = set(count_df.columns) - set(tfidf_df.columns)differenceprint(count_df.equals(tfidf_df))count_df.head()tfidf_df.head()Sekarang saatnya melatih dan menguji model Anda.
Di sini, Anda akan mulai dengan favorit NLP, MultinomialNB. Anda dapat menggunakannya untuk membandingkan TF-IDF versus bag-of-words. Intuisi saya adalah bag-of-words (alias CountVectorizer) akan berkinerja lebih baik dengan model ini. (Untuk bacaan lebih lanjut tentang distribusi multinomial dan mengapa ia bekerja paling baik dengan bilangan bulat, lihat referensi SVM dalam analisis teks scikit-learn dan penjelasan ringkas dari kursus statistik UPenn ini).
Saya pribadi merasa Confusion Matrix lebih mudah dibandingkan dan dibaca, jadi saya menggunakan dokumentasi scikit-learn untuk membangun confusion matrix yang mudah dibaca (terima kasih open source!). Confusion matrix menampilkan label yang benar pada diagonal utama (kiri atas ke kanan bawah). Sel lain menampilkan label yang salah, sering disebut false positive atau false negative. Bergantung pada masalah Anda, salah satunya mungkin lebih penting. Misalnya, untuk masalah berita palsu, apakah lebih penting agar kita tidak melabeli artikel berita nyata sebagai berita palsu? Jika demikian, mungkin pada akhirnya kita ingin memberi bobot pada skor akurasi agar lebih mencerminkan kekhawatiran ini.
Selain Confusion Matrix, scikit-learn memiliki banyak cara untuk memvisualisasikan dan membandingkan model Anda. Salah satu cara populer adalah menggunakan Kurva ROC. Ada banyak cara lain untuk mengevaluasi model yang tersedia di modul metrics scikit-learn.
def plot_confusion_matrix(cm, classes, normalize=False, title='Confusion matrix', cmap=plt.cm.Blues): """ See full source and example: http://scikit-learn.org/stable/auto_examples/model_selection/plot_confusion_matrix.html This function prints and plots the confusion matrix. Normalization can be applied by setting `normalize=True`. """ plt.imshow(cm, interpolation='nearest', cmap=cmap) plt.title(title) plt.colorbar() tick_marks = np.arange(len(classes)) plt.xticks(tick_marks, classes, rotation=45) plt.yticks(tick_marks, classes) if normalize: cm = cm.astype('float') / cm.sum(axis=1)[:, np.newaxis] print("Normalized confusion matrix") else: print('Confusion matrix, without normalization') thresh = cm.max() / 2. for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])): plt.text(j, i, cm[i, j], horizontalalignment="center", color="white" if cm[i, j] > thresh else "black") plt.tight_layout() plt.ylabel('True label') plt.xlabel('Predicted label')clf = MultinomialNB() clf.fit(tfidf_train, y_train)pred = clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.857Confusion matrix, without normalization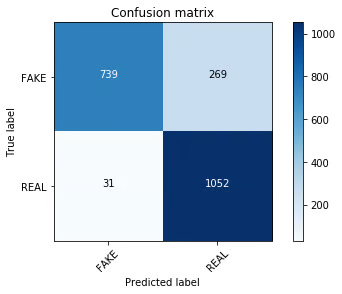
clf = MultinomialNB() clf.fit(count_train, y_train)pred = clf.predict(count_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.893Confusion matrix, without normalization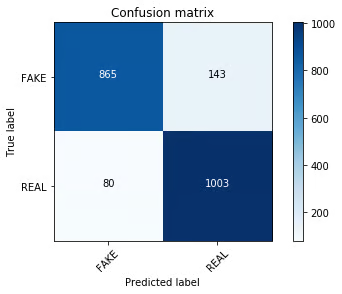
Dan benar saja, tanpa penyetelan parameter sama sekali, himpunan pelatihan yang di-vektorisasi count count_train terlihat mengungguli vektor TF-IDF Anda!
Ada banyak tulisan bagus tentang cara kerja model linear yang baik dengan vektorisasi TF-IDF (lihat word2vec untuk klasifikasi, referensi SVM dalam analisis teks scikit-learn, dan banyak lagi).
Jadi Anda harus menggunakan SVM, bukan?
Saya baru-baru ini menonton kuliah Victor Lavrenko tentang klasifikasi teks dan ia membandingkan pengklasifikasi Passive Aggressive dengan SVM linear untuk klasifikasi teks. Kita akan menguji pendekatan ini (yang memiliki beberapa keuntungan kecepatan signifikan dan kekurangan pembelajaran permanen) dengan dataset berita palsu.
linear_clf = PassiveAggressiveClassifier(n_iter=50) linear_clf.fit(tfidf_train, y_train)pred = linear_clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.936Confusion matrix, without normalization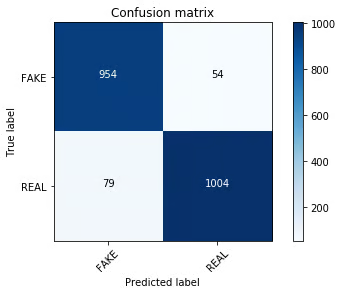
Wow!
Saya terkesan. Confusion matrix-nya terlihat berbeda dan modelnya sedikit lebih baik dalam mengklasifikasikan berita palsu kita. Kita dapat menguji apakah penyetelan nilai alpha untuk MultinomialNB menghasilkan hasil yang sebanding. Anda juga dapat menggunakan penyetelan parameter dengan grid search untuk pencarian yang lebih menyeluruh.
clf = MultinomialNB(alpha=0.1) last_score = 0for alpha in np.arange(0,1,.1): nb_classifier = MultinomialNB(alpha=alpha) nb_classifier.fit(tfidf_train, y_train) pred = nb_classifier.predict(tfidf_test) score = metrics.accuracy_score(y_test, pred) if score > last_score: clf = nb_classifier print("Alpha: {:.2f} Score: {:.5f}".format(alpha, score))Belum juga... Pada titik ini, mungkin menarik untuk melakukan penyetelan parameter di semua pengklasifikasi, atau melihat beberapa pengklasifikasi Bayesian scikit-learn lainnya. Anda juga bisa menguji Support Vector Machine (SVM) untuk melihat apakah kinerjanya melampaui pengklasifikasi Passive Aggressive.
Tapi saya lebih penasaran tentang apa yang sebenarnya telah dipelajari model Passive Aggressive. Jadi mari beralih ke introspeksi.
Jadi berita palsu sudah terpecahkan, bukan? Kita mencapai akurasi 93% pada dataset saya jadi mari kita tutup buku dan pulang.
Tentu saja belum. Saya sangat berhati-hati terhadap hasil ini mengingat banyaknya noise yang kita lihat pada fitur. Ada tulisan bagus di StackOverflow dengan fungsi yang sangat berguna ini untuk menemukan vektor yang paling memengaruhi label. Ini hanya berfungsi untuk klasifikasi biner (pengklasifikasi dengan 2 kelas), tetapi itu kabar baik bagi Anda, karena Anda hanya memiliki label FAKE atau REAL.
Menggunakan pengklasifikasi dengan performa terbaik Anda pada dataset vektor TF-IDF (tfidf_vectorizer) dan pengklasifikasi Passive Aggressive (linear_clf), inspeksi 30 vektor teratas untuk berita palsu dan nyata:
Anda juga dapat melakukan ini dengan cara yang cukup jelas hanya dengan beberapa baris Python, dengan memasangkan koefisien ke fitur dan melihat bagian atas serta bawah daftar Anda.
feature_names = tfidf_vectorizer.get_feature_names()### Most realsorted(zip(clf.coef_[0], feature_names), reverse=True)[:20]### Most fakesorted(zip(clf.coef_[0], feature_names))[:20]Jadi, jelas ada kata tertentu yang mungkin menunjukkan kecenderungan politik dan sumber pada fitur palsu teratas (seperti kata corporate dan establishment).
Selain itu, data berita nyata lebih sering menggunakan bentuk verba “to say”, kemungkinan karena di koran dan sebagian besar publikasi jurnalistik, sumber dikutip langsung (“Kanselir Jerman Angela Merkel mengatakan...” ).
Untuk mengekstrak daftar lengkap dari pengklasifikasi Anda saat ini dan melihat setiap token (atau dengan mudah membandingkan token dari satu pengklasifikasi ke lainnya), Anda dapat dengan mudah mengekspornya seperti ini.
tokens_with_weights = sorted(list(zip(feature_names, clf.coef_[0])))Vektorisasi lain yang kadang digunakan untuk klasifikasi teks adalah HashingVectorizer. HashingVectorizer membutuhkan lebih sedikit memori dan lebih cepat (karena bersifat sparse dan menggunakan hash alih-alih token) tetapi lebih sulit diintrospeksi. Anda dapat membaca lebih lanjut tentang pro dan kontra menggunakan HashingVectorizer di dokumentasi scikit-learn jika berminat.
Anda dapat mencobanya dan membandingkan hasilnya dengan vektorisasi lainnya. Kinerjanya cukup baik, dengan hasil lebih baik daripada vektorisasi TF-IDF yang menggunakan MultinomialNB (ini agak diharapkan karena alasan yang sama mengapa CountVectorizer berkinerja lebih baik), tetapi tidak sebaik vektorisasi TF-IDF dengan algoritma linear Passive Aggressive.
hash_vectorizer = HashingVectorizer(stop_words='english', non_negative=True)hash_train = hash_vectorizer.fit_transform(X_train)hash_test = hash_vectorizer.transform(X_test)clf = MultinomialNB(alpha=.01)clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.902Confusion matrix, without normalization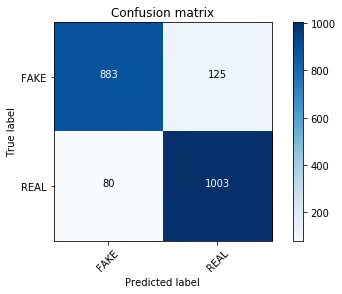
clf = PassiveAggressiveClassifier(n_iter=50)clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.921Confusion matrix, without normalization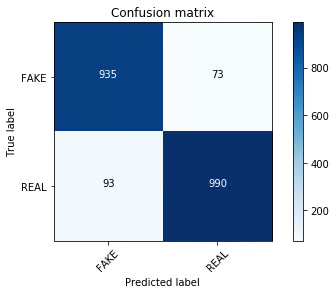
Apakah eksperimen pengklasifikasi berita palsu Anda berhasil? Tentu tidak.
Tetapi apakah Anda sempat bermain-main dengan dataset baru, menguji beberapa model klasifikasi NLP dan mengintrospeksi seberapa berhasil mereka? Ya.
Sesuai perkiraan sejak awal, mendefinisikan berita palsu dengan bag-of-words sederhana atau vektor TF-IDF adalah pendekatan yang terlalu menyederhanakan. Terutama dengan dataset multibahasa yang penuh token berisik. Jika Anda tidak melihat apa yang sebenarnya dipelajari model Anda, Anda mungkin mengira model mempelajari sesuatu yang bermakna. Jadi, ingat: selalu introspeksi model Anda (semampu Anda!).
Saya penasaran apakah Anda menemukan tren lain dalam data yang mungkin saya lewatkan. Saya akan menindaklanjuti dengan sebuah tulisan tentang bagaimana berbagai pengklasifikasi dibandingkan dalam hal fitur penting di blog saya. Jika Anda meluangkan waktu untuk meneliti dan menemukan hal menarik, silakan bagikan temuan dan catatan Anda di kolom komentar atau Anda selalu bisa menghubungi di Twitter (saya @kjam).
Saya harap Anda bersenang-senang mengeksplorasi dataset NLP baru bersama saya!
Lihat Python Machine Learning: Scikit-Learn Tutorial dari DataCamp.
Kursus Machine Learning
Kursus
Kursus
Kursus
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt




