{count, plural, one {कोर्स} other {कोर्स}}
scikit-learn के साथ Supervised Learning
{hours} घंटा
306.9K
कथित “फेक न्यूज़” का पता लगाना आसान काम नहीं है। पहले तो यह तय करना होता है कि फेक न्यूज़ है क्या—क्योंकि अब यह एक राजनीतिक बयान बन चुका है। अगर आप कोई परिभाषा ढूँढ़ लें या उस पर सहमत हो जाएँ, तो आपको वास्तविक और फेक न्यूज़ को एकत्र कर सही तरह से लेबल करना होगा (बेहतर भेद दिखाने के लिए उम्मीद है कि समान विषयों पर)। एकत्र करने के बाद, आपको ऐसे उपयोगी फ़ीचर्स ढूँढ़ने होंगे जो फेक और वास्तविक समाचारों में अंतर कर सकें।
इस समस्या क्षेत्र पर गहराई से नज़र डालने के लिए, मैं Miguel Martinez-Alvarez की पोस्ट “How can Machine Learning and AI Help Solve the Fake News Problem” देखने की सलाह देता/देती हूँ।
लगभग उसी समय जब मैंने Miguel की सूझबूझ भरी पोस्ट पढ़ी, मुझे एक ओपन डेटा साइंस पोस्ट मिली जिसमें Bayesian मॉडलों से सफल फेक न्यूज़ डिटेक्टर बनाने के बारे में बताया गया था। लेखक ने टैग की गई फेक और वास्तविक न्यूज़ के उदाहरणों वाला डेटासेट रिपॉज़िटरी भी बनाया। मुझे जिज्ञासा हुई कि क्या मैं आसानी से नतीजों को दोहरा सकता/सकती हूँ, और फिर यह पता लगा सकता/सकती हूँ कि मॉडल ने क्या सीखा।
इस ट्यूटोरियल में, आप मेरे शुरुआती अन्वेषण के कुछ चरणों से गुजरेंगे और देखेंगे कि क्या आप एक सफल फेक न्यूज़ डिटेक्टर बना सकते हैं!
टिप: यदि आप नैचुरल लैंग्वेज प्रोसेसिंग (NLP) की बुनियादें सीखना चाहते हैं, तो Natural Language Processing Fundamentals in Python कोर्स करने पर विचार करें।
शुरुआत में, आपको हमेशा डेटा पर एक त्वरित नज़र डालनी चाहिए और उसकी सामग्री का अंदाज़ा लगाना चाहिए। इसके लिए, एक Pandas DataFrame का उपयोग करें और shape, head देखें तथा ज़रूरी ट्रांसफ़ॉर्मेशन लागू करें।
अब जबकि DataFrame आपकी ज़रूरत के क़रीब दिख रहा है, आप लेबल अलग करना चाहेंगे और ट्रेनिंग तथा टेस्ट डेटासेट तैयार करना चाहेंगे।
इस नोटबुक के लिए, मैंने लंबी आर्टिकल टेक्स्ट पर ध्यान केंद्रित करने का फ़ैसला किया। क्योंकि मुझे पता था कि मैं बैग-ऑफ़-वर्ड्स और टर्म फ़्रीक्वेंसी–इनवर्स डॉक्युमेंट फ़्रीक्वेंसी (TF-IDF) का उपयोग कर फ़ीचर्स निकालूँगा/निकालूँगी, यह एक अच्छा विकल्प लगा। लंबा टेक्स्ट उपयोग करने से उम्मीद है कि वास्तविक और फेक न्यूज़ डेटा के लिए अलग-अलग शब्द और फ़ीचर्स सामने आएँगे।
अब जब आपके पास ट्रेनिंग और टेस्टिंग डेटा है, तो आप अपने क्लासिफ़ायर बना सकते हैं। यह समझने के लिए कि लेखों के शब्दों और टोकनों का फेक या वास्तविक होने पर कितना असर पड़ रहा है, आप शुरुआत में CountVectorizer और TfidfVectorizer का उपयोग करेंगे।
आप देखेंगे कि उदाहरण में TF-IDF वेक्टराइज़र tfidf_vectorizer के लिए max_df आर्ग्यूमेंट के साथ अधिकतम थ्रेशहोल्ड .7 सेट है। यह उन शब्दों को हटा देता है जो 70% से अधिक लेखों में आते हैं। साथ ही, बिल्ट-इन stop_words पैरामीटर वेक्टर बनाने से पहले डेटा से अंग्रेज़ी स्टॉप वर्ड्स हटा देगा।
और भी कई पैरामीटर उपलब्ध हैं और आप उनके बारे में scikit-learn डक्यूमेंटेशन में TfidfVectorizer और CountVectorizer पर पढ़ सकते हैं।
अब जब आपके पास वेक्टर हैं, तो आप count_vectorizer और tfidf_vectorizer में संग्रहीत वेक्टर फ़ीचर्स पर नज़र डाल सकते हैं।
क्या कोई स्पष्ट समस्या दिख रही है? (हाँ!)
डेटासेट में जो आप उपयोग कर रहे हैं, उसमें साफ़ तौर पर टिप्पणियाँ, माप या अन्य अर्थहीन शब्दों के साथ-साथ बहुभाषी लेख भी मौजूद हैं। सामान्यतः, आप इस पर अधिक समय प्री-प्रोसेसिंग में लगाएँगे और शोर हटाएँगे, पर यह ट्यूटोरियल महज़ एक छोटे प्रूफ़-ऑफ़-कॉन्सेप्ट को दिखाता है, इसलिए आप देखेंगे कि क्या मॉडल इस शोर को पार कर सकता है और इन समस्याओं के बावजूद सही वर्गीकरण कर सकता है।
मुझे जिज्ञासा थी कि क्या मेरे काउंट और TF-IDF वेक्टराइज़र ने अलग टोकन निकाले। फ़ीचर्स देखने और तुलना करने के लिए, आप वेक्टर जानकारी को वापस एक DataFrame में निकाल सकते हैं ताकि आसान Python तुलना की जा सके।
जैसा कि नीचे की सेल्स चलाकर आप देखेंगे, दोनों वेक्टराइज़र ने वही टोकन निकाले, लेकिन उनके वेट्स अलग हैं। संभवतः, TF-IDF वेक्टराइज़र के max_df और min_df बदलने से नतीजे बदल सकते हैं और प्रत्येक में अलग फ़ीचर्स मिल सकते हैं।
count_df = pd.DataFrame(count_train.A, columns=count_vectorizer.get_feature_names())tfidf_df = pd.DataFrame(tfidf_train.A, columns=tfidf_vectorizer.get_feature_names())difference = set(count_df.columns) - set(tfidf_df.columns)differenceprint(count_df.equals(tfidf_df))count_df.head()tfidf_df.head()अब समय है कि आप अपने मॉडलों को ट्रेन और टेस्ट करें।
यहाँ, आप NLP के एक पसंदीदा, MultinomialNB, से शुरुआत करेंगे। आप इसका उपयोग TF-IDF बनाम बैग-ऑफ़-वर्ड्स की तुलना करने के लिए कर सकते हैं। मेरी सहज समझ थी कि बैग-ऑफ़-वर्ड्स (उर्फ़ CountVectorizer) इस मॉडल के साथ बेहतर प्रदर्शन करेगा। (मल्टीनॉमियल डिस्ट्रीब्यूशन और इंटिजर्स के साथ इसके बेहतर काम करने पर अधिक पढ़ने के लिए, यह UPenn के एक सांख्यिकी कोर्स का संक्षिप्त स्पष्टीकरण देखें)।
मुझे पर्सनली Confusion Matrix की तुलना और पढ़ना आसान लगता है, इसलिए मैंने scikit-learn डक्यूमेंटेशन का उपयोग करके कुछ आसानी से पढ़ी जाने वाली कन्फ्यूज़न मैट्रिसेज़ बनाईं (ओपन सोर्स का धन्यवाद!)। कन्फ्यूज़न मैट्रिक्स मुख्य डायगोनल (ऊपर बाएँ से नीचे दाएँ) पर सही लेबल दिखाती है। अन्य सेल्स गलत लेबल दिखाते हैं, जिन्हें अक्सर फ़ॉल्स पॉज़िटिव्स या फ़ॉल्स नेगेटिव्स कहा जाता है। आपकी समस्या पर निर्भर करते हुए, इनमें से कोई एक अधिक महत्वपूर्ण हो सकता है। उदाहरण के लिए, फेक न्यूज़ समस्या के लिए, क्या यह अधिक महत्वपूर्ण है कि हम वास्तविक समाचार लेखों को फेक न कहें? अगर हाँ, तो हम अंततः अपनी एक्यूरेसी स्कोर को इस चिंता को बेहतर दर्शाने के लिए वेट करना चाहेंगे।
कन्फ्यूज़न मैट्रिसेज़ के अलावा, scikit-learn आपके मॉडलों को विज़ुअलाइज़ और तुलना करने के कई तरीके देता है। एक लोकप्रिय तरीका है ROC कर्व का उपयोग करना। अपने मॉडल का आकलन करने के और भी कई तरीके scikit-learn metrics मॉड्यूल में उपलब्ध हैं।
def plot_confusion_matrix(cm, classes, normalize=False, title='Confusion matrix', cmap=plt.cm.Blues): """ See full source and example: http://scikit-learn.org/stable/auto_examples/model_selection/plot_confusion_matrix.html This function prints and plots the confusion matrix. Normalization can be applied by setting `normalize=True`. """ plt.imshow(cm, interpolation='nearest', cmap=cmap) plt.title(title) plt.colorbar() tick_marks = np.arange(len(classes)) plt.xticks(tick_marks, classes, rotation=45) plt.yticks(tick_marks, classes) if normalize: cm = cm.astype('float') / cm.sum(axis=1)[:, np.newaxis] print("Normalized confusion matrix") else: print('Confusion matrix, without normalization') thresh = cm.max() / 2. for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])): plt.text(j, i, cm[i, j], horizontalalignment="center", color="white" if cm[i, j] > thresh else "black") plt.tight_layout() plt.ylabel('True label') plt.xlabel('Predicted label')clf = MultinomialNB() clf.fit(tfidf_train, y_train)pred = clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.857Confusion matrix, without normalization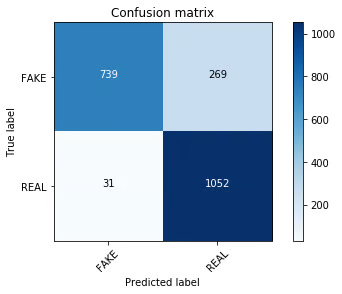
clf = MultinomialNB() clf.fit(count_train, y_train)pred = clf.predict(count_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.893Confusion matrix, without normalization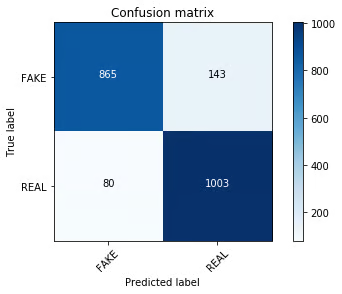
और सच में, बिना किसी पैरामीटर ट्यूनिंग के, आपका काउंट-वेक्टराइज़्ड ट्रेनिंग सेट count_train आपके TF-IDF वेक्टर्स से स्पष्ट रूप से बेहतर प्रदर्शन कर रहा है!
कई शानदार लेख मौजूद हैं जो बताते हैं कि लिनियर मॉडल TF-IDF वेक्टराइज़र्स के साथ अच्छा काम करते हैं (देखें क्लासिफ़िकेशन के लिए word2vec, scikit-learn टेक्स्ट एनालिसिस में SVM संदर्भ, और बहुत कुछ)।
तो फिर आपको SVM का उपयोग करना चाहिए, है न?
ठीक है, मैंने हाल ही में Victor Lavrenko का टेक्स्ट क्लासिफ़िकेशन पर लेक्चर देखा और वे टेक्स्ट क्लासिफ़िकेशन के लिए Passive Aggressive क्लासिफ़ायर की तुलना लिनियर SVMs से करते हैं। हम इस तरीके को (जिसके कुछ उल्लेखनीय स्पीड फायदे और स्थायी लर्निंग कमियाँ हैं) फेक न्यूज़ डेटासेट पर टेस्ट करेंगे।
linear_clf = PassiveAggressiveClassifier(n_iter=50) linear_clf.fit(tfidf_train, y_train)pred = linear_clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.936Confusion matrix, without normalization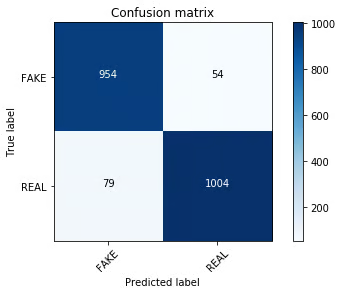
वाह!
मैं प्रभावित हूँ। कन्फ्यूज़न मैट्रिक्स अलग दिख रही है और मॉडल हमारा फेक न्यूज़ थोड़ा बेहतर वर्गीकृत कर रहा है। हम जाँच सकते हैं कि MultinomialNB के लिए alpha वैल्यू ट्यून करने से तुलनीय नतीजे आते हैं या नहीं। आप अधिक व्यापक खोज के लिए ग्रिड सर्च के साथ पैरामीटर ट्यूनिंग भी कर सकते हैं।
clf = MultinomialNB(alpha=0.1) last_score = 0for alpha in np.arange(0,1,.1): nb_classifier = MultinomialNB(alpha=alpha) nb_classifier.fit(tfidf_train, y_train) pred = nb_classifier.predict(tfidf_test) score = metrics.accuracy_score(y_test, pred) if score > last_score: clf = nb_classifier print("Alpha: {:.2f} Score: {:.5f}".format(alpha, score))अभी नहीं... इस बिंदु पर, सभी क्लासिफ़ायर पर पैरामीटर ट्यूनिंग करना दिलचस्प हो सकता है, या कुछ अन्य scikit-learn Bayesian क्लासिफ़ायर देखना। आप यह भी परख सकते हैं कि क्या एक सपोर्ट वेक्टर मशीन (SVM) Passive Aggressive क्लासिफ़ायर से बेहतर प्रदर्शन करती है।
लेकिन मुझे थोड़ा अधिक उत्सुकता है कि Passive Aggressive मॉडल ने वास्तव में क्या सीखा है। तो चलिए अंतर्दर्शन की ओर बढ़ते हैं।
तो क्या फेक न्यूज़ सुलझ गई? मेरे डेटासेट पर हमने 93% एक्यूरेसी हासिल कर ली, तो चलिए सब समेट लें।
बिल्कुल नहीं। हमने फ़ीचर्स में जितना शोर देखा, उसके चलते मैं इन नतीजों को लेकर कम से कम सतर्क हूँ। StackOverflow पर एक शानदार उत्तर है जिसमें लेबल्स को सबसे अधिक प्रभावित करने वाले वेक्टर खोजने का बेहद उपयोगी फ़ंक्शन है। यह केवल बाइनरी क्लासिफ़िकेशन (2 क्लास वाले क्लासिफ़ायर) के लिए काम करता है, लेकिन यह आपके लिए अच्छी बात है, क्योंकि आपके पास केवल FAKE या REAL लेबल हैं।
अपने TF-IDF वेक्टर डेटासेट (tfidf_vectorizer) और Passive Aggressive क्लासिफ़ायर (linear_clf) वाले सर्वश्रेष्ठ प्रदर्शन करने वाले क्लासिफ़ायर का उपयोग करते हुए, फेक और वास्तविक न्यूज़ के लिए शीर्ष 30 वेक्टर देखें:
आप यह काम कुछ स्पष्ट लाइनों के Python कोड से भी कर सकते हैं—अपनी कोइफ़िशिएंट्स को फ़ीचर्स के साथ ज़िप करके और अपनी सूची के ऊपर और नीचे के हिस्से को देख कर।
feature_names = tfidf_vectorizer.get_feature_names()### Most realsorted(zip(clf.coef_[0], feature_names), reverse=True)[:20]### Most fakesorted(zip(clf.coef_[0], feature_names))[:20]तो, साफ़ तौर पर कुछ शब्द ऐसे हैं जो शीर्ष फेक फ़ीचर्स में राजनीतिक मंशा और स्रोत का संकेत दे सकते हैं (जैसे corporate और establishment जैसे शब्द)।
साथ ही, वास्तविक समाचार डेटा में क्रिया "to say" के रूप अधिक बार आते हैं, संभवतः इसलिए कि अख़बारों और अधिकांश पत्रकारिता प्रकाशनों में स्रोतों को सीधे उद्धृत किया जाता है (“German Chancellor Angela Merkel said...”)।
अपने मौजूदा क्लासिफ़ायर से पूरी सूची निकालने और हर टोकन पर नज़र डालने (या आसानी से एक क्लासिफ़ायर से दूसरे की तुलना करने) के लिए, आप इसे इस तरह निर्यात कर सकते हैं।
tokens_with_weights = sorted(list(zip(feature_names, clf.coef_[0])))टेक्स्ट क्लासिफ़िकेशन के लिए कभी-कभी उपयोग होने वाला एक अन्य वेक्टराइज़र HashingVectorizer है। HashingVectorizer को कम मेमोरी चाहिए और यह तेज़ होता है (क्योंकि यह स्पार्स होता है और टोकन की बजाय हैश का उपयोग करता है) लेकिन इसका अंतर्दर्शन कठिन होता है। अगर आप रुचि रखते हैं तो HashingVectorizer के फ़ायदे-नुकसान scikit-learn डक्यूमेंटेशन में पढ़ सकते हैं।
आप इसे आज़मा सकते हैं और इसके नतीजों की तुलना अन्य वेक्टराइज़र्स से कर सकते हैं। यह काफ़ी अच्छा प्रदर्शन करता है—MultinomialNB के साथ TF-IDF वेक्टराइज़र से बेहतर (यह कुछ हद तक अपेक्षित है, वही कारण जिनसे CountVectorizer बेहतर करता है), लेकिन Passive Aggressive लिनियर एल्गोरिद्म के साथ TF-IDF वेक्टराइज़र जितना अच्छा नहीं।
hash_vectorizer = HashingVectorizer(stop_words='english', non_negative=True)hash_train = hash_vectorizer.fit_transform(X_train)hash_test = hash_vectorizer.transform(X_test)clf = MultinomialNB(alpha=.01)clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.902Confusion matrix, without normalization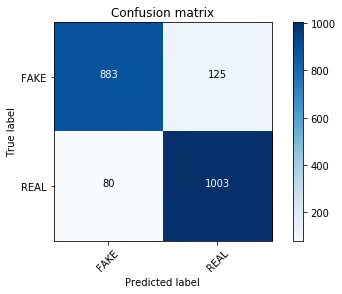
clf = PassiveAggressiveClassifier(n_iter=50)clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.921Confusion matrix, without normalization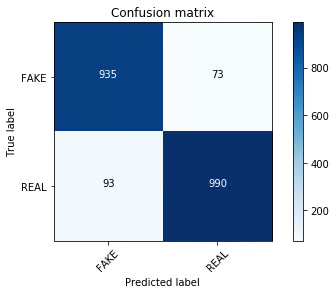
तो क्या आपका फेक न्यूज़ क्लासिफ़ायर प्रयोग सफल रहा? बिल्कुल नहीं।
लेकिन क्या आपने एक नए डेटासेट के साथ प्रयोग किया, कुछ NLP क्लासिफ़िकेशन मॉडलों को परखा और उनका अंतर्दर्शन किया कि वे कितने सफल रहे? हाँ।
शुरुआत से ही अपेक्षित था कि साधारण बैग-ऑफ़-वर्ड्स या TF-IDF वेक्टर के साथ फेक न्यूज़ को परिभाषित करना अत्यधिक सरलीकृत तरीका है—खासकर शोर से भरे बहुभाषी डेटासेट के साथ। अगर आपने यह नहीं देखा होता कि आपके मॉडल ने सच में क्या सीखा, तो आप सोच सकते थे कि मॉडल ने कुछ सार्थक सीखा है। इसलिए याद रखें: हमेशा अपने मॉडलों का (जहाँ तक हो सके) अंतर्दर्शन करें।
मुझे उत्सुकता होगी अगर आपको डेटा में कुछ और रुझान दिखें जो मुझसे छूट गए हों। मैं इस पर फॉलो-अप पोस्ट करूँगा/करूँगी कि विभिन्न क्लासिफ़ायर महत्वपूर्ण फ़ीचर्स के संदर्भ में कैसे तुलना करते हैं, मेरे ब्लॉग पर। अगर आप कुछ समय रिसर्च में लगाएँ और कोई दिलचस्प चीज़ पाएँ, तो निःसंकोच अपनी खोज और नोट्स कमेंट्स में शेयर करें या आप ट्विटर पर भी संपर्क कर सकते हैं (मैं @kjam हूँ)।
उम्मीद है आपने मेरे साथ एक नए NLP डेटासेट की खोज में मज़ा किया होगा!
DataCamp का Python Machine Learning: Scikit-Learn Tutorial देखें।
मशीन लर्निंग कोर्स
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}