Khóa học
Học có giám sát với scikit-learn
4 giờ
309.1K
Phát hiện cái gọi là “tin giả” không hề dễ. Trước tiên là định nghĩa thế nào là tin giả – khi mà khái niệm này giờ đây đã trở thành một phát ngôn chính trị. Nếu có thể tìm được hoặc thống nhất một định nghĩa, bạn phải thu thập và gắn nhãn đúng tin thật và tin giả (hy vọng là về các chủ đề tương tự để làm rõ khác biệt). Sau khi thu thập, bạn cần tìm những đặc trưng hữu ích để phân biệt tin giả với tin thật.
Để tìm hiểu sâu hơn về không gian vấn đề này, tôi khuyên bạn xem bài viết của Miguel Martinez-Alvarez “How can Machine Learning and AI Help Solve the Fake News Problem”.
Gần thời điểm tôi đọc bài viết sâu sắc của Miguel, tôi bắt gặp một bài trên Open Data Science về xây dựng bộ phát hiện tin giả thành công bằng mô hình Bayes. Tác giả còn tạo một kho lưu trữ với tập dữ liệu ví dụ tin giả và tin thật đã gắn nhãn. Tôi tò mò liệu mình có thể dễ dàng tái tạo kết quả không, và liệu tôi có thể xác định mô hình đã học được gì.
Trong hướng dẫn này, bạn sẽ cùng tôi đi qua một số bước khám phá ban đầu và thử xây dựng một bộ phát hiện tin giả hiệu quả!
Mẹo: nếu bạn muốn tìm hiểu thêm về các kiến thức cơ bản của Xử lý ngôn ngữ tự nhiên (NLP), hãy cân nhắc tham gia khóa Natural Language Processing Fundamentals in Python.
Để bắt đầu, bạn nên nhìn nhanh vào dữ liệu để cảm nhận nội dung. Hãy dùng Pandas DataFrame, kiểm tra kích thước, các dòng đầu và áp dụng các biến đổi cần thiết.
Giờ DataFrame đã gần giống những gì bạn cần, hãy tách nhãn và thiết lập tập huấn luyện và kiểm tra.
Trong notebook này, tôi quyết định tập trung vào phần nội dung bài báo dài hơn. Vì tôi biết sẽ dùng bag-of-words và TF-IDF (Term Frequency–Inverse Document Frequency) để trích xuất đặc trưng, lựa chọn này có vẻ hợp lý. Dùng văn bản dài hơn hy vọng sẽ cho phép xuất hiện các từ và đặc trưng khác biệt giữa tin thật và tin giả.
Giờ bạn đã có dữ liệu huấn luyện và kiểm tra, bạn có thể xây dựng các bộ phân loại. Để đánh giá xem các từ và token trong bài viết có ảnh hưởng đáng kể đến việc tin là giả hay thật không, bạn bắt đầu bằng cách dùng CountVectorizer và TfidfVectorizer.
Bạn sẽ thấy ví dụ đặt ngưỡng tối đa là .7 cho TF-IDF vectorizer tfidf_vectorizer bằng đối số max_df. Điều này loại bỏ các từ xuất hiện trong hơn 70% bài viết. Ngoài ra, tham số tích hợp stop_words sẽ loại bỏ stop words tiếng Anh khỏi dữ liệu trước khi tạo vector.
Có rất nhiều tham số khác và bạn có thể đọc thêm trong tài liệu scikit-learn cho TfidfVectorizer và CountVectorizer.
Giờ bạn đã có các vector, bạn có thể xem các đặc trưng vector được lưu trong count_vectorizer và tfidf_vectorizer.
Có vấn đề dễ nhận thấy nào không? (Có!)
Rõ ràng là có bình luận, phép đo hoặc các từ vô nghĩa khác cũng như bài viết đa ngôn ngữ trong tập dữ liệu bạn đang dùng. Thông thường, bạn sẽ muốn dành nhiều thời gian tiền xử lý và loại bỏ nhiễu, nhưng vì hướng dẫn này chỉ trình diễn một thử nghiệm nhỏ, bạn sẽ xem liệu mô hình có thể vượt qua nhiễu và phân loại đúng bất chấp các vấn đề này không.
Tôi tò mò liệu các vectorizer count và TF-IDF của mình có trích xuất các token khác nhau không. Để xem và so sánh đặc trưng, bạn có thể đưa thông tin vector trở lại một DataFrame để so sánh trong Python cho thuận tiện.
Như bạn sẽ thấy khi chạy các ô dưới đây, cả hai vectorizer trích xuất cùng một tập token, nhưng rõ ràng có trọng số khác nhau. Nhiều khả năng, thay đổi max_df và min_df của TF-IDF vectorizer có thể làm thay đổi kết quả và dẫn đến mỗi bên có tập đặc trưng khác nhau.
count_df = pd.DataFrame(count_train.A, columns=count_vectorizer.get_feature_names())tfidf_df = pd.DataFrame(tfidf_train.A, columns=tfidf_vectorizer.get_feature_names())difference = set(count_df.columns) - set(tfidf_df.columns)differenceprint(count_df.equals(tfidf_df))count_df.head()tfidf_df.head()Đến lúc huấn luyện và kiểm tra mô hình của bạn.
Tại đây, bạn sẽ bắt đầu với một lựa chọn ưa thích trong NLP, MultinomialNB. Bạn có thể dùng nó để so sánh TF-IDF với bag-of-words. Trực giác của tôi là bag-of-words (tức CountVectorizer) sẽ hoạt động tốt hơn với mô hình này. (Để đọc thêm về phân phối đa thức và vì sao nó hoạt động tốt với số nguyên, hãy xem giải thích khá súc tích từ một khóa thống kê của UPenn).
Cá nhân tôi thấy Ma trận nhầm lẫn dễ so sánh và đọc hơn, nên tôi dùng tài liệu scikit-learn để dựng vài ma trận nhầm lẫn dễ đọc (cảm ơn mã nguồn mở!). Ma trận nhầm lẫn hiển thị các nhãn đúng trên đường chéo chính (từ trên trái xuống dưới phải). Các ô còn lại hiển thị nhãn sai, thường gọi là dương tính giả hoặc âm tính giả. Tùy vấn đề mà một trong hai có thể quan trọng hơn. Ví dụ, với bài toán tin giả, liệu quan trọng hơn là không gán nhầm tin thật thành tin giả? Nếu vậy, ta có thể cân nhắc đánh trọng số điểm chính xác để phản ánh mối quan tâm này.
Ngoài Ma trận nhầm lẫn, scikit-learn có nhiều cách để trực quan hóa và so sánh mô hình. Một cách phổ biến là dùng đường cong ROC. Còn rất nhiều cách khác để đánh giá mô hình trong mô-đun metrics của scikit-learn.
def plot_confusion_matrix(cm, classes, normalize=False, title='Confusion matrix', cmap=plt.cm.Blues): """ See full source and example: http://scikit-learn.org/stable/auto_examples/model_selection/plot_confusion_matrix.html This function prints and plots the confusion matrix. Normalization can be applied by setting `normalize=True`. """ plt.imshow(cm, interpolation='nearest', cmap=cmap) plt.title(title) plt.colorbar() tick_marks = np.arange(len(classes)) plt.xticks(tick_marks, classes, rotation=45) plt.yticks(tick_marks, classes) if normalize: cm = cm.astype('float') / cm.sum(axis=1)[:, np.newaxis] print("Normalized confusion matrix") else: print('Confusion matrix, without normalization') thresh = cm.max() / 2. for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])): plt.text(j, i, cm[i, j], horizontalalignment="center", color="white" if cm[i, j] > thresh else "black") plt.tight_layout() plt.ylabel('True label') plt.xlabel('Predicted label')clf = MultinomialNB() clf.fit(tfidf_train, y_train)pred = clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.857Confusion matrix, without normalization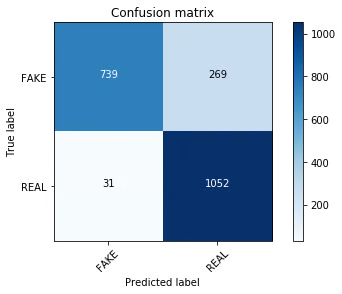
clf = MultinomialNB() clf.fit(count_train, y_train)pred = clf.predict(count_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.893Confusion matrix, without normalization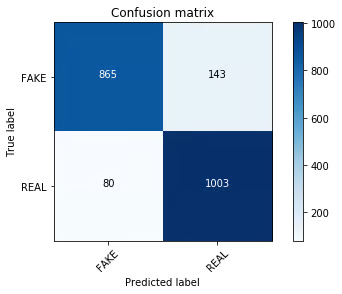
Và quả thật, không cần tinh chỉnh tham số nào, tập huấn luyện vector đếm count_train đang vượt trội rõ rệt so với TF-IDF!
Có rất nhiều bài viết hay về cách mô hình tuyến tính hoạt động tốt với TF-IDF vectorizer (hãy xem word2vec cho phân loại, tài liệu tham khảo SVM trong phân tích văn bản với scikit-learn, và nhiều nguồn khác).
Vậy bạn nên dùng SVM, đúng không?
Gần đây tôi xem bài giảng của Victor Lavrenko về phân loại văn bản và ông so sánh bộ phân loại Passive Aggressive với SVM tuyến tính cho bài toán văn bản. Chúng ta sẽ thử cách tiếp cận này (mang lại một số lợi thế về tốc độ và nhược điểm về học lâu dài) với tập dữ liệu tin giả.
linear_clf = PassiveAggressiveClassifier(n_iter=50) linear_clf.fit(tfidf_train, y_train)pred = linear_clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.936Confusion matrix, without normalization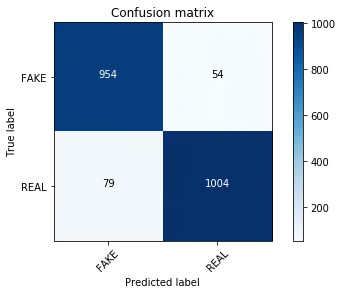
Wow!
Tôi ấn tượng đấy. Ma trận nhầm lẫn trông khác đi và mô hình phân loại tin giả tốt hơn một chút. Ta có thể kiểm tra xem việc tinh chỉnh giá trị alpha cho MultinomialNB có tạo ra kết quả tương đương không. Bạn cũng có thể dùng tinh chỉnh tham số bằng grid search để tìm kiếm toàn diện hơn.
clf = MultinomialNB(alpha=0.1) last_score = 0for alpha in np.arange(0,1,.1): nb_classifier = MultinomialNB(alpha=alpha) nb_classifier.fit(tfidf_train, y_train) pred = nb_classifier.predict(tfidf_test) score = metrics.accuracy_score(y_test, pred) if score > last_score: clf = nb_classifier print("Alpha: {:.2f} Score: {:.5f}".format(alpha, score))Vẫn chưa ổn... Lúc này, sẽ thú vị nếu thực hiện tinh chỉnh tham số trên tất cả các bộ phân loại, hoặc xem qua một số bộ phân loại Bayes trong scikit-learn khác. Bạn cũng có thể thử SVM để xem có vượt trội hơn Passive Aggressive hay không.
Nhưng tôi tò mò hơn về việc mô hình Passive Aggressive thực sự đã học được gì. Vậy hãy chuyển sang nội quan.
Vậy là vấn đề tin giả đã được giải quyết, đúng không? Chúng ta đạt 93% độ chính xác trên tập dữ liệu của tôi, vậy hãy đóng máy và về nhà thôi.
Dĩ nhiên là không. Tôi ít nhất cũng hoài nghi về những kết quả này bởi có quá nhiều nhiễu trong các đặc trưng. Có một bài viết rất hay trên StackOverflow với hàm cực kỳ hữu ích để tìm các vector ảnh hưởng mạnh nhất đến nhãn. Nó chỉ hoạt động cho bài toán phân loại nhị phân (2 lớp), nhưng đó là tin vui vì bạn chỉ có nhãn FAKE hoặc REAL.
Dùng bộ phân loại hoạt động tốt nhất với tập vector TF-IDF của bạn (tfidf_vectorizer) và bộ phân loại Passive Aggressive (linear_clf), hãy kiểm tra top 30 vector cho tin giả và tin thật:
Bạn cũng có thể làm điều này theo cách khá hiển nhiên chỉ với vài dòng Python, bằng cách zip các hệ số với đặc trưng rồi xem phần đầu và cuối danh sách.
feature_names = tfidf_vectorizer.get_feature_names()### Most realsorted(zip(clf.coef_[0], feature_names), reverse=True)[:20]### Most fakesorted(zip(clf.coef_[0], feature_names))[:20]Rõ ràng có những từ có thể thể hiện ý định chính trị và nguồn gốc trong nhóm đặc trưng “giả” hàng đầu (như corporate và establishment).
Ngoài ra, dữ liệu tin thật dùng các dạng của động từ “to say” thường xuyên hơn, có lẽ vì trong báo chí và phần lớn ấn phẩm, nguồn tin được trích dẫn trực tiếp (“Thủ tướng Đức Angela Merkel nói…”).
Để trích xuất toàn bộ danh sách từ bộ phân loại hiện tại và xem từng token (hoặc dễ so sánh token giữa các bộ phân loại), bạn có thể xuất như sau.
tokens_with_weights = sorted(list(zip(feature_names, clf.coef_[0])))Một vectorizer khác đôi khi dùng cho phân loại văn bản là HashingVectorizer. HashingVectorizer cần ít bộ nhớ hơn và nhanh hơn (vì thưa và dùng băm thay vì token) nhưng khó nội quan hơn. Bạn có thể đọc thêm về ưu nhược điểm của HashingVectorizer trong tài liệu scikit-learn nếu quan tâm.
Bạn có thể thử và so sánh kết quả với các vectorizer khác. Nó hoạt động khá tốt, cho kết quả tốt hơn TF-IDF khi dùng MultinomialNB (điều này phần nào dễ hiểu do lý do tương tự khiến CountVectorizer vượt trội), nhưng không tốt bằng TF-IDF với thuật toán tuyến tính Passive Aggressive.
hash_vectorizer = HashingVectorizer(stop_words='english', non_negative=True)hash_train = hash_vectorizer.fit_transform(X_train)hash_test = hash_vectorizer.transform(X_test)clf = MultinomialNB(alpha=.01)clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.902Confusion matrix, without normalization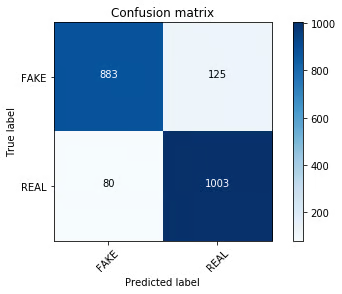
clf = PassiveAggressiveClassifier(n_iter=50)clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.921Confusion matrix, without normalization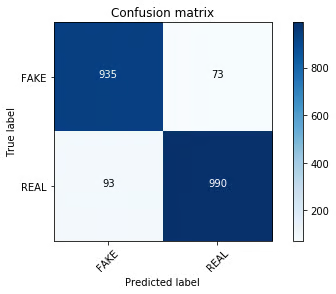
Vậy thử nghiệm bộ phân loại tin giả của bạn có thành công không? Chắc chắn là không.
Nhưng bạn đã được chơi với một tập dữ liệu mới, thử một vài mô hình phân loại NLP và nội quan mức độ thành công của chúng? Có.
Như dự đoán từ đầu, định nghĩa tin giả chỉ bằng bag-of-words hoặc vector TF-IDF là cách tiếp cận quá đơn giản. Đặc biệt là với tập dữ liệu đa ngôn ngữ đầy token nhiễu. Nếu bạn không xem xét mô hình đã thực sự học gì, bạn có thể nghĩ mô hình đã học được điều gì đó ý nghĩa. Vì vậy, hãy nhớ: luôn nội quan mô hình của bạn (trong khả năng có thể!).
Tôi sẽ rất tò mò nếu bạn tìm thấy các xu hướng khác trong dữ liệu mà tôi có thể đã bỏ lỡ. Tôi sẽ tiếp tục với một bài viết về cách các bộ phân loại khác nhau so sánh về các đặc trưng quan trọng trên blog của tôi. Nếu bạn dành thời gian nghiên cứu và thấy điều gì thú vị, cứ thoải mái chia sẻ phát hiện và ghi chú trong phần bình luận hoặc luôn có thể liên hệ trên Twitter (tôi là @kjam).
Hy vọng bạn đã có chút niềm vui khi khám phá một tập dữ liệu NLP mới cùng tôi!
Xem thêm Python Machine Learning: Hướng dẫn Scikit-Learn của DataCamp.
Khóa học Machine Learning
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
