Pular para o conteúdo principal

Detectando fake news com scikit-learn

Este tutorial de scikit-learn vai guiar você na construção de um classificador de fake news com a ajuda de modelos bayesianos.
Atualizado 17 de set. de 2026  · 15 min lido

Explorar com IA

ChatGPTClaudePerplexity
datacamp graphic

Detectar as chamadas “fake news” não é tarefa simples. Primeiro, é preciso definir o que é fake news — algo que ganhou conotação política. Se você conseguir definir ou concordar com um conceito, então precisa coletar e rotular corretamente notícias reais e falsas (de preferência sobre temas semelhantes para evidenciar melhor as diferenças). Depois de coletar, é preciso encontrar boas features para distinguir notícias falsas de reais.

Para um mergulho mais profundo nesse tema, recomendo o post do Miguel Martinez-Alvarez: “How can Machine Learning and AI Help Solve the Fake News Problem”.

Na mesma época em que li o post do Miguel, encontrei um artigo no Open Data Science sobre como construir um detector de fake news com modelos bayesianos. O autor ainda criou um repositório com o dataset rotulado de exemplos reais e falsos. Fiquei curioso para saber se eu conseguiria reproduzir os resultados com facilidade e, em seguida, entender o que o modelo havia aprendido.

Neste tutorial, você vai acompanhar parte da minha exploração inicial e ver se consegue construir um detector de fake news que funcione!

Dica: se você quer aprender mais sobre fundamentos de Processamento de Linguagem Natural (NLP), vale conferir o curso Natural Language Processing Fundamentals in Python.

Exploração de dados

Para começar, sempre dê uma olhada rápida nos dados para sentir o conteúdo. Para isso, use um DataFrame do Pandas e verifique o shape, o head e aplique as transformações necessárias.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZCIsInNhbXBsZSI6IiMgSW1wb3J0IGBmYWtlX29yX3JlYWxfbmV3cy5jc3ZgIFxuZGYgPSBfXy5fX19fX19fXyhcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKVxuICAgIFxuIyBJbnNwZWN0IHNoYXBlIG9mIGBkZmAgXG5kZi5fX19fX1xuXG4jIFByaW50IGZpcnN0IGxpbmVzIG9mIGBkZmBcbmRmLl9fX19fXyIsInNvbHV0aW9uIjoiIyBJbXBvcnQgYGZha2Vfb3JfcmVhbF9uZXdzLmNzdmAgXG5kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvZmFrZV9vcl9yZWFsX25ld3MuY3N2XCIpXG4gICAgXG4jIEluc3BlY3Qgc2hhcGUgb2YgYGRmYCBcbmRmLnNoYXBlXG5cbiMgUHJpbnQgZmlyc3QgbGluZXMgb2YgYGRmYCBcbmRmLmhlYWQoKSIsInNjdCI6InRlc3Rfb2JqZWN0KFwiZGZcIiwgdW5kZWZpbmVkX21zZz1cIkRpZCB5b3UgaW1wb3J0IHRoZSBkYXRhIGNvcnJlY3RseT9cIixpbmNvcnJlY3RfbXNnPVwiTWFrZSBzdXJlIHRvIHVzZSB0aGUgUGFuZGFzIGByZWFkX2NzdigpYCBmdW5jdGlvbiB0byByZWFkIGluIHRoZSBkYXRhIVwiKVxudGVzdF9vYmplY3RfYWNjZXNzZWQoXCJkZi5zaGFwZVwiLCBub3RfYWNjZXNzZWRfbXNnPVwiRGlkIHlvdSB1c2UgYHNoYXBlYCB0byByZXRyaWV2ZSB0aGUgc2hhcGUgb2YgdGhlIGBkZmA/XCIpXG50ZXN0X2Z1bmN0aW9uKFwiZGYuaGVhZFwiKVxuc3VjY2Vzc19tc2coXCJOaWNlIG9uZSFcIikifQ==
 
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKSIsInNhbXBsZSI6IiMgU2V0IGluZGV4XG5kZiA9IGRmLnNldF9pbmRleChcIlVubmFtZWQ6IDBcIikgXG5cbiMgUHJpbnQgZmlyc3QgbGluZXMgb2YgYGRmYCBcbmRmLl9fX19fXyIsInNvbHV0aW9uIjoiIyBTZXQgaW5kZXggXG5kZiA9IGRmLnNldF9pbmRleChcIlVubmFtZWQ6IDBcIilcblxuIyBQcmludCBmaXJzdCBsaW5lcyBvZiBgZGZgIFxuZGYuaGVhZCgpIiwic2N0IjoidGVzdF9vYmplY3QoXCJkZlwiKVxudGVzdF9mdW5jdGlvbihcImRmLmhlYWRcIilcbnN1Y2Nlc3NfbXNnKFwiQXdlc29tZSBqb2IhXCIpIn0=

Extraindo os dados de treino

Agora que o DataFrame está mais próximo do que você precisa, separe os rótulos e monte os conjuntos de treino e teste.

Neste notebook, decidi focar no texto mais longo do artigo. Como eu sabia que usaria bag-of-words e TF-IDF (Term Frequency–Inverse Document Frequency) para extrair features, essa parecia uma boa escolha. Textos mais longos tendem a trazer palavras e características distintas para diferenciar as notícias reais das falsas.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiZnJvbSBza2xlYXJuLm1vZGVsX3NlbGVjdGlvbiBpbXBvcnQgdHJhaW5fdGVzdF9zcGxpdFxuaW1wb3J0IHBhbmRhcyBhcyBwZFxuZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKVxuZGYgPSBkZi5zZXRfaW5kZXgoXCJVbm5hbWVkOiAwXCIpICIsInNhbXBsZSI6IiNTZXQgYHlgIFxueSA9IGRmLl9fX19fIFxuIFxuIyBEcm9wIHRoZSBgbGFiZWxgIGNvbHVtbiBcbmRmLl9fX18oXCJsYWJlbFwiLCBheGlzPTEpIFxuIFxuIyBNYWtlIHRyYWluaW5nIGFuZCB0ZXN0IHNldHMgXG5YX3RyYWluLCBYX3Rlc3QsIHlfdHJhaW4sIHlfdGVzdCA9IF9fX19fX19fX19fX19fX18oZGZbJ3RleHQnXSwgeSwgdGVzdF9zaXplPTAuMzMsIHJhbmRvbV9zdGF0ZT01MykiLCJzb2x1dGlvbiI6IiMgU2V0IGB5YCBcbnkgPSBkZi5sYWJlbCBcblxuIyBEcm9wIHRoZSBgbGFiZWxgIGNvbHVtblxuZGYuZHJvcChcImxhYmVsXCIsIGF4aXM9MSlcblxuIyBNYWtlIHRyYWluaW5nIGFuZCB0ZXN0IHNldHMgXG5YX3RyYWluLCBYX3Rlc3QsIHlfdHJhaW4sIHlfdGVzdCA9IHRyYWluX3Rlc3Rfc3BsaXQoZGZbJ3RleHQnXSwgeSwgdGVzdF9zaXplPTAuMzMsIHJhbmRvbV9zdGF0ZT01MykiLCJzY3QiOiJ0ZXN0X29iamVjdChcInlcIilcbnRlc3Rfb2JqZWN0KFwiZGZcIilcbnRlc3Rfb2JqZWN0KFwiWF90ZXN0XCIsIGRvX2V2YWw9RmFsc2UsIHVuZGVmaW5lZF9tc2c9XCJEaWQgeW91IGRlZmluZSBgWF90ZXN0YD9cIilcbnRlc3Rfb2JqZWN0KFwiWF90cmFpblwiLCBkb19ldmFsPUZhbHNlLCB1bmRlZmluZWRfbXNnPVwiRGlkIHlvdSBkZWZpbmUgYFhfdHJhaW5gP1wiKVxudGVzdF9vYmplY3QoXCJ5X3RyYWluXCIsIGRvX2V2YWw9RmFsc2UsIHVuZGVmaW5lZF9tc2c9XCJEaWQgeW91IGRlZmluZSBgeV90cmFpbmA/XCIpXG50ZXN0X29iamVjdChcInlfdGVzdFwiLCBkb19ldmFsPUZhbHNlLCB1bmRlZmluZWRfbXNnPVwiRGlkIHlvdSBkZWZpbmUgYHlfdGVzdGA/XCIpXG5zdWNjZXNzX21zZyhcIkF3ZXNvbWUgam9iIVwiKSJ9

Construindo classificadores com vetorizadores

Agora que você tem os dados de treino e teste, pode construir os classificadores. Para avaliar se as palavras e tokens dos artigos impactam a classificação entre notícia real e falsa, começamos usando CountVectorizer e TfidfVectorizer.

No exemplo, há um limite máximo .7 definido no TF-IDF tfidf_vectorizer com o argumento max_df. Isso remove palavras que aparecem em mais de 70% dos artigos. Além disso, o parâmetro stop_words embutido remove stop words em inglês dos dados antes de vetorizá-los.

Existem muitos outros parâmetros — você pode conferir todos na documentação do scikit-learn para TfidfVectorizer e CountVectorizer.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuZnJvbSBza2xlYXJuLm1vZGVsX3NlbGVjdGlvbiBpbXBvcnQgdHJhaW5fdGVzdF9zcGxpdCBcbmZyb20gc2tsZWFybi5mZWF0dXJlX2V4dHJhY3Rpb24udGV4dCBpbXBvcnQgQ291bnRWZWN0b3JpemVyIFxuZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKVxuZGYgPSBkZi5zZXRfaW5kZXgoJ1VubmFtZWQ6IDAnKVxueSA9IGRmLmxhYmVsXG5kZiA9IGRmLmRyb3AoJ2xhYmVsJywgYXhpcz0xKVxuWF90cmFpbiwgWF90ZXN0LCB5X3RyYWluLCB5X3Rlc3QgPSB0cmFpbl90ZXN0X3NwbGl0KGRmWyd0ZXh0J10sIHksIHRlc3Rfc2l6ZT0wLjMzLCByYW5kb21fc3RhdGU9NTMpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIHRoZSBgY291bnRfdmVjdG9yaXplcmAgXG5jb3VudF92ZWN0b3JpemVyID0gX19fX19fX19fX19fX19fKHN0b3Bfd29yZHM9J2VuZ2xpc2gnKSBcblxuIyBGaXQgYW5kIHRyYW5zZm9ybSB0aGUgdHJhaW5pbmcgZGF0YSBcbmNvdW50X3RyYWluID0gY291bnRfdmVjdG9yaXplci5fX19fX19fX19fX19fKFhfdHJhaW4pIFxuXG4jIFRyYW5zZm9ybSB0aGUgdGVzdCBzZXRcbmNvdW50X3Rlc3QgPSBjb3VudF92ZWN0b3JpemVyLl9fX19fX19fXyhYX3Rlc3QpIiwic29sdXRpb24iOiIjIEluaXRpYWxpemUgdGhlIGBjb3VudF92ZWN0b3JpemVyYCBcbmNvdW50X3ZlY3Rvcml6ZXIgPSBDb3VudFZlY3Rvcml6ZXIoc3RvcF93b3Jkcz0nZW5nbGlzaCcpXG5cbiMgRml0IGFuZCB0cmFuc2Zvcm0gdGhlIHRyYWluaW5nIGRhdGEgXG5jb3VudF90cmFpbiA9IGNvdW50X3ZlY3Rvcml6ZXIuZml0X3RyYW5zZm9ybShYX3RyYWluKSBcblxuIyBUcmFuc2Zvcm0gdGhlIHRlc3Qgc2V0IFxuY291bnRfdGVzdCA9IGNvdW50X3ZlY3Rvcml6ZXIudHJhbnNmb3JtKFhfdGVzdCkiLCJzY3QiOiJ0ZXN0X29iamVjdChcImNvdW50X3ZlY3Rvcml6ZXJcIiwgZG9fZXZhbD1GYWxzZSlcbnRlc3Rfb2JqZWN0KFwiY291bnRfdHJhaW5cIiwgZG9fZXZhbD1GYWxzZSlcbnRlc3Rfb2JqZWN0KFwiY291bnRfdGVzdFwiLCBkb19ldmFsPUZhbHNlLCB1bmRlZmluZWRfbXNnPVwiRGlkIHlvdSBkZWZpbmUgYGNvdW50X3Rlc3RgP1wiKVxuc3VjY2Vzc19tc2coXCJHcmVhdCBqb2IhXCIpIn0=
 
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuZnJvbSBza2xlYXJuLm1vZGVsX3NlbGVjdGlvbiBpbXBvcnQgdHJhaW5fdGVzdF9zcGxpdCBcbmZyb20gc2tsZWFybi5mZWF0dXJlX2V4dHJhY3Rpb24udGV4dCBpbXBvcnQgVGZpZGZWZWN0b3JpemVyIFxuZFYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKVxuZGYgPSBkZi5zZXRfaW5kZXgoJ1VubmFtZWQ6IDAnKVxueSA9IGRmLmxhYmVsXG5kZiA9IGRmLmRyb3AoJ2xhYmVsJywgYXhpcz0xKVxuWF90cmFpbiwgWF90ZXN0LCB5X3RyYWluLCB5X3Rlc3QgPSB0cmFpbl90ZXN0X3NwbGl0KGRmWyd0ZXh0J10sIHksIHRlc3Rfc2l6ZT0wLjMzLCByYW5kb21fc3RhdGU9NTMpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIHRoZSBgdGZpZGZfdmVjdG9yaXplcmBcbnRmaWRmX3ZlY3Rvcml6ZXIgPSBfX19fX19fX19fX19fX18oc3RvcF93b3Jkcz0nZW5nbGlzaCcsIG1heF9kZj0wLjcpIFxuXG4jIEZpdCBhbmQgdHJhbnNmb3JtIHRoZSB0cmFpbmluZyBkYXRhIFxudGZpZGZfdHJhaW4gPSB0ZmlkZl92ZWN0b3JpemVyLl9fX19fX19fX19fX18oWF90cmFpbikgXG5cbiMgVHJhbnNmb3JtIHRoZSB0ZXN0IHNldCBcbnRmaWRmX3Rlc3QgPSB0ZmlkZl92ZWN0b3JpemVyLl9fX19fX19fXyhYX3Rlc3QpIiwic29sdXRpb24iOiIjIEluaXRpYWxpemUgdGhlIGB0ZmlkZl92ZWN0b3JpemVyYCBcbnRmaWRmX3ZlY3Rvcml6ZXIgPSBUZmlkZlZlY3Rvcml6ZXIoc3RvcF93b3Jkcz0nZW5nbGlzaCcsIG1heF9kZj0wLjcpIFxuXG4jIEZpdCBhbmQgdHJhbnNmb3JtIHRoZSB0cmFpbmluZyBkYXRhIFxudGZpZGZfdHJhaW4gPSB0ZmlkZl92ZWN0b3JpemVyLmZpdF90cmFuc2Zvcm0oWF90cmFpbikgXG5cbiMgVHJhbnNmb3JtIHRoZSB0ZXN0IHNldCBcbnRmaWRmX3Rlc3QgPSB0ZmlkZl92ZWN0b3JpemVyLnRyYW5zZm9ybShYX3Rlc3QpIiwic2N0IjoidGVzdF9vYmplY3QoXCJ0ZmlkZl92ZWN0b3JpemVyXCIsIGRvX2V2YWw9RmFsc2UpXG50ZXN0X29iamVjdChcInRmaWRmX3RyYWluXCIsIGRvX2V2YWw9RmFsc2UpXG50ZXN0X29iamVjdChcInRmaWRmX3Rlc3RcIiwgZG9fZXZhbD1GYWxzZSwgdW5kZWZpbmVkX21zZz1cIkRpZCB5b3UgZGVmaW5lIGBjb3VudF90ZXN0YD9cIilcbnN1Y2Nlc3NfbXNnKFwiV2VsbCBkb25lIVwiKSJ9

Com os vetores prontos, você pode inspecionar as features geradas, armazenadas em count_vectorizer e tfidf_vectorizer.

Há algum problema visível? (Sim!)

Claramente existem comentários, medidas ou outras palavras sem sentido, além de artigos em vários idiomas no dataset. Normalmente, você deveria investir mais tempo no pré-processamento e na remoção de ruído, mas como este tutorial é apenas uma prova de conceito rápida, vamos ver se o modelo consegue superar o ruído e classificar corretamente apesar desses problemas.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuZnJvbSBza2xlYXJuLm1vZGVsX3NlbGVjdGlvbiBpbXBvcnQgdHJhaW5fdGVzdF9zcGxpdFxuZnJvbSBza2xlYXJuLmZlYXR1cmVfZXh0cmFjdGlvbi50ZXh0IGltcG9ydCBUZmlkZlZlY3Rvcml6ZXIsIENvdW50VmVjdG9yaXplciBcbmRmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9mYWtlX29yX3JlYWxfbmV3cy5jc3ZcIilcbmRmID0gZGYuc2V0X2luZGV4KCdVbm5hbWVkOiAwJylcbnkgPSBkZi5sYWJlbFxuZGYgPSBkZi5kcm9wKCdsYWJlbCcsIGF4aXM9MSlcblhfdHJhaW4sIFhfdGVzdCwgeV90cmFpbiwgeV90ZXN0ID0gdHJhaW5fdGVzdF9zcGxpdChkZlsndGV4dCddLCB5LCB0ZXN0X3NpemU9MC4zMywgcmFuZG9tX3N0YXRlPTUzKVxudGZpZGZfdmVjdG9yaXplciA9IFRmaWRmVmVjdG9yaXplcihzdG9wX3dvcmRzPSdlbmdsaXNoJywgbWF4X2RmPTAuNylcbnRmaWRmX3RyYWluID0gdGZpZGZfdmVjdG9yaXplci5maXRfdHJhbnNmb3JtKFhfdHJhaW4pXG50ZmlkZl90ZXN0ID0gdGZpZGZfdmVjdG9yaXplci50cmFuc2Zvcm0oWF90ZXN0KVxuY291bnRfdmVjdG9yaXplciA9IENvdW50VmVjdG9yaXplcihzdG9wX3dvcmRzPSdlbmdsaXNoJylcbmNvdW50X3RyYWluID0gY291bnRfdmVjdG9yaXplci5maXRfdHJhbnNmb3JtKFhfdHJhaW4pIFxuY291bnRfdGVzdCA9IGNvdW50X3ZlY3Rvcml6ZXIudHJhbnNmb3JtKFhfdGVzdCkiLCJzYW1wbGUiOiIjIEdldCB0aGUgZmVhdHVyZSBuYW1lcyBvZiBgdGZpZGZfdmVjdG9yaXplcmAgXG5wcmludCh0ZmlkZl92ZWN0b3JpemVyLl9fX19fX19fX19fKClbLTEwOl0pXG5cbiMgR2V0IHRoZSBmZWF0dXJlIG5hbWVzIG9mIGBjb3VudF92ZWN0b3JpemVyYCBcbnByaW50KGNvdW50X3ZlY3Rvcml6ZXIuX19fX19fX19fX18oKVs6MTBdKSIsInNvbHV0aW9uIjoiIyBHZXQgdGhlIGZlYXR1cmUgbmFtZXMgb2YgYHRmaWRmX3ZlY3Rvcml6ZXJgIFxucHJpbnQodGZpZGZfdmVjdG9yaXplci5nZXRfZmVhdHVyZV9uYW1lcygpWy0xMDpdKVxuXG4jIEdldCB0aGUgZmVhdHVyZSBuYW1lcyBvZiBgY291bnRfdmVjdG9yaXplcmAgXG5wcmludChjb3VudF92ZWN0b3JpemVyLmdldF9mZWF0dXJlX25hbWVzKClbOjEwXSkiLCJzY3QiOiJ0ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgMSlcbnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCAyKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Intermezzo: contagem vs. TF-IDF

Fiquei curioso para saber se os vetorizadores de contagem e de TF-IDF extraíram tokens diferentes. Para comparar as features, você pode trazer as informações de volta para um DataFrame e fazer comparações em Python com facilidade.

Rodando as células abaixo, dá para ver que ambos extraíram os mesmos tokens, mas com pesos diferentes. Alterar max_df e min_df do TF-IDF provavelmente mudaria o resultado e levaria a features diferentes em cada um.

In [15]:
 count_df = pd.DataFrame(count_train.A, columns=count_vectorizer.get_feature_names())
In [16]:
tfidf_df = pd.DataFrame(tfidf_train.A, columns=tfidf_vectorizer.get_feature_names())
In [17]:
difference = set(count_df.columns) - set(tfidf_df.columns)difference
Out[17]:
set()
In [18]:
print(count_df.equals(tfidf_df))
False
In [19]:
count_df.head()
Out[19]:
 000000000000000310000350000600010001pt000ft000km...حلبعربيعنلممامحاولاتمنهذاوالمرضىยงade
00000000000...0000000000
10000000000...0000000000
20000000000...0000000000
30000000000...0000000000
40000000000...0000000000

5 rows × 56922 columns

In [20]:
tfidf_df.head()
Out[20]:
 000000000000000310000350000600010001pt000ft000km...حلبعربيعنلممامحاولاتمنهذاوالمرضىยงade
00.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0
10.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0
20.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0
30.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0
40.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0

5 rows × 56922 columns

Comparando modelos

Hora de treinar e testar os modelos.

Vamos começar com um favorito do NLP, o MultinomialNB. Você pode usá-lo para comparar TF-IDF com bag-of-words. Minha intuição era que bag-of-words (ou CountVectorizer) funcionaria melhor com esse modelo. (Para entender a distribuição multinomial e por que ela funciona melhor com inteiros, confira esta explicação sucinta de um curso de estatística da UPenn.)

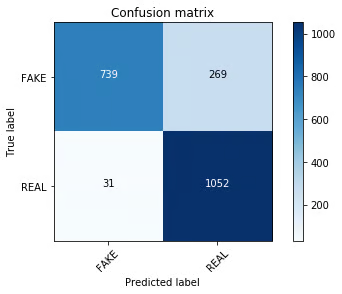
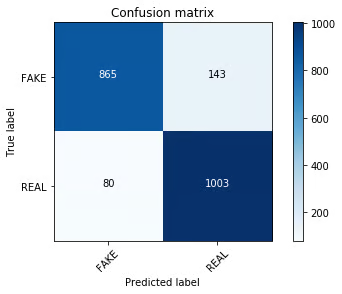
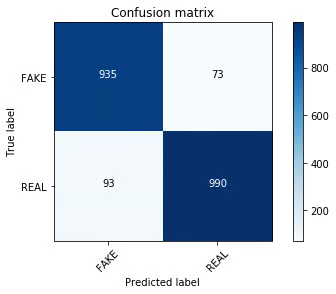
Pessoalmente, acho Matrizes de Confusão mais fáceis de ler e comparar, então usei a documentação do scikit-learn para construir versões legíveis (valeu, open source!). A matriz de confusão mostra os rótulos corretos na diagonal principal (do canto superior esquerdo ao inferior direito). As outras células mostram rótulos incorretos, os famosos falsos positivos e falsos negativos. Dependendo do problema, um deles pode ser mais crítico. Por exemplo, em fake news, é mais importante não rotular notícias reais como falsas? Se sim, talvez valha ponderar a métrica de acurácia para refletir essa preocupação.

Além de Matrizes de Confusão, o scikit-learn oferece várias formas de visualizar e comparar modelos. Uma bem popular é usar a curva ROC. Há muitos outros recursos de avaliação disponíveis no módulo metrics.

In [21]:
def plot_confusion_matrix(cm, classes,                          normalize=False,                          title='Confusion matrix',                          cmap=plt.cm.Blues):    """    See full source and example:     http://scikit-learn.org/stable/auto_examples/model_selection/plot_confusion_matrix.html        This function prints and plots the confusion matrix.    Normalization can be applied by setting `normalize=True`.    """    plt.imshow(cm, interpolation='nearest', cmap=cmap)    plt.title(title)    plt.colorbar()    tick_marks = np.arange(len(classes))    plt.xticks(tick_marks, classes, rotation=45)    plt.yticks(tick_marks, classes)    if normalize:        cm = cm.astype('float') / cm.sum(axis=1)[:, np.newaxis]        print("Normalized confusion matrix")    else:        print('Confusion matrix, without normalization')    thresh = cm.max() / 2.    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):        plt.text(j, i, cm[i, j],                 horizontalalignment="center",                 color="white" if cm[i, j] > thresh else "black")    plt.tight_layout()    plt.ylabel('True label')    plt.xlabel('Predicted label')
In [22]:
clf = MultinomialNB()
In [23]:
 clf.fit(tfidf_train, y_train)pred = clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.857Confusion matrix, without normalization
 
confusion matrix 1
In [24]:
clf = MultinomialNB() 
In [25]:
clf.fit(count_train, y_train)pred = clf.predict(count_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.893Confusion matrix, without normalization
 
confusion matrix 2
 

E de fato, sem nenhum ajuste de parâmetro, o conjunto vetorizado por contagem count_train teve desempenho visivelmente melhor que os vetores TF-IDF!

Testando modelos lineares

Há muitos materiais mostrando que modelos lineares funcionam muito bem com vetorizadores TF-IDF (veja word2vec para classificação, a referência de SVM na análise de texto do scikit-learn e outros).

Então é só usar SVM, certo?

Recentemente, assisti à aula do Victor Lavrenko sobre classificação de texto, em que ele compara classificadores Passive Aggressive com SVMs lineares para texto. Vamos testar essa abordagem (que tem ganhos de velocidade relevantes, mas desvantagens de aprendizado “permanente”) com o dataset de fake news.

In [26]:
linear_clf = PassiveAggressiveClassifier(n_iter=50)
In [27]:
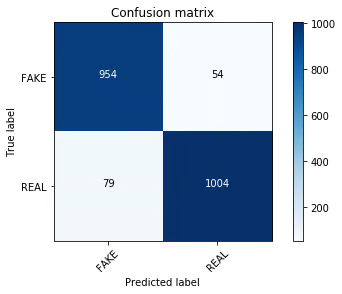
 linear_clf.fit(tfidf_train, y_train)pred = linear_clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.936Confusion matrix, without normalization
confusion matrix 3

Uau!

Impressiona. A matriz de confusão ficou diferente e o modelo classificou um pouco melhor as fake news. Podemos testar se ajustar o alpha do MultinomialNB gera resultados comparáveis. Você também pode usar ajuste de parâmetros com grid search para uma busca mais ampla.

In [28]:
clf = MultinomialNB(alpha=0.1)
In [29]:
 last_score = 0for alpha in np.arange(0,1,.1):    nb_classifier = MultinomialNB(alpha=alpha)    nb_classifier.fit(tfidf_train, y_train)    pred = nb_classifier.predict(tfidf_test)    score = metrics.accuracy_score(y_test, pred)    if score > last_score:        clf = nb_classifier    print("Alpha: {:.2f} Score: {:.5f}".format(alpha, score))
Alpha: 0.00 Score: 0.61502Alpha: 0.10 Score: 0.89766Alpha: 0.20 Score: 0.89383Alpha: 0.30 Score: 0.89000Alpha: 0.40 Score: 0.88570Alpha: 0.50 Score: 0.88427Alpha: 0.60 Score: 0.87470Alpha: 0.70 Score: 0.87040Alpha: 0.80 Score: 0.86609Alpha: 0.90 Score: 0.85892

Nem tanto… Neste ponto, pode ser interessante ajustar parâmetros em todos os classificadores, ou explorar outros classificadores bayesianos do scikit-learn. Você também pode testar uma Support Vector Machine (SVM) para ver se supera o Passive Aggressive.

Mas estou mais curioso para saber o que o modelo Passive Aggressive realmente aprendeu. Vamos à introspecção.

Fazendo introspecção dos modelos

Então, fake news resolvida, certo? Conseguimos 93% de acurácia — missão cumprida.

Claro que não. Eu, no mínimo, fico cauteloso com esses resultados, dado o quanto de ruído vimos nas features. Há uma ótima resposta no StackOverflow com uma função muito útil para encontrar os vetores que mais afetam os rótulos. Ela só funciona para classificação binária (2 classes), o que é perfeito aqui, já que temos apenas FAKE e REAL.

Usando o classificador de melhor desempenho com o dataset TF-IDF (tfidf_vectorizer) e o Passive Aggressive (linear_clf), inspecione os 30 principais vetores para fake e real:

In [30]:
FAKE -4.86382369883 2016FAKE -4.13847157932 hillaryFAKE -3.98994974843 octoberFAKE -3.10552662226 shareFAKE -2.99713810694 novemberFAKE -2.9150746075 articleFAKE -2.54532100449 printFAKE -2.47115243995 advertisementFAKE -2.35915304509 sourceFAKE -2.31585837413 emailFAKE -2.27985826579 electionFAKE -2.2736680857 octFAKE -2.25253568246 warFAKE -2.19663276969 mosulFAKE -2.17921304122 podestaFAKE -1.99361009573 novFAKE -1.98662624907 comFAKE -1.9452527887 establishmentFAKE -1.86869495684 corporateFAKE -1.84166664376 wikileaksFAKE -1.7936566878 26FAKE -1.75686475396 donaldFAKE -1.74951154055 snipFAKE -1.73298170472 mainstreamFAKE -1.71365596627 ukFAKE -1.70917804969 ayotteFAKE -1.70781651904 entireFAKE -1.68272667818 jewishFAKE -1.65334397724 youtubeFAKE -1.6241703128 pipelineREAL 4.78064061698 saidREAL 2.68703967567 tuesdayREAL 2.48309800829 gopREAL 2.45710670245 islamicREAL 2.44326123901 saysREAL 2.29424417889 cruzREAL 2.29144842597 marriageREAL 2.20500735471 candidatesREAL 2.19136552672 conservativeREAL 2.18030834903 mondayREAL 2.05688105375 attacksREAL 2.03476457362 rushREAL 1.9954523319 continueREAL 1.97002430576 fridayREAL 1.95034103105 conventionREAL 1.94620720989 senREAL 1.91185661202 jobsREAL 1.87501303774 debateREAL 1.84059602241 presumptiveREAL 1.80111133252 sayREAL 1.80027216061 sundayREAL 1.79650823765 marchREAL 1.79229792108 parisREAL 1.74587899553 securityREAL 1.69585506276 conservativesREAL 1.68860503431 recountsREAL 1.67424302821 dealREAL 1.67343398121 campaignREAL 1.66148582079 foxREAL 1.61425630518 attack

Você também pode fazer isso de forma bem direta com poucas linhas de Python, juntando os coeficientes às features e olhando o topo e a base da lista.

In [31]:
feature_names = tfidf_vectorizer.get_feature_names()
In [32]:
### Most realsorted(zip(clf.coef_[0], feature_names), reverse=True)[:20]
Out[32]:
[(-6.2573612147015822, 'trump'), (-6.4944530943126777, 'said'), (-6.6539784739838845, 'clinton'), (-7.0379446628670728, 'obama'), (-7.1465399833812278, 'sanders'), (-7.2153760086475112, 'president'), (-7.2665628057416169, 'campaign'), (-7.2875931446681514, 'republican'), (-7.3411184585990643, 'state'), (-7.3413571102479054, 'cruz'), (-7.3783124419854254, 'party'), (-7.4468806724578904, 'new'), (-7.4762888011545883, 'people'), (-7.547225599514773, 'percent'), (-7.5553074094582335, 'bush'), (-7.5801506339098932, 'republicans'), (-7.5855405012652435, 'house'), (-7.6344781725203141, 'voters'), (-7.6484824436952987, 'rubio'), (-7.6734836186463795, 'states')]
In [33]:
### Most fakesorted(zip(clf.coef_[0], feature_names))[:20]
Out[33]:
[(-11.349866225220305, '0000'), (-11.349866225220305, '000035'), (-11.349866225220305, '0001'), (-11.349866225220305, '0001pt'), (-11.349866225220305, '000km'), (-11.349866225220305, '0011'), (-11.349866225220305, '006s'), (-11.349866225220305, '007'), (-11.349866225220305, '007s'), (-11.349866225220305, '008s'), (-11.349866225220305, '0099'), (-11.349866225220305, '00am'), (-11.349866225220305, '00p'), (-11.349866225220305, '00pm'), (-11.349866225220305, '014'), (-11.349866225220305, '015'), (-11.349866225220305, '018'), (-11.349866225220305, '01am'), (-11.349866225220305, '020'), (-11.349866225220305, '023')]

Fica claro que há certas palavras que indicam intenção política e fonte entre as principais features de fake (como corporate e establishment).

Também dá para ver que as notícias reais usam mais formas do verbo “say”, provavelmente porque em jornais e publicações jornalísticas as fontes são citadas diretamente (“A chanceler alemã Angela Merkel said…”).

Para extrair a lista completa do classificador atual e analisar cada token (ou comparar facilmente entre classificadores), você pode exportar assim:

In [34]:
tokens_with_weights = sorted(list(zip(feature_names, clf.coef_[0])))

Intermezzo: HashingVectorizer

Outro vetorizador usado às vezes para classificação de texto é o HashingVectorizer. Ele consome menos memória e é mais rápido (por ser esparso e usar hashes em vez de tokens), mas é mais difícil de inspecionar. Você pode ler mais sobre prós e contras do HashingVectorizer na documentação do scikit-learn.

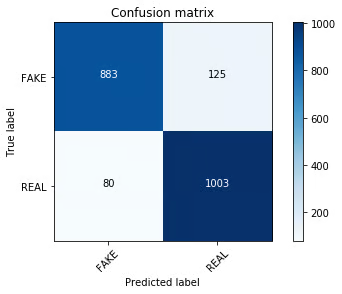
Vale testar e comparar seus resultados com os outros vetorizadores. Ele vai bem — melhor que o TF-IDF com MultinomialNB (o que já era esperado pelos mesmos motivos de CountVectorizer) —, mas não supera o TF-IDF com o algoritmo linear Passive Aggressive.

In [35]:
hash_vectorizer = HashingVectorizer(stop_words='english', non_negative=True)hash_train = hash_vectorizer.fit_transform(X_train)hash_test = hash_vectorizer.transform(X_test)
In [36]:
clf = MultinomialNB(alpha=.01)
In [37]:
clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.902Confusion matrix, without normalization
 
confusion matrix 4
In [38]:
clf = PassiveAggressiveClassifier(n_iter=50)
In [39]:
clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.921Confusion matrix, without normalization
confusion matrix 5

Conclusão

Será que o seu experimento de classificador de fake news foi um sucesso? Definitivamente não.

Mas você pôde explorar um dataset novo, testar alguns modelos de classificação em NLP e inspecionar o quão bem eles funcionaram? Sim.

Como esperado desde o início, definir fake news com bag-of-words ou TF-IDF é uma abordagem simplista — ainda mais com um dataset multilíngue cheio de ruído. Se você não tivesse olhado o que o modelo realmente aprendeu, poderia achar que ele capturou algo significativo. Então, lembre-se: sempre faça introspecção dos seus modelos (na medida do possível!).

Fico curioso para saber se você encontra outras tendências nos dados que eu possa ter deixado passar. Vou publicar um post comparando como diferentes classificadores se comportam em relação às features mais importantes no meu blog. Se você pesquisar e achar algo interessante, compartilhe nos comentários ou fale comigo no Twitter (sou @kjam).

Espero que você tenha se divertido explorando um novo dataset de NLP comigo!

Dê uma olhada no Python Machine Learning: Scikit-Learn Tutorial da DataCamp.

Tópicos
Python
Ciência de dados
Aprendizado de máquina

Cursos de machine learning

Curso

Aprendizado Supervisionado com scikit-learn

4 h
302.3K
Aprimore suas habilidades em aprendizado de máquina com scikit-learn e dados reais. Aprenda a fazer previsões poderosas em Python!
Ver detalhesRight Arrow
Iniciar Curso
Ver maisRight Arrow
Relacionado

Tutorial

Tutorial de manipulação de dados categóricos de aprendizado de máquina com Python

Aprenda os truques comuns para lidar com dados categóricos e pré-processá-los para criar modelos de aprendizado de máquina!
Moez Ali's photo

Moez Ali

14 min

Tutorial

Entendendo data drift e model drift: detecção de drift em Python

Navegue pelos riscos do model drift e confira nosso guia prático de monitoramento de data drift.
Moez Ali's photo

Moez Ali

9 min

Tutorial

Tutorial de análise de sentimentos com NLTK para iniciantes

Tutorial de análise de sentimentos com NLTK (Natural Language Toolkit) em Python. Aprenda a criar e desenvolver análises de sentimentos usando Python. Siga etapas específicas para realizar a mineração e análise de textos e fazer o processamento de linguagem natural.
Moez Ali's photo

Moez Ali

13 min

Clustering k-means

Tutorial

Introdução ao k-Means Clustering com o scikit-learn em Python

Neste tutorial, saiba como aplicar o k-Means Clustering com o scikit-learn em Python

Kevin Babitz

8 min

Python

Tutorial

Tutorial para entender a regressão logística em Python

Aprenda sobre a regressão logística, suas propriedades básicas e crie um modelo de aprendizado de máquina em um aplicativo do mundo real em Python.
Avinash Navlani's photo

Avinash Navlani

10 min

Tutorial

Stemming e lematização em Python

Este tutorial aborda o stemming e a lematização de um ponto de vista prático usando o pacote Python Natural Language ToolKit (NLTK).
Kurtis Pykes 's photo

Kurtis Pykes

12 min

Ver MaisVer Mais