Cursus
Supervised Learning met scikit-learn
4 uur
305.8K
Het detecteren van zogenaamd “nepnieuws” is geen eenvoudige taak. Om te beginnen moet je definiëren wat nepnieuws is – een term die inmiddels ook een politieke lading heeft gekregen. Als je een definitie kunt vinden of overeenkomen, moet je vervolgens echt en nep nieuws verzamelen en correct labelen (bij voorkeur over vergelijkbare onderwerpen om duidelijke verschillen te laten zien). Eenmaal verzameld, moet je vervolgens bruikbare features vinden om nep van echt nieuws te onderscheiden.
Voor een diepgaandere kijk op dit probleem raad ik het artikel van Miguel Martinez-Alvarez aan: “How can Machine Learning and AI Help Solve the Fake News Problem”.
Ongeveer in dezelfde periode dat ik Miguels inzichtelijke post las, kwam ik een post op Open Data Science tegen over het bouwen van een succesvolle nepnieuwsdetector met Bayesiaanse modellen. De auteur maakte zelfs een repository met de dataset van gelabelde nep- en echte nieuwsvoorbeelden. Ik was benieuwd of ik de resultaten eenvoudig kon reproduceren en of ik vervolgens kon achterhalen wat het model had geleerd.
In deze tutorial loop je mee met een deel van mijn eerste verkenning en kijk je of je een succesvolle nepnieuwsdetector kunt bouwen!
Tip: wil je meer leren over de basis van Natural Language Processing (NLP), overweeg dan de cursus Natural Language Processing Fundamentals in Python.
Begin altijd met een snelle blik op de data om gevoel te krijgen bij de inhoud. Gebruik hiervoor een Pandas DataFrame en controleer de shape, head en pas waar nodig transformaties toe.
Nu de DataFrame meer lijkt op wat je nodig hebt, wil je de labels scheiden en trainings- en testdatasets instellen.
Voor dit notebook heb ik ervoor gekozen me te richten op de langere artikeltekst. Omdat ik wist dat ik bag-of-words en Term Frequency–Inverse Document Frequency (TF-IDF) zou gebruiken om features te extraheren, leek dit een goede keuze. Door langere tekst te gebruiken, krijg je hopelijk onderscheidende woorden en features voor mijn echte en nepnieuwsdata.
Nu je je trainings- en testdata hebt, kun je je classifiers bouwen. Om een goed beeld te krijgen of de woorden en tokens in de artikelen een significante invloed hadden op de vraag of het nieuws nep of echt was, begin je met CountVectorizer en TfidfVectorizer.
Je ziet dat in het voorbeeld een maximale drempel is ingesteld op .7 voor de TF-IDF-vectorizer tfidf_vectorizer met het argument max_df. Dit verwijdert woorden die in meer dan 70% van de artikelen voorkomen. Ook verwijdert de ingebouwde parameter stop_words Engelse stopwoorden uit de data voordat er vectors worden gemaakt.
Er zijn nog veel meer parameters beschikbaar en je kunt er alles over lezen in de scikit-learn-documentatie voor TfidfVectorizer en CountVectorizer.
Nu je vectors hebt, kun je vervolgens kijken naar de vectorfeatures, opgeslagen in count_vectorizer en tfidf_vectorizer.
Zie je opvallende problemen? (Ja!)
Er zitten duidelijk commentaren, metingen of andere onsamenhangende woorden in, evenals meertalige artikelen in de dataset die je gebruikt hebt. Normaal gesproken zou je meer tijd besteden aan preprocessing en het verwijderen van ruis, maar omdat deze tutorial slechts een kleine proof of concept laat zien, kijk je of het model de ruis kan overwinnen en ondanks deze problemen correct kan classificeren.
Ik was benieuwd of mijn count- en TF-IDF-vectorizers verschillende tokens hadden geëxtraheerd. Om dit te bekijken en features te vergelijken, kun je de vectorinformatie terug in een DataFrame zetten om eenvoudige Python-vergelijkingen te maken.
Zoals je ziet als je de cellen hieronder uitvoert, hebben beide vectorizers dezelfde tokens geëxtraheerd, maar uiteraard met verschillende gewichten. Waarschijnlijk kan het aanpassen van de max_df en min_df van de TF-IDF-vectorizer het resultaat veranderen en tot verschillende features in elk leiden.
count_df = pd.DataFrame(count_train.A, columns=count_vectorizer.get_feature_names())tfidf_df = pd.DataFrame(tfidf_train.A, columns=tfidf_vectorizer.get_feature_names())difference = set(count_df.columns) - set(tfidf_df.columns)differenceprint(count_df.equals(tfidf_df))count_df.head()tfidf_df.head()Tijd om je modellen te trainen en te testen.
Hier begin je met een NLP-favoriet, MultinomialNB. Hiermee kun je TF-IDF vergelijken met bag-of-words. Mijn intuïtie was dat bag-of-words (oftewel CountVectorizer) beter zou presteren met dit model. (Voor meer over multinomiale verdelingen en waarom die het best werken met gehele getallen, bekijk deze korte uitleg uit een UPenn-statistiekcursus).
Persoonlijk vind ik confusion matrices makkelijker te vergelijken en te lezen, dus gebruikte ik de scikit-learn-documentatie om een paar goed leesbare confusion matrices te bouwen (dank je, open source!). Een confusion matrix toont de correcte labels op de hoofddiagonaal (linksboven naar rechtsonder). De andere cellen tonen de onjuiste labels, vaak false positives of false negatives genoemd. Afhankelijk van je probleem kan één van die twee zwaarder wegen. Bijvoorbeeld: bij het nepnieuwsprobleem is het belangrijker dat we echte artikelen niet als nep labelen? Zo ja, dan willen we onze accuracyscore uiteindelijk misschien wegen om deze zorg beter te weerspiegelen.
Naast confusion matrices biedt scikit-learn veel manieren om je modellen te visualiseren en te vergelijken. Een populaire manier is een ROC-curve gebruiken. Er zijn veel andere manieren om je model te evalueren in de scikit-learn metrics-module.
def plot_confusion_matrix(cm, classes, normalize=False, title='Confusion matrix', cmap=plt.cm.Blues): """ See full source and example: http://scikit-learn.org/stable/auto_examples/model_selection/plot_confusion_matrix.html This function prints and plots the confusion matrix. Normalization can be applied by setting `normalize=True`. """ plt.imshow(cm, interpolation='nearest', cmap=cmap) plt.title(title) plt.colorbar() tick_marks = np.arange(len(classes)) plt.xticks(tick_marks, classes, rotation=45) plt.yticks(tick_marks, classes) if normalize: cm = cm.astype('float') / cm.sum(axis=1)[:, np.newaxis] print("Normalized confusion matrix") else: print('Confusion matrix, without normalization') thresh = cm.max() / 2. for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])): plt.text(j, i, cm[i, j], horizontalalignment="center", color="white" if cm[i, j] > thresh else "black") plt.tight_layout() plt.ylabel('True label') plt.xlabel('Predicted label')clf = MultinomialNB() clf.fit(tfidf_train, y_train)pred = clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.857Confusion matrix, without normalization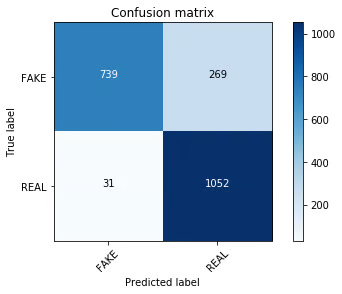
clf = MultinomialNB() clf.fit(count_train, y_train)pred = clf.predict(count_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.893Confusion matrix, without normalization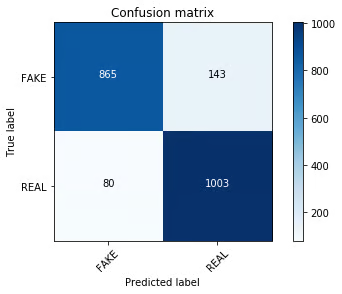
En inderdaad, zonder enige parameterafstemming presteert je getelde, gevectoriseerde trainingsset count_train zichtbaar beter dan je TF-IDF-vectors!
Er zijn veel goede stukken geschreven over hoe lineaire modellen goed werken met TF-IDF-vectorizers (bekijk word2vec voor classificatie, SVM-referentie in scikit-learn-tekstanalyse, en meer).
Dus je zou een SVM moeten gebruiken, toch?
Nou, ik keek onlangs Victor Lavrenko’s college over tekstclassificatie en hij vergelijkt Passive Aggressive-classifiers met lineaire SVM’s voor tekstclassificatie. We testen deze aanpak (die aanzienlijke snelheidsvoordelen en blijvende leer-nadelen heeft) met de nepnieuwsdataset.
linear_clf = PassiveAggressiveClassifier(n_iter=50) linear_clf.fit(tfidf_train, y_train)pred = linear_clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.936Confusion matrix, without normalization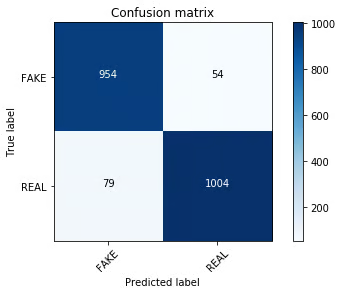
Wauw!
Ik ben onder de indruk. De confusion matrix ziet er anders uit en het model classificeert ons nepnieuws wat beter. We kunnen testen of het afstemmen van de alpha-waarde voor een MultinomialNB vergelijkbare resultaten oplevert. Je kunt ook parametertuning met grid search gebruiken voor een meer uitputtende zoektocht.
clf = MultinomialNB(alpha=0.1) last_score = 0for alpha in np.arange(0,1,.1): nb_classifier = MultinomialNB(alpha=alpha) nb_classifier.fit(tfidf_train, y_train) pred = nb_classifier.predict(tfidf_test) score = metrics.accuracy_score(y_test, pred) if score > last_score: clf = nb_classifier print("Alpha: {:.2f} Score: {:.5f}".format(alpha, score))Net niet... Op dit punt is het interessant om parametertuning uit te voeren over alle classifiers, of te kijken naar andere Bayesiaanse classifiers in scikit-learn. Je kunt ook een Support Vector Machine (SVM) testen om te zien of die beter presteert dan de Passive Aggressive-classifier.
Maar ik ben nog iets benieuwder naar wat het Passive Aggressive-model eigenlijk heeft geleerd. Dus door naar introspectie.
Dus nepnieuws is opgelost, toch? We haalden 93% nauwkeurigheid op mijn dataset, dus we kunnen inpakken en naar huis.
Natuurlijk niet. Ik ben op zijn best voorzichtig met deze resultaten, gezien de hoeveelheid ruis die we in de features zagen. Er is een prima uitleg op StackOverflow met een ontzettend handige functie om vectors te vinden die labels het meest beïnvloeden. Hij werkt alleen voor binaire classificatie (classifiers met 2 klassen), maar dat is goed nieuws voor jou, want je hebt alleen FAKE- of REAL-labels.
Gebruik je best presterende classifier met je TF-IDF-vectordataset (tfidf_vectorizer) en Passive Aggressive-classifier (linear_clf) en bekijk de top 30 vectors voor nep en echt nieuws:
Je kunt dit ook op een vrij voor de hand liggende manier doen met maar een paar regels Python, door je coëfficiënten te zippen met je features en naar de boven- en onderkant van je lijst te kijken.
feature_names = tfidf_vectorizer.get_feature_names()### Most realsorted(zip(clf.coef_[0], feature_names), reverse=True)[:20]### Most fakesorted(zip(clf.coef_[0], feature_names))[:20]Er zijn dus duidelijk bepaalde woorden die politieke intentie en bron kunnen aangeven in de top-nepfeatures (zoals de woorden corporate en establishment).
Ook gebruikt echte nieuwsdata vaker vormen van het werkwoord “to say”, waarschijnlijk omdat in kranten en de meeste journalistieke publicaties bronnen direct worden geciteerd (“De Duitse bondskanselier Angela Merkel zei...” ).
Om de volledige lijst uit je huidige classifier te halen en elk token te bekijken (of tokens eenvoudig van classifier tot classifier te vergelijken), kun je die zo exporteren.
tokens_with_weights = sorted(list(zip(feature_names, clf.coef_[0])))Een andere vectorizer die soms wordt gebruikt voor tekstclassificatie is een HashingVectorizer. HashingVectorizers hebben minder geheugen nodig en zijn sneller (omdat ze schaars zijn en hashes gebruiken in plaats van tokens) maar zijn lastiger te introspecteren. Je kunt wat meer lezen over de voor- en nadelen van het gebruik van HashingVectorizer in de scikit-learn-documentatie als je geïnteresseerd bent.
Je kunt ‘m proberen en de resultaten vergelijken met de andere vectorizers. Hij presteert behoorlijk, met betere resultaten dan de TF-IDF-vectorizer met MultinomialNB (dat is enigszins te verwachten om dezelfde redenen waarom CountVectorizers beter presteren), maar niet zo goed als de TF-IDF-vectorizer met het Passive Aggressive-lineaire algoritme.
hash_vectorizer = HashingVectorizer(stop_words='english', non_negative=True)hash_train = hash_vectorizer.fit_transform(X_train)hash_test = hash_vectorizer.transform(X_test)clf = MultinomialNB(alpha=.01)clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.902Confusion matrix, without normalization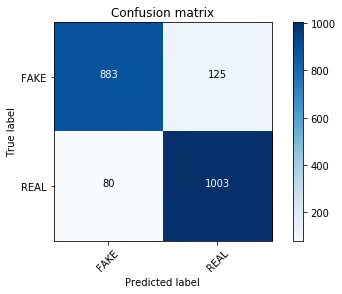
clf = PassiveAggressiveClassifier(n_iter=50)clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.921Confusion matrix, without normalization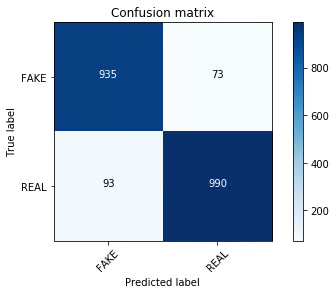
Was je experiment met een nepnieuwsklasseerder een succes? Zeker niet.
Maar heb je kunnen spelen met een nieuwe dataset, een paar NLP-classificatiemodellen getest en onderzocht hoe succesvol ze waren? Ja.
Zoals vanaf het begin verwacht, is nepnieuws definiëren met simpele bag-of-words- of TF-IDF-vectors een te simplistische aanpak. Zeker met een meertalige dataset vol ruisige tokens. Als je niet had gekeken naar wat je model daadwerkelijk had geleerd, had je misschien gedacht dat het model iets betekenisvols had geleerd. Dus onthoud: introspecteer je modellen altijd (zover je kunt!).
Ik ben benieuwd of jij andere trends in de data vindt die ik gemist heb. Ik kom hierop terug met een post over hoe verschillende classifiers zich verhouden qua belangrijke features op mijn blog. Als je tijd steekt in onderzoek en iets interessants vindt, deel je bevindingen en notities dan gerust in de comments of neem contact op via Twitter (ik ben @kjam).
Ik hoop dat je plezier had in het verkennen van een nieuwe NLP-dataset!
Bekijk ook DataCamp’s Python Machine Learning: Scikit-Learn Tutorial.
Machine learning-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

