Kurs
scikit-learn ile Supervised Learning
4 sa
309.1K
“Sahte haberleri” tespit etmek hiç kolay değildir. Önce, sahte haberin ne olduğunu tanımlamanız gerekir – ki bu artık politik bir ifadeye dönüştü. Bir tanım bulur ya da üzerinde uzlaşırsanız, gerçek ve sahte haberleri toplamanız ve doğru etiketlemeniz gerekir (tercihen net ayrımlar göstermek için benzer konular hakkında). Topladıktan sonra, sahte ile gerçeği ayırmak için faydalı özellikler bulmanız gerekir.
Bu problem alanına daha derin bir bakış için, Miguel Martinez-Alvarez’in “Makine Öğrenimi ve Yapay Zekâ Sahte Haber Sorununu Çözmeye Nasıl Yardımcı Olabilir” başlıklı yazısına göz atmanızı öneririm.
Miguel’in ufuk açıcı yazısını okuduğum sıralarda, Bayesçi modellerle başarılı bir sahte haber dedektörü inşa etmek hakkında bir open data science yazısına rastladım. Yazar hatta etiketlenmiş sahte ve gerçek haber örneklerinden oluşan veri kümesi için bir depo bile oluşturmuştu. Sonuçları kolayca çoğaltıp çoğaltamayacağımı ve ardından modelin ne öğrendiğini anlayıp anlayamayacağımı merak ettim.
Bu eğitimde, birlikte bazı ilk keşif adımlarımı izleyecek ve başarılı bir sahte haber dedektörü inşa edip edemeyeceğinizi göreceksiniz!
İpucu: Doğal Dil İşleme (NLP) temelleri hakkında daha fazla bilgi edinmek isterseniz, Python ile Doğal Dil İşleme Temelleri kursunu göz önünde bulundurun.
Başlamak için, her zaman veriye hızlıca göz atmalı ve içeriğine dair bir fikir edinmelisiniz. Bunu yapmak için bir Pandas DataFrame kullanın; şekline, ilk satırlara bakın ve gerekli dönüşümleri uygulayın.
Artık DataFrame ihtiyacınıza daha uygun göründüğüne göre, etiketleri ayırmak ve eğitim ile test veri kümelerini oluşturmak istiyorsunuz.
Bu not defterinde, daha uzun makale metnini kullanmaya odaklanmayı seçtim. Özellik çıkarmak için kelime torbası (bag-of-words) ve Terim Frekansı–Ters Belge Frekansı (TF-IDF) kullanacağımı bildiğimden, bu iyi bir tercih gibi göründü. Daha uzun metinler kullanmak, gerçek ve sahte haber verilerim için ayırt edici kelimeler ve özellikler elde etmeye umarım olanak tanır.
Artık eğitim ve test verilerinize sahip olduğunuza göre, sınıflandırıcılarınızı oluşturabilirsiniz. Makalelerdeki kelime ve belirteçlerin (token) haberin sahte ya da gerçek olmasında anlamlı bir etkisi olup olmadığını görmek için, önce CountVectorizer ve TfidfVectorizer kullanarak başlayın.
Örnekte, TF-IDF vektörleştirici tfidf_vectorizer için max_df argümanı kullanılarak üst eşik .7 olarak ayarlanmıştır. Bu, makalelerin %70’inden fazlasında geçen kelimeleri kaldırır. Ayrıca, yerleşik stop_words parametresi, vektör oluşturmadan önce veriden İngilizce durdurma kelimelerini kaldıracaktır.
Daha birçok parametre mevcuttur ve bunların tümünü scikit-learn dokümantasyonunda TfidfVectorizer ve CountVectorizer için okuyabilirsiniz.
Artık vektörlere sahip olduğunuza göre, count_vectorizer ve tfidf_vectorizer içinde saklanan vektör özelliklerine göz atabilirsiniz.
Dikkat çeken sorunlar var mı? (Evet!)
Kullandığınız veri kümesinde açıkça yorumlar, ölçümler ya da başka anlamsız kelimelerin yanı sıra çok dilli makaleler de bulunuyor. Normalde, bu aşamada daha fazla zaman harcayıp ön işleme yaparak gürültüyü temizlemek istersiniz; fakat bu eğitim sadece küçük bir kavram kanıtını gösterdiği için, modelin bu gürültüyü aşarak bu sorunlara rağmen doğru sınıflandırma yapıp yapamayacağını göreceksiniz.
Count ve TF-IDF vektörleştiricilerimin farklı belirteçler çıkarıp çıkarmadığını merak ettim. Özelliklere bakıp karşılaştırmak için, vektör bilgisini yeniden bir DataFrame’e aktarabilir ve kolay Python karşılaştırmaları yapabilirsiniz.
Aşağıdaki hücreleri çalıştırdığınızda görebileceğiniz gibi, her iki vektörleştirici de aynı belirteçleri çıkardı, ancak ağırlıkları doğal olarak farklı. Muhtemelen, TF-IDF vektörleştiricinin max_df ve min_df değerlerini değiştirmek, sonucu etkileyebilir ve her birinde farklı özelliklere yol açabilir.
count_df = pd.DataFrame(count_train.A, columns=count_vectorizer.get_feature_names())tfidf_df = pd.DataFrame(tfidf_train.A, columns=tfidf_vectorizer.get_feature_names())difference = set(count_df.columns) - set(tfidf_df.columns)differenceprint(count_df.equals(tfidf_df))count_df.head()tfidf_df.head()Şimdi modellerinizi eğitip test etme zamanı.
Burada, bir NLP klasiği olan MultinomialNB ile başlayacaksınız. Bunu TF-IDF’e karşı kelime torbasını karşılaştırmak için kullanabilirsiniz. Sezgim, kelime torbasının (diğer adıyla CountVectorizer) bu modelle daha iyi performans göstereceği yönündeydi. (Çok terimli dağılım ve neden tamsayılarla en iyi çalıştığı hakkında daha fazla okumak için, UPenn istatistik dersinden oldukça öz bir açıklamaya göz atın).
Kişisel olarak Karmaşıklık (Confusion) Matrislerini karşılaştırmayı ve okumayı daha kolay buluyorum, bu yüzden scikit-learn dokümantasyonunu kullanarak kolay okunur karmaşıklık matrisleri oluşturdum (teşekkürler açık kaynak!). Bir karmaşıklık matrisi, ana diyagonal üzerinde (sol üstten sağ alta) doğru etiketleri gösterir. Diğer hücreler yanlış etiketleri gösterir; bunlar genellikle yanlış pozitif veya yanlış negatif olarak anılır. Probleminize bağlı olarak bunlardan biri daha önemli olabilir. Örneğin sahte haber probleminde, gerçek haber makalelerini sahte olarak etiketlemememiz daha mı önemli? Eğer öyleyse, doğruluk puanımızı bu kaygıyı daha iyi yansıtacak şekilde nihayetinde ağırlıklandırmak isteyebiliriz.
Karmaşıklık Matrislerinin yanı sıra, scikit-learn modellerinizi görselleştirmek ve karşılaştırmak için birçok yol sunar. Popüler yöntemlerden biri ROC Eğrisi kullanmaktır. Modelinizi değerlendirmek için scikit-learn metrics modülünde daha birçok yöntem mevcuttur.
def plot_confusion_matrix(cm, classes, normalize=False, title='Confusion matrix', cmap=plt.cm.Blues): """ See full source and example: http://scikit-learn.org/stable/auto_examples/model_selection/plot_confusion_matrix.html This function prints and plots the confusion matrix. Normalization can be applied by setting `normalize=True`. """ plt.imshow(cm, interpolation='nearest', cmap=cmap) plt.title(title) plt.colorbar() tick_marks = np.arange(len(classes)) plt.xticks(tick_marks, classes, rotation=45) plt.yticks(tick_marks, classes) if normalize: cm = cm.astype('float') / cm.sum(axis=1)[:, np.newaxis] print("Normalized confusion matrix") else: print('Confusion matrix, without normalization') thresh = cm.max() / 2. for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])): plt.text(j, i, cm[i, j], horizontalalignment="center", color="white" if cm[i, j] > thresh else "black") plt.tight_layout() plt.ylabel('True label') plt.xlabel('Predicted label')clf = MultinomialNB() clf.fit(tfidf_train, y_train)pred = clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.857Confusion matrix, without normalization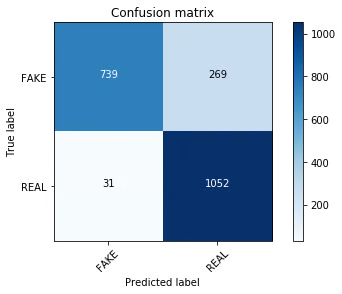
clf = MultinomialNB() clf.fit(count_train, y_train)pred = clf.predict(count_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.893Confusion matrix, without normalization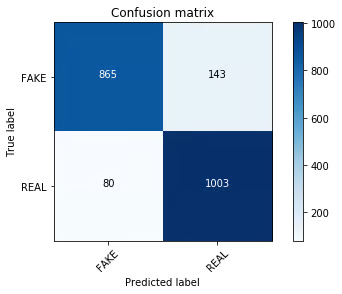
Ve gerçekten de, hiçbir parametre ayarı yapmadan, count vektörleştirilmiş eğitim kümeniz count_train TF-IDF vektörlerinizi gözle görülür şekilde geride bırakıyor!
TF-IDF vektörleştiricilerle doğrusal modellerin iyi çalıştığına dair harika yazılar var (bkz. sınıflandırma için word2vec, scikit-learn metin analizinde SVM referansı ve daha fazlası).
Öyleyse bir SVM mi kullanmalısınız?
Ben yakın zamanda Victor Lavrenko’nun metin sınıflandırma dersini izledim ve metin sınıflandırması için Pascal-Aggressive (Passive Aggressive) sınıflandırıcıları doğrusal SVM’lerle karşılaştırıyor. Bu yaklaşımı (kayda değer hız avantajları ve kalıcı öğrenme dezavantajları var) sahte haber veri kümesiyle test edeceğiz.
linear_clf = PassiveAggressiveClassifier(n_iter=50) linear_clf.fit(tfidf_train, y_train)pred = linear_clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.936Confusion matrix, without normalization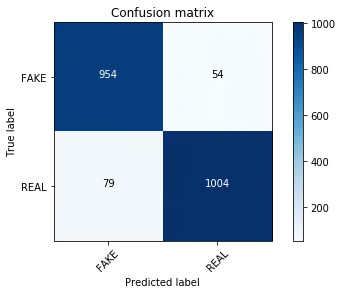
Vay canına!
Etkilendim. Karmaşıklık matrisi farklı görünüyor ve model sahte haberleri biraz daha iyi sınıflandırıyor. MultinomialNB için alpha değerini ayarlamanın benzer sonuçlar üretip üretmediğini test edebiliriz. Daha kapsamlı bir arama için ızgara aramasıyla (grid search) parametre ayarı da yapabilirsiniz.
clf = MultinomialNB(alpha=0.1) last_score = 0for alpha in np.arange(0,1,.1): nb_classifier = MultinomialNB(alpha=alpha) nb_classifier.fit(tfidf_train, y_train) pred = nb_classifier.predict(tfidf_test) score = metrics.accuracy_score(y_test, pred) if score > last_score: clf = nb_classifier print("Alpha: {:.2f} Score: {:.5f}".format(alpha, score))Pek değil... Bu noktada, tüm sınıflandırıcılar arasında parametre ayarı yapmak ya da bazı diğer scikit-learn Bayesçi sınıflandırıcılarına bakmak ilginç olabilir. Ayrıca, Pasif Agresif sınıflandırıcıyı geride bırakıp bırakmadığını görmek için bir Destek Vektör Makinesi (SVM) ile de test edebilirsiniz.
Fakat ben, Pasif Agresif modelin aslında ne öğrendiğini biraz daha merak ediyorum. O halde irdelemeye geçelim.
Demek sahte haber sorunu çözüldü, öyle mi? Veri kümemde %93 doğruluk elde ettik; o zaman dükkanı kapatıp eve gidelim.
Elbette, pek değil. Özelliklerde ne kadar gürültü gördüğümüz düşünüldüğünde bu sonuçlara en iyi ihtimalle temkinli yaklaşıyorum. Etiketleri en çok etkileyen vektörleri bulmak için son derece faydalı bir işleve sahip harika bir StackOverflow yazısı var. Yalnızca ikili sınıflandırmada (iki sınıflı sınıflandırıcılar) çalışıyor, fakat bu sizin için iyi haber; zira elinizde yalnızca FAKE veya REAL etiketleri var.
En iyi performans gösteren sınıflandırıcınızı TF-IDF vektör veri kümenizle (tfidf_vectorizer) ve Pasif Agresif sınıflandırıcıyla (linear_clf) kullanarak, sahte ve gerçek haberler için ilk 30 vektörü inceleyin:
Bunu, katsayılarınızı özelliklerinizle eşleyip listenizin en üst ve en altına bakarak yalnızca birkaç satır Python ile oldukça bariz bir şekilde de yapabilirsiniz.
feature_names = tfidf_vectorizer.get_feature_names()### Most realsorted(zip(clf.coef_[0], feature_names), reverse=True)[:20]### Most fakesorted(zip(clf.coef_[0], feature_names))[:20]Görüldüğü üzere, en üstteki sahte özelliklerde (örneğin corporate ve establishment gibi kelimeler) siyasi niyet ve kaynağı işaret edebilecek bazı kelimeler var.
Ayrıca, gerçek haber verileri “to say” fiilinin çekimlerini daha sık kullanıyor; muhtemelen gazetelerde ve çoğu habercilik yayınında kaynaklar doğrudan alıntılandığı için (“Almanya Şansölyesi Angela Merkel söyledi...”).
Geçerli sınıflandırıcınızdan tam listeyi çıkarmak ve her belirtece bakmak (ya da sınıflandırıcıdan sınıflandırıcıya belirteçleri kolayca karşılaştırmak) için, bunu kolayca şu şekilde dışa aktarabilirsiniz.
tokens_with_weights = sorted(list(zip(feature_names, clf.coef_[0])))Metin sınıflandırmasında bazen kullanılan bir diğer vektörleştirici de HashingVectorizer’dır. HashingVectorizerlar daha az bellek kullanır ve daha hızlıdır (seyrektirler ve belirteçler yerine hash kullanırlar) ancak irdelemesi daha zordur. İlgileniyorsanız, HashingVectorizer kullanmanın artı ve eksileri hakkında scikit-learn dokümantasyonunda biraz daha okuyabilirsiniz.
Deneyebilir ve sonuçlarını diğer vektörleştiricilerle karşılaştırabilirsiniz. MultinomialNB kullanıldığında TF-IDF vektörleştiriciden daha iyi sonuçlarla oldukça iyi performans gösterir (bu, CountVectorizerların daha iyi performans göstermesiyle aynı nedenlerden dolayı bir ölçüde beklenir), ancak Pasif Agresif doğrusal algoritmayla TF-IDF vektörleştirici kadar iyi değildir.
hash_vectorizer = HashingVectorizer(stop_words='english', non_negative=True)hash_train = hash_vectorizer.fit_transform(X_train)hash_test = hash_vectorizer.transform(X_test)clf = MultinomialNB(alpha=.01)clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.902Confusion matrix, without normalization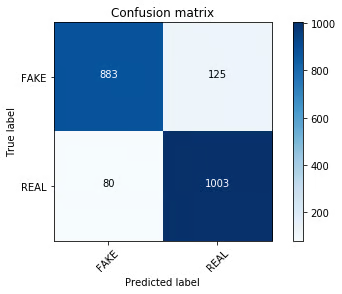
clf = PassiveAggressiveClassifier(n_iter=50)clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.921Confusion matrix, without normalization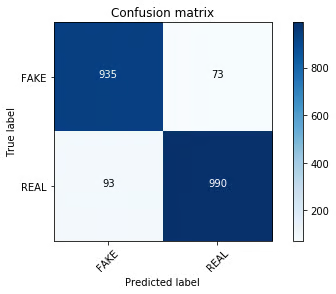
Peki sahte haber sınıflandırıcı deneyiniz başarılı oldu mu? Kesinlikle hayır.
Fakat yeni bir veri kümesiyle oynama fırsatı buldunuz, bazı NLP sınıflandırma modellerini denediniz ve ne kadar başarılı olduklarını irdelediniz mi? Evet.
Başından beri beklendiği üzere, sahte haberleri basit kelime torbası veya TF-IDF vektörleriyle tanımlamak aşırı basitleştirilmiş bir yaklaşımdır. Özellikle gürültülü belirteçlerle dolu çok dilli bir veri kümesiyle. Modelinizin gerçekte ne öğrendiğine bakmamış olsaydınız, modelin anlamlı bir şey öğrendiğini düşünebilirdiniz. Bu yüzden unutmayın: modellerinizi her zaman (elinizden geldiğince) irdeleyin.
Veride benim gözümden kaçan başka eğilimler bulursanız merak ederim. Önemli özellikler açısından farklı sınıflandırıcıların nasıl karşılaştırıldığını anlatan bir yazıyla blogumda devam edeceğim. Araştırmaya biraz zaman ayırıp ilginç bir şey bulursanız, bulgularınızı ve notlarınızı yorumlarda paylaşmaktan çekinmeyin ya da her zaman Twitter’dan ulaşabilirsiniz (ben @kjam).
Benimle birlikte yeni bir NLP veri kümesini keşfederken eğlendiğinizi umarım!
DataCamp’in Python ile Makine Öğrenimi: Scikit-Learn Eğitimine göz atın.
Makine Öğrenimi Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




