Weiter zum Inhalt

Fake News mit Scikit-Learn erkennen

Dieses scikit-learn-Tutorial zeigt dir Schritt für Schritt, wie du mit Bayes-Modellen einen Fake-News-Klassifizierer baust.
Aktualisiert 18. Sept. 2026  · 15 Min. lesen

Mit KI erkunden

ChatGPTClaudePerplexity
datacamp graphic

Das Erkennen sogenannter „Fake News“ ist alles andere als trivial. Zuerst gilt es zu definieren, was Fake News überhaupt sind – ein Begriff, der längst politisch aufgeladen ist. Selbst wenn eine Definition steht, musst du echte und falsche Nachrichten sammeln und korrekt labeln (idealerweise zu ähnlichen Themen, um klare Unterschiede sichtbar zu machen). Anschließend brauchst du sinnvolle Features, um echte von falschen Meldungen zu trennen.

Für einen tieferen Einblick empfehle ich den Beitrag von Miguel Martinez-Alvarez: „How can Machine Learning and AI Help Solve the Fake News Problem“.

Etwa zur selben Zeit bin ich auf einen Open-Data-Science-Post gestoßen, der zeigt, wie man einen erfolgreichen Fake-News-Detector mit Bayes-Modellen baut. Die Autorin bzw. der Autor hat sogar ein Repository mit gelabelten Beispielen für Fake und Real bereitgestellt. Ich war neugierig, ob ich die Ergebnisse leicht reproduzieren und anschließend verstehen kann, was das Modell tatsächlich gelernt hat.

In diesem Tutorial gehst du einige meiner ersten Schritte durch und schaust, ob du einen funktionierenden Fake-News-Detector aufbauen kannst.

Tipp: Wenn du mehr über die Grundlagen der Natural Language Processing (NLP) lernen möchtest, schau dir den Kurs Natural Language Processing Fundamentals in Python an.

Datenexploration

Zu Beginn solltest du immer einen kurzen Blick auf die Daten werfen und ein Gefühl für den Inhalt bekommen. Nutze dafür einen Pandas DataFrame, prüfe die Form, wirf einen Blick auf den Kopf der Tabelle und wende nötige Transformationen an.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZCIsInNhbXBsZSI6IiMgSW1wb3J0IGBmYWtlX29yX3JlYWxfbmV3cy5jc3ZgIFxuZGYgPSBfXy5fX19fX19fXyhcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKVxuICAgIFxuIyBJbnNwZWN0IHNoYXBlIG9mIGBkZmAgXG5kZi5fX19fX1xuXG4jIFByaW50IGZpcnN0IGxpbmVzIG9mIGBkZmBcbmRmLl9fX19fXyIsInNvbHV0aW9uIjoiIyBJbXBvcnQgYGZha2Vfb3JfcmVhbF9uZXdzLmNzdmAgXG5kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvZmFrZV9vcl9yZWFsX25ld3MuY3N2XCIpXG4gICAgXG4jIEluc3BlY3Qgc2hhcGUgb2YgYGRmYCBcbmRmLnNoYXBlXG5cbiMgUHJpbnQgZmlyc3QgbGluZXMgb2YgYGRmYCBcbmRmLmhlYWQoKSIsInNjdCI6InRlc3Rfb2JqZWN0KFwiZGZcIiwgdW5kZWZpbmVkX21zZz1cIkRpZCB5b3UgaW1wb3J0IHRoZSBkYXRhIGNvcnJlY3RseT9cIixpbmNvcnJlY3RfbXNnPVwiTWFrZSBzdXJlIHRvIHVzZSB0aGUgUGFuZGFzIGByZWFkX2NzdigpYCBmdW5jdGlvbiB0byByZWFkIGluIHRoZSBkYXRhIVwiKVxudGVzdF9vYmplY3RfYWNjZXNzZWQoXCJkZi5zaGFwZVwiLCBub3RfYWNjZXNzZWRfbXNnPVwiRGlkIHlvdSB1c2UgYHNoYXBlYCB0byByZXRyaWV2ZSB0aGUgc2hhcGUgb2YgdGhlIGBkZmA/XCIpXG50ZXN0X2Z1bmN0aW9uKFwiZGYuaGVhZFwiKVxuc3VjY2Vzc19tc2coXCJOaWNlIG9uZSFcIikifQ==
 
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKSIsInNhbXBsZSI6IiMgU2V0IGluZGV4XG5kZiA9IGRmLnNldF9pbmRleChcIlVubmFtZWQ6IDBcIikgXG5cbiMgUHJpbnQgZmlyc3QgbGluZXMgb2YgYGRmYCBcbmRmLl9fX19fXyIsInNvbHV0aW9uIjoiIyBTZXQgaW5kZXggXG5kZiA9IGRmLnNldF9pbmRleChcIlVubmFtZWQ6IDBcIilcblxuIyBQcmludCBmaXJzdCBsaW5lcyBvZiBgZGZgIFxuZGYuaGVhZCgpIiwic2N0IjoidGVzdF9vYmplY3QoXCJkZlwiKVxudGVzdF9mdW5jdGlvbihcImRmLmhlYWRcIilcbnN1Y2Nlc3NfbXNnKFwiQXdlc29tZSBqb2IhXCIpIn0=

Trainingsdaten extrahieren

Jetzt, wo der DataFrame näher an dem ist, was du brauchst, trennst du die Labels ab und legst Trainings- und Testdaten an.

Für dieses Notebook habe ich mich auf längere Artikeltexte konzentriert. Da ich Bag-of-Words und Term Frequency–Inverse Document Frequency (TF-IDF) für die Feature-Extraktion nutzen wollte, war das eine gute Wahl. Längere Texte erhöhen die Chance, unterscheidende Wörter und Features für echte und falsche Meldungen zu finden.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiZnJvbSBza2xlYXJuLm1vZGVsX3NlbGVjdGlvbiBpbXBvcnQgdHJhaW5fdGVzdF9zcGxpdFxuaW1wb3J0IHBhbmRhcyBhcyBwZFxuZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKVxuZGYgPSBkZi5zZXRfaW5kZXgoXCJVbm5hbWVkOiAwXCIpICIsInNhbXBsZSI6IiNTZXQgYHlgIFxueSA9IGRmLl9fX19fIFxuIFxuIyBEcm9wIHRoZSBgbGFiZWxgIGNvbHVtbiBcbmRmLl9fX18oXCJsYWJlbFwiLCBheGlzPTEpIFxuIFxuIyBNYWtlIHRyYWluaW5nIGFuZCB0ZXN0IHNldHMgXG5YX3RyYWluLCBYX3Rlc3QsIHlfdHJhaW4sIHlfdGVzdCA9IF9fX19fX19fX19fX19fX18oZGZbJ3RleHQnXSwgeSwgdGVzdF9zaXplPTAuMzMsIHJhbmRvbV9zdGF0ZT01MykiLCJzb2x1dGlvbiI6IiMgU2V0IGB5YCBcbnkgPSBkZi5sYWJlbCBcblxuIyBEcm9wIHRoZSBgbGFiZWxgIGNvbHVtblxuZGYuZHJvcChcImxhYmVsXCIsIGF4aXM9MSlcblxuIyBNYWtlIHRyYWluaW5nIGFuZCB0ZXN0IHNldHMgXG5YX3RyYWluLCBYX3Rlc3QsIHlfdHJhaW4sIHlfdGVzdCA9IHRyYWluX3Rlc3Rfc3BsaXQoZGZbJ3RleHQnXSwgeSwgdGVzdF9zaXplPTAuMzMsIHJhbmRvbV9zdGF0ZT01MykiLCJzY3QiOiJ0ZXN0X29iamVjdChcInlcIilcbnRlc3Rfb2JqZWN0KFwiZGZcIilcbnRlc3Rfb2JqZWN0KFwiWF90ZXN0XCIsIGRvX2V2YWw9RmFsc2UsIHVuZGVmaW5lZF9tc2c9XCJEaWQgeW91IGRlZmluZSBgWF90ZXN0YD9cIilcbnRlc3Rfb2JqZWN0KFwiWF90cmFpblwiLCBkb19ldmFsPUZhbHNlLCB1bmRlZmluZWRfbXNnPVwiRGlkIHlvdSBkZWZpbmUgYFhfdHJhaW5gP1wiKVxudGVzdF9vYmplY3QoXCJ5X3RyYWluXCIsIGRvX2V2YWw9RmFsc2UsIHVuZGVmaW5lZF9tc2c9XCJEaWQgeW91IGRlZmluZSBgeV90cmFpbmA/XCIpXG50ZXN0X29iamVjdChcInlfdGVzdFwiLCBkb19ldmFsPUZhbHNlLCB1bmRlZmluZWRfbXNnPVwiRGlkIHlvdSBkZWZpbmUgYHlfdGVzdGA/XCIpXG5zdWNjZXNzX21zZyhcIkF3ZXNvbWUgam9iIVwiKSJ9

Vektorisierer-Klassifizierer bauen

Jetzt, wo Trainings- und Testdaten bereitstehen, baust du deine Klassifizierer. Um zu prüfen, ob Wörter und Tokens in den Artikeln einen starken Einfluss darauf haben, ob News als Fake oder Real eingestuft werden, startest du mit CountVectorizer und TfidfVectorizer.

Im Beispiel ist für den TF-IDF-Vektorisierer tfidf_vectorizer mit dem Argument max_df ein Schwellwert von .7 gesetzt. Dadurch werden Wörter entfernt, die in mehr als 70% der Artikel vorkommen. Außerdem entfernt der eingebaute Parameter stop_words englische Stoppwörter, bevor Vektoren erzeugt werden.

Es gibt viele weitere Parameter. Details findest du in der scikit-learn-Dokumentation zu TfidfVectorizer und CountVectorizer.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuZnJvbSBza2xlYXJuLm1vZGVsX3NlbGVjdGlvbiBpbXBvcnQgdHJhaW5fdGVzdF9zcGxpdCBcbmZyb20gc2tsZWFybi5mZWF0dXJlX2V4dHJhY3Rpb24udGV4dCBpbXBvcnQgQ291bnRWZWN0b3JpemVyIFxuZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKVxuZGYgPSBkZi5zZXRfaW5kZXgoJ1VubmFtZWQ6IDAnKVxueSA9IGRmLmxhYmVsXG5kZiA9IGRmLmRyb3AoJ2xhYmVsJywgYXhpcz0xKVxuWF90cmFpbiwgWF90ZXN0LCB5X3RyYWluLCB5X3Rlc3QgPSB0cmFpbl90ZXN0X3NwbGl0KGRmWyd0ZXh0J10sIHksIHRlc3Rfc2l6ZT0wLjMzLCByYW5kb21fc3RhdGU9NTMpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIHRoZSBgY291bnRfdmVjdG9yaXplcmAgXG5jb3VudF92ZWN0b3JpemVyID0gX19fX19fX19fX19fX19fKHN0b3Bfd29yZHM9J2VuZ2xpc2gnKSBcblxuIyBGaXQgYW5kIHRyYW5zZm9ybSB0aGUgdHJhaW5pbmcgZGF0YSBcbmNvdW50X3RyYWluID0gY291bnRfdmVjdG9yaXplci5fX19fX19fX19fX19fKFhfdHJhaW4pIFxuXG4jIFRyYW5zZm9ybSB0aGUgdGVzdCBzZXRcbmNvdW50X3Rlc3QgPSBjb3VudF92ZWN0b3JpemVyLl9fX19fX19fXyhYX3Rlc3QpIiwic29sdXRpb24iOiIjIEluaXRpYWxpemUgdGhlIGBjb3VudF92ZWN0b3JpemVyYCBcbmNvdW50X3ZlY3Rvcml6ZXIgPSBDb3VudFZlY3Rvcml6ZXIoc3RvcF93b3Jkcz0nZW5nbGlzaCcpXG5cbiMgRml0IGFuZCB0cmFuc2Zvcm0gdGhlIHRyYWluaW5nIGRhdGEgXG5jb3VudF90cmFpbiA9IGNvdW50X3ZlY3Rvcml6ZXIuZml0X3RyYW5zZm9ybShYX3RyYWluKSBcblxuIyBUcmFuc2Zvcm0gdGhlIHRlc3Qgc2V0IFxuY291bnRfdGVzdCA9IGNvdW50X3ZlY3Rvcml6ZXIudHJhbnNmb3JtKFhfdGVzdCkiLCJzY3QiOiJ0ZXN0X29iamVjdChcImNvdW50X3ZlY3Rvcml6ZXJcIiwgZG9fZXZhbD1GYWxzZSlcbnRlc3Rfb2JqZWN0KFwiY291bnRfdHJhaW5cIiwgZG9fZXZhbD1GYWxzZSlcbnRlc3Rfb2JqZWN0KFwiY291bnRfdGVzdFwiLCBkb19ldmFsPUZhbHNlLCB1bmRlZmluZWRfbXNnPVwiRGlkIHlvdSBkZWZpbmUgYGNvdW50X3Rlc3RgP1wiKVxuc3VjY2Vzc19tc2coXCJHcmVhdCBqb2IhXCIpIn0=
 
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuZnJvbSBza2xlYXJuLm1vZGVsX3NlbGVjdGlvbiBpbXBvcnQgdHJhaW5fdGVzdF9zcGxpdCBcbmZyb20gc2tsZWFybi5mZWF0dXJlX2V4dHJhY3Rpb24udGV4dCBpbXBvcnQgVGZpZGZWZWN0b3JpemVyIFxuZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKVxuZGYgPSBkZi5zZXRfaW5kZXgoJ1VubmFtZWQ6IDAnKVxueSA9IGRmLmxhYmVsXG5kZiA9IGRmLmRyb3AoJ2xhYmVsJywgYXhpcz0xKVxuWF90cmFpbiwgWF90ZXN0LCB5X3RyYWluLCB5X3Rlc3QgPSB0cmFpbl90ZXN0X3NwbGl0KGRmWyd0ZXh0J10sIHksIHRlc3Rfc2l6ZT0wLjMzLCByYW5kb21fc3RhdGU9NTMpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIHRoZSBgdGZpZGZfdmVjdG9yaXplcmBcbnRmaWRmX3ZlY3Rvcml6ZXIgPSBfX19fX19fX19fX19fX18oc3RvcF93b3Jkcz0nZW5nbGlzaCcsIG1heF9kZj0wLjcpIFxuXG4jIEZpdCBhbmQgdHJhbnNmb3JtIHRoZSB0cmFpbmluZyBkYXRhIFxudGZpZGZfdHJhaW4gPSB0ZmlkZl92ZWN0b3JpemVyLl9fX19fX19fX19fX18oWF90cmFpbikgXG5cbiMgVHJhbnNmb3JtIHRoZSB0ZXN0IHNldCBcbnRmaWRmX3Rlc3QgPSB0ZmlkZl92ZWN0b3JpemVyLl9fX19fX19fXyhYX3Rlc3QpIiwic29sdXRpb24iOiIjIEluaXRpYWxpemUgdGhlIGB0ZmlkZl92ZWN0b3JpemVyYCBcbnRmaWRmX3ZlY3Rvcml6ZXIgPSBUZmlkZlZlY3Rvcml6ZXIoc3RvcF93b3Jkcz0nZW5nbGlzaCcsIG1heF9kZj0wLjcpIFxuXG4jIEZpdCBhbmQgdHJhbnNmb3JtIHRoZSB0cmFpbmluZyBkYXRhIFxudGZpZGZfdHJhaW4gPSB0ZmlkZl92ZWN0b3JpemVyLmZpdF90cmFuc2Zvcm0oWF90cmFpbikgXG5cbiMgVHJhbnNmb3JtIHRoZSB0ZXN0IHNldCBcbnRmaWRmX3Rlc3QgPSB0ZmlkZl92ZWN0b3JpemVyLnRyYW5zZm9ybShYX3Rlc3QpIiwic2N0IjoidGVzdF9vYmplY3QoXCJ0ZmlkZl92ZWN0b3JpemVyXCIsIGRvX2V2YWw9RmFsc2UpXG50ZXN0X29iamVjdChcInRmaWRmX3RyYWluXCIsIGRvX2V2YWw9RmFsc2UpXG50ZXN0X29iamVjdChcInRmaWRmX3Rlc3RcIiwgZG9fZXZhbD1GYWxzZSwgdW5kZWZpbmVkX21zZz1cIkRpZCB5b3UgZGVmaW5lIGBjb3VudF90ZXN0YD9cIilcbnN1Y2Nlc3NfbXNnKFwiV2VsbCBkb25lIVwiKSJ9

Jetzt, da du Vektoren hast, kannst du dir die Vektor-Features ansehen, die in count_vectorizer und tfidf_vectorizer gespeichert sind.

Fallen Probleme auf? (Ja!)

Im Datensatz finden sich offensichtlich Kommentare, Maßeinheiten oder andere unsinnige Tokens sowie mehrsprachige Artikel. Normalerweise würdest du mehr Zeit ins Preprocessing und in die Rauschunterdrückung investieren. Da dieses Tutorial aber nur ein kleines Proof of Concept zeigt, schauen wir, ob das Modell das Rauschen überwindet und trotz dieser Probleme korrekt klassifiziert.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuZnJvbSBza2xlYXJuLm1vZGVsX3NlbGVjdGlvbiBpbXBvcnQgdHJhaW5fdGVzdF9zcGxpdFxuZnJvbSBza2xlYXJuLmZlYXR1cmVfZXh0cmFjdGlvbi50ZXh0IGltcG9ydCBUZmlkZlZlY3Rvcml6ZXIsIENvdW50VmVjdG9yaXplciBcbmRmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9mYWtlX29yX3JlYWxfbmV3cy5jc3ZcIilcbmRmID0gZGYuc2V0X2luZGV4KCdVbm5hbWVkOiAwJylcbnkgPSBkZi5sYWJlbFxuZGYgPSBkZi5kcm9wKCdsYWJlbCcsIGF4aXM9MSlcblhfdHJhaW4sIFhfdGVzdCwgeV90cmFpbiwgeV90ZXN0ID0gdHJhaW5fdGVzdF9zcGxpdChkZlsndGV4dCddLCB5LCB0ZXN0X3NpemU9MC4zMywgcmFuZG9tX3N0YXRlPTUzKVxudGZpZGZfdmVjdG9yaXplciA9IFRmaWRmVmVjdG9yaXplcihzdG9wX3dvcmRzPSdlbmdsaXNoJywgbWF4X2RmPTAuNylcbnRmaWRmX3RyYWluID0gdGZpZGZfdmVjdG9yaXplci5maXRfdHJhbnNmb3JtKFhfdHJhaW4pXG50ZmlkZl90ZXN0ID0gdGZpZGZfdmVjdG9yaXplci50cmFuc2Zvcm0oWF90ZXN0KVxuY291bnRfdmVjdG9yaXplciA9IENvdW50VmVjdG9yaXplcihzdG9wX3dvcmRzPSdlbmdsaXNoJylcbmNvdW50X3RyYWluID0gY291bnRfdmVjdG9yaXplci5maXRfdHJhbnNmb3JtKFhfdHJhaW4pIFxuY291bnRfdGVzdCA9IGNvdW50X3ZlY3Rvcml6ZXIudHJhbnNmb3JtKFhfdGVzdCkiLCJzYW1wbGUiOiIjIEdldCB0aGUgZmVhdHVyZSBuYW1lcyBvZiBgdGZpZGZfdmVjdG9yaXplcmAgXG5wcmludCh0ZmlkZl92ZWN0b3JpemVyLl9fX19fX19fX19fKClbLTEwOl0pXG5cbiMgR2V0IHRoZSBmZWF0dXJlIG5hbWVzIG9mIGBjb3VudF92ZWN0b3JpemVyYCBcbnByaW50KGNvdW50X3ZlY3Rvcml6ZXIuX19fX19fX19fX18oKVs6MTBdKSIsInNvbHV0aW9uIjoiIyBHZXQgdGhlIGZlYXR1cmUgbmFtZXMgb2YgYHRmaWRmX3ZlY3Rvcml6ZXJgIFxucHJpbnQodGZpZGZfdmVjdG9yaXplci5nZXRfZmVhdHVyZV9uYW1lcygpWy0xMDpdKVxuXG4jIEdldCB0aGUgZmVhdHVyZSBuYW1lcyBvZiBgY291bnRfdmVjdG9yaXplcmAgXG5wcmludChjb3VudF92ZWN0b3JpemVyLmdldF9mZWF0dXJlX25hbWVzKClbOjEwXSkiLCJzY3QiOiJ0ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgMSlcbnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCAyKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Intermezzo: Count- versus TF-IDF-Features

Ich wollte wissen, ob Count- und TF-IDF-Vektorisierer unterschiedliche Tokens extrahiert haben. Um die Features zu vergleichen, kannst du die Vektordaten wieder in einen DataFrame zurückschreiben und in Python bequem vergleichen.

Wie die folgenden Zellen zeigen, extrahieren beide Vektorisierer dieselben Tokens, allerdings mit unterschiedlichen Gewichten. Vermutlich ließe sich das Ergebnis durch Anpassung von max_df und min_df beim TF-IDF-Vektorisierer verändern.

In [15]:
 count_df = pd.DataFrame(count_train.A, columns=count_vectorizer.get_feature_names())
In [16]:
tfidf_df = pd.DataFrame(tfidf_train.A, columns=tfidf_vectorizer.get_feature_names())
In [17]:
difference = set(count_df.columns) - set(tfidf_df.columns)difference
Out[17]:
set()
In [18]:
print(count_df.equals(tfidf_df))
False
In [19]:
count_df.head()
Out[19]:
 000000000000000310000350000600010001pt000ft000km...حلبعربيعنلممامحاولاتمنهذاوالمرضىยงade
00000000000...0000000000
10000000000...0000000000
20000000000...0000000000
30000000000...0000000000
40000000000...0000000000

5 rows × 56922 columns

In [20]:
tfidf_df.head()
Out[20]:
 000000000000000310000350000600010001pt000ft000km...حلبعربيعنلممامحاولاتمنهذاوالمرضىยงade
00.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0
10.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0
20.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.0
30.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0
40.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0

5 rows × 56922 columns

Modelle vergleichen

Jetzt ist es Zeit, deine Modelle zu trainieren und zu testen.

Wir starten mit einem NLP-Klassiker: MultinomialNB. Damit kannst du TF-IDF gegen Bag-of-Words vergleichen. Meine Intuition: Bag-of-Words (also CountVectorizer) performt mit diesem Modell besser. (Warum die Multinomialverteilung besonders gut mit Ganzzahlen funktioniert, erklärt diese knackige Referenz aus einem UPenn-Statistikkurs.)

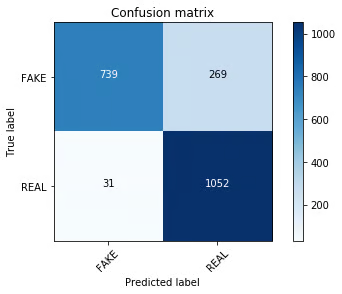
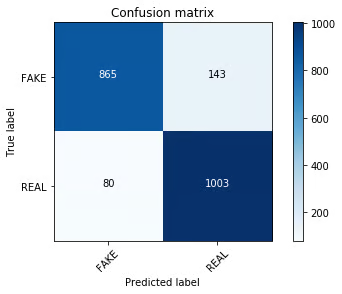
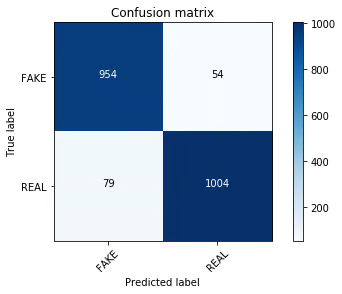
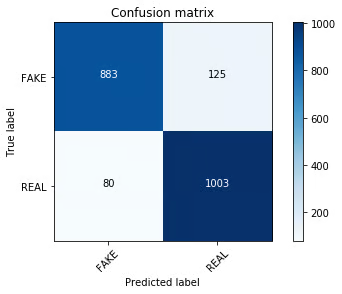
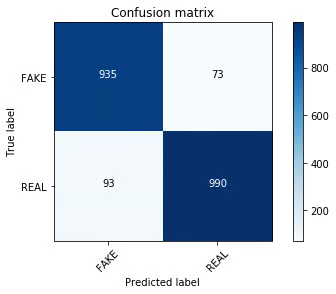
Ich finde Confusion-Matrizen für den Vergleich besonders anschaulich. Mithilfe der scikit-learn-Dokumentation habe ich schnell lesbare Confusion-Matrizen gebaut. Eine Confusion-Matrix zeigt die korrekt erkannten Labels auf der Hauptdiagonalen (von oben links nach unten rechts). Die anderen Zellen zeigen Fehlklassifikationen, oft als False Positives oder False Negatives bezeichnet. Je nach Problem kann eines davon kritischer sein. Beim Fake-News-Problem wäre es etwa wichtig, echte Artikel nicht als Fake zu labeln. Dann sollten wir die Metriken gegebenenfalls entsprechend gewichten.

Neben Confusion-Matrizen bietet scikit-learn viele weitere Möglichkeiten, Modelle zu visualisieren und zu vergleichen. Beliebt ist z. B. die ROC-Kurve. Viele weitere Evaluationsmethoden findest du im Metrics-Modul.

In [21]:
def plot_confusion_matrix(cm, classes,                          normalize=False,                          title='Confusion matrix',                          cmap=plt.cm.Blues):    """    See full source and example:     http://scikit-learn.org/stable/auto_examples/model_selection/plot_confusion_matrix.html        This function prints and plots the confusion matrix.    Normalization can be applied by setting `normalize=True`.    """    plt.imshow(cm, interpolation='nearest', cmap=cmap)    plt.title(title)    plt.colorbar()    tick_marks = np.arange(len(classes))    plt.xticks(tick_marks, classes, rotation=45)    plt.yticks(tick_marks, classes)    if normalize:        cm = cm.astype('float') / cm.sum(axis=1)[:, np.newaxis]        print("Normalized confusion matrix")    else:        print('Confusion matrix, without normalization')    thresh = cm.max() / 2.    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):        plt.text(j, i, cm[i, j],                 horizontalalignment="center",                 color="white" if cm[i, j] > thresh else "black")    plt.tight_layout()    plt.ylabel('True label')    plt.xlabel('Predicted label')
In [22]:
clf = MultinomialNB()
In [23]:
 clf.fit(tfidf_train, y_train)pred = clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.857Confusion matrix, without normalization
 
confusion matrix 1
In [24]:
clf = MultinomialNB() 
In [25]:
clf.fit(count_train, y_train)pred = clf.predict(count_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.893Confusion matrix, without normalization
 
confusion matrix 2
 

Und tatsächlich: Ganz ohne Parameter-Tuning schlägt dein Count-vektorisierter Trainingssatz count_train die TF-IDF-Vektoren sichtbar!

Lineare Modelle testen

Es gibt viele gute Beiträge dazu, warum lineare Modelle mit TF-IDF-Vektorisierern gut funktionieren (sieh dir etwa word2vec für Klassifikation, die SVM-Referenz in der scikit-learn-Textanalyse und vieles mehr an).

Also SVM verwenden, richtig?

Kürzlich habe ich mir Victor Lavrenkos Lecture zur Textklassifikation angesehen. Darin vergleicht er Passive-Aggressive-Klassifizierer mit linearen SVMs für Textklassifikation. Wir testen diesen Ansatz (er ist teilweise deutlich schneller, hat aber Nachteile beim dauerhaften Lernen) auf unserem Fake-News-Datensatz.

In [26]:
linear_clf = PassiveAggressiveClassifier(n_iter=50)
In [27]:
 linear_clf.fit(tfidf_train, y_train)pred = linear_clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.936Confusion matrix, without normalization
confusion matrix 3

Wow!

Beeindruckend. Die Confusion-Matrix sieht anders aus, und das Modell erkennt Fake News etwas besser. Wir können testen, ob sich durch Tuning des alpha-Werts bei MultinomialNB ähnliche Ergebnisse erzielen lassen. Für eine gründlichere Suche kannst du auch Grid Search zum Parametertuning einsetzen.

In [28]:
clf = MultinomialNB(alpha=0.1)
In [29]:
 last_score = 0for alpha in np.arange(0,1,.1):    nb_classifier = MultinomialNB(alpha=alpha)    nb_classifier.fit(tfidf_train, y_train)    pred = nb_classifier.predict(tfidf_test)    score = metrics.accuracy_score(y_test, pred)    if score > last_score:        clf = nb_classifier    print("Alpha: {:.2f} Score: {:.5f}".format(alpha, score))
Alpha: 0.00 Score: 0.61502Alpha: 0.10 Score: 0.89766Alpha: 0.20 Score: 0.89383Alpha: 0.30 Score: 0.89000Alpha: 0.40 Score: 0.88570Alpha: 0.50 Score: 0.88427Alpha: 0.60 Score: 0.87470Alpha: 0.70 Score: 0.87040Alpha: 0.80 Score: 0.86609Alpha: 0.90 Score: 0.85892

Noch nicht ganz … An diesem Punkt wäre es spannend, über alle Klassifizierer hinweg Parameter zu tunen oder weitere Bayes-Klassifizierer in scikit-learn auszuprobieren. Du könntest auch eine Support Vector Machine (SVM) testen, um zu sehen, ob sie den Passive-Aggressive-Klassifizierer übertrifft.

Mich interessiert allerdings mehr, was das Passive-Aggressive-Modell tatsächlich gelernt hat. Also ab zur Introspektion.

Modelle inspizieren

Also ist das Fake-News-Problem gelöst, ja? Wir haben auf meinem Datensatz 93% Genauigkeit erreicht – Feierabend.

Natürlich nicht. Ich bin bei diesen Ergebnissen sehr vorsichtig, angesichts des vielen Rauschens in den Features. Es gibt auf StackOverflow eine großartige Erklärung samt Funktion, um die Vektoren zu finden, die Labels am stärksten beeinflussen. Sie funktioniert nur für binäre Klassifikation (zwei Klassen) – was hier gut passt, da wir FAKE oder REAL haben.

Mit deinem am besten performenden Klassifizierer und dem TF-IDF-Vektordatensatz (tfidf_vectorizer) sowie dem Passive-Aggressive-Klassifizierer (linear_clf) inspizierst du die Top-30-Vektoren für Fake und Real:

In [30]:
FAKE -4.86382369883 2016FAKE -4.13847157932 hillaryFAKE -3.98994974843 octoberFAKE -3.10552662226 shareFAKE -2.99713810694 novemberFAKE -2.9150746075 articleFAKE -2.54532100449 printFAKE -2.47115243995 advertisementFAKE -2.35915304509 sourceFAKE -2.31585837413 emailFAKE -2.27985826579 electionFAKE -2.2736680857 octFAKE -2.25253568246 warFAKE -2.19663276969 mosulFAKE -2.17921304122 podestaFAKE -1.99361009573 novFAKE -1.98662624907 comFAKE -1.9452527887 establishmentFAKE -1.86869495684 corporateFAKE -1.84166664376 wikileaksFAKE -1.7936566878 26FAKE -1.75686475396 donaldFAKE -1.74951154055 snipFAKE -1.73298170472 mainstreamFAKE -1.71365596627 ukFAKE -1.70917804969 ayotteFAKE -1.70781651904 entireFAKE -1.68272667818 jewishFAKE -1.65334397724 youtubeFAKE -1.6241703128 pipelineREAL 4.78064061698 saidREAL 2.68703967567 tuesdayREAL 2.48309800829 gopREAL 2.45710670245 islamicREAL 2.44326123901 saysREAL 2.29424417889 cruzREAL 2.29144842597 marriageREAL 2.20500735471 candidatesREAL 2.19136552672 conservativeREAL 2.18030834903 mondayREAL 2.05688105375 attacksREAL 2.03476457362 rushREAL 1.9954523319 continueREAL 1.97002430576 fridayREAL 1.95034103105 conventionREAL 1.94620720989 senREAL 1.91185661202 jobsREAL 1.87501303774 debateREAL 1.84059602241 presumptiveREAL 1.80111133252 sayREAL 1.80027216061 sundayREAL 1.79650823765 marchREAL 1.79229792108 parisREAL 1.74587899553 securityREAL 1.69585506276 conservativesREAL 1.68860503431 recountsREAL 1.67424302821 dealREAL 1.67343398121 campaignREAL 1.66148582079 foxREAL 1.61425630518 attack

Das geht auch recht simpel mit wenigen Zeilen Python, indem du die Koeffizienten mit den Feature-Namen „zippst“ und dir Anfang und Ende der Liste ansiehst.

In [31]:
feature_names = tfidf_vectorizer.get_feature_names()
In [32]:
### Most realsorted(zip(clf.coef_[0], feature_names), reverse=True)[:20]
Out[32]:
[(-6.2573612147015822, 'trump'), (-6.4944530943126777, 'said'), (-6.6539784739838845, 'clinton'), (-7.0379446628670728, 'obama'), (-7.1465399833812278, 'sanders'), (-7.2153760086475112, 'president'), (-7.2665628057416169, 'campaign'), (-7.2875931446681514, 'republican'), (-7.3411184585990643, 'state'), (-7.3413571102479054, 'cruz'), (-7.3783124419854254, 'party'), (-7.4468806724578904, 'new'), (-7.4762888011545883, 'people'), (-7.547225599514773, 'percent'), (-7.5553074094582335, 'bush'), (-7.5801506339098932, 'republicans'), (-7.5855405012652435, 'house'), (-7.6344781725203141, 'voters'), (-7.6484824436952987, 'rubio'), (-7.6734836186463795, 'states')]
In [33]:
### Most fakesorted(zip(clf.coef_[0], feature_names))[:20]
Out[33]:
[(-11.349866225220305, '0000'), (-11.349866225220305, '000035'), (-11.349866225220305, '0001'), (-11.349866225220305, '0001pt'), (-11.349866225220305, '000km'), (-11.349866225220305, '0011'), (-11.349866225220305, '006s'), (-11.349866225220305, '007'), (-11.349866225220305, '007s'), (-11.349866225220305, '008s'), (-11.349866225220305, '0099'), (-11.349866225220305, '00am'), (-11.349866225220305, '00p'), (-11.349866225220305, '00pm'), (-11.349866225220305, '014'), (-11.349866225220305, '015'), (-11.349866225220305, '018'), (-11.349866225220305, '01am'), (-11.349866225220305, '020'), (-11.349866225220305, '023')]

Offenbar deuten bestimmte Wörter in den Top-Fake-Features auf politische Intention und Quelle hin (etwa corporate oder establishment).

Außerdem tauchen in echten Nachrichten Formen von „to say“ häufiger auf – vermutlich, weil in Zeitungen und seriösen Medien Quellen direkt zitiert werden („German Chancellor Angela Merkel said …“).

Um die vollständige Liste aus deinem aktuellen Klassifizierer zu exportieren und jeden Token anzusehen (oder Tokens zwischen Klassifizierern zu vergleichen), kannst du sie so sichern:

In [34]:
tokens_with_weights = sorted(list(zip(feature_names, clf.coef_[0])))

Intermezzo: HashingVectorizer

Ein weiterer Vektorisierer für Textklassifikation ist der HashingVectorizer. HashingVectorizer benötigen weniger Speicher und sind schneller (sie sind spärlich besetzt und verwenden Hashes statt Tokens), sind aber schwerer zu inspizieren. Mehr zu Vor- und Nachteilen findest du in der scikit-learn-Dokumentation zu HashingVectorizer.

Probier ihn aus und vergleiche die Ergebnisse mit den anderen Vektorisierern. Er schneidet recht ordentlich ab – besser als der TF-IDF-Vektorisierer mit MultinomialNB (was aus ähnlichen Gründen zu erwarten ist, warum CountVectorizer oft besser ist), aber schlechter als TF-IDF in Kombination mit dem linearen Passive-Aggressive-Algorithmus.

In [35]:
hash_vectorizer = HashingVectorizer(stop_words='english', non_negative=True)hash_train = hash_vectorizer.fit_transform(X_train)hash_test = hash_vectorizer.transform(X_test)
In [36]:
clf = MultinomialNB(alpha=.01)
In [37]:
clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.902Confusion matrix, without normalization
 
confusion matrix 4
In [38]:
clf = PassiveAggressiveClassifier(n_iter=50)
In [39]:
clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.921Confusion matrix, without normalization
confusion matrix 5

Fazit

War dein Fake-News-Klassifizierer ein voller Erfolg? Eher nicht.

Hattest du die Gelegenheit, einen neuen Datensatz auszuprobieren, ein paar NLP-Modelle zu testen und zu inspizieren, wie gut sie funktionieren? Ja.

Wie erwartet, ist es zu simpel, Fake News nur mit Bag-of-Words- oder TF-IDF-Vektoren zu definieren – besonders bei einem mehrsprachigen Datensatz voller Rauschen. Hättest du nicht hineingeschaut, was dein Modell gelernt hat, könntest du denken, es hätte etwas Sinnvolles erfasst. Merke dir also: Modelle immer so gut wie möglich inspizieren.

Mich würde interessieren, ob du weitere Muster im Datensatz findest, die ich übersehen habe. Ich plane einen Folgebeitrag dazu, wie sich verschiedene Klassifizierer in Bezug auf wichtige Features unterscheiden – auf meinem Blog. Wenn du etwas Spannendes findest, teile es gern in den Kommentaren oder melde dich auf Twitter (ich bin @kjam).

Ich hoffe, du hattest Spaß beim Entdecken eines neuen NLP-Datensatzes!

Schau dir auch DataCamps Python Machine Learning: Scikit-Learn Tutorial an.

Themen
Python
Datenwissenschaft
Maschinelles Lernen

Machine-Learning-Kurse

Kurs

Überwachtes Lernen mit scikit-learn

4 Std.
302.3K
In diesem interaktiven Kurs mit realen Datensätzen lernst du, mithilfe von scikit-learn in Python leistungsstarke Vorhersagen zu erstellen.
Details anzeigenRight Arrow
Kurs Starten
Mehr anzeigenRight Arrow