Corso
Apprendimento supervisionato con scikit-learn
4 ore
306K
Rilevare le cosiddette “fake news” non è un compito semplice. Innanzitutto, bisogna definire cosa si intende per fake news – dato che è ormai diventata un’espressione anche politica. Se riesci a trovare o concordare una definizione, allora devi raccogliere e etichettare correttamente notizie vere e false (auspicabilmente su argomenti simili per evidenziare al meglio le differenze). Una volta raccolte, devi poi trovare feature utili per distinguere le notizie false da quelle vere.
Per un approfondimento su questo problema, ti consiglio di dare un’occhiata al post di Miguel Martinez-Alvarez “How can Machine Learning and AI Help Solve the Fake News Problem”.
Più o meno nello stesso periodo in cui ho letto l’acuto post di Miguel, mi sono imbattuto in un post di open data science su come costruire un classificatore di fake news efficace con modelli bayesiani. L’autore ha persino creato un repository con il dataset di esempi di notizie vere e false etichettati. Ero curioso di vedere se riuscivo a riprodurre facilmente i risultati e, in tal caso, se potevo capire cosa avesse imparato il modello.
In questo tutorial, ripercorrerai insieme a me parte della mia esplorazione iniziale e vedrai se riesci a costruire un classificatore di fake news efficace!
Suggerimento: se vuoi saperne di più sulle basi dell’elaborazione del linguaggio naturale (NLP), prendi in considerazione il corso Natural Language Processing Fundamentals in Python.
Per iniziare, conviene sempre dare una rapida occhiata ai dati per farsi un’idea del loro contenuto. Per farlo, usa un DataFrame di Pandas e controlla shape, head e applica eventuali trasformazioni necessarie.
Ora che il DataFrame è più vicino a ciò che ti serve, vuoi separare le etichette e impostare i dataset di training e test.
Per questo notebook, ho deciso di concentrarmi sull’uso del testo degli articoli più lungo. Poiché sapevo che avrei usato bag-of-words e Term Frequency–Inverse Document Frequency (TF-IDF) per estrarre le feature, è sembrata una buona scelta. Usare testi più lunghi dovrebbe consentire parole e feature più distintive per i dati di notizie vere e false.
Ora che hai i tuoi dati di training e test, puoi costruire i classificatori. Per capire bene se le parole e i token negli articoli hanno avuto un impatto significativo nel determinare se una notizia fosse falsa o vera, cominci con CountVectorizer e TfidfVectorizer.
Vedrai che l’esempio ha una soglia massima impostata a .7 per il vectorizer TF-IDF tfidf_vectorizer usando l’argomento max_df. Questo rimuove le parole che compaiono in più del 70% degli articoli. Inoltre, il parametro integrato stop_words rimuove gli stop word inglesi dai dati prima della vettorizzazione.
Ci sono molti altri parametri disponibili e puoi leggerne tutti i dettagli nella documentazione di scikit-learn per TfidfVectorizer e CountVectorizer.
Ora che hai i vettori, puoi dare un’occhiata alle feature dei vettori, memorizzate in count_vectorizer e tfidf_vectorizer.
Ci sono problemi evidenti? (Sì!)
Nel dataset che stai usando ci sono chiaramente commenti, misurazioni o altre parole senza senso, oltre ad articoli multilingue. Normalmente, vorresti dedicare più tempo al preprocessing e alla rimozione del rumore, ma poiché questo tutorial mostra solo una piccola prova di concetto, vedrai se il modello riesce a superare il rumore e classificare correttamente nonostante questi problemi.
Ero curioso di sapere se i miei vectorizer count e TF-IDF avessero estratto token diversi. Per dare un’occhiata e confrontare le feature, puoi riportare le informazioni dei vettori in un DataFrame per fare confronti in Python in modo semplice.
Come puoi vedere eseguendo le celle qui sotto, entrambi i vectorizer hanno estratto gli stessi token, ma con pesi ovviamente diversi. Probabilmente, modificare max_df e min_df del vectorizer TF-IDF potrebbe cambiare il risultato e portare a feature differenti in ciascuno.
count_df = pd.DataFrame(count_train.A, columns=count_vectorizer.get_feature_names())tfidf_df = pd.DataFrame(tfidf_train.A, columns=tfidf_vectorizer.get_feature_names())difference = set(count_df.columns) - set(tfidf_df.columns)differenceprint(count_df.equals(tfidf_df))count_df.head()tfidf_df.head()È il momento di addestrare e testare i modelli.
Qui, inizierai con un classico dell’NLP, MultinomialNB. Puoi usarlo per confrontare TF-IDF e bag-of-words. La mia intuizione era che bag-of-words (ovvero CountVectorizer) avrebbe funzionato meglio con questo modello. (Per approfondire la distribuzione multinomiale e perché funziona meglio con numeri interi, dai un’occhiata a questa spiegazione piuttosto sintetica da un corso di statistica di UPenn).
Personalmente trovo più facili da confrontare e leggere le confusion matrix, quindi ho usato la documentazione di scikit-learn per costruirne alcune facilmente leggibili (grazie open source!). Una confusion matrix mostra le etichette corrette sulla diagonale principale (dall’alto a sinistra al basso a destra). Le altre celle mostrano le etichette errate, spesso chiamate falsi positivi o falsi negativi. A seconda del problema, una delle due potrebbe essere più significativa. Per esempio, per il problema delle fake news, è più importante evitare di etichettare come false le notizie vere? Se sì, potremmo voler alla fine pesare la nostra metrica di accuratezza per riflettere meglio questa preoccupazione.
Oltre alle confusion matrix, scikit-learn offre molti modi per visualizzare e confrontare i modelli. Un modo popolare è usare una curva ROC. Ci sono molti altri modi per valutare il modello disponibili nel modulo metrics di scikit-learn.
def plot_confusion_matrix(cm, classes, normalize=False, title='Confusion matrix', cmap=plt.cm.Blues): """ See full source and example: http://scikit-learn.org/stable/auto_examples/model_selection/plot_confusion_matrix.html This function prints and plots the confusion matrix. Normalization can be applied by setting `normalize=True`. """ plt.imshow(cm, interpolation='nearest', cmap=cmap) plt.title(title) plt.colorbar() tick_marks = np.arange(len(classes)) plt.xticks(tick_marks, classes, rotation=45) plt.yticks(tick_marks, classes) if normalize: cm = cm.astype('float') / cm.sum(axis=1)[:, np.newaxis] print("Normalized confusion matrix") else: print('Confusion matrix, without normalization') thresh = cm.max() / 2. for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])): plt.text(j, i, cm[i, j], horizontalalignment="center", color="white" if cm[i, j] > thresh else "black") plt.tight_layout() plt.ylabel('True label') plt.xlabel('Predicted label')clf = MultinomialNB() clf.fit(tfidf_train, y_train)pred = clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.857Confusion matrix, without normalization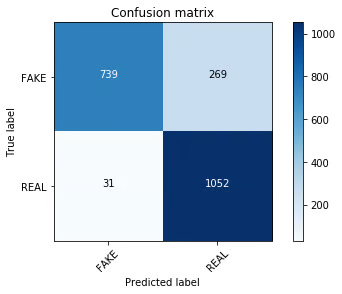
clf = MultinomialNB() clf.fit(count_train, y_train)pred = clf.predict(count_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.893Confusion matrix, without normalization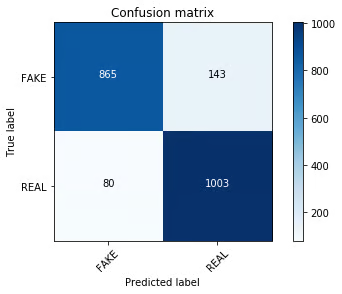
E infatti, senza alcun tuning dei parametri, il tuo set di training vettorizzato con count count_train supera visibilmente i tuoi vettori TF-IDF!
Ci sono molte ottime risorse su come i modelli lineari funzionino bene con i vectorizer TF-IDF (dai un’occhiata a word2vec per la classificazione, riferimenti SVM nell’analisi testuale di scikit-learn e molte altre).
Quindi dovresti usare una SVM, giusto?
Be’, ho guardato di recente la lezione di Victor Lavrenko sulla classificazione del testo in cui confronta i classificatori Passive Aggressive con le SVM lineari per la classificazione testuale. Metteremo alla prova questo approccio (che ha notevoli vantaggi in velocità e svantaggi nell’apprendimento permanente) con il dataset delle fake news.
linear_clf = PassiveAggressiveClassifier(n_iter=50) linear_clf.fit(tfidf_train, y_train)pred = linear_clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.936Confusion matrix, without normalization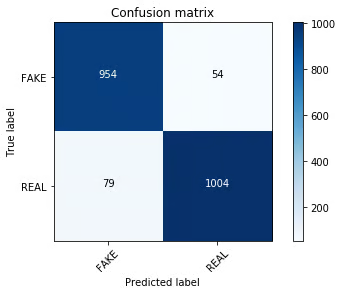
Wow!
Sono colpito. La confusion matrix ha un aspetto diverso e il modello classifica un po’ meglio le nostre fake news. Possiamo testare se il tuning del valore di alpha per un MultinomialNB produce risultati comparabili. Puoi anche usare la ricerca a griglia per l’ottimizzazione dei parametri per una ricerca più esaustiva.
clf = MultinomialNB(alpha=0.1) last_score = 0for alpha in np.arange(0,1,.1): nb_classifier = MultinomialNB(alpha=alpha) nb_classifier.fit(tfidf_train, y_train) pred = nb_classifier.predict(tfidf_test) score = metrics.accuracy_score(y_test, pred) if score > last_score: clf = nb_classifier print("Alpha: {:.2f} Score: {:.5f}".format(alpha, score))Non proprio... A questo punto, potrebbe essere interessante eseguire il tuning dei parametri su tutti i classificatori o dare un’occhiata ad altri classificatori bayesiani di scikit-learn. Potresti anche provare con una Support Vector Machine (SVM) per vedere se supera il classificatore Passive Aggressive.
Ma sono un po’ più curioso di capire cosa il modello Passive Aggressive abbia effettivamente imparato. Quindi passiamo all’introspezione.
Quindi le fake news sono risolte, giusto? Abbiamo raggiunto il 93% di accuratezza sul mio dataset, quindi chiudiamo tutto e andiamo a casa.
Ovviamente no. Sono, nel migliore dei casi, diffidente verso questi risultati, visto quanto rumore abbiamo visto nelle feature. C’è un’ottima risposta su StackOverflow con una funzione utilissima per trovare i vettori che influenzano maggiormente le etichette. Funziona solo per la classificazione binaria (classificatori con 2 classi), ma per te è una buona notizia, dato che hai solo etichette FAKE o REAL.
Usando il tuo classificatore con prestazioni migliori con il dataset di vettori TF-IDF (tfidf_vectorizer) e il classificatore Passive Aggressive (linear_clf), ispeziona le 30 feature principali per le notizie false e vere:
Puoi farlo anche in modo piuttosto semplice con poche righe di Python, unendo (zip) i coefficienti alle feature e guardando l’inizio e la fine della lista.
feature_names = tfidf_vectorizer.get_feature_names()### Most realsorted(zip(clf.coef_[0], feature_names), reverse=True)[:20]### Most fakesorted(zip(clf.coef_[0], feature_names))[:20]Dunque, è chiaro che ci sono alcune parole che potrebbero indicare orientamento politico e fonte tra le feature top delle fake (come corporate ed establishment).
Inoltre, i dati delle notizie vere usano più spesso forme del verbo “to say”, probabilmente perché nei giornali e nella maggior parte delle pubblicazioni giornalistiche le fonti vengono citate direttamente (“La cancelliera tedesca Angela Merkel ha detto...”).
Per estrarre l’elenco completo dal classificatore attuale e dare un’occhiata a ogni token (o confrontare facilmente i token da un classificatore all’altro), puoi esportarlo facilmente così.
tokens_with_weights = sorted(list(zip(feature_names, clf.coef_[0])))Un altro vectorizer talvolta usato per la classificazione testuale è HashingVectorizer. Gli HashingVectorizer richiedono meno memoria e sono più veloci (perché sono sparsi e usano hash anziché token), ma sono più difficili da ispezionare. Puoi leggere qualcosa in più sui pro e i contro dell’uso di HashingVectorizer nella documentazione di scikit-learn, se ti interessa.
Puoi fare una prova e confrontarne i risultati con gli altri vectorizer. Si comporta piuttosto bene, con risultati migliori del vectorizer TF-IDF usando MultinomialNB (cosa in parte attesa per le stesse ragioni per cui i CountVectorizer funzionano meglio), ma non bene quanto il vectorizer TF-IDF con l’algoritmo lineare Passive Aggressive.
hash_vectorizer = HashingVectorizer(stop_words='english', non_negative=True)hash_train = hash_vectorizer.fit_transform(X_train)hash_test = hash_vectorizer.transform(X_test)clf = MultinomialNB(alpha=.01)clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.902Confusion matrix, without normalization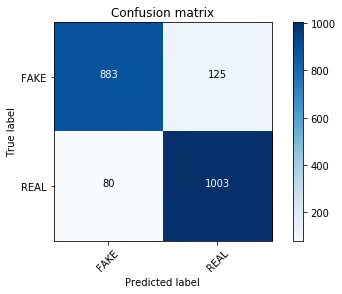
clf = PassiveAggressiveClassifier(n_iter=50)clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy: %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])accuracy: 0.921Confusion matrix, without normalization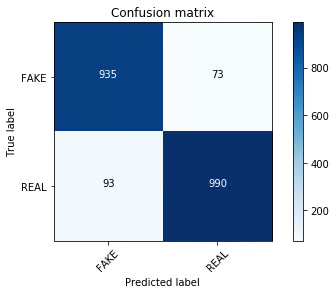
Quindi l’esperimento con il classificatore di fake news è stato un successo? Decisamente no.
Ma ti sei divertito a sperimentare con un nuovo dataset, provare alcuni modelli di classificazione NLP e ispezionare quanto fossero efficaci? Sì.
Come previsto fin dall’inizio, definire le fake news con semplici vettori bag-of-words o TF-IDF è un approccio troppo semplificato. Soprattutto con un dataset multilingue pieno di token rumorosi. Se non avessi guardato cosa aveva effettivamente imparato il tuo modello, avresti potuto pensare che avesse appreso qualcosa di significativo. Quindi, ricorda: ispeziona sempre i tuoi modelli (per quanto possibile!).
Sarei curioso di sapere se trovi altre tendenze nei dati che potrei essermi perso. Farò un follow-up con un post su come i diversi classificatori si confrontano in termini di feature importanti sul mio blog. Se dedichi un po’ di tempo alla ricerca e trovi qualcosa di interessante, condividi pure risultati e note nei commenti o contattami su Twitter (sono @kjam).
Spero ti sia divertito a esplorare con me un nuovo dataset NLP!
Dai un’occhiata al tutorial Python Machine Learning: Scikit-Learn di DataCamp.
Corsi di Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



