Accéder au contenu principal

Détecter les fake news avec scikit-learn

Ce tutoriel scikit-learn vous guide pas à pas pour construire un classifieur de fake news à l’aide de modèles bayésiens.
Actualisé 19 sept. 2026  · 15 min lire

Explorer avec l’IA

ChatGPTClaudePerplexity
datacamp graphic

Détecter les fameuses « fake news » n’a rien d’évident. D’abord, il faut en définir le périmètre – le terme a désormais une connotation politique. Une fois la définition établie, il faut collecter des articles et les étiqueter correctement comme vrais ou faux (de préférence sur des thématiques similaires pour bien distinguer les deux). Une fois la collecte faite, reste à identifier des caractéristiques utiles pour différencier le vrai du faux.

Pour un tour d’horizon plus approfondi, je vous recommande l’article de Miguel Martinez-Alvarez : « How can Machine Learning and AI Help Solve the Fake News Problem ».

À peu près au même moment, j’ai découvert un article d’Open Data Science sur la création d’un détecteur de fake news performant avec des modèles bayésiens. L’auteur a même mis à disposition un répertoire contenant un jeu de données d’articles vrais et faux étiquetés. J’étais curieux de voir si je pouvais reproduire facilement les résultats et, surtout, si je pouvais comprendre ce que le modèle avait appris.

Dans ce tutoriel, vous allez parcourir avec moi quelques étapes d’exploration initiale et vérifier si vous parvenez à construire un détecteur de fake news convaincant.

Astuce : pour approfondir les bases du traitement automatique du langage (NLP), suivez le cours Natural Language Processing Fundamentals in Python.

Exploration des données

Commencez toujours par un rapide tour d’horizon des données pour en prendre le pouls. Pour cela, utilisez un DataFrame Pandas, vérifiez sa forme, affichez les premières lignes et appliquez les transformations nécessaires.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZCIsInNhbXBsZSI6IiMgSW1wb3J0IGBmYWtlX29yX3JlYWxfbmV3cy5jc3ZgIFxuZGYgPSBfXy5fX19fX19fXyhcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKVxuICAgIFxuIyBJbnNwZWN0IHNoYXBlIG9mIGBkZmAgXG5kZi5fX19fX1xuXG4jIFByaW50IGZpcnN0IGxpbmVzIG9mIGBkZmBcbmRmLl9fX19fXyIsInNvbHV0aW9uIjoiIyBJbXBvcnQgYGZha2Vfb3JfcmVhbF9uZXdzLmNzdmAgXG5kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvZmFrZV9vcl9yZWFsX25ld3MuY3N2XCIpXG4gICAgXG4jIEluc3BlY3Qgc2hhcGUgb2YgYGRmYCBcbmRmLnNoYXBlXG5cbiMgUHJpbnQgZmlyc3QgbGluZXMgb2YgYGRmYCBcbmRmLmhlYWQoKSIsInNjdCI6InRlc3Rfb2JqZWN0KFwiZGZcIiwgdW5kZWZpbmVkX21zZz1cIkRpZCB5b3UgaW1wb3J0IHRoZSBkYXRhIGNvcnJlY3RseT9cIixpbmNvcnJlY3RfbXNnPVwiTWFrZSBzdXJlIHRvIHVzZSB0aGUgUGFuZGFzIGByZWFkX2NzdigpYCBmdW5jdGlvbiB0byByZWFkIGluIHRoZSBkYXRhIVwiKVxudGVzdF9vYmplY3RfYWNjZXNzZWQoXCJkZi5zaGFwZVwiLCBub3RfYWNjZXNzZWRfbXNnPVwiRGlkIHlvdSB1c2UgYHNoYXBlYCB0byByZXRyaWV2ZSB0aGUgc2hhcGUgb2YgdGhlIGBkZmA/XCIpXG50ZXN0X2Z1bmN0aW9uKFwiZGYuaGVhZFwiKVxuc3VjY2Vzc19tc2coXCJOaWNlIG9uZSFcIikifQ==
 
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKSIsInNhbXBsZSI6IiMgU2V0IGluZGV4XG5kZiA9IGRmLnNldF9pbmRleChcIlVubmFtZWQ6IDBcIikgXG5cbiMgUHJpbnQgZmlyc3QgbGluZXMgb2YgYGRmYCBcbmRmLl9fX19fXyIsInNvbHV0aW9uIjoiIyBTZXQgaW5kZXggXG5kZiA9IGRmLnNldF9pbmRleChcIlVubmFtZWQ6IDBcIilcblxuIyBQcmludCBmaXJzdCBsaW5lcyBvZiBgZGZgIFxuZGYuaGVhZCgpIiwic2N0IjoidGVzdF9vYmplY3QoXCJkZlwiKVxudGVzdF9mdW5jdGlvbihcImRmLmhlYWRcIilcbnN1Y2Nlc3NfbXNnKFwiQXdlc29tZSBqb2IhXCIpIn0=

Extraction des données d’entraînement

Maintenant que le DataFrame ressemble davantage à ce dont vous avez besoin, séparez les étiquettes et constituez des jeux d’entraînement et de test.

Pour ce notebook, j’ai décidé de me concentrer sur le texte long des articles. Sachant que j’allais utiliser le sac de mots et la mesure TF-IDF (Term Frequency–Inverse Document Frequency) pour extraire des caractéristiques, ce choix était pertinent. Un texte plus long permettra, espérons-le, de mieux distinguer des mots et des caractéristiques entre mes données de vraies et de fausses informations.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiZnJvbSBza2xlYXJuLm1vZGVsX3NlbGVjdGlvbiBpbXBvcnQgdHJhaW5fdGVzdF9zcGxpdFxuaW1wb3J0IHBhbmRhcyBhcyBwZFxuZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKVxuZGYgPSBkZi5zZXRfaW5kZXgoXCJVbm5hbWVkOiAwXCIpICIsInNhbXBsZSI6IiNTZXQgYHlgIFxueSA9IGRmLl9fX19fIFxuIFxuIyBEcm9wIHRoZSBgbGFiZWxgIGNvbHVtbiBcbmRmLl9fX18oXCJsYWJlbFwiLCBheGlzPTEpIFxuIFxuIyBNYWtlIHRyYWluaW5nIGFuZCB0ZXN0IHNldHMgXG5YX3RyYWluLCBYX3Rlc3QsIHlfdHJhaW4sIHlfdGVzdCA9IF9fX19fX19fX19fX19fX18oZGZbJ3RleHQnXSwgeSwgdGVzdF9zaXplPTAuMzMsIHJhbmRvbV9zdGF0ZT01MykiLCJzb2x1dGlvbiI6IiMgU2V0IGB5YCBcbnkgPSBkZi5sYWJlbCBcblxuIyBEcm9wIHRoZSBgbGFiZWxgIGNvbHVtblxuZGYuZHJvcChcImxhYmVsXCIsIGF4aXM9MSlcblxuIyBNYWtlIHRyYWluaW5nIGFuZCB0ZXN0IHNldHMgXG5YX3RyYWluLCBYX3Rlc3QsIHlfdHJhaW4sIHlfdGVzdCA9IHRyYWluX3Rlc3Rfc3BsaXQoZGZbJ3RleHQnXSwgeSwgdGVzdF9zaXplPTAuMzMsIHJhbmRvbV9zdGF0ZT01MykiLCJzY3QiOiJ0ZXN0X29iamVjdChcInlcIilcbnRlc3Rfb2JqZWN0KFwiZGZcIilcbnRlc3Rfb2JqZWN0KFwiWF90ZXN0XCIsIGRvX2V2YWw9RmFsc2UsIHVuZGVmaW5lZF9tc2c9XCJEaWQgeW91IGRlZmluZSBgWF90ZXN0YD9cIilcbnRlc3Rfb2JqZWN0KFwiWF90cmFpblwiLCBkb19ldmFsPUZhbHNlLCB1bmRlZmluZWRfbXNnPVwiRGlkIHlvdSBkZWZpbmUgYFhfdHJhaW5gP1wiKVxudGVzdF9vYmplY3QoXCJ5X3RyYWluXCIsIGRvX2V2YWw9RmFsc2UsIHVuZGVmaW5lZF9tc2c9XCJEaWQgeW91IGRlZmluZSBgeV90cmFpbmA/XCIpXG50ZXN0X29iamVjdChcInlfdGVzdFwiLCBkb19ldmFsPUZhbHNlLCB1bmRlZmluZWRfbXNnPVwiRGlkIHlvdSBkZWZpbmUgYHlfdGVzdGA/XCIpXG5zdWNjZXNzX21zZyhcIkF3ZXNvbWUgam9iIVwiKSJ9

Construction des classifieurs avec vectorisation

Maintenant que vous avez vos jeux d’entraînement et de test, vous pouvez construire vos classifieurs. Pour évaluer l’impact des mots et jetons des articles sur la détection du vrai/faux, commencez avec CountVectorizer et TfidfVectorizer.

Dans l’exemple, un seuil maximal de .7 est défini pour le vectoriseur TF-IDF tfidf_vectorizer via l’argument max_df. Cela retire les mots présents dans plus de 70 % des articles. Par ailleurs, le paramètre intégré stop_words supprimera les stop words anglais avant la vectorisation.

De nombreux autres paramètres sont disponibles : consultez la documentation scikit-learn pour TfidfVectorizer et CountVectorizer.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuZnJvbSBza2xlYXJuLm1vZGVsX3NlbGVjdGlvbiBpbXBvcnQgdHJhaW5fdGVzdF9zcGxpdCBcbmZyb20gc2tsZWFybi5mZWF0dXJlX2V4dHJhY3Rpb24udGV4dCBpbXBvcnQgQ291bnRWZWN0b3JpemVyIFxuZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKVxuZGYgPSBkZi5zZXRfaW5kZXgoJ1VubmFtZWQ6IDAnKVxueSA9IGRmLmxhYmVsXG5kZiA9IGRmLmRyb3AoJ2xhYmVsJywgYXhpcz0xKVxuWF90cmFpbiwgWF90ZXN0LCB5X3RyYWluLCB5X3Rlc3QgPSB0cmFpbl90ZXN0X3NwbGl0KGRmWyd0ZXh0J10sIHksIHRlc3Rfc2l6ZT0wLjMzLCByYW5kb21fc3RhdGU9NTMpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIHRoZSBgY291bnRfdmVjdG9yaXplcmAgXG5jb3VudF92ZWN0b3JpemVyID0gX19fX19fX19fX19fX19fKHN0b3Bfd29yZHM9J2VuZ2xpc2gnKSBcblxuIyBGaXQgYW5kIHRyYW5zZm9ybSB0aGUgdHJhaW5pbmcgZGF0YSBcbmNvdW50X3RyYWluID0gY291bnRfdmVjdG9yaXplci5fX19fX19fX19fX19fKFhfdHJhaW4pIFxuXG4jIFRyYW5zZm9ybSB0aGUgdGVzdCBzZXRcbmNvdW50X3Rlc3QgPSBjb3VudF92ZWN0b3JpemVyLl9fX19fX19fXyhYX3Rlc3QpIiwic29sdXRpb24iOiIjIEluaXRpYWxpemUgdGhlIGBjb3VudF92ZWN0b3JpemVyYCBcbmNvdW50X3ZlY3Rvcml6ZXIgPSBDb3VudFZlY3Rvcml6ZXIoc3RvcF93b3Jkcz0nZW5nbGlzaCcpXG5cbiMgRml0IGFuZCB0cmFuc2Zvcm0gdGhlIHRyYWluaW5nIGRhdGEgXG5jb3VudF90cmFpbiA9IGNvdW50X3ZlY3Rvcml6ZXIuZml0X3RyYW5zZm9ybShYX3RyYWluKSBcblxuIyBUcmFuc2Zvcm0gdGhlIHRlc3Qgc2V0IFxuY291bnRfdGVzdCA9IGNvdW50X3ZlY3Rvcml6ZXIudHJhbnNmb3JtKFhfdGVzdCkiLCJzY3QiOiJ0ZXN0X29iamVjdChcImNvdW50X3ZlY3Rvcml6ZXJcIiwgZG9fZXZhbD1GYWxzZSlcbnRlc3Rfb2JqZWN0KFwiY291bnRfdHJhaW5cIiwgZG9fZXZhbD1GYWxzZSlcbnRlc3Rfb2JqZWN0KFwiY291bnRfdGVzdFwiLCBkb19ldmFsPUZhbHNlLCB1bmRlZmluZWRfbXNnPVwiRGlkIHlvdSBkZWZpbmUgYGNvdW50X3Rlc3RgP1wiKVxuc3VjY2Vzc19tc2coXCJHcmVhdCBqb2IhXCIpIn0=
 
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuZnJvbSBza2xlYXJuLm1vZGVsX3NlbGVjdGlvbiBpbXBvcnQgdHJhaW5fdGVzdF9zcGxpdCBcbmZyb20gc2tsZWFybi5mZWF0dXJlX2V4dHJhY3Rpb24udGV4dCBpbXBvcnQgVGZpZGZWZWN0b3JpemVyIFxuZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL2Zha2Vfb3JfcmVhbF9uZXdzLmNzdlwiKVxuZGYgPSBkZi5zZXRfaW5kZXgoJ1VubmFtZWQ6IDAnKVxueSA9IGRmLmxhYmVsXG5kZiA9IGRmLmRyb3AoJ2xhYmVsJywgYXhpcz0xKVxuWF90cmFpbiwgWF90ZXN0LCB5X3RyYWluLCB5X3Rlc3QgPSB0cmFpbl90ZXN0X3NwbGl0KGRmWyd0ZXh0J10sIHksIHRlc3Rfc2l6ZT0wLjMzLCByYW5kb21fc3RhdGU9NTMpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIHRoZSBgdGZpZGZfdmVjdG9yaXplcmBcbnRmaWRmX3ZlY3Rvcml6ZXIgPSBfX19fX19fX19fX19fX18oc3RvcF93b3Jkcz0nZW5nbGlzaCcsIG1heF9kZj0wLjcpIFxuXG4jIEZpdCBhbmQgdHJhbnNmb3JtIHRoZSB0cmFpbmluZyBkYXRhIFxudGZpZGZfdHJhaW4gPSB0ZmlkZl92ZWN0b3JpemVyLl9fX19fX19fX19fX18oWF90cmFpbikgXG5cbiMgVHJhbnNmb3JtIHRoZSB0ZXN0IHNldCBcbnRmaWRmX3Rlc3QgPSB0ZmlkZl92ZWN0b3JpemVyLl9fX19fX19fXyhYX3Rlc3QpIiwic29sdXRpb24iOiIjIEluaXRpYWxpemUgdGhlIGB0ZmlkZl92ZWN0b3JpemVyYCBcbnRmaWRmX3ZlY3Rvcml6ZXIgPSBUZmlkZlZlY3Rvcml6ZXIoc3RvcF93b3Jkcz0nZW5nbGlzaCcsIG1heF9kZj0wLjcpIFxuXG4jIEZpdCBhbmQgdHJhbnNmb3JtIHRoZSB0cmFpbmluZyBkYXRhIFxudGZpZGZfdHJhaW4gPSB0ZmlkZl92ZWN0b3JpemVyLmZpdF90cmFuc2Zvcm0oWF90cmFpbikgXG5cbiMgVHJhbnNmb3JtIHRoZSB0ZXN0IHNldCBcbnRmaWRmX3Rlc3QgPSB0ZmlkZl92ZWN0b3JpemVyLnRyYW5zZm9ybShYX3Rlc3QpIiwic2N0IjoidGVzdF9vYmplY3QoXCJ0ZmlkZl92ZWN0b3JpemVyXCIsIGRvX2V2YWw9RmFsc2UpXG50ZXN0X29iamVjdChcInRmaWRmX3RyYWluXCIsIGRvX2V2YWw9RmFsc2UpXG50ZXN0X29iamVjdChcInRmaWRmX3Rlc3RcIiwgZG9fZXZhbD1GYWxzZSwgdW5kZWZpbmVkX21zZz1cIkRpZCB5b3UgZGVmaW5lIGBjb3VudF90ZXN0YD9cIilcbnN1Y2Nlc3NfbXNnKFwiV2VsbCBkb25lIVwiKSJ9

Maintenant que vous avez vos vecteurs, vous pouvez examiner les caractéristiques extraites, stockées dans count_vectorizer et tfidf_vectorizer.

Voyez-vous des problèmes visibles ? (Oui !)

Il y a clairement des commentaires, des mesures ou d’autres éléments incohérents, ainsi que des articles multilingues dans le jeu de données utilisé. Normalement, vous consacreriez plus de temps au prétraitement et à la réduction du bruit. Mais comme ce tutoriel vise à proposer une preuve de concept rapide, voyons si le modèle peut surmonter ce bruit et bien classer malgré ces écueils.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuZnJvbSBza2xlYXJuLm1vZGVsX3NlbGVjdGlvbiBpbXBvcnQgdHJhaW5fdGVzdF9zcGxpdFxuZnJvbSBza2xlYXJuLmZlYXR1cmVfZXh0cmFjdGlvbi50ZXh0IGltcG9ydCBUZmlkZlZlY3Rvcml6ZXIsIENvdW50VmVjdG9yaXplciBcbmRmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9mYWtlX29yX3JlYWxfbmV3cy5jc3ZcIilcbmRmID0gZGYuc2V0X2luZGV4KCdVbm5hbWVkOiAwJylcbnkgPSBkZi5sYWJlbFxuZGYgPSBkZi5kcm9wKCdsYWJlbCcsIGF4aXM9MSlcblhfdHJhaW4sIFhfdGVzdCwgeV90cmFpbiwgeV90ZXN0ID0gdHJhaW5fdGVzdF9zcGxpdChkZlsndGV4dCddLCB5LCB0ZXN0X3NpemU9MC4zMywgcmFuZG9tX3N0YXRlPTUzKVxudGZpZGZfdmVjdG9yaXplciA9IFRmaWRmVmVjdG9yaXplcihzdG9wX3dvcmRzPSdlbmdsaXNoJywgbWF4X2RmPTAuNylcbnRmaWRmX3RyYWluID0gdGZpZGZfdmVjdG9yaXplci5maXRfdHJhbnNmb3JtKFhfdHJhaW4pXG50ZmlkZl90ZXN0ID0gdGZpZGZfdmVjdG9yaXplci50cmFuc2Zvcm0oWF90ZXN0KVxuY291bnRfdmVjdG9yaXplciA9IENvdW50VmVjdG9yaXplcihzdG9wX3dvcmRzPSdlbmdsaXNoJylcbmNvdW50X3RyYWluID0gY291bnRfdmVjdG9yaXplci5maXRfdHJhbnNmb3JtKFhfdHJhaW4pIFxuY291bnRfdGVzdCA9IGNvdW50X3ZlY3Rvcml6ZXIudHJhbnNmb3JtKFhfdGVzdCkiLCJzYW1wbGUiOiIjIEdldCB0aGUgZmVhdHVyZSBuYW1lcyBvZiBgdGZpZGZfdmVjdG9yaXplcmAgXG5wcmludCh0ZmlkZl92ZWN0b3JpemVyLl9fX19fX19fX19fKClbLTEwOl0pXG5cbiMgR2V0IHRoZSBmZWF0dXJlIG5hbWVzIG9mIGBjb3VudF92ZWN0b3JpemVyYCBcbnByaW50KGNvdW50X3ZlY3Rvcml6ZXIuX19fX19fX19fX18oKVs6MTBdKSIsInNvbHV0aW9uIjoiIyBHZXQgdGhlIGZlYXR1cmUgbmFtZXMgb2YgYHRmaWRmX3ZlY3Rvcml6ZXJgIFxucHJpbnQodGZpZGZfdmVjdG9yaXplci5nZXRfZmVhdHVyZV9uYW1lcygpWy0xMDpdKVxuXG4jIEdldCB0aGUgZmVhdHVyZSBuYW1lcyBvZiBgY291bnRfdmVjdG9yaXplcmAgXG5wcmludChjb3VudF92ZWN0b3JpemVyLmdldF9mZWF0dXJlX25hbWVzKClbOjEwXSkiLCJzY3QiOiJ0ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgMSlcbnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCAyKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Intermezzo : caractéristiques Count vs TF-IDF

Je voulais savoir si mes vectoriseurs Count et TF-IDF extrayaient des jetons différents. Pour comparer facilement, vous pouvez retransformer les vecteurs en DataFrame et faire des comparaisons simples en Python.

En exécutant les cellules ci-dessous, vous verrez que les deux vectoriseurs extraient les mêmes jetons, mais avec des pondérations différentes. En jouant sur les paramètres max_df et min_df du vectoriseur TF-IDF, on pourrait sans doute obtenir des caractéristiques différentes.

In [15]:
 count_df = pd.DataFrame(count_train.A, columns=count_vectorizer.get_feature_names())
In [16]:
tfidf_df = pd.DataFrame(tfidf_train.A, columns=tfidf_vectorizer.get_feature_names())
In [17]:
difference = set(count_df.columns) - set(tfidf_df.columns)difference
Out[17]:
set()
In [18]:
print(count_df.equals(tfidf_df))
False
In [19]:
count_df.head()
Out[19]:
 000000000000000310000350000600010001pt000ft000km...حلبعربيعنلممامحاولاتمنهذاوالمرضىยงade
00000000000...0000000000
10000000000...0000000000
20000000000...0000000000
30000000000...0000000000
40000000000...0000000000

5 rows × 56922 columns

In [20]:
tfidf_df.head()
Out[20]:
 000000000000000310000350000600010001pt000ft000km...حلبعربيعنلممامحاولاتمنهذاوالمرضىยงade
00.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0
10.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0
20.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0
30.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0
40.00.00.00.00.00.00.00.00.00.0...0.00.00.00.00.00.00.00.00.00.0

5 rows × 56922 columns

Comparer les modèles

Il est temps d’entraîner et de tester vos modèles.

Nous allons commencer avec un classique du NLP, MultinomialNB. Vous pouvez l’utiliser pour comparer TF-IDF au sac de mots. Mon intuition : le sac de mots (CountVectorizer) fonctionnerait mieux avec ce modèle. (Pour en savoir plus sur la distribution multinomiale et l’intérêt d’utiliser des entiers, voyez cette explication synthétique d’un cours de statistiques de l’UPenn.)

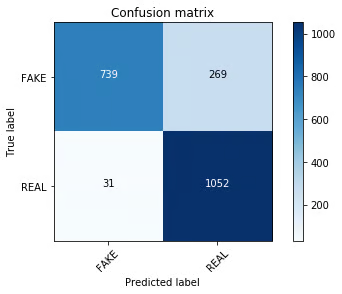
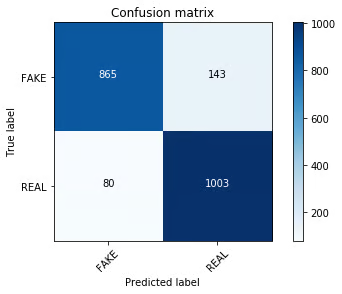
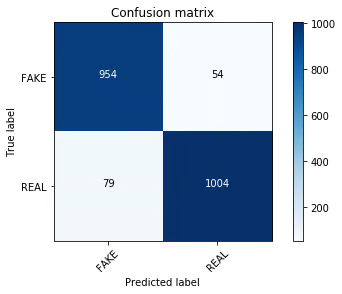
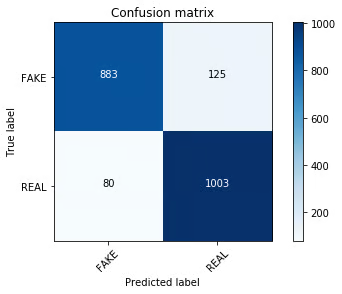
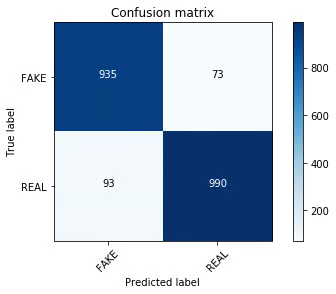
Je trouve les matrices de confusion plus faciles à lire et à comparer ; je me suis donc appuyé sur la documentation scikit-learn pour construire des matrices lisibles (merci l’open source !). Une matrice de confusion affiche les étiquettes correctes sur la diagonale principale (du haut gauche vers le bas droit). Les autres cellules correspondent aux étiquettes incorrectes, souvent appelées faux positifs ou faux négatifs. Selon le problème, l’un des deux peut compter davantage. Par exemple, pour les fake news, est-il plus important d’éviter de classer des articles vrais comme faux ? Si oui, il faudra peut-être pondérer notre score d’exactitude en conséquence.

Au-delà des matrices de confusion, scikit-learn propose de multiples façons de visualiser et comparer vos modèles. Une méthode populaire consiste à utiliser une courbe ROC. D’autres métriques d’évaluation sont disponibles dans le module metrics.

In [21]:
def plot_confusion_matrix(cm, classes,                          normalize=False,                          title='Confusion matrix',                          cmap=plt.cm.Blues):    """    See full source and example:     http://scikit-learn.org/stable/auto_examples/model_selection/plot_confusion_matrix.html        This function prints and plots the confusion matrix.    Normalization can be applied by setting `normalize=True`.    """    plt.imshow(cm, interpolation='nearest', cmap=cmap)    plt.title(title)    plt.colorbar()    tick_marks = np.arange(len(classes))    plt.xticks(tick_marks, classes, rotation=45)    plt.yticks(tick_marks, classes)    if normalize:        cm = cm.astype('float') / cm.sum(axis=1)[:, np.newaxis]        print("Normalized confusion matrix")    else:        print('Confusion matrix, without normalization')    thresh = cm.max() / 2.    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):        plt.text(j, i, cm[i, j],                 horizontalalignment="center",                 color="white" if cm[i, j] > thresh else "black")    plt.tight_layout()    plt.ylabel('True label')    plt.xlabel('Predicted label')
In [22]:
clf = MultinomialNB()
In [23]:
 clf.fit(tfidf_train, y_train)pred = clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.857Confusion matrix, without normalization
 
confusion matrix 1
In [24]:
clf = MultinomialNB() 
In [25]:
clf.fit(count_train, y_train)pred = clf.predict(count_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.893Confusion matrix, without normalization
 
confusion matrix 2
 

Et en effet, sans aucun réglage d’hyperparamètres, votre jeu d’entraînement vectorisé par comptage count_train surpasse visiblement vos vecteurs TF-IDF !

Tester des modèles linéaires

De nombreux articles expliquent que les modèles linéaires fonctionnent très bien avec des vectoriseurs TF-IDF (voir par exemple word2vec pour la classification, la référence SVM dans l’analyse de texte scikit-learn, etc.).

Faut-il donc utiliser un SVM ?

J’ai récemment regardé le cours de Victor Lavrenko sur la classification de textes, où il compare les classifieurs Passive Aggressive aux SVM linéaires. Testons cette approche (rapide mais avec des limites d’apprentissage permanentes) sur notre jeu de données de fake news.

In [26]:
linear_clf = PassiveAggressiveClassifier(n_iter=50)
In [27]:
 linear_clf.fit(tfidf_train, y_train)pred = linear_clf.predict(tfidf_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.936Confusion matrix, without normalization
confusion matrix 3

Waouh !

Impressionnant. La matrice de confusion est différente et le modèle classe un peu mieux nos fake news. Testons si l’ajustement de la valeur alpha d’un MultinomialNB permet d’obtenir des résultats comparables. Vous pouvez aussi utiliser une recherche sur grille pour un réglage plus exhaustif.

In [28]:
clf = MultinomialNB(alpha=0.1)
In [29]:
 last_score = 0for alpha in np.arange(0,1,.1):    nb_classifier = MultinomialNB(alpha=alpha)    nb_classifier.fit(tfidf_train, y_train)    pred = nb_classifier.predict(tfidf_test)    score = metrics.accuracy_score(y_test, pred)    if score > last_score:        clf = nb_classifier    print("Alpha: {:.2f} Score: {:.5f}".format(alpha, score))
Alpha: 0.00 Score: 0.61502Alpha: 0.10 Score: 0.89766Alpha: 0.20 Score: 0.89383Alpha: 0.30 Score: 0.89000Alpha: 0.40 Score: 0.88570Alpha: 0.50 Score: 0.88427Alpha: 0.60 Score: 0.87470Alpha: 0.70 Score: 0.87040Alpha: 0.80 Score: 0.86609Alpha: 0.90 Score: 0.85892

Pas tout à fait… À ce stade, il serait pertinent d’affiner les hyperparamètres de l’ensemble des classifieurs, ou d’examiner d’autres classifieurs bayésiens scikit-learn. Vous pourriez aussi tester un SVM pour voir s’il dépasse le classifieur Passive Aggressive.

Mais je suis surtout curieux de savoir ce que le modèle Passive Aggressive a réellement appris. Passons donc à l’introspection.

Observer l’intérieur des modèles

Alors, le problème des fake news est réglé, n’est-ce pas ? Nous avons obtenu 93 % d’exactitude, on remballe et on rentre.

Évidemment, non. Je reste très prudent face à ces résultats, vu le bruit observé dans les caractéristiques. Il existe une excellente réponse sur StackOverflow présentant une fonction très utile pour trouver les vecteurs influençant le plus les étiquettes. Elle ne fonctionne que pour la classification binaire (2 classes), mais c’est parfait ici puisque nos étiquettes sont FAKE ou REAL.

En utilisant votre meilleur couple classifieur–vecteurs TF-IDF (tfidf_vectorizer) et classifieur Passive Aggressive (linear_clf), inspectez les 30 principaux vecteurs pour les articles faux et vrais :

In [30]:
FAKE -4.86382369883 2016FAKE -4.13847157932 hillaryFAKE -3.98994974843 octoberFAKE -3.10552662226 shareFAKE -2.99713810694 novemberFAKE -2.9150746075 articleFAKE -2.54532100449 printFAKE -2.47115243995 advertisementFAKE -2.35915304509 sourceFAKE -2.31585837413 emailFAKE -2.27985826579 electionFAKE -2.2736680857 octFAKE -2.25253568246 warFAKE -2.19663276969 mosulFAKE -2.17921304122 podestaFAKE -1.99361009573 novFAKE -1.98662624907 comFAKE -1.9452527887 establishmentFAKE -1.86869495684 corporateFAKE -1.84166664376 wikileaksFAKE -1.7936566878 26FAKE -1.75686475396 donaldFAKE -1.74951154055 snipFAKE -1.73298170472 mainstreamFAKE -1.71365596627 ukFAKE -1.70917804969 ayotteFAKE -1.70781651904 entireFAKE -1.68272667818 jewishFAKE -1.65334397724 youtubeFAKE -1.6241703128 pipelineREAL 4.78064061698 saidREAL 2.68703967567 tuesdayREAL 2.48309800829 gopREAL 2.45710670245 islamicREAL 2.44326123901 saysREAL 2.29424417889 cruzREAL 2.29144842597 marriageREAL 2.20500735471 candidatesREAL 2.19136552672 conservativeREAL 2.18030834903 mondayREAL 2.05688105375 attacksREAL 2.03476457362 rushREAL 1.9954523319 continueREAL 1.97002430576 fridayREAL 1.95034103105 conventionREAL 1.94620720989 senREAL 1.91185661202 jobsREAL 1.87501303774 debateREAL 1.84059602241 presumptiveREAL 1.80111133252 sayREAL 1.80027216061 sundayREAL 1.79650823765 marchREAL 1.79229792108 parisREAL 1.74587899553 securityREAL 1.69585506276 conservativesREAL 1.68860503431 recountsREAL 1.67424302821 dealREAL 1.67343398121 campaignREAL 1.66148582079 foxREAL 1.61425630518 attack

Vous pouvez aussi le faire très simplement en Python : associez coefficients et caractéristiques avec zip, puis regardez le début et la fin de la liste.

In [31]:
feature_names = tfidf_vectorizer.get_feature_names()
In [32]:
### Most realsorted(zip(clf.coef_[0], feature_names), reverse=True)[:20]
Out[32]:
[(-6.2573612147015822, 'trump'), (-6.4944530943126777, 'said'), (-6.6539784739838845, 'clinton'), (-7.0379446628670728, 'obama'), (-7.1465399833812278, 'sanders'), (-7.2153760086475112, 'president'), (-7.2665628057416169, 'campaign'), (-7.2875931446681514, 'republican'), (-7.3411184585990643, 'state'), (-7.3413571102479054, 'cruz'), (-7.3783124419854254, 'party'), (-7.4468806724578904, 'new'), (-7.4762888011545883, 'people'), (-7.547225599514773, 'percent'), (-7.5553074094582335, 'bush'), (-7.5801506339098932, 'republicans'), (-7.5855405012652435, 'house'), (-7.6344781725203141, 'voters'), (-7.6484824436952987, 'rubio'), (-7.6734836186463795, 'states')]
In [33]:
### Most fakesorted(zip(clf.coef_[0], feature_names))[:20]
Out[33]:
[(-11.349866225220305, '0000'), (-11.349866225220305, '000035'), (-11.349866225220305, '0001'), (-11.349866225220305, '0001pt'), (-11.349866225220305, '000km'), (-11.349866225220305, '0011'), (-11.349866225220305, '006s'), (-11.349866225220305, '007'), (-11.349866225220305, '007s'), (-11.349866225220305, '008s'), (-11.349866225220305, '0099'), (-11.349866225220305, '00am'), (-11.349866225220305, '00p'), (-11.349866225220305, '00pm'), (-11.349866225220305, '014'), (-11.349866225220305, '015'), (-11.349866225220305, '018'), (-11.349866225220305, '01am'), (-11.349866225220305, '020'), (-11.349866225220305, '023')]

On voit clairement certains mots révélant une intention ou une source politique parmi les caractéristiques associées aux faux (par exemple corporate ou establishment).

On observe aussi que les données d’articles « vrais » emploient plus souvent des formes du verbe « to say », probablement parce que la presse cite fréquemment des sources (« La chancelière allemande Angela Merkel a déclaré… »).

Pour extraire la liste complète depuis votre classifieur actuel et examiner chaque jeton (ou comparer facilement d’un classifieur à l’autre), exportez-la ainsi.

In [34]:
tokens_with_weights = sorted(list(zip(feature_names, clf.coef_[0])))

Intermezzo : HashingVectorizer

Un autre vectoriseur parfois utilisé pour la classification de texte est le HashingVectorizer. Les HashingVectorizer demandent moins de mémoire et sont plus rapides (car ils produisent des matrices creuses et s’appuient sur des hachages plutôt que sur des jetons), mais ils sont plus difficiles à introspecter. Vous pouvez en lire davantage sur les avantages et limites de HashingVectorizer dans la documentation scikit-learn.

Essayez-le et comparez ses résultats à ceux des autres vectoriseurs. Les performances sont honorables, meilleures que le TF-IDF avec MultinomialNB (ce qui est attendu pour des raisons similaires à celles qui font que CountVectorizer performe mieux), mais inférieures au TF-IDF avec l’algorithme linéaire Passive Aggressive.

In [35]:
hash_vectorizer = HashingVectorizer(stop_words='english', non_negative=True)hash_train = hash_vectorizer.fit_transform(X_train)hash_test = hash_vectorizer.transform(X_test)
In [36]:
clf = MultinomialNB(alpha=.01)
In [37]:
clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.902Confusion matrix, without normalization
 
confusion matrix 4
In [38]:
clf = PassiveAggressiveClassifier(n_iter=50)
In [39]:
clf.fit(hash_train, y_train)pred = clf.predict(hash_test)score = metrics.accuracy_score(y_test, pred)print("accuracy:   %0.3f" % score)cm = metrics.confusion_matrix(y_test, pred, labels=['FAKE', 'REAL'])plot_confusion_matrix(cm, classes=['FAKE', 'REAL'])
accuracy:   0.921Confusion matrix, without normalization
confusion matrix 5

Conclusion

Alors, l’expérience de classifieur de fake news est-elle un succès ? Clairement non.

Mais avez-vous pu manipuler un nouveau jeu de données, tester des modèles de classification NLP et examiner leur comportement ? Oui.

Comme prévu dès le départ, définir les fake news avec un simple sac de mots ou des vecteurs TF-IDF est une approche trop simpliste, d’autant plus avec un jeu de données multilingue plein de bruit. Sans introspection de ce que votre modèle a réellement appris, vous auriez pu croire qu’il captait quelque chose de pertinent. Moralité : essayez toujours d’introspecter vos modèles (autant que possible) !

Je serais curieux de connaître d’autres tendances que j’aurais pu manquer. Je publierai un billet comparant différents classifieurs sous l’angle des caractéristiques les plus importantes sur mon blog. Si vous trouvez des éléments intéressants, partagez-les en commentaire ou contactez-moi sur Twitter (je suis @kjam).

J’espère que cette exploration d’un nouveau jeu de données NLP vous a plu !

Découvrez aussi le tutoriel DataCamp Python Machine Learning : Scikit-Learn Tutorial.

Sujets
Python
Science des données
Apprentissage automatique

Cours de machine learning

Cours

Apprentissage supervisé avec scikit-learn

4 h
303.1K
Développez vos compétences en machine learning avec scikit-learn en Python et apprenez à faire des prédictions à partir de données réelles.
Afficher les détailsRight Arrow
Commencer Le Cours
Voir plusRight Arrow