
Kursus
Exploratory Data Analysis in Python
4 jam
119.3K
Mari mulai dengan plot data paling umum yang banyak digunakan di berbagai bidang dan dapat dibuat di sebagian besar library visualisasi data Python (kecuali beberapa yang sangat terspesialisasi).
Diagram batang adalah visualisasi data paling umum untuk menampilkan nilai numerik dari data kategorikal guna membandingkan berbagai kategori. Kategori direpresentasikan oleh batang persegi panjang dengan lebar sama dan tinggi (untuk diagram batang vertikal) atau panjang (untuk diagram batang horizontal) yang proporsional dengan nilai numerik yang diwakilinya.
Untuk membuat diagram batang dasar di matplotlib, kita gunakan fungsi matplotlib.pyplot.bar() sebagai berikut:
# Data preparation
penguins_grouped = penguins[['species', 'bill_length_mm']].groupby('species').mean().reset_index()
# Creating a bar chart
plt.bar(penguins_grouped['species'], penguins_grouped['bill_length_mm'])
plt.title('Average penguin bill length by species')
plt.show()
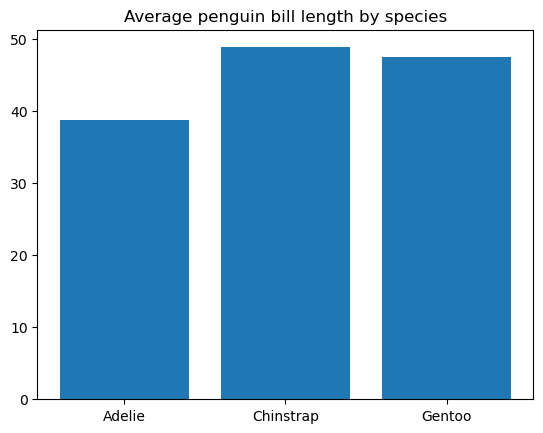
Kita dapat menyesuaikan lebar dan warna batang, lebar dan warna tepi batang, menambahkan label ticks pada batang, mengisi batang dengan pola, dan lain-lain.
Plot garis adalah jenis bagan data yang menunjukkan perkembangan variabel dari kiri ke kanan sepanjang sumbu x melalui titik data yang dihubungkan oleh segmen garis lurus. Umumnya, perubahan variabel diplot terhadap waktu. Memang, plot garis sering digunakan untuk memvisualisasikan deret waktu, seperti dibahas dalam tutorial tentang plot garis deret waktu Matplotlib.
Kita dapat membuat plot garis dasar di matplotlib menggunakan fungsi matplotlib.pyplot.plot() sebagai berikut:
# Data preparation
flights_grouped = flights[['year', 'passengers']].astype({'year': 'string'}).groupby('year').sum().reset_index()
# Creating a line plot
plt.plot(flights_grouped['year'], flights_grouped['passengers'])
plt.title('Total number of passengers by year')
plt.show()
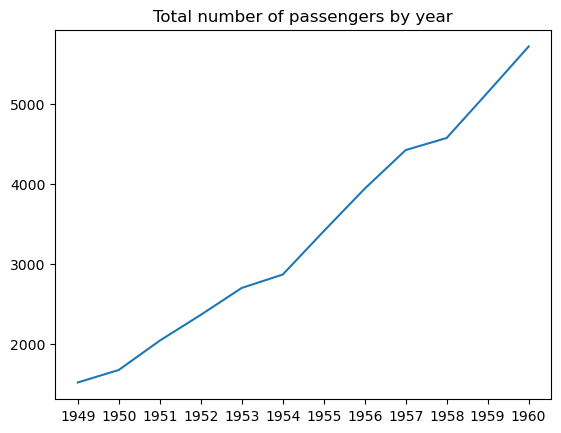
Dimungkinkan untuk menyesuaikan lebar, gaya, warna, dan transparansi garis, menambahkan dan menyesuaikan marker, dan lain-lain.
Tutorial Line Plots in MatplotLib with Python menyediakan lebih banyak penjelasan dan contoh tentang cara membuat dan menyesuaikan plot garis di matplotlib. Untuk mempelajari cara membuat dan menyesuaikan plot garis di seaborn, baca Python Seaborn Line Plot Tutorial: Create Data Visualizations.
Plot sebar adalah jenis visualisasi data yang menampilkan hubungan antara dua variabel yang diplot sebagai titik data pada bidang koordinat. Plot ini digunakan untuk memeriksa apakah dua variabel saling berkorelasi, seberapa kuat korelasinya, dan apakah ada klaster yang jelas dalam data.
Kode di bawah ini mengilustrasikan cara membuat plot sebar dasar di matplotlib menggunakan fungsi matplotlib.pyplot.scatter():
# Creating a scatter plot
plt.scatter(penguins['bill_length_mm'], penguins['bill_depth_mm'])
plt.title('Penguin bill length vs. bill depth')
plt.show()
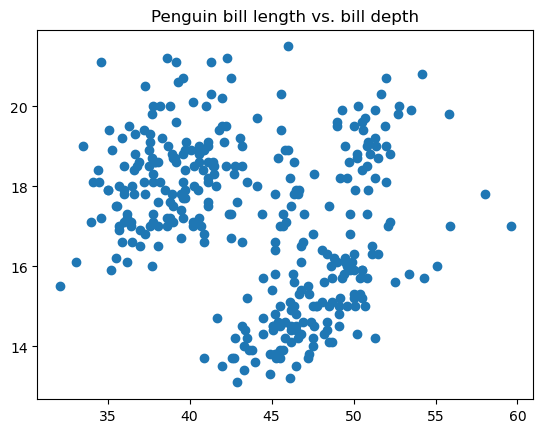
Kita dapat menyesuaikan ukuran, gaya, warna, transparansi titik, lebar tepi, warna tepi, dan lainnya.
Anda dapat membaca lebih lanjut tentang plot sebar (dan bukan hanya itu!) dalam tutorial ini: Data Demystified: Data Visualizations that Capture Relationships.
Histogram adalah jenis plot data yang merepresentasikan distribusi frekuensi nilai dari sebuah variabel numerik. Di balik layar, data dibagi ke dalam kelompok rentang nilai yang disebut bin, menghitung jumlah titik pada setiap bin, lalu menampilkan setiap bin sebagai batang vertikal dengan tinggi proporsional terhadap jumlah pada bin tersebut. Histogram dapat dianggap sebagai jenis khusus dari diagram batang, hanya saja batang-batang bersebelahan menempel tanpa celah, mengingat sifat bin yang kontinu.
Kita dapat dengan mudah membuat histogram dasar di matplotlib menggunakan fungsi matplotlib.pyplot.hist():
# Creating a histogram
plt.hist(penguins['bill_length_mm'])
plt.title('Penguin bill length distribution')
plt.show()
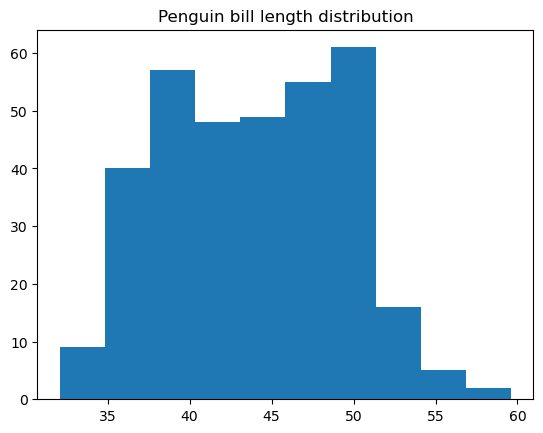
Banyak hal dapat dikustomisasi dalam fungsi ini, termasuk warna dan gaya histogram, jumlah bin, tepi bin, rentang bawah dan atas bin, apakah histogram reguler atau kumulatif, dan sebagainya.
Untuk lebih banyak contoh histogram, lihat Histograms in Matplotlib dan How to Create a Histogram with Plotly.
Box plot adalah jenis plot data yang menampilkan lima statistik deskriptif dari data: nilai minimum dan maksimum (tidak termasuk outlier), median, serta kuartil pertama dan ketiga. Secara opsional, nilai mean juga dapat ditampilkan. Box plot tepat dipilih jika Anda hanya tertarik pada statistik ini tanpa menggali distribusi data mendasar yang sebenarnya.
Dalam tutorial 11 Teknik Visualisasi Data untuk Setiap Use-Case beserta Contohnya, Anda akan menemukan, di antaranya, penjelasan lebih rinci tentang jenis informasi statistik yang dapat diperoleh dari box plot.
Kita dapat membuat box plot dasar di matplotlib menggunakan fungsi matplotlib.pyplot.boxplot() seperti di bawah ini:
# Data preparation
penguins_cleaned = penguins.dropna()
# Creating a box plot
plt.boxplot(penguins_cleaned['bill_length_mm'])
plt.title('Penguin bill length distribution')
plt.show()
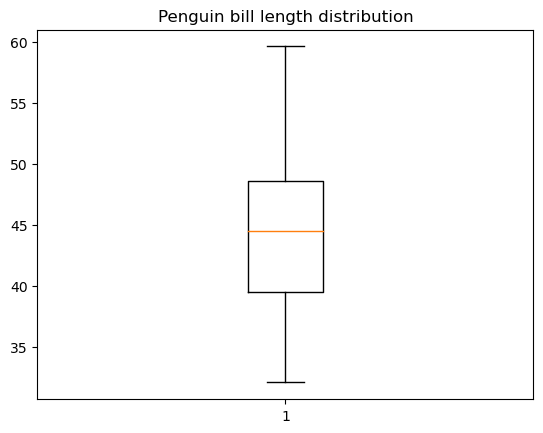
Ada banyak ruang untuk menyesuaikan box plot: lebar dan orientasi box, posisi box dan whisker, visibilitas dan gaya berbagai elemen box plot, dan lainnya.
Perhatikan bahwa untuk membuat box plot menggunakan fungsi ini, kita perlu memastikan terlebih dahulu bahwa data tidak mengandung nilai hilang. Memang, pada contoh di atas, kita menghapus nilai hilang dari data sebelum memplot. Sebagai perbandingan, library Seaborn tidak memiliki keterbatasan ini dan menangani nilai hilang di balik layar, seperti berikut:
# Creating a box plot
sns.boxplot(data=penguins, y='bill_length_mm')
plt.title('Penguin bill length distribution')
plt.show()
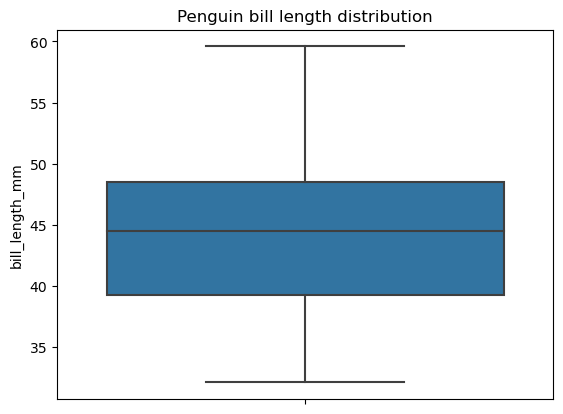
Diagram pai adalah jenis visualisasi data yang direpresentasikan oleh lingkaran yang dibagi menjadi sektor, di mana setiap sektor sesuai dengan kategori tertentu dari data kategorikal, dan sudut setiap sektor mencerminkan proporsi kategori tersebut sebagai bagian dari keseluruhan. Berbeda dengan diagram batang, diagram pai dimaksudkan untuk menggambarkan kategori yang membentuk keseluruhan, misalnya penumpang sebuah kapal.
Diagram pai memiliki beberapa kelemahan:
Oleh karena itu, diagram pai sebaiknya digunakan secara hemat dan dengan kehati-hatian.
Untuk membuat diagram pai dasar di matplotlib, kita perlu menerapkan fungsi matplotlib.pyplot.pie() sebagai berikut:
# Data preparation
titanic_grouped = titanic.groupby('class')['pclass'].count().reset_index()
# Creating a pie chart
plt.pie(titanic_grouped['pclass'], labels=titanic_grouped['class'])
plt.title('Number of passengers by class')
plt.show()
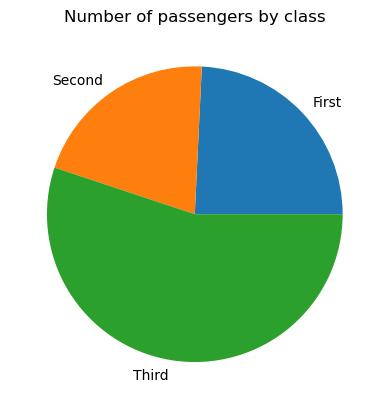
Jika perlu, kita dapat menyesuaikan plot pai: mengubah warna irisan, menambahkan offset pada beberapa irisan (biasanya yang sangat kecil), mengubah radius lingkaran, menyesuaikan format label, mengisi sebagian atau semua irisan dengan pola, dan lain-lain.
Untuk pembahasan lebih dalam tentang diagram pai, termasuk menambahkan persentase dan irisan yang dipecah, baca Python Pie Chart: Build and Style with Pandas and Matplotlib.
Di bagian ini, kita akan mengeksplorasi berbagai plot data lanjutan. Beberapa merupakan variasi dari jenis visualisasi umum yang kita bahas sebelumnya, sementara yang lain adalah jenis tersendiri.
Jika diagram batang umum digunakan untuk menampilkan nilai numerik variabel kategorikal per kategori, diagram batang berkelompok memiliki tujuan yang sama tetapi lintas dua variabel kategorikal. Secara grafis, ini berarti kita memiliki beberapa kelompok batang, dengan setiap kelompok terkait kategori tertentu dari satu variabel dan setiap batang dalam kelompok tersebut terkait kategori tertentu dari variabel kedua. Diagram batang berkelompok paling efektif ketika variabel kedua tidak lebih dari tiga kategori. Jika lebih, plot menjadi terlalu padat dan kurang membantu.
Seperti diagram batang umum, kita dapat membuat diagram batang berkelompok dengan matplotlib. Namun, library Seaborn menawarkan fungsionalitas yang lebih nyaman melalui fungsi seaborn.barplot() untuk membuat plot seperti ini. Mari lihat contoh pembuatan diagram batang berkelompok dasar untuk panjang paruh penguin lintas dua variabel kategorikal: spesies dan jenis kelamin.
# Creating a grouped bar chart
sns.barplot(data=penguins, x='species', y='bill_length_mm', hue='sex')
plt.title('Penguin bill length by species and sex')
plt.show()
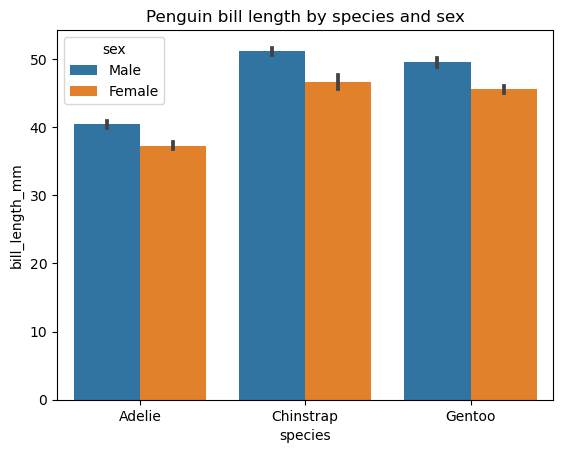
Variabel kategorikal kedua diperkenalkan melalui parameter hue. Parameter opsional lain memungkinkan mengubah orientasi, lebar, dan warna batang, urutan kategori, estimator statistik, dan lainnya.
Untuk menyelami lebih jauh plotting dengan Seaborn, pertimbangkan kursus berikut: Intermediate Data Visualization with Seaborn.
Diagram area bertumpuk adalah perpanjangan dari diagram area umum (yang pada dasarnya adalah plot garis dengan area di bawah garis diberi warna atau pola) dengan banyak area, masing-masing mewakili variabel tertentu, ditumpuk satu sama lain. Plot ini berguna ketika kita perlu melacak baik perkembangan keseluruhan dari sekumpulan variabel maupun kontribusi masing-masing variabel terhadap perkembangan tersebut. Seperti plot garis, diagram area bertumpuk biasanya menunjukkan perubahan variabel dari waktu ke waktu.
Penting untuk diingat keterbatasan utama diagram area bertumpuk: plot ini terutama membantu menangkap tren umum, bukan nilai pasti untuk area yang ditumpuk.
Untuk membuat diagram area bertumpuk dasar di matplotlib, kita gunakan fungsi matplotlib.pyplot.stackplot() seperti di bawah ini:
# Data preparation
flights_grouped = flights.groupby(['year', 'month']).mean().reset_index()
flights_49_50 = pd.DataFrame(list(zip(flights_grouped.loc[:11, 'month'].tolist(), flights_grouped.loc[:11, 'passengers'].tolist(), flights_grouped.loc[12:23, 'passengers'].tolist())), columns=['month', '1949', '1950'])
# Creating a stacked area chart
plt.stackplot(flights_49_50['month'], flights_49_50['1949'], flights_49_50['1950'], labels=['1949', '1950'])
plt.title('Number of passengers in 1949 and 1950 by month')
plt.legend()
plt.show()
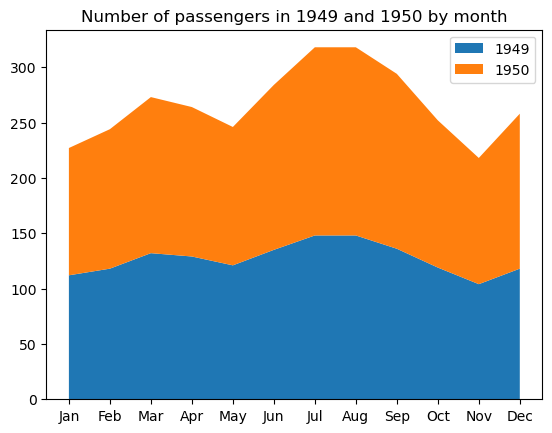
Beberapa properti yang dapat disesuaikan antara lain warna area, transparansi, pola isian, serta lebar, gaya, warna, dan transparansi garis.
Pada bagian Jenis Plot Data Umum, kita mendefinisikan box plot sebagai visualisasi data yang menampilkan lima statistik deskriptif. Kadang-kadang, kita ingin menampilkan dan membandingkan statistik ini secara terpisah untuk setiap kategori dari variabel kategorikal. Dalam kasus tersebut, kita perlu memplot beberapa box pada area plot yang sama, yang dapat dengan mudah dilakukan dengan fungsi seaborn.boxplot() sebagai berikut:
# Creating multiple box plots
sns.boxplot(data=penguins, x='bill_length_mm', y='species')
plt.title('Penguin bill length distribution by species')
plt.show()
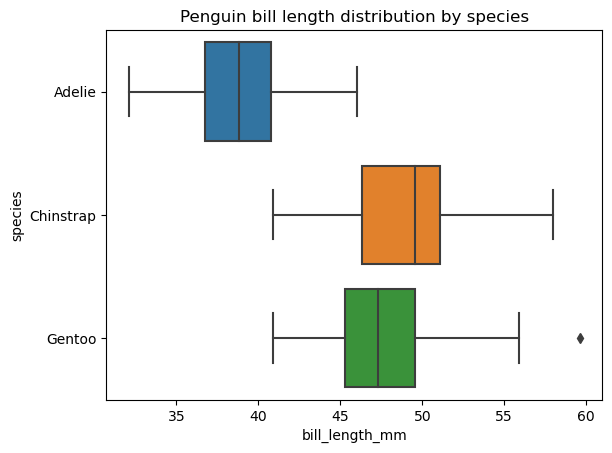
Kita dapat mengubah urutan box plot, orientasi, warna, transparansi, lebar, properti berbagai elemennya, menambahkan variabel kategorikal lain pada area plot, dan sebagainya.
Plot biola mirip dengan box plot dan menampilkan statistik umum data yang sama, namun juga menampilkan bentuk distribusi datanya. Seperti pada box plot, kita dapat membuat satu plot biola untuk data yang diminati atau, lebih sering, banyak plot biola, masing-masing untuk kategori terpisah dari variabel kategorikal.
Seaborn menyediakan lebih banyak ruang untuk membuat dan menyesuaikan plot biola dibanding matplotlib. Untuk membuat plot biola dasar di seaborn, gunakan fungsi seaborn.violinplot() seperti di bawah ini:
# Creating a violin plot
sns.violinplot(data=penguins, x='bill_length_mm', y='species')
plt.title('Penguin bill length distribution by species')
plt.show()
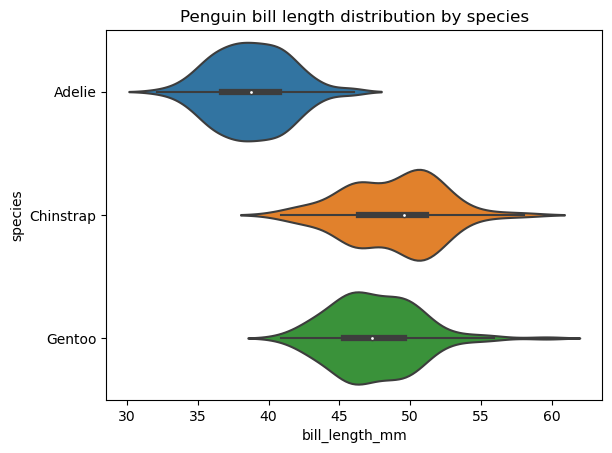
Kita dapat mengubah urutan violin, orientasi, warna, transparansi, lebar, properti berbagai elemennya, memperluas distribusi melewati titik data ekstrem, menambahkan variabel kategorikal lain pada area plot, memilih cara representasi titik data di bagian dalam violin, dan lain-lain.
Heatmap adalah jenis visualisasi data bergaya tabel di mana setiap titik data numerik digambarkan berdasarkan skala warna yang dipilih dan menurut besaran titik data dalam dataset. Gagasan utama di balik plot ini adalah untuk menggambarkan potensi titik panas dan dingin dalam data yang mungkin membutuhkan perhatian khusus.
Dalam banyak kasus, data memerlukan praproses sebelum membuat heatmap. Ini biasanya mencakup pembersihan dan normalisasi data.
Kode di bawah menunjukkan cara membuat heatmap dasar (setelah praproses data yang diperlukan) menggunakan fungsi seaborn.heatmap():
# Data preparation
from sklearn import preprocessing
car_crashes_cleaned = car_crashes.drop(labels='abbrev', axis=1).iloc[0:10]
min_max_scaler = preprocessing.MinMaxScaler()
car_crashes_normalized = pd.DataFrame(min_max_scaler.fit_transform(car_crashes_cleaned.values), columns=car_crashes_cleaned.columns)
# Creating a heatmap
sns.heatmap(car_crashes_normalized, annot=True)
plt.title('Car crash heatmap for the first 10 car crashes')
plt.show()
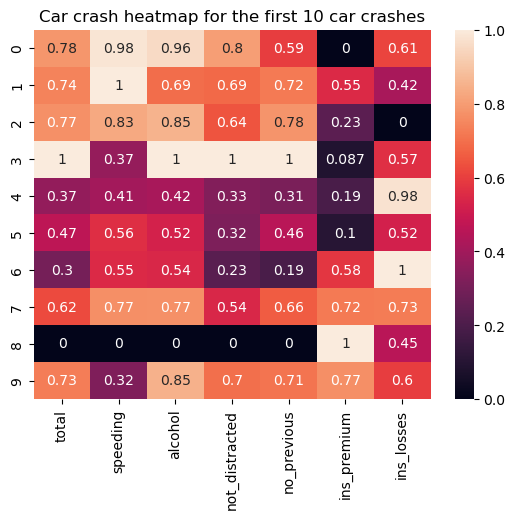
Beberapa penyesuaian yang mungkin meliputi pemilihan colormap, penentuan nilai anchor, pemformatan anotasi, kustomisasi garis pemisah, penerapan masker, dan lain-lain.
Untuk panduan heatmap yang lebih mendetail, termasuk colormap dan anotasi kustom, baca Seaborn Heatmaps: A Guide to Data Visualization.
Terakhir, mari lihat beberapa jenis visualisasi data yang jarang digunakan atau bahkan kurang dikenal. Banyak di antaranya memiliki setidaknya satu analog di antara jenis grafik yang lebih populer. Namun, dalam beberapa kasus khusus, visualisasi data yang tidak konvensional ini bisa bekerja lebih efektif daripada plot yang umum digunakan.
Plot stem pada dasarnya adalah cara lain untuk merepresentasikan diagram batang, hanya saja alih-alih batang padat, terdiri dari garis tipis dengan marker (opsional) di puncaknya. Walau plot stem tampak seperti variasi berlebih dari diagram batang, sebenarnya ini adalah alternatif yang lebih baik ketika memvisualisasikan banyak kategori. Keunggulan plot stem atas diagram batang adalah rasio tinta-data yang lebih baik sehingga keterbacaan meningkat.
Untuk membuat plot stem dasar di matplotlib, kita gunakan fungsi matplotlib.pyplot.stem() sebagai berikut:
# Data preparation
fmri_grouped = fmri.groupby('subject')[['subject', 'signal']].max()
# Creating a stem plot
plt.stem(fmri_grouped['subject'], fmri_grouped['signal'])
plt.title('FMRI maximum signal by subject')
plt.show()
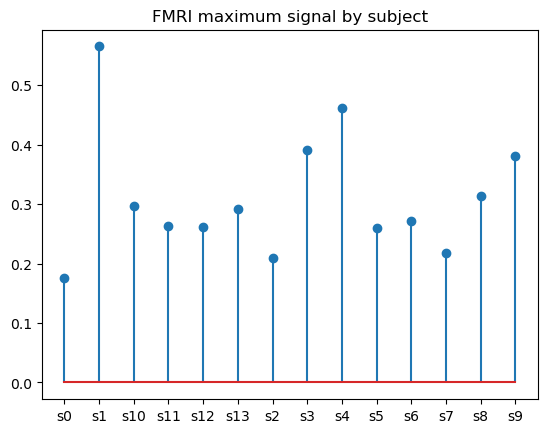
Kita dapat mengubah orientasi stem dan menyesuaikan properti stem, baseline, dan marker melalui parameter opsional.
Dua jenis visualisasi data yang sangat mirip ini dapat dianggap sebagai implementasi plot sebar untuk variabel kategorikal: baik strip maupun swarm plot menampilkan bagian dalam distribusi data, termasuk ukuran sampel dan posisi titik data individual namun mengecualikan statistik deskriptif. Perbedaan utama antara keduanya adalah pada strip plot, titik data dapat saling tumpang tindih, sementara pada swarm plot, tidak. Sebaliknya, pada swarm plot, titik data disejajarkan sepanjang sumbu kategorikal.
Perlu diingat bahwa baik strip maupun swarm plot hanya membantu untuk dataset yang relatif kecil.
Berikut cara membuat strip plot dengan fungsi seaborn.stripplot():
# Creating a strip plot
sns.stripplot(data=penguins, x='bill_length_mm', y='species')
plt.title('Penguin bill length distribution by species')
plt.show()
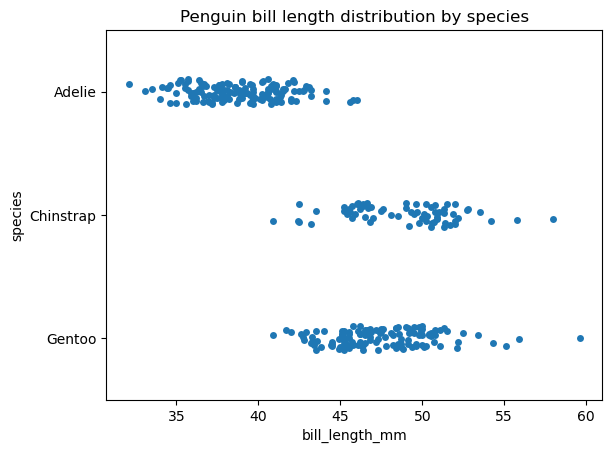
Sekarang, mari buat swarm plot dengan fungsi seaborn.swarmplot() untuk data yang sama dan amati perbedaannya:
# Creating a swarm plot
sns.swarmplot(data=penguins, x='bill_length_mm', y='species')
plt.title('Penguin bill length distribution by species')
plt.show()
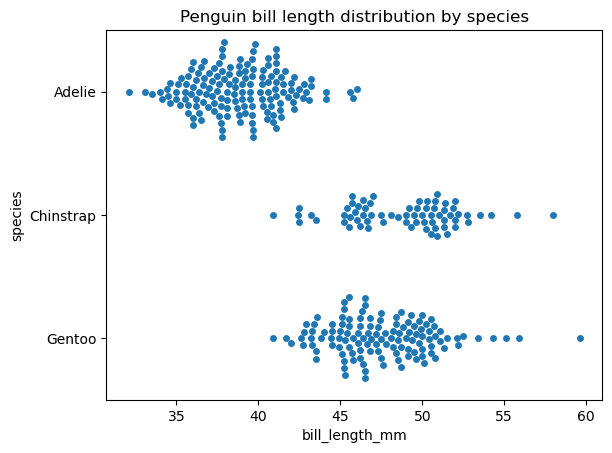
Fungsi seaborn.stripplot() dan seaborn.swarmplot() memiliki sintaks yang sangat mirip. Beberapa properti yang dapat disesuaikan pada keduanya antara lain urutan dan orientasi plot serta properti marker seperti gaya, ukuran, warna, transparansi, dan lainnya. Mengatur transparansi marker membantu mengatasi masalah tumpang tindih titik pada strip plot.
Treemap adalah jenis plot data yang digunakan untuk memvisualisasikan nilai numerik dari data kategorikal per kategori sebagai sekumpulan persegi panjang di dalam bingkai persegi panjang, dengan luas setiap persegi panjang proporsional terhadap nilai kategori yang sesuai. Dari segi tujuan, treemap identik dengan diagram batang dan diagram pai. Mirip diagram pai, treemap terutama dimaksudkan untuk menggambarkan kategori yang membentuk keseluruhan. Treemap dapat terlihat efektif dan menarik ketika ada hingga sepuluh kategori dengan perbedaan nilai numerik yang jelas.
Kekurangan treemap sangat mirip dengan diagram pai:
Kita harus mengingat poin-poin ini dan menggunakan treemap secara hemat dan hanya ketika paling tepat.
Untuk membuat treemap di Python, pertama kita perlu menginstal dan mengimpor library squarify: pip install squarify, lalu import squarify. Kode berikut membuat treemap dasar:
import squarify
# Data preparation
diamonds_grouped = diamonds[['cut', 'price']].groupby('cut').mean().reset_index()
# Creating a treemap
squarify.plot(sizes=diamonds_grouped['price'], label=diamonds_grouped['cut'])
plt.title('Average diamond price by cut')
plt.show()
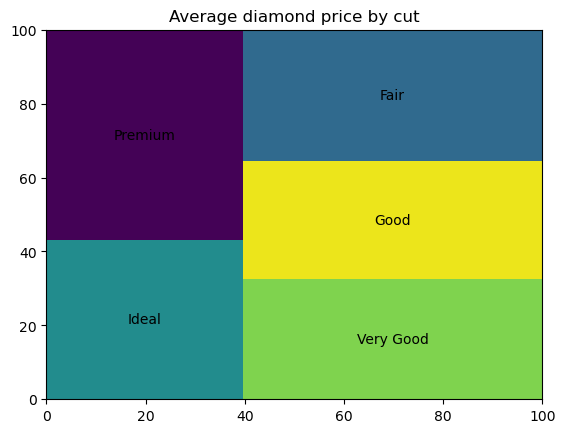
Kita dapat menyesuaikan warna dan transparansi persegi panjang, mengisinya dengan pola, mengatur properti tepi persegi panjang, menambahkan celah kecil antar persegi panjang, serta mengatur properti teks label.
Ada pendekatan lain untuk membuat treemap di Python menggunakan library plotly. Anda dapat membaca lebih lanjut di tutorial What is Data Visualization? A Guide for Data Scientists.
Word cloud adalah jenis visualisasi data teks di mana ukuran font setiap kata sesuai dengan frekuensi kemunculannya dalam teks masukan. Menggunakan word cloud membantu menemukan kata-kata paling penting dalam sebuah teks.
Meskipun word cloud selalu menarik perhatian dan intuitif bagi berbagai audiens, kita perlu menyadari beberapa keterbatasan bawaan dari jenis plot ini:
Aplikasi word cloud yang menarik dan kurang dikenal adalah kita dapat membuatnya bukan berdasarkan frekuensi kata, melainkan atribut lain yang ditetapkan ke setiap kata. Misalnya, kita bisa membuat kamus negara, menetapkan nilai populasi pada tiap negara, dan menampilkannya.
Untuk membuat word cloud di Python, kita perlu menggunakan library khusus wordcloud. Pertama instal (pip install wordcloud), lalu impor kelas WordCloud dan stopwords: from wordcloud import WordCloud, STOPWORDS. Kode berikut menghasilkan word cloud dasar:
from wordcloud import WordCloud, STOPWORDS
text = 'cat cat cat cat cat cat dog dog dog dog dog panda panda panda panda koala koala koala rabbit rabbit fox'
# Creating a word cloud
wordcloud = WordCloud().generate(text)
plt.imshow(wordcloud)
plt.title('Words by their frequency in the text')
plt.axis('off')
plt.show()
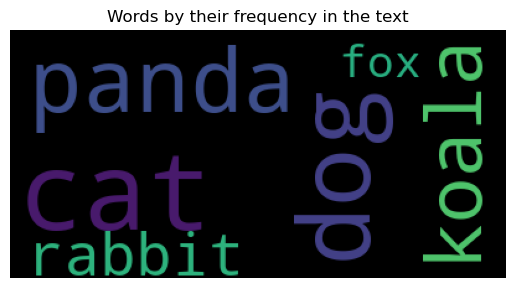
Dimungkinkan untuk menyesuaikan dimensi word cloud, mengganti warna latar belakang, menetapkan colormap untuk kata, memberi preferensi pada kata horizontal dibanding vertikal, membatasi jumlah kata maksimum yang ditampilkan, memperbarui daftar stopwords, membatasi ukuran font, mempertimbangkan kolokasi kata, memastikan reprodusibilitas grafik, dan lain-lain.
Jika Anda ingin mempelajari lebih lanjut tentang word cloud di Python, berikut bacaan yang bagus: Generating WordClouds in Python Tutorial.
Mulai Perjalanan Visualisasi Data Anda Hari Ini!
Kursus
Program
Kursus
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



