Kursus
Rekayasa Fitur untuk NLP di Python
4 jam
29.8K
Janji machine learning telah menunjukkan banyak hasil menakjubkan di berbagai bidang. Pemrosesan bahasa alami tidak terkecuali, dan merupakan salah satu bidang di mana machine learning mampu menunjukkan kecerdasan buatan umum (tidak sepenuhnya tetapi setidaknya sebagian) dengan mencapai hasil cemerlang untuk tugas-tugas yang benar-benar rumit.
NLP (natural language processing) memang bukan bidang baru, begitu juga machine learning. Namun, perpaduan keduanya tergolong mutakhir dan terus menjanjikan kemajuan. Ini adalah salah satu aplikasi hibrida yang setiap orang (dengan ponsel pintar beranggaran terjangkau) temui setiap hari. Misalnya, perhatikan "saran kata pada keyboard", atau pelengkapan otomatis yang cerdas; semua ini adalah produk sampingan dari penggabungan NLP dan Machine Learning, dan secara alami telah menjadi bagian tak terpisahkan dari hidup kita.
Analisis sentimen adalah topik penting dalam bidang NLP. Topik ini dengan cepat menjadi salah satu yang paling hangat karena relevansinya dan banyaknya masalah bisnis yang berhasil dipecahkan dan dijawab. Dalam tutorial ini, Anda akan membahas topik yang tidak begitu sederhana ini dengan cara yang sederhana. Anda akan menguraikan sedikit matematika di baliknya, dan mempelajarinya. Anda juga akan membangun pengklasifikasi sentimen sederhana di akhir tutorial ini. Secara khusus, Anda akan membahas:
Mari kita mulai.
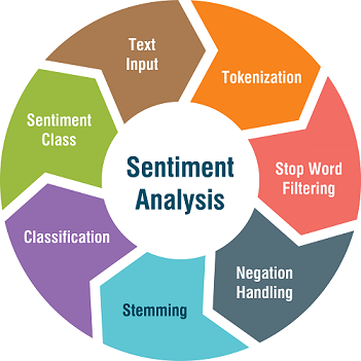
Pada dasarnya, analisis sentimen atau klasifikasi sentimen termasuk dalam kategori luas tugas klasifikasi teks di mana Anda diberikan sebuah frasa, atau daftar frasa, dan pengklasifikasi Anda harus memberi tahu apakah sentimen di baliknya positif, negatif, atau netral. Terkadang, atribut ketiga tidak digunakan agar tetap menjadi masalah klasifikasi biner. Pada tugas-tugas terbaru, sentimen seperti "agak positif" dan "agak negatif" juga dipertimbangkan. Mari pahami dengan contoh.
Pertimbangkan frasa berikut:
Frasa-frasa tersebut sesuai dengan ulasan film singkat, dan masing-masing menyampaikan sentimen yang berbeda. Misalnya, frasa pertama menunjukkan sentimen positif tentang film Titanic sementara frasa kedua menganggap film itu tidak begitu bagus (sentimen negatif). Perhatikan frasa ketiga lebih saksama. Tidak ada kata dalam frasa itu yang dapat memberi tahu Anda apa pun mengenai sentimen yang disampaikannya. Maka, itu adalah contoh sentimen netral.
Sekarang, dari sudut pandang machine learning yang ketat, tugas ini tidak lain adalah tugas pembelajaran terawasi. Anda akan memasok sekumpulan frasa (dengan label sentimen masing-masing) ke model machine learning, dan Anda akan menguji model pada frasa yang tidak berlabel.
Untuk sekadar memperkenalkan analisis sentimen ini sudah cukup, tetapi untuk dapat membangun model klasifikasi sentimen, Anda membutuhkan sesuatu yang lebih. Mari lanjutkan.
 Sumber: SlideShare
Sebelum memahami pernyataan masalah dari tugas klasifikasi sentimen, Anda perlu memiliki gambaran jelas tentang masalah klasifikasi teks umum. Mari kita definisikan secara formal masalah dari tugas klasifikasi teks umum.
Istilah dokumen di sini bersifat subjektif dalam dunia klasifikasi teks. Dengan dokumen, yang dimaksud adalah cuitan, frasa, bagian artikel berita, seluruh artikel berita, sebuah artikel penuh, manual produk, cerita, dll. Alasan di balik terminologi ini adalah kata yang merupakan entitas atomik dan kecil dalam konteks ini. Jadi, untuk menyebut rangkaian kata yang panjang, istilah dokumen digunakan secara umum. Cuitan berarti dokumen yang lebih pendek sedangkan artikel berarti dokumen yang lebih panjang.
Jadi, sebuah himpunan latih dari n dokumen berlabel tampak seperti: (d1,c1), (d2,c2),...,(dn,cn) dan keluaran akhirnya adalah sebuah pengklasifikasi yang telah dipelajari.
Anda sudah berada di jalur yang benar! Namun satu pertanyaan yang mungkin Anda miliki saat ini adalah di mana fitur-fitur dari dokumen? Pertanyaan yang wajar! Anda akan membahasnya sedikit lagi.
Sekarang, mari lanjutkan dengan perumusan masalah dan perlahan membangun intuisi di balik klasifikasi sentimen.
Satu poin krusial yang perlu Anda ingat saat mengerjakan analisis sentimen adalah tidak semua kata dalam sebuah frasa menyampaikan sentimen dari frasa tersebut. Kata-kata seperti "I", "Are", "Am", dll. tidak berkontribusi menyampaikan sentimen apa pun dan karenanya tidak relevan dalam konteks klasifikasi sentimen. Pertimbangkan masalah pemilihan fitur di sini. Dalam pemilihan fitur, Anda mencoba mencari fitur paling relevan yang paling berkaitan dengan label kelas. Gagasan yang sama berlaku di sini. Oleh karena itu, hanya segelintir kata dalam sebuah frasa yang berperan dan mengidentifikasi serta mengekstraknya dari frasa terbukti menjadi tugas yang menantang. Namun jangan khawatir, Anda akan membahasnya.
Pertimbangkan ulasan film berikut untuk memahaminya lebih baik:
"I love this movie! It's sweet, but with satirical humor. The dialogs are great and the adventure scenes are fun. It manages to be romantic and whimsical while laughing at the conventions of the fairy tale genre. I would recommend it to just about anyone. I have seen it several times and I'm always happy to see it again......."
Ya, ini jelas merupakan ulasan yang membawa sentimen positif terhadap film tertentu. Namun kata-kata spesifik apa yang mendefinisikan sifat positif ini?
Lihat lagi ulasan tersebut.
"I love this movie! It's sweet, but with satirical humor. The dialogs are great and the adventure scenes are fun. It manages to be romantic and whimsical while laughing at the conventions of the fairy tale genre. I would recommend it to just about anyone. I have seen it several times and I'm always happy to see it again......."
Anda pasti sudah mendapatkan gambaran yang jelas sekarang. Kata-kata yang dicetak tebal pada potongan teks di atas adalah kata-kata paling penting yang membentuk sifat positif dari sentimen yang disampaikan oleh teks.
Apa yang harus dilakukan dengan kata-kata ini? Langkah berikutnya yang terasa alami adalah membuat sebuah representasi seperti berikut:

Jadi apa yang dilakukan representasi di atas? Anda tentu sudah menebaknya. Setiap baris memuat sebuah kata dan frekuensi kemunculannya dalam dokumen (mari menyebutnya dokumen mulai sekarang). Anda juga mungkin bertanya-tanya love hanya muncul sekali tetapi mengapa frekuensinya 2? Nah, ini adalah bagian dari keseluruhan ulasan. Anggaplah representasi ini untuk seluruh ulasan.
Saat merumuskan pernyataan masalah tugas klasifikasi sentimen, Anda memahami representasi "Bag of words" dan representasi di atas tidak lain adalah representasi Bag-of-words. Ini mungkin konsep paling mendasar dalam NLP dan merupakan langkah pertama dalam mengerjakan masalah klasifikasi teks apa pun. Jadi, pastikan Anda memahaminya dengan baik.
Sebuah representasi bag-of-words dari sebuah dokumen tidak hanya memuat kata-kata tertentu tetapi semua kata yang unik dalam dokumen beserta frekuensi kemunculannya. Bag di sini adalah himpunan secara matematis, sehingga sesuai definisi himpunan, bag tidak memuat kata duplikat.
Namun untuk aplikasi ini, Anda hanya tertarik pada kata-kata yang dicetak tebal seperti disebutkan sebelumnya, jadi bag-of-words untuk dokumen ini hanya akan memuat kata-kata tersebut.
Dokumen tidak ditulis secara acak. Bukan begitu, kan? Urutan kata dalam sebuah dokumen itu penting. Namun dalam konteks klasifikasi sentimen, urutan ini tidak terlalu penting. Yang lebih penting, atau yang paling penting di sini, adalah keberadaan kata-kata tersebut.
Kata-kata yang Anda temukan dalam bag-of-words sekarang akan membentuk himpunan fitur dari dokumen Anda. Jadi, anggap Anda memiliki kumpulan banyak ulasan film (dokumen), dan Anda telah membuat representasi bag-of-words untuk masing-masing dan menyimpan labelnya (yaitu sentimen - +ve atau -ve dalam kasus ini). Himpunan latih Anda seharusnya tampak seperti:

Representasi ini juga dikenal sebagai Korpus.
Himpunan latih ini seharusnya mudah diinterpretasikan -
Semua baris adalah vektor fitur independen yang memuat informasi tentang sebuah dokumen spesifik (ulasan film), kata-kata tertentu, dan sentimennya. Perhatikan bahwa label sentiment sering dinyatakan sebagai (+, -) atau (+ve, -ve). Juga, fitur w1, w2, w3, 34, ..., wn dihasilkan dari sebuah bag of words, dan tidak wajib semua dokumen memuat masing-masing fitur/kata tersebut.
Anda akan meneruskan vektor-vektor fitur ini ke pengklasifikasi. Jadi, mari pelajari selanjutnya - model klasifikasi Naive Bayes untuk klasifikasi sentimen.
Klasifikasi Naive Bayes tidak lain adalah menerapkan aturan Bayes untuk membentuk probabilitas klasifikasi. Pada bagian ini, Anda mempelajari pengklasifikasi Naive Bayes dalam konteks klasifikasi sentimen. Sangat dianjurkan untuk mendapatkan pengantar tentang klasifikasi Naive Bayes dan aturan Bayes. Sumbernya sebagai berikut:
Lalu mengapa Naive Bayes di dunia yang punya k-NN, Decision Trees, dan banyak lainnya? Anda akan membahasnya nanti.
Mari terlebih dahulu membangun pengertian istilah umum pada pengklasifikasi Naive Bayes dalam konteks klasifikasi sentimen. Anda akan mulai dengan melihat aturan Bayes:

Dalam kasus ini, kelas terdiri dari dua sentimen: positif dan negatif.
Mari pelajari tiap istilah pada gambar di atas secara rinci dalam konteks ini.
Sekarang, apa itu Prior dan Likelihood? Juga, istilah P(d) (probabilitas sebuah dokumen); terdengar aneh? Pertanyaan yang bagus! Mari temukan jawabannya sekarang!
Belum ke detail yang paling halus! Namun tetaplah bersama. Anda akan menemukan lebih banyak informasi. Ingat, Anda masih membangun intuisi untuk mengaitkan aturan Bayes dalam konteks klasifikasi sentimen.
Mari masuk ke detail lebih jauh untuk mengetahui apa sebenarnya yang coba dilakukan aturan Bayes di sini. Gambar berikut menyajikan langkah-langkah aturan Bayes yang lebih rinci:

Banyak istilah yang belum dikenal di sini. Mari pelan-pelan.
Mulailah dengan suku sisi kanan cMAP. Ini menunjukkan tujuan utama aturan Bayes di sini, yaitu mencari probabilitas/estimasi posterior maksimum dari suatu dokumen yang termasuk ke kelas tertentu. MAP adalah singkatan dari Max A Posteriori yang merupakan terminologi Yunani.
Apa itu argmax? Anda bisa saja menggunakan max!
argmax menunjukkan indeksnya. Misalkan P(+|d) > P(-|d) di mana + dan - masing-masing menunjukkan sentimen positif dan negatif. Istilah P(+|d), P(-|d) mengembalikan probabilitas yang merupakan besaran numerik. Namun, Anda tidak tertarik pada probabilitasnya, Anda tertarik menemukan kelas untuk mana P(+|d) lebih besar, dan argmax mengembalikannya. Untuk P(+|d) > P(-|d), argmax akan mengembalikan +.Dan ya, Anda dapat mengabaikan suku penyebut P(d). Itu sepenuhnya bergantung pada implementasi.
Tetapi bagaimana saya menemukan $P(d|c)$ dan $P(c)$? Inilah tepatnya di mana bag of words akan sangat berguna. Tapi bagaimana?
Lanjutkan membaca!
Anda sudah tahu cara mengonversi dokumen tertentu ke representasi bag of words. Lebih penting lagi, Anda dapat merepresentasikan sebuah dokumen sebagai himpunan fitur dengan ini. Jadi sekarang, pada dasarnya suku cMAP dapat ditulis sebagai (mengabaikan penyebut P(d)):

Lalu, bagaimana Anda benar-benar menghitung probabilitasnya? Mari mulai dengan $P(c)$ terlebih dahulu.
P(c) pada dasarnya berkaitan dengan pertanyaan: "Seberapa sering kelas ini muncul?" Misalkan dataset dokumen Anda berisi 60% sentimen positif dan 40% sentimen negatif. Maka, $P(+) = 0.6$ dan $P(-) = 0.4$.
Sekarang, bagaimana Anda menafsirkan suku ini: P(x1, x2,...,xn | c)?
Pikirkan begini - berapa probabilitas kemunculan kata-kata (fitur) ini diberikan kelas c. Misalnya, anggap Anda memiliki 1000 dokumen, dan Anda hanya memiliki dua kata dalam korpus - "good" dan "awesome". Sekarang, dari 1000 dokumen ini, 500 dokumen berlabel positif, dan 500 sisanya berlabel negatif. Juga, Anda menemukan bahwa dari 500 dokumen berlabel positif, 200 dokumen memuat "good" dan "awesome" keduanya (catat P(x1,x2) berarti P(x1 dan x2)). Maka, probabilitas P(good,awesome | +) = 200 / 1000 = 1/5.
Satu poin penting yang perlu dicatat di sini adalah jika ukuran kosakata Anda $X$ maka Anda dapat merumuskan probabilitas likelihood Xn (seperti P(good,awesome | +)) selama dokumen Anda memuat n kata.
Ingat Anda harus menghitung probabilitas likelihood untuk kedua kelas di sini. Jadi, jumlah kombinasi total pada skenario di mana Anda memiliki 2000 total kata dan setiap dokumen memuat rata-rata 20 kata adalah (2000)20. Angka ini sangat besar! Dan bagaimana jika ukuran korpus jutaan (yang benar-benar terjadi dalam kasus praktis)?
Ini disebut Bayes Classifier. Namun ini tidak bekerja karena perhitungannya terlalu banyak. Sekarang, Anda akan mempelajari beberapa asumsi untuk menjadikan Bayes classifier sebagai pengklasifikasi Naive Bayes.
Asumsi-asumsi yang akan Anda pelajari disebut Naive Bayes Independence Assumptions. Sebagai berikut:
- Asumsi bag of words: Asumsikan posisi tidak penting. Asumsikan sebuah kata tertentu muncul pada posisi ke-10 dan ke-20, tetapi dengan asumsi ini, yang dimaksud adalah Anda hanya peduli pada frekuensi kemunculan kata tersebut yaitu 2. Angka 10 dan 12 tidak relevan di sini.
- Asumsi independensi bersyarat: Ini adalah asumsi krusial yang menjadikan Bayes classifier sebagai Naive Bayes. Asumsi ini menyatakan bahwa "anggap probabilitas fitur P(xi|cj)". Perhatikan pernyataannya. Artinya P(x1|cj), P(x2|cj) dan seterusnya saling independen. (Ini sama sekali tidak berarti bahwa P(x1), P(x2) dan seterusnya saling independen) Kini, suku P(x1, x2,...,xn | c) dapat dinyatakan sebagai berikut: 
Jadi, secara alami kombinasi Xn berkurang menjadi Xn yang secara eksponensial lebih kecil (jika ukuran kosakata Anda $X$ dan dokumen Anda memuat n kata). Didefinisikan secara matematis, Bayes classifier ketika direduksi menjadi Naive Bayes classifier tampak seperti:

Naive Bayes memiliki dua keunggulan:
Mekanisme klasifikasi Naive Bayes ketika diterapkan pada masalah klasifikasi teks disebut sebagai klasifikasi "Multinomial Naive Bayes".
Sekarang, Anda cukup cakap memahami mekanisme pengklasifikasi Naive Bayes khususnya untuk masalah klasifikasi sentimen. Kini saatnya Anda mengimplementasikan pengklasifikasi sentimen.
Anda akan melakukannya di Python! Mari mulai studi kasusnya.
Untuk studi kasus ini, Anda akan menggunakan korpus ulasan film offline seperti yang dibahas dalam buku NLTK dan dapat diunduh dari tautan ini. nltk menyediakan versi dataset tersebut. Dataset ini mengategorikan setiap ulasan sebagai positif atau negatif. Anda perlu mengunduhnya terlebih dahulu sebagai berikut:
python -m nltk.downloader all
Tidak direkomendasikan menjalankannya dari Jupyter Notebook. Cobalah menjalankannya dari command prompt (jika menggunakan Windows). Ini akan memakan waktu. Jadi, harap bersabar.
Untuk informasi lebih lanjut tentang dataset NLTK, pastikan Anda mengunjungi tautan ini.
Anda akan mengimplementasikan Naive Bayes atau katakanlah Multinomial Naive Bayes classifier menggunakan NLTK yang merupakan singkatan dari Natural Language Toolkit. Ini adalah pustaka yang didedikasikan untuk tugas terkait NLP dan NLU, dan dokumentasinya sangat baik. Pustaka ini mencakup banyak teknik dengan baik dan juga menyediakan dataset gratis untuk eksperimen.
Ini adalah situs resmi NLTK. Pastikan Anda memeriksanya karena memuat tutorial NLP yang ditulis dengan baik yang mencakup berbagai konsep NLP.
Setelah semua data diunduh, Anda akan mulai dengan mengimpor dataset ulasan film dengan from nltk.corpus import movie_reviews. Lalu, Anda akan menyusun sebuah daftar dokumen yang diberi label dengan kategori yang sesuai.
# Load and prepare the dataset
import nltk
from nltk.corpus import movie_reviews
import random

documents = [(list(movie_reviews.words(fileid)), category)
              for category in movie_reviews.categories()
              for fileid in movie_reviews.fileids(category)]

random.shuffle(documents)
Selanjutnya, Anda akan mendefinisikan ekstraktor fitur untuk dokumen, agar pengklasifikasi mengetahui aspek data mana yang harus diperhatikan. "Dalam kasus ini, Anda dapat mendefinisikan sebuah fitur untuk setiap kata, yang menunjukkan apakah dokumen memuat kata tersebut. Untuk membatasi jumlah fitur yang perlu diproses pengklasifikasi, Anda mulai dengan menyusun daftar 2000 kata yang paling sering muncul di seluruh korpus" Sumber. Anda kemudian dapat mendefinisikan ekstraktor fitur yang cukup memeriksa apakah masing-masing kata ini ada dalam sebuah dokumen tertentu.
# Define the feature extractor

all_words = nltk.FreqDist(w.lower() for w in movie_reviews.words())
word_features = list(all_words)[:2000]

def document_features(document):
    document_words = set(document)
    features = {}
    for word in word_features:
        features['contains({})'.format(word)] = (word in document_words)
    return features
"Alasan Anda menghitung himpunan semua kata dalam sebuah dokumen document_words = set(document), alih-alih hanya memeriksa apakah kata itu ada dalam dokumen, adalah karena memeriksa apakah sebuah kata muncul dalam himpunan jauh lebih cepat daripada memeriksa apakah kata itu muncul dalam daftar" - Sumber.
Anda telah mendefinisikan ekstraktor fitur. Sekarang, Anda dapat menggunakannya untuk melatih pengklasifikasi Naive Bayes guna memprediksi sentimen ulasan film baru. Untuk memeriksa kinerja pengklasifikasi, Anda akan menghitung akurasinya pada himpunan uji. NLTK menyediakan show_most_informative_features() untuk melihat fitur mana yang dianggap paling informatif oleh pengklasifikasi.
# Train Naive Bayes classifier
featuresets = [(document_features(d), c) for (d,c) in documents]
train_set, test_set = featuresets[100:], featuresets[:100]
classifier = nltk.NaiveBayesClassifier.train(train_set)
# Test the classifier
print(nltk.classify.accuracy(classifier, test_set))
0.71
Wah! Pengklasifikasi berhasil mencapai akurasi 71% tanpa bahkan menyetel parameter atau fine-tuning. Ini sangat bagus untuk percobaan pertama!
# Show the most important features as interpreted by Naive Bayes
classifier.show_most_informative_features(5)
Most Informative Features
       contains(winslet) = True              pos : neg    =      8.4 : 1.0
     contains(illogical) = True              neg : pos    =      7.6 : 1.0
      contains(captures) = True              pos : neg    =      7.0 : 1.0
        contains(turkey) = True              neg : pos    =      6.5 : 1.0
        contains(doubts) = True              pos : neg    =      5.8 : 1.0
"Dalam dataset, sebuah ulasan yang menyebut "Illogical" hampir 8 kali lebih mungkin negatif daripada positif, sementara sebuah ulasan yang menyebut "Captures" sekitar 6 kali lebih mungkin positif" - Sumber.
Sekarang pertanyaannya - mengapa Naive Bayes?
Keterbatasan utama Naive Bayes adalah asumsi prediktor yang independen. Dalam kehidupan nyata, hampir tidak mungkin Anda mendapatkan sekumpulan prediktor yang sepenuhnya independen.
Analisis sentimen menyelesaikan sejumlah masalah bisnis yang nyata:
Selamat! Anda telah sampai di akhir. NLP adalah topik yang sangat luas dan menarik serta menyelesaikan beberapa masalah yang menantang. Secara khusus, persinggungan NLP dan Deep Learning telah melahirkan beberapa produk yang fantastis. Ini benar-benar merevolusi cara chatbot berinteraksi. Daftarnya tak berujung.
Tutorial ini semoga memberi Anda awalan dalam salah satu sub-bidang utama NLP, yaitu Analisis Sentimen. Anda membahas salah satu topik paling fundamental dalam NLP - Bag of Words lalu mempelajari Naive Bayes Classifier secara mendetail. Anda juga meninjau kekurangannya. Anda menggunakan nltk, salah satu pustaka Python paling populer untuk tugas NLP dan NLU. Anda mengimplementasikan pengklasifikasi Naive Bayes sederhana dengan korpus film yang disediakan nltk. Beri diri Anda tepuk tangan. Anda pantas mendapatkannya!
Berikut beberapa tautan ke sumber daya hebat jika Anda ingin melangkah lebih jauh dari awal yang sederhana ini:
Referensi berikut digunakan untuk membuat tutorial ini:
Jika Anda tertarik mempelajari dasar-dasar NLP dan menerapkannya pada dataset dunia nyata, Anda dapat mengikuti kursus DataCamp "Natural Language Processing Fundamentals in Python".
Kursus Python
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



