Kurs
Feature Engineering für NLP in Python
4 Std.
29.6K
Die Verheißung von Machine Learning hat in vielen Bereichen beeindruckende Ergebnisse geliefert. Natural Language Processing ist da keine Ausnahme – im Gegenteil: Hier zeigt Machine Learning für komplexe Aufgaben teils erstaunliche Resultate, die an eine allgemeine künstliche Intelligenz erinnern (wenn auch nur teilweise).
NLP (Natural Language Processing) ist ebenso wenig neu wie Machine Learning. Die Verbindung beider Felder ist jedoch vergleichsweise jung – und macht rasant Fortschritte. Es ist eine dieser hybriden Anwendungen, mit denen wirklich jede und jeder (mit einem halbwegs aktuellen Smartphone) täglich in Berührung kommt. Denk nur an „Wortvorschläge“ auf der Tastatur oder intelligente Autovervollständigung. All das sind Nebenprodukte der Verschmelzung von NLP und Machine Learning – und längst fester Bestandteil unseres Alltags.
Sentiment-Analyse ist ein Kernthema im NLP. Sie zählt zu den heißesten Themen, weil sie für Unternehmen extrem relevant ist und viele Praxisprobleme löst. In diesem Tutorial schauen wir uns dieses nicht ganz einfache Thema auf einfache Weise an. Wir zerlegen die nötige Mathematik in kleine Happen und bauen am Ende einen einfachen Sentiment-Classifier. Im Detail behandeln wir:
Los geht’s.
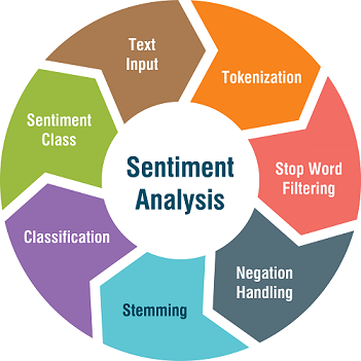
Im Kern gehören Sentiment-Analyse bzw. -Klassifikation zur Familie der Textklassifikationsaufgaben: Du bekommst eine Phrase oder eine Liste von Phrasen und dein Classifier soll entscheiden, ob die dahinterliegende Stimmung positiv, negativ oder neutral ist. Manchmal wird auf die neutrale Klasse verzichtet, um ein binäres Problem zu erhalten. In aktuellen Aufgabenstellungen tauchen auch Stufen wie „eher positiv“ oder „eher negativ“ auf. Schauen wir uns ein Beispiel an.
Betrachte die folgenden Phrasen:
Die Phrasen sind kurze Filmkritiken und transportieren unterschiedliche Stimmungen. Die erste steht klar für eine positive Haltung zum Film, die zweite für eine negative. In der dritten findest du keine Wörter, die eine eindeutige Stimmung verraten – sie ist neutral.
Aus strenger Machine-Learning-Perspektive ist das eine überwachte Lernaufgabe. Du gibst dem Modell viele Phrasen mit ihren Labels (den jeweiligen Stimmungen) und testest es anschließend auf unlabeled Phrasen.
Für die Einführung reicht das. Um selbst einen Sentiment-Classifier zu bauen, brauchst du mehr. Weiter geht’s.
 Quelle: SlideShare
Bevor wir das Problemstatement für Sentiment-Klassifikation definieren, lohnt ein Blick auf Textklassifikation allgemein. Formal lässt sich eine allgemeine Textklassifikationsaufgabe so beschreiben:
Der Begriff Dokument ist hier dehnbar. In der Textklassifikation meint „Dokument“ Tweets, Phrasen, Ausschnitte aus Artikeln, ganze Artikel, Produktanleitungen, Geschichten usw. Der Grund ist der Begriff Wort als kleinstes Element. Für längere Wortfolgen spricht man daher allgemein von einem Dokument. Ein Tweet ist also ein kurzes Dokument, ein Artikel ein langes.
Ein Trainingsset aus n gelabelten Dokumenten sieht dann so aus: (d1,c1), (d2,c2),...,(dn,cn). Ziel ist ein gelerntes Klassifikationsmodell.
Soweit so gut. Aber wo sind die Merkmale der Dokumente? Gute Frage! Dazu gleich mehr.
Gehen wir weiter in der Problemformulierung und bauen Schritt für Schritt die Intuition hinter Sentiment-Klassifikation auf.
Wichtig: Nicht alle Wörter in einer Phrase tragen zur Stimmung bei. Wörter wie „Ich“, „Sind“, „Bin“ usw. transportieren keine Sentiments und sind in diesem Kontext irrelevant. Stichwort Feature Selection: Dabei suchst du die Merkmale, die am stärksten mit dem Klassenlabel zusammenhängen. Genau das machen wir hier auch. Nur ein Teil der Wörter ist wirklich relevant – sie zu identifizieren und aus den Phrasen zu extrahieren, ist die Herausforderung. Aber keine Sorge, wir kommen dazu.
Betrachte diese Filmkritik:
„Ich liebe diesen Film! Er ist süß, aber mit satirischem Humor. Die Dialoge sind großartig und die Abenteuerszenen machen Spaß. Er ist romantisch und verspielt und nimmt gleichzeitig das Märchen-Genre aufs Korn. Ich würde ihn empfehlen – fast jedem. Ich habe ihn mehrfach gesehen und freue mich immer wieder darauf.......“
Klar: Das ist eine positive Kritik. Doch welche Wörter transportieren dieses Positive?
Schau noch einmal hin.
„Ich liebe diesen Film! Er ist süß, aber mit satirischem Humor. Die Dialoge sind großartig und die Abenteuerszenen machen Spaß. Er ist romantisch und verspielt ... Ich würde ihn empfehlen ... ich bin immer glücklich, ihn wieder zu sehen.......“
Jetzt ist es offensichtlich: Die fett markierten Wörter prägen die positive Stimmung.
Was tun wir mit diesen Wörtern? Naheliegend ist eine Darstellung wie diese:

Was passiert hier? Genau: Jede Zeile enthält ein Wort und seine Häufigkeit im Dokument (nennen wir es ab jetzt Dokument). Du fragst dich, warum „liebe“ nur einmal vorkommt, aber die Frequenz 2 ist? Der Ausschnitt stammt nur aus einem Teil der Kritik – die Tabelle bezieht sich auf die gesamte Rezension.
Damit sind wir bei der „Bag-of-Words“-Darstellung. Sie ist eines der grundlegendsten Konzepte im NLP und meist der erste Schritt in Textklassifikationsprojekten. Verstehe sie gut.
Eine Bag-of-Words-Darstellung eines Dokuments enthält nicht nur bestimmte Wörter, sondern alle einzigartigen Wörter des Dokuments sowie ihre Häufigkeiten. „Bag“ steht hier für eine mathematische Menge – Duplikate gibt es also nicht.
Für unsere Anwendung interessieren uns nur die oben hervorgehobenen Wörter, daher enthält das Bag of Words hier nur diese.
Dokumente sind nicht wirr geschrieben. Die Wortreihenfolge ist grundsätzlich wichtig. Für die Sentiment-Klassifikation ist sie jedoch oft zweitrangig. Entscheidend ist in erster Linie, ob bestimmte Wörter vorkommen.
Die im Bag of Words gefundenen Wörter bilden jetzt den Featuresatz deines Dokuments. Angenommen, du hast viele Rezensionen (Dokumente) gesammelt, für jede ein Bag-of-Words erzeugt und das jeweilige Label (Sentiment: + oder –) behalten. Dein Trainingsset sieht dann so aus:

Diese Sammlung wird auch als Korpus bezeichnet.
Das Trainingsset ist leicht zu lesen –
Jede Zeile ist ein unabhängiger Feature-Vektor zu einem Dokument (Filmkritik) mit den jeweiligen Wörtern und dem Sentiment. Das Label Sentiment wird oft als (+, −) oder (+ve, −ve) geschrieben. Außerdem stammen die Features w1, w2, w3, …, wn aus einem Bag of Words; nicht jedes Dokument enthält alle Features/Wörter.
Diese Feature-Vektoren gibst du an den Classifier. Schauen wir uns als Nächstes das Naive-Bayes-Modell für Sentiment-Klassifikation an.
Naive Bayes nutzt die Bayes-Regel, um Klassifikationswahrscheinlichkeiten zu berechnen. In diesem Abschnitt betrachten wir den Naive-Bayes-Classifier im Kontext der Sentiment-Klassifikation. Es empfiehlt sich, die Bayes-Regel und Naive Bayes kurz aufzufrischen. Nützliche Ressourcen:
Warum Naive Bayes und nicht k-NN, Entscheidungsbäume oder andere? Dazu gleich mehr.
Erst definieren wir die Begriffe aus der Bayes-Regel im Kontext der Sentiment-Klassifikation. Beginnen wir mit der Bayes-Regel:

In unserem Fall gibt es zwei Klassen: positiv und negativ.
Schauen wir uns die Terme im Detail an.
Was sind Prior und Likelihood? Und P(d) – die Wahrscheinlichkeit eines Dokuments? Gute Fragen! Hier die Antworten:
Noch sind wir nicht in allen Details. Bleib dran – die Intuition im Kontext Sentiment wird gleich klarer.
Die folgende Darstellung zeigt die Schritte der Bayes-Regel ausführlicher:

Viele neue Symbole – gehen wir es langsam an.
Beginnen wir mit cMAP. Das steht für das Ziel der Bayes-Regel: die Klasse mit der maximalen a-posteriori-Wahrscheinlichkeit für ein Dokument zu finden. MAP bedeutet Max A Posteriori.
Was ist argmax? Warum nicht einfach max?
argmax liefert den Index bzw. die Klasse. Angenommen P(+|d) > P(-|d). Die Werte sind Zahlen, aber uns interessiert die Klasse, nicht der Zahlenwert. argmax liefert also das +.Den Nenner P(d) kannst du oft weglassen – je nach Implementierung.
Wie berechne ich $P(d|c)$ und $P(c)$? Genau hier hilft das Bag of Words. Wie?
Weiterlesen!
Du weißt, wie du ein Dokument in ein Bag of Words überführst – also in einen Featuresatz. Damit lässt sich cMAP (ohne Nenner P(d)) so schreiben:

Beginnen wir mit $P(c)$.
P(c) fragt: „Wie häufig tritt diese Klasse auf?“ Enthält dein Datensatz z. B. 60% positive und 40% negative Dokumente, dann ist $P(+) = 0{,}6$ und $P(-) = 0{,}4$.
Wie interpretierst du P(x1, x2, ..., xn | c)?
Frag dich: Wie wahrscheinlich ist es, dass diese Wörter (Features) gemeinsam auftreten, gegeben die Klasse c? Beispiel: Du hast 1000 Dokumente und im Korpus nur zwei Wörter – „good“ und „awesome“. 500 Dokumente sind positiv, 500 negativ. In 200 der 500 positiven Dokumente kommen „good“ und „awesome“ gemeinsam vor (P(x1,x2) meint P(x1 und x2)). Dann ist P(good,awesome | +) = 200 / 1000 = 1/5.
Wichtiger Punkt: Hat dein Vokabular die Größe $X$, kannst du bei Dokumenten mit n Wörtern Xn Likelihood-Kombinationen formulieren (z. B. P(good,awesome | +)).
Du musst die Likelihoods für beide Klassen berechnen. Bei 2000 Wörtern im Vokabular und durchschnittlich 20 Wörtern pro Dokument wären es (2000)20 Kombinationen – astronomisch groß! In realen Korpora geht das in die Millionen.
Das ist der Bayes-Classifier. So ist er nicht praktikabel – zu viele Rechnungen. Jetzt kommen die Annahmen, die daraus den Naive-Bayes-Classifier machen.
Die folgenden Annahmen heißen Naive-Bayes-Unabhängigkeitsannahmen:
- Bag-of-Words-Annahme: Die Position eines Wortes ist egal. Ob ein Wort an 10. oder 20. Stelle steht, spielt keine Rolle – relevant ist nur, dass es 2-mal vorkommt.
- Bedingte Unabhängigkeit: Die entscheidende Annahme, die Bayes zu Naive Bayes macht. „Nimm an, die Feature-Wahrscheinlichkeiten P(xi|cj) sind unabhängig.“ Konkret: P(x1|cj), P(x2|cj) usw. sind paarweise unabhängig voneinander. (Nicht zu verwechseln mit der Unabhängigkeit von P(x1), P(x2) ohne Bedingung.) Dann lässt sich P(x1, x2,...,xn | c) schreiben als: 
Damit schrumpfen Xn Kombinationen zu X·n Operationen – also exponentiell weniger (bei Vokabulargröße $X$ und n Wörtern je Dokument). Mathematisch reduziert sieht der Bayes-Classifier als Naive Bayes so aus:

Naive Bayes bietet zwei Vorteile:
Wird Naive Bayes auf Textklassifikation angewandt, spricht man meist von „Multinomial Naive Bayes“.
Jetzt kennst du die Mechanik des Naive-Bayes-Classifiers für Sentiment-Aufgaben. Zeit für die Umsetzung.
Wir machen das in Python! Starten wir mit der Fallstudie.
Für diese Fallstudie nutzen wir ein Offline-Korpus mit Filmrezensionen aus dem NLTK-Book, das du hier herunterladen kannst. nltk stellt eine Version des Datensatzes bereit. Jede Rezension ist als positiv oder negativ gekennzeichnet. Lade die Daten zunächst so herunter:
python -m nltk.downloader all
Das solltest du nicht in Jupyter Notebook ausführen. Starte den Befehl lieber im Terminal bzw. in der Eingabeaufforderung (unter Windows). Der Download dauert etwas – hab Geduld.
Mehr Infos zu NLTK-Datasets findest du unter diesem Link.
Wir implementieren Naive Bayes bzw. Multinomial Naive Bayes mit NLTK (Natural Language Toolkit). Die Bibliothek ist auf NLP- und NLU-Aufgaben spezialisiert, sehr gut dokumentiert und bringt viele Techniken sowie frei verfügbare Datensätze für Experimente mit.
Hier ist die offizielle NLTK-Website – mit vielen gut geschriebenen NLP-Tutorials.
Nach dem Download importieren wir das Movie-Reviews-Korpus mit from nltk.corpus import movie_reviews und bauen anschließend eine Liste von Dokumenten mit ihren Labels.
# Load and prepare the dataset
import nltk
from nltk.corpus import movie_reviews
import random

documents = [(list(movie_reviews.words(fileid)), category)
              for category in movie_reviews.categories()
              for fileid in movie_reviews.fileids(category)]

random.shuffle(documents)
Als Nächstes definieren wir einen Feature-Extractor, damit der Classifier weiß, worauf er achten soll. „In diesem Fall definieren wir für jedes Wort ein Feature, das anzeigt, ob das Dokument dieses Wort enthält. Um die Anzahl der Features zu begrenzen, erstellen wir zunächst eine Liste der 2000 häufigsten Wörter im gesamten Korpus“ Quelle. Dann definieren wir einen Feature-Extractor, der prüft, ob diese Wörter im jeweiligen Dokument vorkommen.
# Define the feature extractor

all_words = nltk.FreqDist(w.lower() for w in movie_reviews.words())
word_features = list(all_words)[:2000]

def document_features(document):
    document_words = set(document)
    features = {}
    for word in word_features:
        features['contains({})'.format(word)] = (word in document_words)
    return features
„Warum document_words = set(document)? Weil das Prüfen, ob sich ein Wort in einem Set befindet, deutlich schneller ist als die Suche in einer Liste.“ – Quelle.
Mit dem Feature-Extractor können wir nun einen Naive-Bayes-Classifier trainieren, der die Stimmung neuer Rezensionen vorhersagt. Zur Bewertung messen wir die Accuracy auf dem Testset. NLTK bietet show_most_informative_features(), um die aussagekräftigsten Features anzuzeigen.
# Train Naive Bayes classifier
featuresets = [(document_features(d), c) for (d,c) in documents]
train_set, test_set = featuresets[100:], featuresets[:100]
classifier = nltk.NaiveBayesClassifier.train(train_set)
# Test the classifier
print(nltk.classify.accuracy(classifier, test_set))
0.71
Stark! Ohne Feintuning erreicht der Classifier direkt 71% Genauigkeit. Für den ersten Wurf ist das richtig gut.
# Show the most important features as interpreted by Naive Bayes
classifier.show_most_informative_features(5)
Most Informative Features
       contains(winslet) = True              pos : neg    =      8.4 : 1.0
     contains(illogical) = True              neg : pos    =      7.6 : 1.0
      contains(captures) = True              pos : neg    =      7.0 : 1.0
        contains(turkey) = True              neg : pos    =      6.5 : 1.0
        contains(doubts) = True              pos : neg    =      5.8 : 1.0
„In diesem Datensatz ist eine Rezension, die „Illogical“ erwähnt, fast achtmal so wahrscheinlich negativ wie positiv; bei „Captures“ ist sie rund sechsmal so wahrscheinlich positiv.“ – Quelle.
Warum also Naive Bayes?
Die Hauptlimitation ist die Annahme unabhängiger Prädiktoren. In der Realität sind Features selten vollständig unabhängig.
Sentiment-Analyse löst echte Business-Probleme:
Glückwunsch! Du bist bis zum Ende dabei geblieben. NLP ist ein riesiges, spannendes Feld und löst herausfordernde Probleme. Besonders die Schnittstelle von NLP und Deep Learning hat fantastische Produkte hervorgebracht – etwa moderne Chatbots. Die Liste ist lang.
Dieses Tutorial sollte dir einen soliden Einstieg in ein zentrales Teilgebiet des NLP geben: die Sentiment-Analyse. Wir haben das grundlegende Konzept Bag of Words behandelt und anschließend den Naive-Bayes-Classifier im Detail durchgegangen – inklusive seiner Schwächen. Mit nltk, einer der beliebtesten Python-Bibliotheken für NLP und NLU, hast du einen einfachen Naive-Bayes-Classifier auf dem mitgelieferten Movie-Korpus gebaut. Applaus an dich – verdient!
Wenn du weitermachen willst, findest du hier großartige Ressourcen:
Diese Referenzen wurden für das Tutorial genutzt:
Wenn du die NLP-Grundlagen lernen und auf reale Datensätze anwenden willst, schau dir den DataCamp-Kurs „Natural Language Processing Fundamentals in Python“ an.
Python-Kurse
Kurs
Kurs
Kurs