Cours
Feature Engineering pour le NLP en Python
4 h
29.7K
Les promesses de l’apprentissage automatique ont donné des résultats impressionnants dans de nombreux domaines. Le traitement automatique du langage naturel ne fait pas exception : c’est l’un des champs où l’apprentissage automatique a su montrer des signes d’intelligence artificielle générale (pas totalement, mais au moins en partie), avec de superbes résultats sur des tâches réellement complexes.
Ni le TAL (traitement automatique du langage) ni l’apprentissage automatique ne sont nouveaux. Mais leur fusion est relativement récente et promet de belles avancées. C’est une application hybride que tout le monde (dès qu’on possède un smartphone) croise quotidiennement : par exemple, la « suggestion de mots au clavier » ou l’auto-complétion intelligente. Ce sont des sous-produits de l’alliance du TAL et du Machine Learning, et ils sont naturellement devenus indissociables de notre quotidien.
L’analyse de sentiments est un sujet central en TAL. Elle est rapidement devenue l’un des thèmes les plus en vue, tant pour sa pertinence que pour le nombre de problèmes métier qu’elle aide à résoudre. Dans ce tutoriel, vous allez aborder ce sujet pas si simple de manière simple. Vous allez décortiquer les quelques briques mathématiques utiles et les étudier. Vous construirez aussi un classificateur de sentiments simple à la fin. Concrètement, vous verrez :
Allons-y.
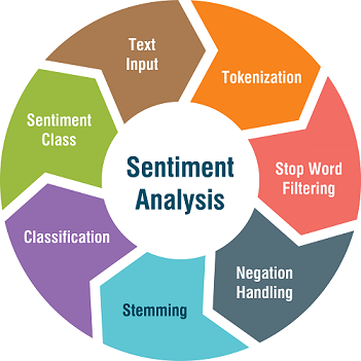
Essentiellement, l’analyse (ou la classification) de sentiments appartient à la grande famille des tâches de classification de texte : on vous fournit une phrase (ou une liste de phrases) et votre classificateur doit indiquer si le sentiment exprimé est positif, négatif ou neutre. Parfois, on écarte la classe neutre pour en faire un problème binaire. Plus récemment, des nuances comme « plutôt positif » et « plutôt négatif » sont aussi prises en compte. Illustrons par un exemple.
Considérez les phrases suivantes :
Ces phrases correspondent à de courts avis et chacune transmet un sentiment différent. La première exprime un avis positif sur le film Titanic, la seconde un avis négatif. Regardez de plus près la troisième : aucun mot n’y renseigne sur un sentiment particulier. C’est donc un exemple de sentiment neutre.
D’un point de vue strictement apprentissage automatique, c’est une tâche d’apprentissage supervisé. Vous fournissez au modèle un ensemble de phrases annotées (avec leurs sentiments) et vous testez le modèle sur des phrases non annotées.
Pour une introduction, cela suffit. Mais pour construire un modèle de classification de sentiments, il faut aller plus loin. Continuons.
 Source : SlideShare
Avant de détailler le problème pour la classification de sentiments, clarifions le cadre général de la classification de textes. Définissons-le formellement.
Ici, le terme document est à interpréter largement dans le monde de la classification de textes : il peut s’agir de tweets, de phrases, d’extraits d’articles, d’articles entiers, d’un manuel produit, d’un récit, etc. Le mot est l’entité atomique et petite ; pour désigner de longues séquences de mots, on utilise donc « document ». Un tweet est un document court, un article un document long.
Un ensemble d’apprentissage de n documents annotés s’écrit : (d1, c1), (d2, c2), …, (dn, cn). La sortie recherchée est un classificateur entraîné.
Vous vous en sortez bien ! Une question vous vient sans doute : où sont les variables explicatives (features) des documents ? Excellente question ! Nous y venons.
Poursuivons la formulation du problème pour construire l’intuition derrière la classification de sentiments.
Point crucial : toutes les mots d’une phrase ne portent pas le sentiment. Des mots comme « je », « suis », « est », etc. ne contribuent pas à exprimer un sentiment et sont donc peu pertinents ici. Pensez à la sélection de variables : on cherche les caractéristiques les plus liées à l’étiquette de classe. Même logique ici. Seule une poignée de mots y participent, et les identifier puis les extraire est un vrai défi. Mais ne vous inquiétez pas, on y arrive.
Considérez l’avis suivant pour mieux comprendre :
« J’adore ce film ! Il est charmant, avec un humour satirique. Les dialogues sont excellents et les scènes d’aventure sont amusantes. Il parvient à être romantique et fantaisiste tout en se moquant des codes du conte de fées. Je le recommande à presque tout le monde. Je l’ai vu plusieurs fois et je suis toujours heureux de le revoir encore… »
Oui, c’est sans conteste un avis positif. Mais quels sont les mots qui traduisent précisément cette positivité ?
Relisez l’avis.
« J’adore ce film ! Il est charmant, avec un humour satirique. Les dialogues sont excellents et les scènes d’aventure sont amusantes. Il parvient à être romantique et fantaisiste… Je le recommande… je suis toujours heureux de le voir encore… »
Vous voyez l’idée : les mots en gras structurent la tonalité positive du texte.
Que faire de ces mots ? L’étape suivante naturelle est de créer une représentation du type :

Que fait cette représentation ? Vous l’avez deviné : chaque ligne contient un mot et sa fréquence d’apparition dans le document (appelons-le « document » désormais). Vous vous demandez peut-être pourquoi « adore » n’apparaît qu’une fois mais a une fréquence de 2 ? Il s’agit ici d’un extrait ; imaginez que le tableau porte sur l’avis complet.
En formulant le problème, vous venez d’introduire la représentation en « sac de mots » (bag-of-words). C’est l’un des concepts les plus fondamentaux en TAL, et souvent la première étape de tout problème de classification de texte. Assurez-vous de bien le maîtriser.
Une représentation en bag-of-words d’un document contient tous les mots uniques du document et leur fréquence d’apparition. Ici, « sac » renvoie à un ensemble mathématique : par définition, il n’y a pas de doublons.
Pour notre application, seuls les mots saillants identifiés plus haut nous intéressent : le sac de mots du document ne retiendra donc que ceux-là.
Un document n’est pas un assemblage de mots désordonnés, la séquence a du sens. Mais dans le contexte de la classification des sentiments, l’ordre compte moins que la présence de ces mots.
Les mots retenus dans le sac de mots constituent alors l’ensemble de variables du document. Imaginez une collection d’avis de films (documents) : vous construisez un sac de mots pour chacun et conservez leurs étiquettes (sentiments : + ou – ici). Votre ensemble d’apprentissage ressemble à :

On appelle aussi cette représentation un corpus.
Cet ensemble d’apprentissage est facile à lire :
Chaque ligne est un vecteur de caractéristiques indépendant décrivant un document (avis de film), ses mots particuliers et son sentiment. Notez que le label sentiment est souvent noté (+, –) ou (+ve, –ve). Les variables w1, w2, w3, …, wn proviennent du sac de mots ; tous les documents ne contiennent pas nécessairement toutes ces variables.
Vous allez transmettre ces vecteurs au classificateur. Étudions donc le modèle : la classification Naïve Bayes pour l’analyse de sentiments.
La classification Naïve Bayes consiste à appliquer la règle de Bayes pour former des probabilités de classe. Dans cette section, vous voyez le classificateur Naïve Bayes dans le contexte de la classification de sentiments. Il est vivement recommandé d’avoir une introduction à Naïve Bayes et à la règle de Bayes. Quelques ressources :
Mais pourquoi Naïve Bayes dans un monde avec k-NN, arbres de décision et tant d’autres ? Réponse un peu plus loin.
Construisons d’abord les notions générales du Naïve Bayes dans ce contexte. Commençons par la règle de Bayes :

Dans notre cas, la classe comprend deux sentiments : positif et négatif.
Examinons chaque terme dans ce cadre.
Qu’appelle-t-on alors Prior et Vraisemblance ? Et P(d) (probabilité d’un document) ? Intrigant, non ? Voyons cela.
Rien d’extravagant jusque-là ! Restez avec nous : on affine l’intuition reliant Bayes et la classification de sentiments.
Approfondissons ce que la règle de Bayes cherche à faire ici. L’image suivante détaille les étapes :

Beaucoup de symboles : allons-y pas à pas.
Commençons par cMAP. C’est l’objectif de Bayes ici : trouver l’estimation du posterior maximale pour qu’un document appartienne à une classe donnée. MAP signifie Max A Posteriori.
Et argmax ? Pourquoi pas un simple max ?
argmax renvoie l’index/la classe qui maximise la valeur. Supposons P(+|d) > P(-|d), où + et – désignent les sentiments positif et négatif. Ces termes sont des probabilités (des nombres). Vous n’êtes pas intéressé par la valeur elle-même mais par la classe gagnante : argmax renverra +.Et oui, on peut ignorer le dénominateur P(d). Cela dépend de l’implémentation.
Mais comment calculer P(d|c) et P(c) ? C’est précisément là que le bag of words devient utile. Comment ?
Lisez la suite !
Vous savez convertir un document en sac de mots, et donc en un ensemble de variables. Dès lors, cMAP peut s’écrire (en ignorant P(d)) :

Comment calcule-t-on ces probabilités ? Commençons par P(c).
P(c) répond à : « À quelle fréquence cette classe apparaît-elle ? » Si 60 % des documents sont positifs et 40 % négatifs, alors P(+) = 0,6 et P(-) = 0,4.
Comment interpréter P(x1, x2, …, xn | c) ?
Pensez-y ainsi : quelle est la probabilité d’apparition conjointe de ces mots (variables) sachant la classe c ? Par exemple, vous avez 1000 documents et un corpus avec seulement deux mots : « good » et « awesome ». Sur 1000 documents, 500 sont positifs, 500 négatifs. Parmi les 500 positifs, 200 contiennent à la fois « good » et « awesome » (P(x1, x2) signifie P(x1 et x2)). Alors P(good, awesome | +) = 200 / 1000 = 1/5.
Important : si votre vocabulaire a une taille X, vous pouvez formuler Xn probabilités de vraisemblance (comme P(good, awesome | +)) pour un document de n mots.
Il faut calculer ces vraisemblances pour chaque classe. Avec 2000 mots et 20 mots par document en moyenne, cela fait (2000)20 combinaisons. C’est colossal ! Et si le corpus est de plusieurs millions (ce qui arrive en pratique) ?
C’est le classificateur bayésien général. Mais il est inapplicable tel quel, car trop coûteux. Voyons les hypothèses qui le rendent Naïf.
Voici les hypothèses d’indépendance Naïve Bayes :
- Hypothèse « sac de mots » : la position n’importe pas. Si un mot apparaît aux 10e et 20e positions, on ne retient que sa fréquence (2). Les positions 10 et 20 sont hors sujet.
- Hypothèse d’indépendance conditionnelle : hypothèse clé qui rend Bayes « naïf ». Elle stipule que l’on suppose les probabilités des variables conditionnellement à la classe indépendantes : P(xi|cj). Autrement dit, P(x1|cj), P(x2|cj), etc., sont indépendantes entre elles (cela ne signifie pas que P(x1), P(x2), etc., le sont). Ainsi, P(x1, x2, …, xn | c) s’exprime : 
Naturellement, on passe de Xn combinaisons à Xn, ce qui est exponentiellement plus petit (si X est la taille du vocabulaire et n le nombre de mots du document). Formellement, le classificateur bayésien réduit au Naïve Bayes devient :

Deux atouts majeurs de Naïve Bayes :
Appliqué à la classification de textes, on parle de « Naïve Bayes multinomial ».
Vous comprenez désormais la mécanique de Naïve Bayes pour la classification de sentiments. Il est temps de passer à la pratique.
Et ce sera en Python ! Place à l’étude de cas.
Pour cette étude de cas, vous utiliserez un corpus hors ligne d’avis de films présenté dans le livre NLTK et téléchargeable ici. nltk fournit une version du jeu de données, qui étiquette chaque avis en positif ou négatif. Commencez par tout télécharger ainsi :
python -m nltk.downloader all
Il n’est pas recommandé d’exécuter cette commande depuis Jupyter Notebook. Lancez-la plutôt depuis l’invite de commande (sous Windows). Le téléchargement peut prendre du temps : soyez patient.
Pour en savoir plus sur les jeux de données NLTK, consultez ce lien.
Vous allez implémenter Naïve Bayes (ou plutôt sa variante multinomiale) avec NLTK, le Natural Language Toolkit. Cette bibliothèque dédiée au TAL/TLU dispose d’une excellente documentation, couvre de nombreuses techniques et fournit des jeux de données pour l’expérimentation.
Voici le site officiel de NLTK. Jetez-y un œil : il propose d’excellents tutoriels couvrant divers concepts de TAL.
Une fois les données téléchargées, importez le corpus d’avis avec from nltk.corpus import movie_reviews. Puis, construisez une liste de documents étiquetés avec leurs catégories.
# Load and prepare the dataset
import nltk
from nltk.corpus import movie_reviews
import random

documents = [(list(movie_reviews.words(fileid)), category)
              for category in movie_reviews.categories()
              for fileid in movie_reviews.fileids(category)]

random.shuffle(documents)
Définissez ensuite un extracteur de caractéristiques, afin que le classificateur sache à quelles informations prêter attention. « Ici, vous pouvez définir une caractéristique pour chaque mot, indiquant si le document contient ce mot. Pour limiter le nombre de caractéristiques à traiter, commencez par construire la liste des 2000 mots les plus fréquents du corpus » Source. Vous pouvez alors définir un extracteur qui vérifie simplement la présence de chacun de ces mots dans un document donné.
# Define the feature extractor

all_words = nltk.FreqDist(w.lower() for w in movie_reviews.words())
word_features = list(all_words)[:2000]

def document_features(document):
    document_words = set(document)
    features = {}
    for word in word_features:
        features['contains({})'.format(word)] = (word in document_words)
    return features
« La raison pour laquelle vous calculez l’ensemble des mots du document (document_words = set(document)) plutôt que de vérifier la présence dans une liste, est qu’une recherche dans un ensemble est bien plus rapide que dans une liste » – Source.
Votre extracteur est prêt. Vous pouvez l’utiliser pour entraîner un classificateur Naïve Bayes et prédire le sentiment de nouveaux avis. Pour évaluer ses performances, calculez sa précision sur un jeu de test. NLTK fournit show_most_informative_features() pour lister les variables les plus informatives.
# Train Naive Bayes classifier
featuresets = [(document_features(d), c) for (d,c) in documents]
train_set, test_set = featuresets[100:], featuresets[:100]
classifier = nltk.NaiveBayesClassifier.train(train_set)
# Test the classifier
print(nltk.classify.accuracy(classifier, test_set))
0.71
Super ! Sans aucun réglage fin, le classificateur atteint déjà 71 % de précision. Excellent pour un premier essai !
# Show the most important features as interpreted by Naive Bayes
classifier.show_most_informative_features(5)
Most Informative Features
       contains(winslet) = True              pos : neg    =      8.4 : 1.0
     contains(illogical) = True              neg : pos    =      7.6 : 1.0
      contains(captures) = True              pos : neg    =      7.0 : 1.0
        contains(turkey) = True              neg : pos    =      6.5 : 1.0
        contains(doubts) = True              pos : neg    =      5.8 : 1.0
« Dans ce jeu de données, un avis contenant « Illogical » a presque 8 fois plus de chances d’être négatif que positif, tandis qu’un avis contenant « Captures » a environ 6 fois plus de chances d’être positif » – Source.
Pourquoi choisir Naïve Bayes ?
Sa principale faiblesse est l’hypothèse d’indépendance des prédicteurs. En pratique, il est rare de disposer de variables entièrement indépendantes.
L’analyse de sentiments résout de nombreux problèmes métier concrets :
Félicitations ! Vous êtes allé jusqu’au bout. Le TAL est un domaine vaste et passionnant qui s’attaque à des problèmes difficiles. L’interface entre TAL et Deep Learning a donné naissance à des produits remarquables et a transformé la manière dont les chatbots interagissent. La liste est longue.
Ce tutoriel vous a, espérons-le, donné un bon départ sur une sous-discipline phare du TAL : l’analyse de sentiments. Vous avez couvert un concept fondamental – le Bag of Words – puis étudié en détail le classificateur Naïve Bayes et ses limites. Vous avez utilisé nltk, l’une des bibliothèques Python les plus populaires pour le TAL/TLU, et implémenté un Naïve Bayes simple sur le corpus de films fourni. Bravo !
Voici quelques ressources de qualité pour aller plus loin :
Références utilisées pour ce tutoriel :
Si vous souhaitez apprendre les bases du TAL et les appliquer à des jeux de données réels, suivez le cours de DataCamp « Natural Language Processing Fundamentals in Python ».
Cours Python
Cours
Cours
Cours