Corso
Feature Engineering per NLP in Python
4 ore
29.8K
La promessa del machine learning ha prodotto risultati sorprendenti in una vasta gamma di campi. L’elaborazione del linguaggio naturale non fa eccezione, ed è uno di quei settori in cui il machine learning è riuscito a mostrare un barlume di intelligenza artificiale generale (non del tutto, ma almeno in parte), raggiungendo risultati brillanti per compiti davvero complessi.
NLP (natural language processing) non è un campo nuovo, e non lo è nemmeno il machine learning. Ma la fusione di entrambi è piuttosto recente e promette ulteriori progressi. È una di quelle applicazioni ibride con cui tutti (con uno smartphone economico) hanno a che fare ogni giorno. Per esempio, pensa ai "suggerimenti di parole della tastiera", o agli auto-completamenti intelligenti: sono tutti sottoprodotti dell’unione tra NLP e Machine Learning e, com’è naturale, sono diventati parti inseparabili della nostra vita.
L’analisi del sentiment è un tema fondamentale nell’ambito dell’NLP. È diventata rapidamente uno degli argomenti più caldi per la sua rilevanza e per la quantità di problemi di business che sta riuscendo a risolvere. In questo tutorial affronterai questo argomento non così semplice in modo semplice. Scomporrai tutta la piccola matematica che c’è dietro e la studierai. Alla fine costruirai anche un semplice classificatore di sentiment. In particolare, vedrai:
Iniziamo.
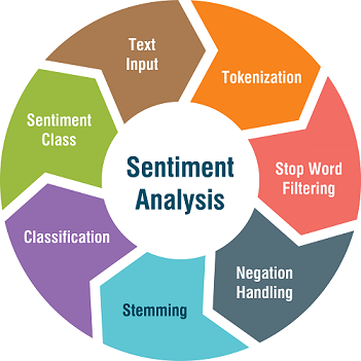
In sostanza, l’analisi o classificazione del sentiment rientra nella più ampia categoria dei compiti di classificazione del testo, dove ti viene fornita una frase o un elenco di frasi e il tuo classificatore deve dire se il sentiment è positivo, negativo o neutro. A volte il terzo attributo viene escluso per mantenere un problema di classificazione binaria. Nei compiti più recenti, si considerano anche sentiment come "lievemente positivo" e "lievemente negativo". Vediamolo ora con un esempio.
Considera le seguenti frasi:
Le frasi corrispondono a brevi recensioni di film e ciascuna trasmette sentiment differenti. Per esempio, la prima esprime un sentiment positivo sul film Titanic, mentre la seconda lo considera non così grande (sentiment negativo). Osserva più da vicino la terza. Non c’è alcuna parola in quella frase che dica qualcosa riguardo al sentiment che trasmette. È quindi un esempio di sentiment neutro.
Da un punto di vista strettamente di machine learning, questo compito non è altro che un compito di apprendimento supervisionato. Fornirai un insieme di frasi (con le etichette dei rispettivi sentiment) al modello di machine learning, e testerai il modello su frasi senza etichetta.
Per introdurre l’analisi del sentiment questo basta, ma per riuscire a costruire un modello di classificazione del sentiment serve qualcosa in più. Andiamo avanti.
 Fonte: SlideShare
Prima di capire la formulazione del problema in un compito di classificazione del sentiment, devi avere un’idea chiara del problema generale di classificazione del testo. Definiamo formalmente il problema.
Il termine documento qui è soggettivo nel mondo della classificazione del testo. Per documento si intendono tweet, frasi, parti di articoli di giornale, interi articoli, un manuale prodotto, un racconto, ecc. La ragione dietro questa terminologia è la nozione di parola, che in questo contesto è un’entità atomica e piccola. Quindi, per indicare sequenze lunghe di parole, in generale si usa il termine documento. Un tweet è un documento più corto, un articolo è un documento più lungo.
Un set di addestramento di n documenti etichettati appare così: (d1,c1), (d2,c2),...,(dn,cn) e l’output finale è un classificatore appreso.
Stai andando bene! Ma una domanda che probabilmente ti poni a questo punto è: dove sono le caratteristiche (feature) dei documenti? Domanda legittima! Ci arriverai tra poco.
Ora proseguiamo con la formulazione del problema e costruiamo gradualmente l’intuizione dietro la classificazione del sentiment.
Un punto cruciale da tenere a mente lavorando sull’analisi del sentiment è che non tutte le parole in una frase trasmettono il sentiment della frase. Parole come "Io", "Sono", "Sei", ecc. non contribuiscono a esprimere alcun tipo di sentiment e quindi non sono rilevanti in un contesto di classificazione del sentiment. Considera qui il problema della selezione delle feature. Nella selezione delle feature, cerchi di individuare le caratteristiche più rilevanti rispetto all’etichetta di classe. La stessa idea vale anche qui. Quindi, solo un numero limitato di parole in una frase partecipa a questo compito e identificarle ed estrarle dalle frasi si rivela impegnativo. Ma non preoccuparti, ci arriverai.
Considera la seguente recensione di un film per capire meglio:
"Adoro questo film! È dolce, ma con umorismo satirico. I dialoghi sono fantastici e le scene d’azione sono divertenti. Riesce a essere romantico e bizzarro mentre ironizza sulle convenzioni del genere fiabesco. Lo consiglierei a chiunque. L’ho visto diverse volte e sono sempre felice di rivederlo......."
Sì, è indubbiamente una recensione che esprime sentiment positivi riguardo a un determinato film. Ma quali sono le parole specifiche che definiscono questa positività?
Riguarda di nuovo la recensione.
"Adoro questo film! È dolce, ma con umorismo satirico. I dialoghi sono fantastici e le scene d’azione sono divertenti. Riesce a essere romantico e bizzarro mentre ironizza sulle convenzioni del genere fiabesco. Lo consiglierei a chiunque. L’ho visto diverse volte e sono sempre felice di rivederlo ancora......."
Ora il quadro è chiaro. Le parole in grassetto nel testo sopra sono le più importanti nel costruire la natura positiva del sentiment trasmesso dal testo.
Cosa farne di queste parole? Il passo successivo, naturale, è creare una rappresentazione simile alla seguente:

Cosa fa la rappresentazione sopra? L’hai intuito: ogni riga contiene una parola e la sua frequenza di occorrenza nel documento (chiamiamolo d’ora in poi documento). Ti starai anche chiedendo: love compare una sola volta ma perché la frequenza è 2? Be’, questa è una parte dell’intera recensione. Considera che la rappresentazione si riferisca a tutta la recensione.
Formulando il problema della classificazione del sentiment, hai incontrato la rappresentazione a "Sacchetto di parole" e quella sopra non è altro che una rappresentazione Bag-of-words. Probabilmente è uno dei concetti più fondamentali dell’NLP ed è il primo passo per affrontare qualsiasi problema di classificazione del testo. Assicurati di capirlo bene.
Una rappresentazione bag-of-words di un documento non contiene solo parole specifiche ma tutte le parole uniche del documento e le loro frequenze di occorrenza. Qui bag è un insieme matematico, quindi per definizione non contiene duplicati.
Ma per questa applicazione, ti interessano solo le parole in grassetto menzionate prima, quindi il bag-of-words per questo documento conterrà solo quelle.
I documenti non sono scritti alla rinfusa, giusto? La sequenza delle parole in un documento è importante. Ma nel contesto della classificazione del sentiment, la sequenza non è così rilevante. Ciò che conta di più qui è la presenza di quelle parole.
Le parole che hai trovato nel bag-of-words andranno ora a costituire l’insieme delle feature del tuo documento. Quindi, immagina di avere una raccolta di molte recensioni di film (documenti), di aver creato per ciascuna la rappresentazione bag-of-words e di averne preservato le etichette (cioè i sentiment - +ve o -ve in questo caso). Il tuo set di addestramento dovrebbe apparire così:

Questa rappresentazione è anche nota come Corpus.
Questo set di addestramento dovrebbe essere facile da interpretare -
Tutte le righe sono vettori di feature indipendenti contenenti informazioni su uno specifico documento (recensioni di film), sulle parole in questione e sul suo sentiment. Nota che l’etichetta sentiment è spesso indicata come (+, -) o (+ve, -ve). Inoltre, le feature w1, w2, w3, 34, ..., wn sono generate da un bag of words, e non è necessario che tutti i documenti contengano ciascuna di queste feature/parole.
Passerai questi vettori di feature al classificatore. Quindi, studiamolo: il modello di classificazione Naive Bayes per la classificazione del sentiment.
La classificazione Naive Bayes non è altro che l’applicazione della regola di Bayes per formare probabilità di classificazione. In questa sezione studierai il classificatore Naive Bayes nel contesto della classificazione del sentiment. È altamente consigliato un ripasso su Naive Bayes e sulla regola di Bayes. Ecco alcune risorse:
Ma perché Naive Bayes nel mondo di k-NN, Decision Trees e tanti altri? Ci arriverai più avanti.
Costruiamo prima la nozione dei termini generali del classificatore Naive Bayes nel contesto della classificazione del sentiment. Partiamo dando un’occhiata alla regola di Bayes:

In questo caso, la classe comprende due sentiment: positivo e negativo.
Studiamo in dettaglio ciascun termine dell’immagine sopra in questo contesto.
Ora, cosa sono Prior e Likelihood? E il termine P(d) (probabilità di un documento); suona strano? Ottime domande! Troviamo le risposte.
Non i dettagli più fini finora! Ma resta con noi. Scoprirai di più. Ricorda, stai ancora costruendo l’intuizione per collegare la regola di Bayes al contesto della classificazione del sentiment.
Entriamo più nel dettaglio per capire cosa stia cercando di fare la regola di Bayes qui. L’immagine seguente presenta passi più dettagliati:

Tanti termini sconosciuti. Andiamo con calma.
Partiamo dal termine a destra cMAP. Denota l’obiettivo principale della regola di Bayes qui, cioè trovare la massima probabilità/stima a posteriori che un certo documento appartenga a una determinata classe. MAP è l’abbreviazione di Max A Posteriori.
Cos’è argmax? Avresti potuto usare semplicemente max!
argmax restituisce l’indice. Supponi che P(+|d) > P(-|d), dove + e - denotano rispettivamente sentiment positivo e negativo. Questi termini P(+|d), P(-|d) restituiscono probabilità, cioè valori numerici. Ma a te non interessa la probabilità, interessa la classe per cui P(+|d) è maggiore, e argmax restituisce proprio quella. Per P(+|d) > P(-|d), argmax restituirà +.E sì, puoi ignorare il termine al denominatore P(d). Dipende interamente dall’implementazione.
Ma come trovo $P(d|c)$ e $P(c)$? È esattamente qui che il bag of words torna utile. Ma come?
Continua a leggere!
Sai già come convertire un documento in una rappresentazione bag of words. Ancora più importante, puoi rappresentare un documento come un insieme di feature. Quindi ora, in sostanza, il termine cMAP può essere scritto (ignorando il denominatore P(d)) così:

Ma come si calcolano davvero le probabilità? Partiamo da $P(c)$.
P(c) riguarda sostanzialmente questa domanda: "Quanto spesso si presenta questa classe?" Diciamo che il tuo dataset contiene il 60% di sentiment positivi e il 40% di negativi. Quindi $P(+) = 0.6$ e $P(-) = 0.4$.
Ora, come interpreti questo termine: P(x1, x2,...,xn | c)?
Pensala così: qual è la probabilità delle occorrenze di queste parole (feature) data la classe c. Per esempio, supponi di avere 1000 documenti e nel corpus solo due parole: "good" e "awesome". Ora, di questi 1000 documenti, 500 sono etichettati come positivi e i restanti 500 come negativi. Inoltre, hai scoperto che tra i 500 positivi, 200 contengono sia "good" sia "awesome" (nota che P(x1,x2) significa P(x1 e x2)). Quindi, la probabilità P(good,awesome | +) = 200 / 1000 = 1/5.
Un punto importante: se la dimensione del tuo vocabolario è $X$ allora puoi formulare probabilità di verosimiglianza Xn (come P(good,awesome | +)) a patto che il tuo documento contenga n parole.
Ricorda che devi calcolare le probabilità di verosimiglianza per entrambe le classi. Quindi, il numero totale di combinazioni in uno scenario con 2000 parole totali e documenti che contengono in media 20 parole sarà (2000)20. Questo numero è enormemente grande! E se il corpus è nell’ordine dei milioni (cosa che accade davvero in pratica)?
Questo è il Classificatore di Bayes. Ma così com’è non funziona: i calcoli sono troppi. Ora studierai alcune assunzioni per trasformarlo in un Naive Bayes.
Le assunzioni che vedrai sono chiamate Assunzioni di indipendenza di Naive Bayes. Sono le seguenti:
- Assunzione bag of words: si assume che la posizione non conti. Supponi che una parola compaia alla 10ª e alla 20ª posizione: con questa assunzione importa solo la frequenza con cui appare, cioè 2. I numeri 10 e 12 qui sono irrilevanti.
- Assunzione di indipendenza condizionale: è l’assunzione cruciale che rende Bayes un Naive Bayes. Afferma: "assumi le probabilità delle feature P(xi|cj)". Guarda bene l’enunciato. Significa che P(x1|cj), P(x2|cj) e così via sono indipendenti tra loro. (Non significa in alcun modo che P(x1), P(x2) ecc. siano indipendenti tra loro) Ora, il termine P(x1, x2,...,xn | c) può essere espresso così: 
In modo naturale, le combinazioni Xn si riducono a Xn, che è esponenzialmente meno (se la dimensione del vocabolario è $X$ e il documento contiene n parole). Definito matematicamente, il classificatore di Bayes ridotto a Naive Bayes appare così:

Naive Bayes ha due vantaggi:
Quando il meccanismo di classificazione Naive Bayes è applicato a un problema di classificazione del testo, viene chiamato "Multinomial Naive Bayes".
Ora hai una buona comprensione del funzionamento di un classificatore Naive Bayes, in particolare per un problema di classificazione del sentiment. È il momento di implementarne uno.
Lo farai in Python! Iniziamo con il caso di studio.
Per questo caso di studio userai un corpus offline di recensioni di film, trattato nel libro NLTK e scaricabile da qui. nltk fornisce una versione del dataset. Il dataset categorizza ogni recensione come positiva o negativa. Devi prima scaricarlo così:
python -m nltk.downloader all
Non è consigliato eseguirlo da Jupyter Notebook. Prova a lanciarlo dal prompt dei comandi (se usi Windows). Ci vorrà un po’ di tempo. Abbi pazienza.
Per maggiori informazioni sui dataset NLTK, assicurati di visitare questo link.
Implementerai Naive Bayes, o meglio Multinomial Naive Bayes, usando NLTK, che sta per Natural Language Toolkit. È una libreria dedicata a compiti di NLP e NLU, con un’ottima documentazione. Copre molte tecniche in modo efficace e fornisce anche dataset gratuiti per fare esperimenti.
Questo è il sito ufficiale di NLTK. Dagli un’occhiata: ha tutorial ben scritti che coprono vari concetti di NLP.
Dopo aver scaricato tutti i dati, inizierai importando il dataset delle recensioni di film con from nltk.corpus import movie_reviews. Poi costruirai una lista di documenti etichettati con le categorie appropriate.
# Load and prepare the dataset
import nltk
from nltk.corpus import movie_reviews
import random

documents = [(list(movie_reviews.words(fileid)), category)
              for category in movie_reviews.categories()
              for fileid in movie_reviews.fileids(category)]

random.shuffle(documents)
Successivamente, definirai un estrattore di feature per i documenti, così il classificatore saprà a quali aspetti dei dati prestare attenzione. "In questo caso, puoi definire una feature per ogni parola, indicando se il documento contiene quella parola. Per limitare il numero di feature che il classificatore deve elaborare, inizi costruendo una lista delle 2000 parole più frequenti nell’intero corpus" Fonte. Puoi quindi definire un estrattore che verifica semplicemente se ciascuna di queste parole è presente in un dato documento.
# Define the feature extractor

all_words = nltk.FreqDist(w.lower() for w in movie_reviews.words())
word_features = list(all_words)[:2000]

def document_features(document):
    document_words = set(document)
    features = {}
    for word in word_features:
        features['contains({})'.format(word)] = (word in document_words)
    return features
"Il motivo per cui hai calcolato l’insieme di tutte le parole in un documento document_words = set(document), invece di controllare semplicemente se la parola è nel documento, è che verificare la presenza in un insieme è molto più veloce che in una lista" - Fonte.
Hai definito l’estrattore di feature. Ora puoi usarlo per addestrare un classificatore Naive Bayes che predica il sentiment di nuove recensioni di film. Per valutarne le prestazioni, calcolerai l’accuratezza sul set di test. NLTK fornisce show_most_informative_features() per vedere quali feature il classificatore considera più informative.
# Train Naive Bayes classifier
featuresets = [(document_features(d), c) for (d,c) in documents]
train_set, test_set = featuresets[100:], featuresets[:100]
classifier = nltk.NaiveBayesClassifier.train(train_set)
# Test the classifier
print(nltk.classify.accuracy(classifier, test_set))
0.71
Wow! Il classificatore ha raggiunto un’accuratezza del 71% senza nemmeno ottimizzare parametri o fare fine-tuning. Ottimo per un primo tentativo!
# Show the most important features as interpreted by Naive Bayes
classifier.show_most_informative_features(5)
Most Informative Features
       contains(winslet) = True              pos : neg    =      8.4 : 1.0
     contains(illogical) = True              neg : pos    =      7.6 : 1.0
      contains(captures) = True              pos : neg    =      7.0 : 1.0
        contains(turkey) = True              neg : pos    =      6.5 : 1.0
        contains(doubts) = True              pos : neg    =      5.8 : 1.0
"Nel dataset, una recensione che menziona "Illogical" è quasi 8 volte più probabile che sia negativa piuttosto che positiva, mentre una recensione che menziona "Captures" è circa 6 volte più probabile che sia positiva" - Fonte.
Ora la domanda: perché Naive Bayes?
La principale limitazione di Naive Bayes è l’assunzione di predittori indipendenti. Nella vita reale è quasi impossibile ottenere un insieme di predittori completamente indipendenti.
L’analisi del sentiment risolve diversi problemi reali di business:
Congratulazioni! Sei arrivato fino in fondo. L’NLP è un tema vastissimo e affascinante, e affronta problemi impegnativi. In particolare, l’intersezione tra NLP e Deep Learning ha dato vita a prodotti straordinari. Ha rivoluzionato il modo in cui i chatbot interagiscono. L’elenco è infinito.
Questo tutorial si spera ti abbia dato una spinta iniziale in uno dei sotto-campi principali dell’NLP, ovvero l’Analisi del Sentiment. Hai affrontato uno dei temi più fondamentali dell’NLP - il Bag of Words - e poi hai studiato in dettaglio il Classificatore Naive Bayes, esaminandone anche i limiti. Hai usato nltk, una delle librerie Python più popolari per NLP e NLU. Hai implementato un semplice classificatore Naive Bayes con il corpus di recensioni fornito da nltk. Fatti un applauso. Te lo meriti!
Di seguito alcuni link a risorse eccellenti, se vuoi proseguire oltre questo umile inizio:
Per creare questo tutorial sono stati usati i seguenti riferimenti:
Se ti interessa imparare le basi dell’NLP e applicarle a dataset reali, puoi seguire il corso di DataCamp "Natural Language Processing Fundamentals in Python".
Corsi Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



