Kurs
Python ile NLP için Özellik Mühendisliği
4 sa
29.8K
Makine öğreniminin sunduğu olanaklar, çok çeşitli alanlarda çarpıcı sonuçlar ortaya koydu. Doğal dil işleme de bunun istisnası değil; hatta makine öğreniminin genel yapay zekâ kabiliyetlerini (tam olmasa da en azından kısmen) sergileyerek gerçekten karmaşık görevlerde parlak sonuçlar aldığı alanlardan biri.
Aslında NLP (doğal dil işleme) de makine öğrenimi de yeni alanlar değil. Ancak bu iki alanın birleşimi oldukça güncel ve ilerlemeye devam ediyor. Bu, bütçeye uygun bir akıllı telefonu olan herkesin günlük yaşamında karşılaştığı hibrit uygulamalardan biri. Örneğin “klavye kelime önerisi” ya da akıllı otomatik tamamlama; bunların tümü NLP ile Makine Öğreniminin birleşiminin yan ürünleri ve doğal olarak hayatımızın ayrılmaz parçaları hâline geldiler.
Duygu analizi, NLP alanında kritik bir konu. İlgililiği ve çözdüğü iş problemlerinin sayısı sayesinde hızla en popüler başlıklardan biri oldu. Bu eğitimde, o kadar da basit olmayan bu konuyu basit bir yolla ele alacaksınız. Arkasındaki küçük matematiği parçalara ayırıp inceleyeceksiniz. Ayrıca eğitimin sonunda basit bir duygu sınıflandırıcı da inşa edeceksiniz. Özellikle şu başlıkları işleyeceksiniz:
Hadi başlayalım.
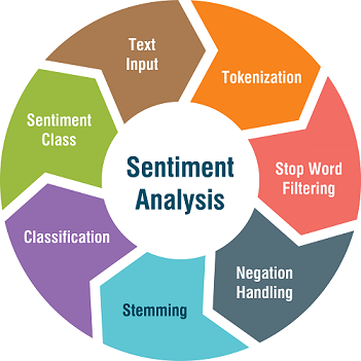
Özünde duygu analizi ya da duygu sınıflandırma, size bir ifade ya da ifade listesi verildiği ve sınıflandırıcınızın bunun ardındaki duygunun olumlu, olumsuz ya da nötr olduğunu söylemesinin beklendiği geniş metin sınıflandırma görevleri kategorisine girer. Bazen ikili sınıflandırma olarak tutulması için üçüncü nitelik (nötr) alınmaz. Güncel görevlerde “biraz olumlu” ve “biraz olumsuz” gibi duygular da ele alınıyor. Şimdi bir örnekle anlayalım.
Aşağıdaki ifadeleri düşünün:
Bu ifadeler kısa film yorumlarına karşılık gelir ve her biri farklı duygular taşır. Örneğin ilk ifade Titanic filmi hakkında olumlu bir duygu belirtirken, ikincisi filmi pek de harika bulmaz (olumsuz duygu). Üçüncü ifadeye daha yakından bakın. Bu ifadede, iletilen duygu hakkında size bir şey söyleyebilecek bir kelime yok. Dolayısıyla bu, nötr duyguya bir örnektir.
Katı bir makine öğrenimi bakış açısından bu görev, denetimli öğrenmeden başka bir şey değildir. Makine öğrenimi modeline bir grup ifade (ilgili duygu etiketleriyle) sağlayacak ve modeli etiketlenmemiş ifadeler üzerinde test edeceksiniz.
Duygu analizine bir giriş için bu kadarı yeterli; ancak bir duygu sınıflandırma modeli inşa edebilmek için biraz daha fazlasına ihtiyaç var. Devam edelim.
 Kaynak: SlideShare
Bir duygu sınıflandırma görevinin problem ifadesini anlamadan önce, genel bir metin sınıflandırma probleminin net bir tanımına sahip olmalısınız. Gelin genel bir metin sınıflandırma görevini biçimsel olarak tanımlayalım.
Buradaki belge terimi, metin sınıflandırma dünyasında öznel bir kavramdır. Belge derken; tweet’ler, ifadeler, haber makalelerinin bölümleri, tüm haber makaleleri, tam bir makale, ürün kılavuzu, hikâye vb. kastedilir. Bu terminolojinin arkasındaki sebep, bu bağlamda atomik ve küçük bir varlık olan kelimedir. Bu yüzden kelimelerin uzun dizilerini belirtmek için genel olarak belge terimi kullanılır. Tweet daha kısa bir belgeyi, makale ise daha uzun bir belgeyi ifade eder.
Dolayısıyla n etiketli belgeden oluşan bir eğitim kümesi şöyle görünür: (d1,c1), (d2,c2),...,(dn,cn) ve nihai çıktı, öğrenilmiş bir sınıflandırıcıdır.
İyi gidiyorsunuz! Ancak şu noktada muhtemelen aklınızda şu soru var: Belgelerin özellikleri nerede? Yerinde bir soru! Birazdan oraya geleceksiniz.
Şimdi problem formülasyonuyla devam edip duygu sınıflandırmanın sezgisini yavaş yavaş oluşturalım.
Duygu analizi üzerinde çalışırken akılda tutulması gereken kritik bir nokta, bir ifadedeki tüm kelimelerin o ifadenin duygusunu iletmediğidir. "I", "Are", "Am" gibi kelimeler herhangi bir duygu iletimine katkıda bulunmaz; bu nedenle duygu sınıflandırma bağlamında göreli değildirler. Burada özellik seçimi problemini düşünün. Özellik seçiminde, sınıf etiketiyle en çok ilişkili olan en ilgili özellikleri bulmaya çalışırsınız. Aynı fikir burada da geçerlidir. Bu nedenle, bir ifadede yalnızca bir avuç kelime bu işe katılır ve bunları tespit edip ifadelerden çıkarmak zorlu görevlerdir. Ama endişelenmeyin, oraya da geleceksiniz.
Bunu daha iyi anlamak için aşağıdaki film yorumunu ele alın:
"I love this movie! It's sweet, but with satirical humor. The dialogs are great and the adventure scenes are fun. It manages to be romantic and whimsical while laughing at the conventions of the fairy tale genre. I would recommend it to just about anyone. I have seen it several times and I'm always happy to see it again......."
Evet, bu kuşkusuz belirli bir filmle ilgili olumlu duygular taşıyan bir yorum. Peki bu olumluluğu tanımlayan belirli kelimeler hangileri?
Yoruma tekrar bakın.
"I love this movie! It's sweet, but with satirical humor. The dialogs are great and the adventure scenes are fun. It manages to be romantic and whimsical while laughing at the conventions of the fairy tale genre. I would recommend it to just about anyone. I have seen it several times and I'm always happy to see it again......."
Artık tablo netleşmiş olmalı. Yukarıdaki metindeki kalın kelimeler, metnin ilettiği olumlu duygunun iskeletini oluşturan en önemli kelimelerdir.
Bu kelimelerle ne yapacağız? Doğal görünen bir sonraki adım, aşağıdakine benzer bir gösterim oluşturmaktır:

Peki yukarıdaki gösterim ne yapıyor? Tahmin ettiniz: Her satır bir kelimeyi ve belgedeki (bundan sonra belge diyelim) görülme sıklığını içeriyor. “love” yalnızca bir kez geçmiş olsa da neden sıklığı 2 diye merak ediyor olabilirsiniz. Bu, yorumun yalnızca bir parçası. Gösterimin tüm yorum için olduğunu düşünün.
Duygu sınıflandırma problem ifadesini formüle ederken, "Kelimeler torbası" gösterimini gördünüz ve yukarıdaki gösterim aslında bir Bag-of-words gösterimidir. Bu, NLP’de muhtemelen en temel kavramdır ve herhangi bir metin sınıflandırma problemine atılan ilk adımdır. Dolayısıyla iyi anladığınızdan emin olun.
Bir belgenin bag-of-words gösterimi yalnızca belirli kelimeleri değil, belgedeki tüm benzersiz kelimeleri ve görülme sıklıklarını içerir. Buradaki torba, matematiksel bir kümedir; dolayısıyla küme tanımı gereği torbada yinelenen kelime bulunmaz.
Ancak bu uygulamada yalnızca önce belirtilen kalın kelimelerle ilgileniyorsunuz; dolayısıyla bu belge için kelimeler torbası yalnızca bu kelimeleri içerecek.
Belgeler karmakarışık yazılmaz. Öyle değil mi? Bir belgedeki kelime sırası kritiktir. Ancak duygu sınıflandırma bağlamında bu sıra çok da önemli değildir. Burada daha önemli, hatta en önemli olan, bu kelimelerin varlığıdır.
Kelimeler torbasında bulduğunuz kelimeler artık belgenizin özellik kümesini oluşturacak. Yani elinizde birçok film yorumu (belge) olduğunu ve her biri için kelimeler torbası gösterimleri oluşturup etiketlerini (yani duygularını - bu örnekte + ve -) koruduğunuzu düşünün. Eğitim kümeniz şöyle görünmelidir:

Bu gösterim aynı zamanda Derlem (Corpus) olarak da bilinir.
Bu eğitim kümesini yorumlamak kolay olmalı -
Tüm satırlar, belirli bir belgeye (film yorumları), belirli kelimelere ve duygusuna ilişkin bilgileri içeren bağımsız özellik vektörleridir. Duygu etiketinin sıklıkla (+, -) veya (+ve, -ve) olarak gösterildiğine dikkat edin. Ayrıca w1, w2, w3, 34, ..., wn özellikleri kelimeler torbasından üretilir ve tüm belgelerin bu özelliklerin/kelimelerin her birini içermesi gerekmez.
Bu özellik vektörlerini sınıflandırıcıya vereceksiniz. Öyleyse sırada şu var: Duygu sınıflandırma için Naive Bayes sınıflandırma modeli.
Naive Bayes sınıflandırma, sınıflandırma olasılıklarını oluşturmak için Bayes kuralının uygulanmasından ibarettir. Bu bölümde, Naive Bayes sınıflandırıcıyı duygu sınıflandırma bağlamında inceleyeceksiniz. Naive Bayes sınıflandırmasına ve Bayes kuralına dair bir giriş okumanız şiddetle önerilir. İlgili kaynaklar:
Peki k-NN, Karar Ağaçları ve daha niceleri varken neden Naive Bayes? Birazdan göreceksiniz.
Önce duygu sınıflandırma bağlamında Naive Bayes sınıflandırıcısındaki genel terimlerin kavramını oluşturalım. Bayes kuralına bakarak başlayacaksınız:

Bu durumda sınıf iki duygudan oluşur: Olumlu ve olumsuz.
Yukarıdaki görseldeki her terimi bu bağlamda ayrıntılı inceleyelim.
Peki Bu Önsel (Prior) ve Olabilirlik (Likelihood) nedir? Ayrıca P(d) terimi (bir belgenin olasılığı); kulağa tuhaf mı geliyor? Harika sorular! Şimdi yanıtlayalım!
Şimdilik en ince ayrıntılar değil! Ama devam edin. Daha fazlasını keşfedeceksiniz. Unutmayın, Bayes kuralını duygu sınıflandırma bağlamıyla ilişkilendirebilmek için hâlâ sezgi inşa ediyorsunuz.
Bayes kuralının burada tam olarak ne yapmaya çalıştığını bulmak için daha ayrıntıya inelim. Aşağıdaki görsel Bayes kuralının daha ayrıntılı adımlarını sunar:

Burada çok sayıda bilinmeyen terim var. Yavaş ilerleyelim.
Sağ taraftaki cMAP terimiyle başlayalım. Bu, Bayes kuralının buradaki temel amacını ifade eder; yani belirli bir belgenin belirli bir sınıfa ait olmasına ilişkin azami artgönderme olasılığını/tahminini bulmak. MAP, Yunanca kökenli Max A Posteriori ifadesinin kısaltmasıdır.
argmax nedir? Sadece max kullanamaz mıydınız!
argmax indeksi ifade eder. Diyelim ki P(+|d) > P(-|d); burada + ve - sırasıyla olumlu ve olumsuz duyguyu gösterir. P(+|d), P(-|d) terimleri sayısal bir nicelik olan olasılık döndürür. Ancak sizin ilginiz olasılık değerinde değil; P(+|d)’nin hangi sınıf için daha büyük olduğunu bulmaktır ve argmax bunu döndürür. P(+|d) > P(-|d) için argmax + döndürür.Ve evet, paydadaki P(d) terimini düşebilirsiniz. Bu tamamen uygulamaya bağlıdır.
Peki $P(d|c)$ ve $P(c)$ nasıl bulunur? İşte burada kelimeler torbası çok işinize yarayacak. Ama nasıl?
Okumaya devam edin!
Verilen bir belgeyi kelimeler torbası gösterimine nasıl dönüştüreceğinizi zaten biliyorsunuz. Daha da önemlisi, bununla bir belgeyi bir özellikler kümesi olarak temsil edebilirsiniz. Dolayısıyla cMAP terimi (paydadaki P(d) terimini yok sayarak) özünde şöyle yazılabilir:

Peki olasılıkları gerçekten nasıl hesaplayacaksınız? Önce $P(c)$ ile başlayalım.
P(c) özünde şu soruyla ilgilidir: "Bu sınıf ne sıklıkta görülüyor?" Diyelim ki belge veri kümenizin %60’ı olumlu, %40’ı olumsuz duygu içeriyor. O hâlde $P(+) = 0.6$ ve $P(-) = 0.4$.
Şimdi şu terimi nasıl yorumlayacaksınız: P(x1, x2,...,xn | c)?
Şöyle düşünün – c sınıfı verildiğinde bu kelimelerin (özelliklerin) ortaya çıkma olasılığı nedir? Örneğin elinizde 1000 belge var ve derlemde yalnızca iki kelime var: "good" ve "awesome". Bu 1000 belgeden 500’ü olumlu, kalan 500’ü olumsuz etiketli. Ayrıca, olumlu etiketli 500 belgenin 200’ünde hem "good" hem "awesome" geçtiğini buldunuz (P(x1,x2), P(x1 ve x2) demektir). O hâlde P(good,awesome | +) = 200 / 1000 = 1/5.
Burada önemli bir nokta: Söz varlığınızın boyutu $X$ ise ve belgeniz n kelime içeriyorsa, Xn adet olabilirlik olasılığı (ör. P(good,awesome | +)) formüle edebilirsiniz.
Unutmayın, olabilirlik olasılıklarını burada her iki sınıf için de hesaplamanız gerekir. Toplam 2000 kelimenin bulunduğu ve her belgenin ortalama 20 kelime içerdiği bir senaryoda toplam kombinasyon sayısı (2000)20 olur. Bu sayı akıl almaz derecede büyük! Ya derlemin boyutu milyonlar seviyesindeyse (pratikte gerçekten olur)?
Buna Bayes Sınıflandırıcısı denir. Ancak hesaplamalar çok fazla olduğundan bu hâliyle çalışmaz. Şimdi Bayes sınıflandırıcısını Naive Bayes sınıflandırıcısına dönüştürecek bazı varsayımları inceleyeceksiniz.
İnceleyeceğiniz varsayımlar Naive Bayes Bağımsızlık Varsayımları olarak adlandırılır. Şunlardır:
- Kelimeler torbası varsayımı: Konumun önemli olmadığını varsayın. Belirli bir kelimenin 10. ve 20. pozisyonda geçtiğini düşünün; bu varsayımla, yalnızca o kelimenin kaç kez geçtiği (2) ile ilgilenirsiniz. 10 ve 12 sayıları burada ilgisizdir.
- Koşullu bağımsızlık varsayımı: Bayes sınıflandırıcısını Naive Bayes yapan kritik varsayım budur. “Özellik olasılıklarının P(xi|cj) olduğunu varsayın” der. Dikkatle bakın: P(x1|cj), P(x2|cj) vb. birbirinden bağımsızdır (Bu, P(x1), P(x2) vb.nin birbirinden bağımsız olduğu anlamına gelmez). Artık P(x1, x2,...,xn | c) terimi şöyle ifade edilebilir: 
Doğal olarak, Xn kombinasyonlar Xn’e düşer; bu da (söz varlığınızın boyutu $X$ ve belgeniz n kelime içeriyorsa) üstel olarak daha azdır. Matematiksel olarak tanımlandığında, Bayes sınıflandırıcısı Naive Bayes’e indirgenince şöyle görünür:

Naive Bayes’in iki avantajı vardır:
Naive Bayes sınıflandırma mekanizması bir metin sınıflandırma problemine uygulandığında “Çoknomlu (Multinomial) Naive Bayes” sınıflandırması olarak anılır.
Artık özellikle bir duygu sınıflandırma problemi için Naive Bayes’in işleyişini anlamada oldukça yetkinsiniz. Şimdi bir duygu sınıflandırıcıyı uygulama zamanı.
Bunu Python ile yapacaksınız! Hadi vaka çalışmasına geçelim.
Bu vaka çalışmasında, NLTK kitabında ele alınan ve buradan indirilebilen çevrimdışı bir film yorumu derlemini kullanacaksınız. nltk veri kümesinin bir sürümünü sağlar. Veri kümesi her yorumu olumlu veya olumsuz olarak kategorize eder. Önce aşağıdaki gibi indirmeniz gerekir:
python -m nltk.downloader all
Bunu Jupyter Notebook’tan çalıştırmanız önerilmez. Komut isteminden (Windows kullanıyorsanız) çalıştırmayı deneyin. Biraz zaman alacaktır. Sabırlı olun.
NLTK veri kümeleri hakkında daha fazla bilgi için bu bağlantıyı mutlaka ziyaret edin.
Doğal Dil Araç Takımı anlamına gelen NLTK kullanarak Naive Bayes, ya da diyelim ki Çoknomlu Naive Bayes sınıflandırıcıyı uygulayacaksınız. Bu kütüphane, NLP ve NLU ile ilgili görevlere adanmıştır ve dokümantasyonu çok iyidir. Birçok tekniği derli toplu biçimde ele alır ve deneyler için ücretsiz veri kümeleri de sağlar.
Burası NLTK’nin resmî sitesidir. Farklı NLP kavramlarını kapsayan, iyi yazılmış öğreticileri olduğu için mutlaka göz atın.
Tüm veriler indirildikten sonra, from nltk.corpus import movie_reviews ile film yorumları veri kümesini içe aktararak başlayacaksınız. Ardından, uygun kategorilerle etiketlenmiş bir belge listesi oluşturacaksınız.
# Load and prepare the dataset
import nltk
from nltk.corpus import movie_reviews
import random

documents = [(list(movie_reviews.words(fileid)), category)
              for category in movie_reviews.categories()
              for fileid in movie_reviews.fileids(category)]

random.shuffle(documents)
Sonraki adımda, sınıflandırıcının verinin hangi yönlerine dikkat etmesi gerektiğini bilebilmesi için belgeler için bir özellik çıkarıcı tanımlayacaksınız. "Bu durumda, belgenin o kelimeyi içerip içermediğini belirten, her kelime için bir özellik tanımlayabilirsiniz. Sınıflandırıcının işlemesi gereken özellik sayısını sınırlamak için, önce genel derlemdeki en sık geçen 2000 kelimeden oluşan bir liste oluşturursunuz" Kaynak. Daha sonra, bu kelimelerin her birinin verilen bir belgede bulunup bulunmadığını basitçe kontrol eden bir özellik çıkarıcı tanımlayabilirsiniz.
# Define the feature extractor

all_words = nltk.FreqDist(w.lower() for w in movie_reviews.words())
word_features = list(all_words)[:2000]

def document_features(document):
    document_words = set(document)
    features = {}
    for word in word_features:
        features['contains({})'.format(word)] = (word in document_words)
    return features
"Bir kelimenin belgede olup olmadığını kontrol etmek yerine document_words = set(document) ile belgedeki tüm kelimelerin kümesini hesaplamanızın nedeni, bir kümede bir kelimenin geçip geçmediğini kontrol etmenin, bir listede olup olmadığını kontrol etmekten çok daha hızlı olmasıdır" - Kaynak.
Özellik çıkarıcıyı tanımladınız. Artık bunu kullanarak yeni film yorumlarının duygularını öngörmek için bir Naive Bayes sınıflandırıcı eğitebilirsiniz. Sınıflandırıcınızın performansını kontrol etmek için, test kümesi üzerinde doğruluğunu hesaplayacaksınız. NLTK, sınıflandırıcının en bilgilendirici bulduğu özellikleri görmek için show_most_informative_features() sağlar.
# Train Naive Bayes classifier
featuresets = [(document_features(d), c) for (d,c) in documents]
train_set, test_set = featuresets[100:], featuresets[:100]
classifier = nltk.NaiveBayesClassifier.train(train_set)
# Test the classifier
print(nltk.classify.accuracy(classifier, test_set))
0.71
Vay canına! Herhangi bir parametreyle oynamadan ya da ince ayar yapmadan sınıflandırıcı %71 doğruluk elde etti. İlk deneme için harika!
# Show the most important features as interpreted by Naive Bayes
classifier.show_most_informative_features(5)
Most Informative Features
       contains(winslet) = True              pos : neg    =      8.4 : 1.0
     contains(illogical) = True              neg : pos    =      7.6 : 1.0
      contains(captures) = True              pos : neg    =      7.0 : 1.0
        contains(turkey) = True              neg : pos    =      6.5 : 1.0
        contains(doubts) = True              pos : neg    =      5.8 : 1.0
"Veri kümesinde, "Illogical" kelimesinden bahseden bir yorumun olumsuz olma olasılığı olumlu olmaya göre neredeyse 8 kat daha fazlayken, "Captures" kelimesinden bahseden bir yorumun olumlu olma olasılığı yaklaşık 6 kat daha fazladır" - Kaynak.
Şimdi soru şu - neden Naive Bayes?
Naive Bayes’in temel sınırlaması, öngörücülerin bağımsız olduğu varsayımıdır. Gerçek hayatta tamamen bağımsız öngörücüler seti elde etmek neredeyse imkânsızdır.
Duygu analizi bir dizi gerçek iş problemini çözer:
Tebrikler! Sona kadar geldiniz. NLP çok geniş ve ilgi çekici bir konu olup zorlu problemleri çözer. Özellikle NLP ve Derin Öğrenmenin kesişimi, harika ürünlerin doğmasına yol açtı. Sohbet botlarının etkileşim şeklini tamamen dönüştürdü. Liste uzar gider.
Bu eğitim umarız NLP’nin başat alt alanlarından biri olan Duygu Analizi konusunda size bir başlangıç sağlamıştır. NLP’nin en temel konularından biri olan Kelimeler Torbası yaklaşımını ele aldınız ve ardından Naive Bayes Sınıflandırıcıyı ayrıntılı olarak incelediniz. Eksik yönlerini de değerlendirdiniz. NLP ve NLU görevleri için en popüler Python kütüphanelerinden biri olan nltk’yi kullandınız. nltk’nin sunduğu film derlemiyle basit bir Naive Bayes sınıflandırıcı uyguladınız. Kendinizi tebrik edin. Hak ettiniz!
Mütevazı başlangıcın ötesine geçmek isterseniz, sırada bazı harika kaynaklar var:
Bu eğitimi hazırlarken aşağıdaki başvurulardan yararlanıldı:
NLP’nin temellerini öğrenmek ve gerçek dünyadaki veri kümelerine uygulamak ilginizi çekiyorsa, DataCamp’in "Python ile Doğal Dil İşleme Temelleri" kursunu alabilirsiniz.
Python Kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




