Cursus
Feature Engineering voor NLP in Python
4 uur
29.8K
De belofte van machine learning heeft in tal van vakgebieden verbluffende resultaten opgeleverd. Natural language processing vormt daarop geen uitzondering, en is een van die domeinen waarin machine learning algemene kunstmatige intelligentie (niet volledig, maar toch deels) heeft laten zien met briljante resultaten voor echt complexe taken.
NLP (natural language processing) is geen nieuw vakgebied en machine learning evenmin. Maar de samensmelting van beide is vrij recent en belooft alleen maar meer vooruitgang. Dit is een van die hybride toepassingen die iedereen (met een smartphone) dagelijks tegenkomt. Denk bijvoorbeeld aan "toetsenbordsuggesties" of slimme auto-aanvullingen; dit zijn allemaal bijproducten van de combinatie van NLP en machine learning en inmiddels onlosmakelijk onderdeel van ons leven.
Sentimentanalyse is een belangrijk onderwerp binnen NLP. Het is uitgegroeid tot een van de heetste topics vanwege de relevantie en het aantal zakelijke problemen dat ermee wordt opgelost of beantwoord. In deze tutorial pak je dit niet zo eenvoudige onderwerp op een eenvoudige manier aan. Je breekt de achterliggende wiskunde op in behapbare stukken en bestudeert die. Ook bouw je aan het eind van deze tutorial een eenvoudige sentiment-classifier. Concreet behandel je:
Laten we beginnen.
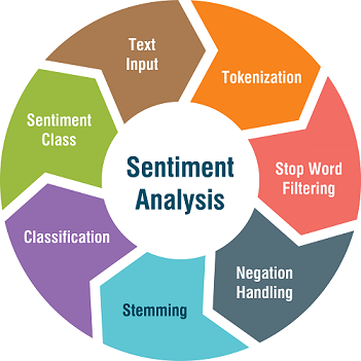
In wezen valt sentimentanalyse of sentimentclassificatie onder de brede categorie tekstondertaken waarbij je een zin of een lijst zinnen aanlevert en je classifier moet aangeven of het sentiment daarachter positief, negatief of neutraal is. Soms wordt het derde kenmerk weggelaten om het een binaire classificatie te houden. In recente taken worden ook nuances als "enigszins positief" en "enigszins negatief" meegenomen. Laten we dit nu met een voorbeeld begrijpen.
Beschouw de volgende zinnen:
De zinnen komen overeen met korte filmreviews en elk ervan draagt een ander sentiment uit. Zo drukt de eerste zin een positief sentiment uit over de film Titanic, terwijl de tweede de film niet zo geweldig vindt (negatief sentiment). Kijk eens beter naar de derde. In die zin staat geen enkel woord dat iets zegt over het gevoel dat ermee wordt uitgedrukt. Dat is dus een voorbeeld van een neutraal sentiment.
Vanuit een strikt machine-learningperspectief is deze taak niets anders dan een supervised learning-taak. Je voedt een reeks zinnen (met de labels van hun respectieve sentimenten) aan het machine-learningmodel en test het model vervolgens op niet-gelabelde zinnen.
Voor een eerste kennismaking met sentimentanalyse is dit prima, maar om een sentimentclassificatiemodel te kunnen bouwen, heb je meer nodig. Laten we verder gaan.
 Bron: SlideShare
Voordat je de probleemstelling van een sentimentclassificatietaak begrijpt, heb je een helder beeld nodig van het algemene tekstclassificatieprobleem. Laten we dat formeel definiëren.
De term document is hier subjectief in de wereld van tekstclassificatie. Met document wordt bedoeld: tweets, zinnen, stukken nieuwsartikelen, volledige nieuwsartikelen, een compleet artikel, een producthandleiding, een verhaal, enzovoort. De reden achter deze terminologie is het woord, dat in deze context atomair en klein is. Om grote reeksen woorden aan te duiden, wordt in het algemeen de term document gebruikt. Tweets zijn korte documenten, terwijl een artikel een lang document is.
Een trainingsset van n gelabelde documenten ziet er dus uit als: (d1,c1), (d2,c2),...,(dn,cn) en de uiteindelijke output is een getrainde classifier.
Je gaat goed! Maar een vraag die je nu waarschijnlijk hebt is: waar zijn de features van de documenten? Terechte vraag! Daar kom je zo op terug.
Laten we nu verdergaan met de probleemformulering en stap voor stap de intuïtie achter sentimentclassificatie opbouwen.
Een cruciaal punt om te onthouden bij sentimentanalyse: niet alle woorden in een zin dragen het sentiment van die zin over. Woorden als "I", "Are", "Am" dragen niet bij aan het uitdrukken van enig sentiment en zijn in een sentimentclassificatiecontext dus niet relevant. Denk hier aan het probleem van featureselectie. Bij featureselectie probeer je de meest relevante features te vinden die het sterkst samenhangen met het klasselabel. Datzelfde idee geldt hier. Slechts een handvol woorden in een zin doet ertoe; die identificeren en extraheren blijkt een uitdaging. Maar geen zorgen, daar kom je op.
Beschouw de volgende filmreview om dit beter te begrijpen:
"I love this movie! It's sweet, but with satirical humor. The dialogs are great and the adventure scenes are fun. It manages to be romantic and whimsical while laughing at the conventions of the fairy tale genre. I would recommend it to just about anyone. I have seen it several times and I'm always happy to see it again......."
Ja, dit is onmiskenbaar een review met een positief sentiment over een bepaalde film. Maar welke specifieke woorden dragen die positiviteit?
Kijk nog eens naar de review.
"I love this movie! It's sweet, but with satirical humor. The dialogs are great and the adventure scenes are fun. It manages to be romantic and whimsical while laughing at the conventions of the fairy tale genre. I would recommend it to just about anyone. I have seen it several times and I'm always happy to see it again......."
Nu heb je vast een helder beeld. De vetgedrukte woorden in bovenstaande tekst zijn het belangrijkst voor het positieve sentiment dat de tekst uitdraagt.
Wat doe je met deze woorden? De volgende stap ligt voor de hand: een representatie maken zoals deze:

Wat doet bovenstaande representatie? Je raadt het al. Elke rij bevat een woord en de frequentie waarmee het in het document voorkomt (laten we het vanaf nu een document noemen). Je vraagt je ook af: love kwam maar één keer voor, waarom is de frequentie dan 2? Dit is een deel van de volledige review. Ga ervan uit dat de representatie voor de hele review geldt.
Bij het formuleren van de probleemstelling van een sentimentclassificatietaak heb je de representatie "Bag of words" leren kennen en de bovenstaande representatie is niets anders dan een Bag-of-words-representatie. Dit is waarschijnlijk een van de meest fundamentele concepten in NLP en de eerste stap bij elk tekstclassificatieprobleem. Zorg dus dat je dit goed begrijpt.
Een bag-of-words-representatie van een document bevat niet alleen specifieke woorden, maar alle unieke woorden in een document en hun frequenties. Een bag is hier een wiskundige verzameling, dus volgens de definitie bevat de bag geen duplicaten.
Maar voor deze toepassing ben je alleen geïnteresseerd in de eerder genoemde vetgedrukte woorden, dus de bag-of-words voor dit document zal alleen deze woorden bevatten.
Documenten worden niet kriskras geschreven. Toch? De volgorde van woorden in een document is belangrijk. Maar in de context van sentimentclassificatie is die volgorde niet zo belangrijk. Wat hier belangrijker, of zelfs het belangrijkst is, is de aanwezigheid van deze woorden.
De woorden die je in de bag-of-words hebt gevonden, vormen nu de feature set van je document. Stel dat je een verzameling filmreviews (documenten) hebt en je voor elk een bag-of-words-representatie hebt gemaakt en hun labels hebt bewaard (dus sentimenten - + of - in dit geval). Je trainingsset ziet er dan zo uit:

Deze representatie staat ook bekend als Corpus.
Deze trainingsset is eenvoudig te interpreteren -
Alle rijen zijn onafhankelijke featurevectoren met informatie over een specifiek document (filmreviews), de betreffende woorden en het sentiment. Merk op dat het label sentiment vaak wordt genoteerd als (+, -) of (+ve, -ve). Ook zijn de features w1, w2, w3, 34, ..., wn gegenereerd uit een bag of words, en het is niet nodig dat alle documenten elk van deze features/woorden bevatten.
Deze featurevectoren geef je door aan de classifier. Laten we die nu bestuderen - het Naive Bayes-classificatiemodel voor sentimentclassificatie.
Naive Bayes-classificatie is niets anders dan het toepassen van de regel van Bayes om classificatiekansen te vormen. In deze sectie bestudeer je de Naive Bayes-classifier in de context van sentimentclassificatie. Het is sterk aan te raden om eerst een introductie te krijgen over Naive Bayes en de regel van Bayes. Handige bronnen:
Maar waarom Naive Bayes in een wereld met k-NN, Decision Trees en zoveel anderen? Daar kom je later op terug.
Laten we eerst de algemene termen van de Naive Bayes-classifier opbouwen in de context van sentimentclassificatie. Je begint met de regel van Bayes:

In dit geval omvat de klasse twee sentimenten: positief en negatief.
Laten we elke term uit bovenstaande afbeelding in deze context in detail bekijken.
Wat zijn dan de Prior en Likelihood? En de term P(d) (kans op een document); klinkt dat niet vreemd? Geweldige vragen! Laten we de antwoorden vinden.
Nog niet de allerdiepste details! Maar houd vol. Je ontdekt zo meer. Onthoud: je bouwt nog steeds je intuïtie om de regel van Bayes te relateren aan sentimentclassificatie.
Laten we dieper ingaan op wat de regel van Bayes hier precies probeert te doen. De volgende afbeelding toont gedetailleerdere stappen van de regel van Bayes:

Veel onbekende termen hier. Rustig aan.
Begin met de term rechts cMAP. Die duidt het primaire doel van de regel van Bayes hier aan, namelijk het vinden van de maximale posterior-kans/-schatting dat een bepaald document tot een bepaalde klasse behoort. MAP is een afkorting van Max A Posteriori.
Wat is argmax? Je had toch ook gewoon max kunnen gebruiken!
argmax geeft de index terug. Stel dat P(+|d) > P(-|d), waarbij + en - respectievelijk positieve en negatieve sentimenten aanduiden. De termen P(+|d), P(-|d) leveren kansen op, dus numerieke waarden. Maar je bent niet geïnteresseerd in de kans zelf; je wilt de klasse vinden waarvoor P(+|d) groter is, en argmax geeft die terug. Voor P(+|d) > P(-|d) retourneert argmax +.En ja, je kunt de noemerterm P(d) laten vallen. Dat hangt volledig af van de implementatie.
Maar hoe vind ik $P(d|c)$ en $P(c)$? Precies hier komt de bag of words van pas. Hoe dan?
Lees verder!
Je weet al hoe je een document omzet naar een bag-of-words-representatie. Belangrijker: je kunt een document hiermee als een set features representeren. Dus kan de term cMAP (zonder de noemer P(d)) nu als volgt worden geschreven:

Maar hoe bereken je de kansen echt? Begin met $P(c)$.
P(c) komt neer op de vraag: "Hoe vaak komt deze klasse voor?" Stel dat je documentdataset 60% positieve en 40% negatieve sentimenten bevat. Dan is $P(+) = 0{,}6$ en $P(-) = 0{,}4$.
Hoe interpreteer je nu deze term: P(x1, x2,...,xn | c)?
Denk zo: wat is de kans op het voorkomen van deze woorden (features) gegeven klasse c. Bijvoorbeeld: je hebt 1000 documenten en in het corpus slechts twee woorden - "good" en "awesome". Van deze 1000 documenten zijn er 500 als positief gelabeld en de overige 500 als negatief. Ook heb je vastgesteld dat van de 500 positief gelabelde documenten er 200 zowel "good" als "awesome" bevatten (merk op: P(x1,x2) betekent P(x1 en x2)). Dus is de kans P(good,awesome | +) = 200 / 1000 = 1/5.
Een belangrijk punt: als je vocabulairegrootte $X$ is, dan kun je Xn likelihood-kansen formuleren (zoals P(good,awesome | +)), mits je document n woorden bevat.
Onthoud dat je de likelihood-kansen voor beide klassen moet berekenen. Dus het totale aantal combinaties in een scenario met 2000 totale woorden en documenten die gemiddeld 20 woorden bevatten, is (2000)20. Dat getal is gigantisch! En wat als de corpusgrootte in de miljoenen loopt (wat in de praktijk echt voorkomt)?
Dit heet de Bayes Classifier. Maar die werkt zo niet, omdat de berekeningen veel te talrijk zijn. Nu bestudeer je enkele aannames om de Bayes-classifier te reduceren tot een Naive Bayes-classifier.
De aannames die je gaat bestuderen heten Naive Bayes Independence Assumptions. Ze zijn als volgt:
- Bag-of-words-aanname: Ga ervan uit dat de positie niet uitmaakt. Stel dat een bepaald woord op de 10e en 20e positie voorkomt, dan telt met deze aanname alleen de frequentie, dus 2. De waarden 10 en 12 zijn hier irrelevant.
- Conditionele-onafhankelijkheidsaanname: Dit is de cruciale aanname die de Bayes-classifier tot Naive Bayes maakt. Ze stelt: "ga uit van onafhankelijke featurekansen P(xi|cj)". Kijk goed: het betekent dat P(x1|cj), P(x2|cj) enz. onafhankelijk van elkaar zijn. (Het betekent geenszins dat P(x1), P(x2) enz. onderling onafhankelijk zijn.) Nu kan de term P(x1, x2,...,xn | c) als volgt worden uitgedrukt: 
Natuurlijk worden Xn combinaties zo gereduceerd tot Xn, wat exponentieel minder is (als je vocabulairegrootte $X$ is en je document n woorden bevat). Wiskundig gedefinieerd ziet de Bayes-classifier, gereduceerd tot Naive Bayes, er zo uit:

Naive Bayes heeft twee voordelen:
Wanneer het Naive Bayes-classificatiemechanisme wordt toegepast op een tekstclassificatieprobleem, spreken we van "Multinomial Naive Bayes"-classificatie.
Nu begrijp je de werking van een Naive Bayes-classifier, zeker voor een sentimentclassificatieprobleem. Hoog tijd om een sentiment-classifier te implementeren.
Dat doe je in Python! Laten we beginnen met de casestudy.
Voor deze casestudy gebruik je een offline filmreviewcorpus zoals behandeld in het NLTK-boek en te downloaden via deze link. nltk levert een versie van de dataset. De dataset labelt elke review als positief of negatief. Je moet die eerst downloaden als volgt:
python -m nltk.downloader all
Het is niet aan te raden dit vanuit Jupyter Notebook te draaien. Probeer het via de command prompt (op Windows). Het duurt even, dus wees geduldig.
Voor meer informatie over NLTK-datasets, bekijk deze link.
Je gaat Naive Bayes, of beter gezegd Multinomial Naive Bayes, implementeren met NLTK (Natural Language Toolkit). Dit is een bibliotheek voor NLP- en NLU-taken, met zeer goede documentatie. Ze behandelt veel technieken uitstekend en levert bovendien gratis datasets voor experimenten.
Dit is de officiële website van NLTK. Zeker even checken: er staan goed geschreven tutorials over NLP met verschillende NLP-concepten.
Nadat alle data is gedownload, begin je met het importeren van de filmreviewsdataset via from nltk.corpus import movie_reviews. Vervolgens bouw je een lijst van documenten, gelabeld met de juiste categorieën.
# Load and prepare the dataset
import nltk
from nltk.corpus import movie_reviews
import random

documents = [(list(movie_reviews.words(fileid)), category)
              for category in movie_reviews.categories()
              for fileid in movie_reviews.fileids(category)]

random.shuffle(documents)
Vervolgens definieer je een feature-extractor voor documenten, zodat de classifier weet waarop hij moet letten. "In dit geval kun je voor elk woord een feature definiëren die aangeeft of het document dat woord bevat. Om het aantal features dat de classifier moet verwerken te beperken, begin je met het opstellen van een lijst met de 2000 meest frequente woorden in het totale corpus" Bron. Daarna definieer je een feature-extractor die simpelweg controleert of elk van deze woorden in een document aanwezig is.
# Define the feature extractor

all_words = nltk.FreqDist(w.lower() for w in movie_reviews.words())
word_features = list(all_words)[:2000]

def document_features(document):
    document_words = set(document)
    features = {}
    for word in word_features:
        features['contains({})'.format(word)] = (word in document_words)
    return features
"De reden dat je de set van alle woorden in een document berekent document_words = set(document), in plaats van alleen te controleren of het woord in het document voorkomt, is dat checken of een woord in een set zit veel sneller is dan in een lijst" - Bron.
Je hebt de feature-extractor gedefinieerd. Nu kun je die gebruiken om een Naive Bayes-classifier te trainen die de sentimenten van nieuwe filmreviews voorspelt. Om de prestaties te controleren, bereken je de nauwkeurigheid op de testset. NLTK biedt show_most_informative_features() om te zien welke features de classifier het meest informatief vond.
# Train Naive Bayes classifier
featuresets = [(document_features(d), c) for (d,c) in documents]
train_set, test_set = featuresets[100:], featuresets[:100]
classifier = nltk.NaiveBayesClassifier.train(train_set)
# Test the classifier
print(nltk.classify.accuracy(classifier, test_set))
0.71
Wauw! De classifier haalde 71% nauwkeurigheid zonder ook maar iets te tunen of parameters af te stellen. Dat is een prima eerste resultaat!
# Show the most important features as interpreted by Naive Bayes
classifier.show_most_informative_features(5)
Most Informative Features
       contains(winslet) = True              pos : neg    =      8.4 : 1.0
     contains(illogical) = True              neg : pos    =      7.6 : 1.0
      contains(captures) = True              pos : neg    =      7.0 : 1.0
        contains(turkey) = True              neg : pos    =      6.5 : 1.0
        contains(doubts) = True              pos : neg    =      5.8 : 1.0
"In de dataset is een review die "Illogical" noemt bijna 8 keer zo waarschijnlijk negatief als positief, terwijl een review die "Captures" noemt ongeveer 6 keer zo waarschijnlijk positief is" - Bron.
Nu de vraag - waarom Naive Bayes?
De belangrijkste beperking van Naive Bayes is de aanname van onafhankelijke voorspellers. In de echte wereld is het haast onmogelijk om een set voorspellers te krijgen die volledig onafhankelijk zijn.
Sentimentanalyse lost uiteenlopende, reële businessproblemen op:
Gefeliciteerd! Je hebt het einde gehaald. NLP is een zeer uitgebreid en interessant onderwerp en pakt uitdagende problemen aan. In het bijzonder heeft de kruising van NLP en Deep Learning tot fantastische producten geleid. Het heeft compleet veranderd hoe chatbots interacteren. De lijst is eindeloos.
Hopelijk gaf deze tutorial je een vliegende start in een van de belangrijkste deelgebieden van NLP, namelijk sentimentanalyse. Je behandelde een van de meest fundamentele onderwerpen binnen NLP - Bag of Words - en bestudeerde vervolgens de Naive Bayes-classifier uitgebreid. Je bekeek ook de beperkingen. Je gebruikte nltk, een van de populairste Python-bibliotheken voor NLP- en NLU-taken. Je implementeerde een eenvoudige Naive Bayes-classifier met het filmcorpus dat nltk aanbiedt. Geef jezelf een schouderklopje. Dat heb je verdiend!
Hieronder staan enkele links naar geweldige bronnen als je vanaf dit bescheiden begin verder wilt gaan:
Voor het maken van deze tutorial zijn de volgende referenties gebruikt:
Als je de basis van NLP wilt leren en toepassen op real-world datasets, bekijk dan DataCamp's cursus "Natural Language Processing Fundamentals in Python".
Python-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

