Curso
Ingeniería de características para NLP en Python
4 h
29.6K
La promesa del machine learning ha dejado resultados sorprendentes en multitud de ámbitos. El procesamiento del lenguaje natural no es una excepción y es una de esas áreas donde el aprendizaje automático ha sido capaz de mostrar rasgos de inteligencia artificial general (no del todo, pero al menos parcialmente) logrando resultados brillantes en tareas realmente complejas.
Ahora bien, NLP (natural language processing) no es un campo nuevo y el machine learning tampoco. Pero la fusión de ambos sí es bastante reciente y no deja de avanzar. Es una de esas aplicaciones híbridas con las que todo el mundo (con un smartphone económico) se cruza a diario. Por ejemplo, el "sugeridor de palabras" del teclado, o los autocompletados inteligentes; todos son fruto de la combinación de NLP y machine learning, y con toda naturalidad se han convertido en parte inseparable de nuestra vida.
El análisis de sentimientos es un tema clave dentro del NLP. Se ha convertido fácilmente en uno de los temas más candentes por su relevancia y por la cantidad de problemas de negocio que ya resuelve. En este tutorial, vas a abordar este tema no tan sencillo de una manera sencilla. Desgranaremos las matemáticas que hay detrás y las estudiaremos. Al final, también construirás un clasificador de sentimientos básico. Concretamente, verás:
Vamos a ello.
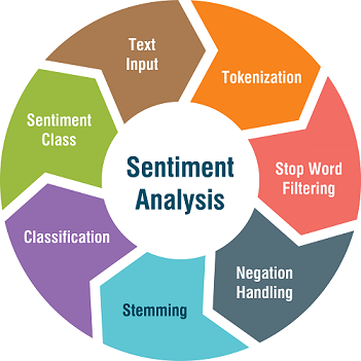
En esencia, el análisis o clasificación de sentimientos entra en la gran categoría de tareas de clasificación de texto: recibes una frase o un conjunto de frases y tu clasificador debe indicar si el sentimiento que hay detrás es positivo, negativo o neutral. A veces no se contempla la tercera categoría para mantener el problema como binario. En trabajos recientes también se consideran matices como "algo positivo" y "algo negativo". Veámoslo con un ejemplo.
Considera estas frases:
Las frases son mini reseñas y cada una transmite un sentimiento distinto. Por ejemplo, la primera denota un sentimiento positivo sobre la película Titanic, mientras que la segunda la valora como no tan buena (sentimiento negativo). Fíjate bien en la tercera: no hay ninguna palabra que te indique nada sobre el sentimiento que transmite. Es un ejemplo de sentimiento neutral.
Desde un punto de vista estrictamente de machine learning, esta tarea no es más que un problema de aprendizaje supervisado. Proporcionas al modelo un conjunto de frases (con las etiquetas de sus respectivos sentimientos) y después lo evalúas con frases sin etiquetar.
Para una primera introducción al análisis de sentimientos esto basta, pero para construir un modelo de clasificación de sentimientos necesitas algo más. Sigamos.
 Fuente: SlideShare
Antes de entender el enunciado de un problema de clasificación de sentimientos, necesitas tener clara la idea de un problema general de clasificación de texto. Definámoslo formalmente.
El término documento aquí es flexible en clasificación de texto. Documento puede significar tuits, frases, fragmentos de noticias, noticias completas, un artículo entero, un manual, un relato, etc. La razón es el término palabra, que en este contexto es la entidad atómica y pequeña. Para denotar secuencias largas de palabras, usamos documento en general. Un tuit es un documento corto; un artículo, un documento largo.
Así, un conjunto de entrenamiento de n documentos etiquetados se ve como: (d1,c1), (d2,c2),...,(dn,cn) y el resultado final es un clasificador entrenado.
¡Vas bien! Pero quizá te preguntes: ¿dónde están las características de los documentos? ¡Buena pregunta! Llegaremos a ello en un momento.
Sigamos con la formulación del problema y construyamos poco a poco la intuición detrás de la clasificación de sentimientos.
Hay un punto crucial que debes tener en mente al trabajar con análisis de sentimientos: no todas las palabras de una frase transmiten su sentimiento. Palabras como "yo", "está", "soy", etc. no aportan ningún matiz de sentimiento y, por tanto, no son relevantes en este contexto. Piensa en selección de características: intentas identificar las más relacionadas con la etiqueta de clase. Aquí aplica la misma idea. Solo un puñado de palabras en una frase participa de verdad; identificarlas y extraerlas resulta desafiante. Pero no te preocupes, llegaremos a eso.
Considera la siguiente reseña para entenderlo mejor:
"¡Me encanta esta película! Es sweet, pero con humor satírico. Los diálogos son geniales y las escenas de aventura son divertidas. Consigue ser romántica y fantasiosa mientras se ríe de las convenciones del género de cuento de hadas. Se la recomendaría a casi cualquiera. La he visto varias veces y siempre estoy feliz de verla de nuevo......."
Sí, sin duda es una reseña con sentimiento positivo sobre una película concreta. Pero, ¿cuáles son las palabras específicas que definen esa positividad?
Vuelve a mirarla:
"Me encanta esta película. Es sweet, pero con humor satírico. Los diálogos son geniales y las escenas de aventura son divertidas. Consigue ser romántica y fantasiosa mientras se ríe de las convenciones del género. La recomendaría a casi cualquiera. La he visto varias veces y siempre estoy feliz de verla de nuevo......."
Ahora se ve claro. Las palabras en negrita son las más importantes para construir el tono positivo del texto.
¿Qué hacemos con esas palabras? El siguiente paso natural es crear una representación como esta:

¿Qué hace esa representación? Ya lo habrás adivinado. Cada fila contiene una palabra y su frecuencia de aparición en el documento (llamémoslo documento a partir de ahora). Quizá te preguntes: "love" aparece una sola vez, ¿por qué la frecuencia es 2? Bien, esto es un fragmento de la reseña completa. Considera que la tabla corresponde a toda la reseña.
Al formular el problema de clasificación de sentimientos, has visto la representación de "bolsa de palabras" y lo anterior no es más que una representación bag-of-words. Es probablemente el concepto más fundamental en NLP y el primer paso para abordar cualquier problema de clasificación de texto. Asegúrate de entenderlo bien.
Una representación bag-of-words de un documento no solo contiene palabras concretas, sino todas las palabras únicas del documento y sus frecuencias de aparición. Aquí una bolsa es un conjunto matemático; por definición, no contiene duplicados.
Pero para esta aplicación solo te interesan las palabras en negrita mencionadas antes, así que la bolsa de palabras de este documento contendrá únicamente esas.
Los documentos no están escritos al azar, ¿verdad? El orden de las palabras importa en general. Pero en el contexto de clasificación de sentimientos, el orden no es tan relevante. Lo más importante aquí es la presencia de esas palabras.
Las palabras que has recopilado en la bolsa de palabras construirán ahora el conjunto de características de tu documento. Imagina que tienes una colección de muchas reseñas (documentos), has creado su bolsa de palabras y conservado sus etiquetas (sentimientos: + o - en este caso). Tu conjunto de entrenamiento tendría este aspecto:

A esta representación también se la conoce como corpus.
Este conjunto de entrenamiento es fácil de interpretar:
Cada fila es un vector de características independiente con información sobre un documento concreto (reseñas), las palabras específicas y su sentimiento. Ten en cuenta que la etiqueta sentiment suele denotarse como (+, -) o (+ve, -ve). Además, las características w1, w2, w3, ..., wn se generan a partir de una bolsa de palabras y no es necesario que todos los documentos contengan cada una de esas palabras.
Pasarás estos vectores al clasificador. Así que estudiemos el siguiente paso: el modelo de clasificación Naive Bayes para análisis de sentimientos.
La clasificación Naive Bayes no es más que aplicar la regla de Bayes para obtener probabilidades de clasificación. En esta sección verás el clasificador Naive Bayes en el contexto del análisis de sentimientos. Es muy recomendable tener una introducción previa a Naive Bayes y a la regla de Bayes. Algunos recursos:
Pero ¿por qué Naive Bayes en un mundo con k-NN, árboles de decisión y tantos otros? Lo verás más adelante.
Primero, construyamos la noción de los términos generales del clasificador Naive Bayes en este contexto. Empezamos mirando la regla de Bayes:

En este caso, la clase tiene dos posibles sentimientos: positivo y negativo.
Estudiemos cada término de la imagen con detalle.
Ahora, ¿qué son el Prior y la Verosimilitud (Likelihood)? Y el término P(d) (probabilidad de un documento); ¿tiene sentido? ¡Grandes preguntas! Vamos con las respuestas.
No son los detalles más finos todavía. Aguanta un poco más: irás descubriendo más. Recuerda que estamos construyendo la intuición para relacionar la regla de Bayes con la clasificación de sentimientos.
Entremos en más detalle para ver qué intenta hacer exactamente la regla de Bayes aquí. La siguiente imagen presenta pasos más detallados:

Hay muchos términos nuevos. Vayamos despacio.
Empecemos por el término de la derecha cMAP. Denota el objetivo principal aquí: encontrar la probabilidad/estimación posterior máxima de que un documento pertenezca a una clase concreta. MAP abrevia Max A Posteriori.
¿Qué es argmax? ¿Por qué no usar simplemente max?
argmax devuelve el índice. Supón que P(+|d) > P(-|d), donde + y - denotan sentimientos positivo y negativo respectivamente. P(+|d) y P(-|d) devuelven probabilidades, un valor numérico. Pero no te interesa el número, sino la clase para la que P(+|d) es mayor, y argmax devuelve eso. Para P(+|d) > P(-|d), argmax devolverá +.Y sí, puedes omitir el denominador P(d). Depende de la implementación.
Pero ¿cómo calculo $P(d|c)$ y $P(c)$? Aquí es donde resulta útil la bolsa de palabras. ¿Cómo?
¡Sigue leyendo!
Ya sabes convertir un documento a una bolsa de palabras. Más importante aún, puedes representarlo como un conjunto de características. Ahora, el término cMAP puede escribirse (ignorando el denominador P(d)) así:

Pero, ¿cómo calculamos realmente las probabilidades? Empecemos por $P(c)$.
P(c) responde básicamente a: "¿Con qué frecuencia aparece esta clase?" Imagina que tu dataset contiene un 60% de sentimientos positivos y un 40% de negativos. Entonces, $P(+) = 0.6$ y $P(-) = 0.4$.
Ahora, ¿cómo interpretas este término: P(x1, x2,...,xn | c)?
Piénsalo así: ¿cuál es la probabilidad de aparición de esas palabras (características) dada la clase c? Por ejemplo, tienes 1000 documentos y solo dos palabras en el corpus: "good" y "awesome". De esos 1000 documentos, 500 están etiquetados como positivos y los otros 500 como negativos. Además, descubres que, de los 500 positivos, 200 contienen "good" y "awesome" a la vez (nota que P(x1,x2) significa P(x1 y x2)). Entonces, la probabilidad P(good,awesome | +) = 200 / 1000 = 1/5.
Un punto importante: si tu vocabulario tiene tamaño $X$, puedes formular Xn probabilidades de verosimilitud (como P(good,awesome | +)) cuando tu documento contiene n palabras.
Recuerda que debes calcular las verosimilitudes para ambas clases. Así, el número total de combinaciones, en un escenario con 2000 palabras totales y documentos con 20 palabras de media, sería (2000)20. ¡Un número descomunal! ¿Y si el corpus está en millones (algo muy habitual en la práctica)?
A esto se le llama clasificador Bayesiano. Pero tal cual no funciona: los cómputos son demasiados. Ahora veremos las asunciones que convierten el clasificador Bayesiano en Naive Bayes.
Estas asunciones se conocen como suposiciones de independencia de Naive Bayes:
- Suposición de bolsa de palabras: la posición no importa. Supón que una palabra aparece en la posición 10 y en la 20; con esta suposición solo nos importa que su frecuencia sea 2. 10 y 20 son irrelevantes aquí.
- Suposición de independencia condicional: es la suposición clave que hace que Bayes sea Naive Bayes. Afirma que "suponemos las probabilidades de características P(xi|cj)". Fíjate: P(x1|cj), P(x2|cj), etc., son independientes entre sí. (No significa que P(x1), P(x2), etc., sean independientes entre sí). Entonces, el término P(x1, x2,...,xn | c) puede expresarse así: 
Naturalmente, las Xn combinaciones se reducen a Xn, que es exponencialmente menor (si tu vocabulario tiene tamaño $X$ y tu documento contiene n palabras). Definido matemáticamente, el clasificador Bayesiano, al reducirse a Naive Bayes, queda así:

Naive Bayes tiene dos ventajas:
Cuando se aplica a un problema de clasificación de texto, el mecanismo Naive Bayes se conoce como "Multinomial Naive Bayes".
Ahora ya entiendes bien la mecánica de Naive Bayes, especialmente para clasificación de sentimientos. Es el momento de implementar un clasificador.
¡Lo harás en Python! Vamos con el caso práctico.
Para este caso práctico, usarás un corpus de reseñas de películas offline cubierto en el libro de NLTK y que puedes descargar desde aquí. nltk proporciona una versión del dataset. El dataset categoriza cada reseña como positiva o negativa. Primero debes descargarlo así:
python -m nltk.downloader all
No se recomienda ejecutarlo desde Jupyter Notebook. Intenta lanzarlo desde la terminal (si usas Windows, desde el símbolo del sistema). Tardará un rato. Ten paciencia.
Para más información sobre los datasets de NLTK, visita este enlace.
Vas a implementar Naive Bayes, o mejor dicho Multinomial Naive Bayes, usando NLTK (Natural Language Toolkit). Es una librería dedicada a tareas de NLP y NLU, con muy buena documentación. Cubre muchas técnicas en profundidad y además ofrece datasets gratuitos para experimentar.
Esta es la web oficial de NLTK. Échale un vistazo: tiene tutoriales muy bien escritos sobre diferentes conceptos de NLP.
Cuando tengas todos los datos descargados, empieza importando el dataset de reseñas con from nltk.corpus import movie_reviews. Después, construye una lista de documentos etiquetados con sus categorías correspondientes.
# Load and prepare the dataset
import nltk
from nltk.corpus import movie_reviews
import random

documents = [(list(movie_reviews.words(fileid)), category)
              for category in movie_reviews.categories()
              for fileid in movie_reviews.fileids(category)]

random.shuffle(documents)
A continuación, define un extractor de características para que el clasificador sepa a qué aspectos de los datos debe prestar atención. "En este caso, puedes definir una característica por cada palabra, indicando si el documento contiene esa palabra. Para limitar el número de características que el clasificador debe procesar, empiezas construyendo una lista con las 2000 palabras más frecuentes del corpus" Fuente. Luego defines un extractor que simplemente comprueba si cada una de esas palabras está presente en un documento dado.
# Define the feature extractor

all_words = nltk.FreqDist(w.lower() for w in movie_reviews.words())
word_features = list(all_words)[:2000]

def document_features(document):
    document_words = set(document)
    features = {}
    for word in word_features:
        features['contains({})'.format(word)] = (word in document_words)
    return features
"La razón por la que calculaste el conjunto de todas las palabras de un documento document_words = set(document), en lugar de comprobar si la palabra está en el documento con una lista, es que comprobar si una palabra está en un conjunto es mucho más rápido que comprobar si está en una lista" - Fuente.
Ya tienes el extractor de características. Ahora puedes usarlo para entrenar un clasificador Naive Bayes que prediga el sentimiento de nuevas reseñas. Para evaluar su rendimiento, calcularemos la precisión sobre el conjunto de test. NLTK ofrece show_most_informative_features() para ver qué características han resultado más informativas.
# Train Naive Bayes classifier
featuresets = [(document_features(d), c) for (d,c) in documents]
train_set, test_set = featuresets[100:], featuresets[:100]
classifier = nltk.NaiveBayesClassifier.train(train_set)
# Test the classifier
print(nltk.classify.accuracy(classifier, test_set))
0.71
¡Genial! El clasificador logra una precisión del 71% sin ajustar parámetros ni hacer fine-tuning. Nada mal para empezar.
# Show the most important features as interpreted by Naive Bayes
classifier.show_most_informative_features(5)
Most Informative Features
       contains(winslet) = True              pos : neg    =      8.4 : 1.0
     contains(illogical) = True              neg : pos    =      7.6 : 1.0
      contains(captures) = True              pos : neg    =      7.0 : 1.0
        contains(turkey) = True              neg : pos    =      6.5 : 1.0
        contains(doubts) = True              pos : neg    =      5.8 : 1.0
"En el dataset, una reseña que menciona "Illogical" es casi 8 veces más probable que sea negativa que positiva, mientras que una que menciona "Captures" es alrededor de 6 veces más probable que sea positiva" - Fuente.
Ahora la pregunta: ¿por qué Naive Bayes?
La principal limitación de Naive Bayes es la asunción de predictores independientes. En la vida real, es casi imposible contar con un conjunto de predictores totalmente independientes.
El análisis de sentimientos resuelve varios problemas de negocio reales:
¡Enhorabuena! Has llegado hasta el final. NLP es un campo amplísimo e interesante que aborda problemas desafiantes. En particular, la intersección entre NLP y deep learning ha dado lugar a productos fantásticos. Ha revolucionado por completo la forma en que interactúan los chatbots. La lista es interminable.
Este tutorial, esperamos, te ha dado un buen impulso en una de las áreas principales del NLP: el análisis de sentimientos. Has visto uno de los temas más fundamentales del NLP, la bolsa de palabras, y luego has estudiado en detalle el clasificador Naive Bayes, examinando también sus limitaciones. Has usado nltk, una de las librerías de Python más populares para tareas de NLP y NLU. Has implementado un Naive Bayes sencillo con el corpus de películas que ofrece nltk. Date un aplauso: ¡te lo has ganado!
A continuación, algunos enlaces a recursos estupendos si quieres seguir más allá de este primer paso:
Se usaron las siguientes referencias para crear este tutorial:
Si te interesa aprender los fundamentos de NLP y aplicarlos a datasets del mundo real, puedes hacer el curso de DataCamp "Natural Language Processing Fundamentals in Python".
Cursos de Python
Curso
Curso
Curso
Tutorial
Moez Ali
13 min
Tutorial
Duong Vu
11 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Moez Ali
12 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Moez Ali
14 min