Curso
Feature Engineering para NLP em Python
4 h
29.6K
A promessa do machine learning já rendeu resultados impressionantes em diversas áreas. Processamento de linguagem natural (NLP) não é exceção — é um dos campos em que o machine learning conseguiu demonstrar sinais de inteligência artificial geral (não totalmente, mas ao menos em parte), alcançando feitos brilhantes em tarefas realmente complexas.
NLP (processamento de linguagem natural) não é um campo novo — e machine learning também não é. Mas a fusão das duas áreas é relativamente recente e só tende a avançar. É uma daquelas aplicações híbridas com as quais todo mundo (com um smartphone acessível) esbarra diariamente. Pense, por exemplo, em "sugestão de palavras no teclado" ou autocompletes inteligentes: tudo isso é fruto da união entre NLP e machine learning e, naturalmente, virou parte inseparável do nosso dia a dia.
Análise de sentimento é um tema essencial em NLP. Virou rapidamente um dos assuntos mais quentes da área por sua relevância e pela quantidade de problemas de negócio que resolve. Neste tutorial, você vai encarar esse tema nada trivial de um jeito simples. Vamos destrinchar a matemática por trás e estudar os conceitos. No fim, você também vai construir um classificador de sentimento simples. Especificamente, vamos ver:
Vamos nessa.
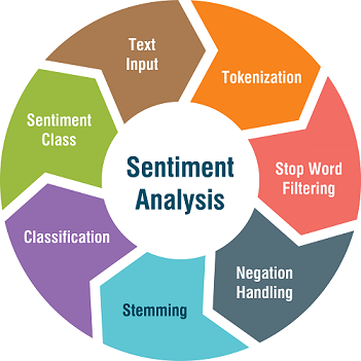
Em essência, análise/classificação de sentimento entra no guarda-chuva das tarefas de classificação de texto: você recebe uma frase ou uma lista de frases e o classificador deve dizer se o sentimento é positivo, negativo ou neutro. Às vezes, a terceira categoria é descartada para manter o problema binário. Em tarefas mais recentes, sentimentos como "levemente positivo" e "levemente negativo" também são considerados. Vamos a um exemplo.
Considere as frases a seguir:
As frases são resenhas curtas e cada uma expressa um sentimento diferente. A primeira indica sentimento positivo sobre o filme Titanic; a segunda, que o filme não é tão bom (sentimento negativo). Repare melhor na terceira: não há palavra que aponte claramente para um sentimento. É um exemplo de sentimento neutro.
Do ponto de vista estritamente de machine learning, essa tarefa é um caso de aprendizado supervisionado. Você fornece várias frases (com seus respectivos rótulos de sentimento) para o modelo e testa em frases sem rótulo.
Para apresentar a análise de sentimento isso já ajuda, mas para construir um classificador de fato você precisa de algo a mais. Vamos em frente.
 Fonte: SlideShare
Antes de entender o enunciado específico da classificação de sentimento, vale clarear o que é um problema geral de classificação de texto. Vamos defini-lo formalmente.
Aqui, o termo documento é amplo no contexto de classificação de texto. Documento pode ser tuítes, frases, trechos de notícias, notícias completas, um artigo, um manual de produto, um conto etc. A razão é a noção de palavra como entidade atômica e pequena. Para denotar sequências maiores de palavras, usa-se documento. Um tuíte é um documento curto; um artigo, um documento longo.
Assim, um conjunto de treinamento com n documentos rotulados fica: (d1,c1), (d2,c2),...,(dn,cn), e a saída final é um classificador aprendido.
Ótimo! Mas você deve estar se perguntando: onde entram as features (características) dos documentos? Ótima pergunta! Chegaremos lá já já.
Vamos seguir com a formulação do problema e construir, aos poucos, a intuição por trás da classificação de sentimento.
Um ponto crucial: nem todas as palavras de uma frase carregam o sentimento. Palavras como "eu", "são", "estou" etc. não contribuem para o sentimento e, portanto, não são relevantes no contexto de classificação de sentimento. Pense em seleção de features: você tenta encontrar os atributos mais relevantes em relação ao rótulo. Aqui é a mesma ideia. Só um punhado de palavras participa — identificá-las e extrai-las das frases é desafiador. Mas calma, chegaremos lá.
Considere a resenha abaixo para entender melhor:
"Eu amo este filme! É doce, mas com humor satírico. Os diálogos são ótimos e as cenas de aventura são divertidas. Consegue ser romântico e fantasioso enquanto faz graça com as convenções do gênero conto de fadas. Eu recomendaria para praticamente qualquer pessoa. Já vi várias vezes e sempre fico feliz em ver de novo......."
Sim, é claramente uma resenha com sentimento positivo. Mas quais palavras definem essa positividade?
Olhe novamente:
"Eu amo este filme! É doce, mas com humor satírico. Os diálogos são ótimos e as cenas de aventura são divertidas. Consegue ser romântico e fantasioso enquanto faz graça com as convenções do gênero conto de fadas. Eu recomendaria para praticamente qualquer pessoa. Já vi várias vezes e sempre fico feliz em ver de novo......."
Agora deu para ver: as palavras em negrito são as que constroem o caráter positivo do texto.
O que fazer com essas palavras? O passo natural é criar uma representação como a seguir:

O que essa representação faz? Cada linha contém uma palavra e sua frequência de ocorrência no documento (vamos chamá-lo de documento daqui em diante). Você pode notar que "amo" apareceu só uma vez no trecho, mas a frequência está 2 — considere que a tabela refere-se à resenha completa.
Ao formular o problema, você esbarrou na representação de "saco de palavras" — o famoso Bag-of-Words. É um dos conceitos mais básicos em NLP e costuma ser o primeiro passo em qualquer classificação de texto. Vale dominar bem.
Uma representação bag-of-words de um documento não contém apenas palavras específicas, mas todas as palavras únicas do documento e suas frequências. Aqui, "saco" é um conjunto matemático; portanto, por definição, não há duplicatas.
Mas, para esta aplicação, nos interessam apenas as palavras em negrito citadas antes; então o bag-of-words para este documento conterá somente essas.
Documentos não são escritos de forma embaralhada, certo? A ordem das palavras importa. Porém, no contexto de classificação de sentimento, a sequência não é tão relevante. O mais importante é a presença dessas palavras.
As palavras que você encontrou no bag-of-words formam agora o conjunto de features do documento. Suponha que você tem uma coleção de várias resenhas (documentos), criou o bag-of-words de cada uma e preservou seus rótulos (sentimentos — + ou - neste caso). Seu conjunto de treinamento ficaria assim:

Essa representação também é chamada de corpus.
O conjunto de treinamento é fácil de interpretar:
Cada linha é um vetor de features independente com informações sobre um documento (resenha), as palavras específicas e o sentimento. Note que o rótulo sentimento costuma ser denotado como (+, -) ou (+ve, -ve). Também, as features w1, w2, w3, ..., wn são geradas a partir do bag-of-words, e não é necessário que todos os documentos contenham todas as palavras/features.
Você passará esses vetores ao classificador. Vamos estudar o modelo — Naive Bayes para classificação de sentimento.
Naive Bayes nada mais é do que aplicar a regra de Bayes para formar probabilidades de classificação. Nesta seção, veremos o classificador Naive Bayes no contexto de análise de sentimento. É altamente recomendado ter uma introdução a Naive Bayes e à regra de Bayes. Alguns recursos:
Mas por que Naive Bayes num mundo com k-NN, Árvores de Decisão e tantos outros? Já chegamos lá.
Vamos primeiro construir a noção dos termos gerais do Naive Bayes no contexto de sentimento. Comece olhando a regra de Bayes:

Neste caso, a classe tem dois sentimentos: positivo e negativo.
Vamos destrinchar cada termo da imagem nesse contexto.
E o que são Prior e Likelihood? E o termo P(d) (probabilidade de um documento) — faz sentido? Ótimas perguntas! Vamos às respostas.
Até aqui, nada super profundo — mas segure firme. Vamos conectar a regra de Bayes ao contexto de classificação de sentimento.
Veja agora passos mais detalhados da regra de Bayes:

Muitos termos novos. Vamos com calma.
Comece pelo termo da direita cMAP. Ele indica o objetivo principal aqui: encontrar a estimativa de máxima probabilidade pósterior de que um documento pertença a uma classe. MAP significa Max A Posteriori.
O que é argmax? Por que não só max?
argmax retorna o índice/arg que maximiza a expressão. Suponha P(+|d) > P(-|d), onde + e - são sentimentos positivo e negativo. P(+|d), P(-|d) são probabilidades (números). Você não quer o número em si, quer a classe para a qual a probabilidade é maior — argmax retorna isso. Para P(+|d) > P(-|d), argmax devolve +.E sim, você pode descartar o denominador P(d). Depende da implementação.
Mas como encontrar $P(d|c)$ e $P(c)$? É aqui que o bag of words ajuda. Como?
Continue lendo!
Você já sabe converter um documento para bag-of-words. Mais importante: consegue representá-lo como um conjunto de features. Assim, o termo cMAP pode ser reescrito (ignorando P(d)):

Mas como calcular as probabilidades? Comecemos por $P(c)$.
P(c) responde: "Com que frequência essa classe ocorre?" Se seu conjunto tiver 60% de sentimentos positivos e 40% de negativos, então $P(+) = 0.6$ e $P(-) = 0.4$.
E como interpretar P(x1, x2,...,xn | c)?
Pense assim: qual a probabilidade de ocorrência dessas palavras (features) dado a classe c. Ex.: você tem 1000 documentos e só duas palavras no corpus — "bom" e "incrível". Desses, 500 são positivos e 500 negativos. Você descobriu que, dos 500 positivos, 200 contêm as duas palavras (note P(x1,x2) = P(x1 e x2)). Então P(bom,incrível | +) = 200 / 1000 = 1/5.
Importante: se o vocabulário tem tamanho $X$, você pode formular Xn probabilidades de likelihood (como P(bom,incrível | +)) para um documento com n palavras.
Lembre que você precisa calcular as likelihoods para ambas as classes. Se há 2000 palavras no vocabulário e cada documento tem em média 20 palavras, o total de combinações é (2000)20. Um número absurdamente grande! E se o corpus tiver milhões de palavras (o que é comum na prática)?
Isso é o classificador de Bayes. Mas, assim, é inviável computacionalmente. Agora vamos estudar as suposições que o tornam um Naive Bayes.
As suposições são chamadas de hipóteses de independência do Naive Bayes:
- Hipótese do bag-of-words: a posição não importa. Se uma palavra aparece na 10ª e na 20ª posição, o que interessa é a frequência total (=2). As posições 10 e 20 são irrelevantes.
- Hipótese de independência condicional: é a hipótese que torna o classificador de Bayes em Naive Bayes. Ela afirma que "assumimos probabilidades de features P(xi|cj)" independentes entre si. Ou seja, P(x1|cj), P(x2|cj) etc. são independentes umas das outras. (Não quer dizer que P(x1), P(x2) etc. sejam independentes.) Assim, P(x1, x2,...,xn | c) pode ser expressa como: 
Naturalmente, as Xn combinações se reduzem a Xn, o que é exponencialmente menor (se o vocabulário tem tamanho $X$ e o documento tem n palavras). Matematicamente, o classificador de Bayes reduzido a Naive Bayes fica assim:

Dois benefícios do Naive Bayes:
Quando aplicado à classificação de texto, o mecanismo Naive Bayes é conhecido como "Multinomial Naive Bayes".
Agora que você entende a mecânica do Naive Bayes para sentimento, é hora de implementar um classificador.
Vamos fazer isso em Python! Bora para o estudo de caso.
Neste estudo de caso, você usará um corpus off-line de resenhas de filmes, como no livro do NLTK, que pode ser baixado aqui. O nltk fornece uma versão do dataset, que rotula cada resenha como positiva ou negativa. Baixe-o assim:
python -m nltk.downloader all
Não é recomendado rodar a partir do Jupyter Notebook. Tente pelo terminal/Prompt de Comando (no Windows). Vai levar um tempo — tenha paciência.
Para mais informações sobre datasets do NLTK, visite este link.
Você vai implementar Naive Bayes — mais precisamente Multinomial Naive Bayes — usando o NLTK (Natural Language Toolkit). É uma biblioteca dedicada a tarefas de NLP e NLU, com ótima documentação. Cobre várias técnicas e ainda oferece datasets gratuitos para experimentos.
Este é o site oficial do NLTK. Vale conferir: há tutoriais muito bem escritos sobre diversos conceitos de NLP.
Depois de baixar os dados, importe o dataset de resenhas com from nltk.corpus import movie_reviews. Em seguida, construa uma lista de documentos rotulados com as categorias adequadas.
# Load and prepare the dataset
import nltk
from nltk.corpus import movie_reviews
import random

documents = [(list(movie_reviews.words(fileid)), category)
              for category in movie_reviews.categories()
              for fileid in movie_reviews.fileids(category)]

random.shuffle(documents)
Depois, defina um extrator de features para que o classificador saiba em que aspectos dos dados prestar atenção. "Neste caso, você pode definir uma feature para cada palavra, indicando se o documento contém aquela palavra. Para limitar o número de features a processar, começamos construindo uma lista das 2000 palavras mais frequentes no corpus" Fonte. Em seguida, definimos um extrator que apenas verifica se cada uma dessas palavras está presente em um documento.
# Define the feature extractor

all_words = nltk.FreqDist(w.lower() for w in movie_reviews.words())
word_features = list(all_words)[:2000]

def document_features(document):
    document_words = set(document)
    features = {}
    for word in word_features:
        features['contains({})'.format(word)] = (word in document_words)
    return features
"O motivo de calcular o conjunto de palavras do documento com document_words = set(document), em vez de checar direto numa lista, é que verificar se uma palavra está em um conjunto é muito mais rápido do que em uma lista" — Fonte.
Com o extrator definido, você pode treinar um classificador Naive Bayes para prever o sentimento de novas resenhas. Para avaliar o desempenho, calcule a acurácia no conjunto de teste. O NLTK oferece show_most_informative_features() para ver quais features foram mais informativas.
# Train Naive Bayes classifier
featuresets = [(document_features(d), c) for (d,c) in documents]
train_set, test_set = featuresets[100:], featuresets[:100]
classifier = nltk.NaiveBayesClassifier.train(train_set)
# Test the classifier
print(nltk.classify.accuracy(classifier, test_set))
0.71
Uau! O classificador atingiu 71% de acurácia sem nenhum ajuste fino. Excelente para a primeira rodada!
# Show the most important features as interpreted by Naive Bayes
classifier.show_most_informative_features(5)
Most Informative Features
       contains(winslet) = True              pos : neg    =      8.4 : 1.0
     contains(illogical) = True              neg : pos    =      7.6 : 1.0
      contains(captures) = True              pos : neg    =      7.0 : 1.0
        contains(turkey) = True              neg : pos    =      6.5 : 1.0
        contains(doubts) = True              pos : neg    =      5.8 : 1.0
"No dataset, uma resenha que menciona "Illogical" é quase 8 vezes mais provável de ser negativa do que positiva, enquanto uma resenha que menciona "Captures" é cerca de 6 vezes mais provável de ser positiva" — Fonte.
Agora a pergunta: por que Naive Bayes?
A principal limitação é a hipótese de preditores independentes. Na vida real, é raro encontrar um conjunto de preditores totalmente independentes.
A análise de sentimento resolve vários problemas reais de negócio:
Parabéns! Você chegou ao fim. NLP é um campo vasto e fascinante, que resolve problemas desafiadores. Em especial, a interseção entre NLP e Deep Learning deu origem a produtos incríveis e revolucionou a interação de chatbots. A lista é longa.
Este tutorial deve ter dado um pontapé inicial em uma das subáreas centrais de NLP: análise de sentimento. Vimos um dos tópicos mais fundamentais — Bag-of-Words — e estudamos o classificador Naive Bayes em detalhes, incluindo limitações. Usamos o nltk, uma das bibliotecas Python mais populares para NLP e NLU, e implementamos um Naive Bayes simples com o corpus de filmes do nltk. Aplausos para você — mandou bem!
A seguir, alguns links excelentes para continuar além deste começo:
Referências usadas para criar este tutorial:
Se você quer aprender os fundamentos de NLP e aplicar em dados do mundo real, faça o curso da DataCamp "Natural Language Processing Fundamentals in Python".
Cursos de Python
Curso
Curso
Curso
Tutorial
Moez Ali
13 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Moez Ali
12 min
Tutorial
Moez Ali
14 min
Tutorial
Avinash Navlani
10 min
Tutorial
Sejal Jaiswal
9 min




