
Kursus
Proyek SOLAR-10.7B merepresentasikan lompatan besar dalam pengembangan model bahasa besar, memperkenalkan pendekatan baru untuk melakukan scaling model secara efektif dan efisien.
Artikel ini dimulai dengan menjelaskan apa itu model SOLAR-10.7B sebelum menyoroti performanya dibandingkan model bahasa besar lainnya dan membahas proses penggunaan versi khusus yang telah di-fine-tune. Terakhir, pembaca akan memahami potensi aplikasi model fine-tuned SOLAR-10.7B-Instruct beserta keterbatasannya.
Apa itu SOLAR-10.7B?
SOLAR-10.7B adalah model dengan 10,7 miliar parameter yang dikembangkan oleh tim di Upstage AI di Korea Selatan.
Berdasarkan arsitektur Llama-2, model ini melampaui model bahasa besar lain dengan hingga 30 miliar parameter, termasuk model Mixtral 8X7B.
Untuk mempelajari lebih lanjut tentang Llama-2, artikel kami Fine-Tuning LLaMA 2: Panduan Langkah demi Langkah untuk Menyesuaikan Large Language Model menyediakan panduan langkah demi langkah untuk melakukan fine-tune Llama-2, menggunakan pendekatan baru untuk mengatasi keterbatasan memori dan komputasi demi akses yang lebih baik ke model bahasa besar open-source.
Lebih jauh, dibangun di atas fondasi SOLAR-10.7B yang tangguh, model SOLAR 10.7B-Instruct di-fine-tune dengan penekanan pada kemampuan mengikuti instruksi yang kompleks. Varian ini menunjukkan peningkatan performa, menampilkan kemampuan adaptasi model dan efektivitas fine-tuning dalam mencapai tujuan yang terspesialisasi.
Terakhir, SOLAR-10.7B memperkenalkan metode bernama Depth Up-Scaling, dan mari kita telusuri lebih jauh pada bagian berikut.
Metode Depth Up-Scaling
Metode inovatif ini memungkinkan perluasan kedalaman jaringan saraf model tanpa memerlukan peningkatan sumber daya komputasi yang sepadan. Strategi semacam ini meningkatkan efisiensi sekaligus performa model secara keseluruhan.
Elemen esensial Depth Up-Scaling
Depth Up-Scaling didasarkan pada tiga komponen utama: (1) bobot Mistral 7B, (2) kerangka Llama 2, dan (3) pra-pelatihan berkelanjutan.
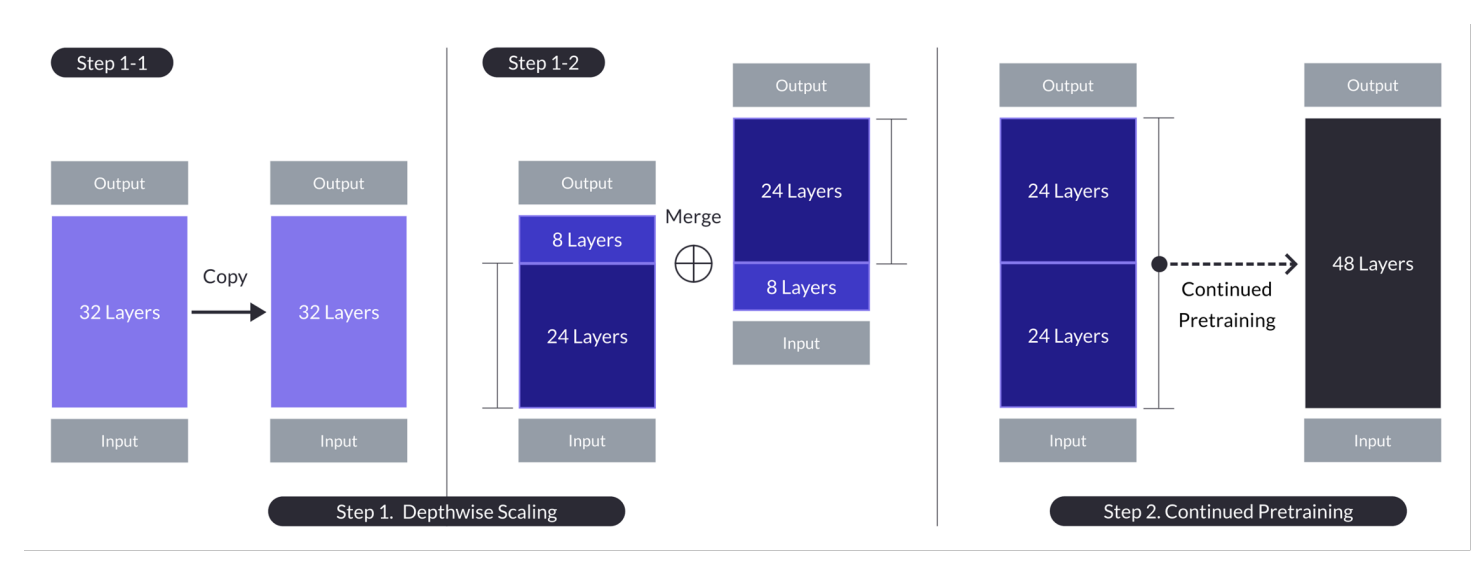
Depth up-scaling untuk kasus n = 32, s = 48, dan m = 8. Depth up-scaling dicapai melalui proses dua tahap berupa peng-skalaan kedalaman yang diikuti dengan pra-pelatihan lanjutan. (Sumber)
Model Dasar:
- Menggunakan arsitektur transformer 32 lapis, khususnya model Llama 2, yang diinisialisasi dengan bobot pra-latih dari Mistral 7B.
- Dipilih karena kompatibilitas dan performanya, dengan tujuan memanfaatkan sumber daya komunitas dan memperkenalkan modifikasi baru untuk meningkatkan kapabilitas.
- Menjadi fondasi untuk peng-skalaan kedalaman dan pra-pelatihan lebih lanjut agar dapat di-scale secara efisien.
Depthwise Scaling:
- Melakukan skala pada model dasar dengan menetapkan jumlah lapisan target untuk model yang di-scale, dengan mempertimbangkan kapabilitas perangkat keras.
- Melibatkan duplikasi model dasar, menghapus m lapisan terakhir dari model asli dan m lapisan awal dari duplikasi, lalu menggabungkannya untuk membentuk model dengan s lapisan.
- Proses ini menciptakan model yang di-scale dengan jumlah lapisan yang disesuaikan agar berada di antara 7 dan 13 miliar parameter, secara spesifik menggunakan basis n=32 lapisan, menghapus m=8 lapisan untuk mencapai s=48 lapisan.
Pra-Pelatihan Berkelanjutan:
- Menangani penurunan performa awal setelah depthwise scaling dengan melanjutkan pra-pelatihan pada model yang di-scale.
- Pemulihan performa yang cepat diamati selama pra-pelatihan lanjutan, yang diatribusikan pada berkurangnya heterogenitas dan ketidaksesuaian dalam model.
- Pra-pelatihan berkelanjutan sangat penting untuk memulihkan dan berpotensi melampaui performa model dasar, dengan memanfaatkan arsitektur model hasil depthwise scaling untuk pembelajaran yang efektif.
Ringkasan ini menyoroti strategi dan hasil utama dari pendekatan Depth Up-Scaling, dengan fokus pada pemanfaatan model yang ada, skala melalui penyesuaian kedalaman, serta peningkatan performa melalui pra-pelatihan berkelanjutan.
Pendekatan multifaset ini membuat SOLAR-10.7B mampu, dan dalam banyak kasus, melampaui kapabilitas model yang jauh lebih besar. Efisiensi ini menjadikannya pilihan utama untuk berbagai aplikasi spesifik, menampilkan kekuatan dan fleksibilitasnya.
Bagaimana Cara Kerja Model SOLAR 10.7B Instruct?
SOLAR-10.7B Instruct unggul dalam menafsirkan dan mengeksekusi instruksi kompleks, sehingga sangat berharga dalam skenario di mana pemahaman yang presisi dan respons terhadap perintah manusia sangat krusial. Kapabilitas ini penting untuk mengembangkan sistem AI yang lebih intuitif dan interaktif.
- SOLAR 10.7B Instruct merupakan hasil fine-tuning dari model SOLAR 10.7B asli agar dapat mengikuti instruksi dalam format QA.
- Fine-tuning terutama menggunakan dataset open-source bersama dataset QA matematika sintetis untuk meningkatkan kemampuan matematis model.
- Versi pertama SOLAR 10.7B Instruct dibuat dengan mengintegrasikan bobot Mistral 7B untuk memperkuat kemampuan belajarnya dalam memproses informasi secara efektif dan efisien.
- Tulang punggung SOLAR 10.7B adalah arsitektur Llama2, yang memberikan perpaduan kecepatan dan akurasi.
Secara keseluruhan, pentingnya model SOLAR-10.7B yang telah di-fine-tune terletak pada peningkatan performa, kemampuan beradaptasi, dan potensinya untuk aplikasi luas, mendorong kemajuan di bidang pemrosesan bahasa alami dan kecerdasan buatan.
Potensi Aplikasi Model Fine-Tuned SOLAR-10.7B
Sebelum masuk ke implementasi teknis, mari jelajahi beberapa potensi aplikasi dari model SOLAR-10.7B yang telah di-fine-tune.
Di bawah ini adalah beberapa contoh pembelajaran dan bimbingan yang dipersonalisasi, dukungan pelanggan yang ditingkatkan, serta pembuatan konten otomatis.
- Pendidikan dan bimbingan belajar yang dipersonalisasi: SOLAR-10.7B-Instruct dapat merevolusi sektor pendidikan dengan menyediakan pengalaman belajar yang dipersonalisasi. Model ini dapat memahami pertanyaan siswa yang kompleks, menawarkan penjelasan, sumber daya, dan latihan yang disesuaikan. Kapabilitas ini menjadikannya alat ideal untuk mengembangkan sistem tutor cerdas yang beradaptasi dengan gaya dan kebutuhan belajar individu, meningkatkan keterlibatan dan hasil belajar siswa.
- Dukungan pelanggan yang lebih baik: SOLAR-10.7B-Instruct dapat menggerakkan chatbot dan asisten virtual tingkat lanjut yang mampu memahami dan menyelesaikan pertanyaan pelanggan yang kompleks dengan akurasi tinggi. Aplikasi ini tidak hanya meningkatkan pengalaman pelanggan dengan memberikan dukungan yang tepat waktu dan relevan, tetapi juga mengurangi beban kerja perwakilan layanan pelanggan manusia dengan mengotomatiskan pertanyaan rutin.
- Pembuatan dan peringkasan konten otomatis: Bagi media dan pembuat konten, SOLAR-10.7B-Instruct menawarkan kemampuan untuk mengotomatisasi pembuatan konten tertulis, seperti artikel berita, laporan, dan karya kreatif. Selain itu, model ini dapat meringkas dokumen yang ekstensif menjadi format yang ringkas dan mudah dipahami, sehingga sangat berharga bagi jurnalis, peneliti, dan profesional yang perlu dengan cepat menyerap dan melaporkan sejumlah besar informasi.
Contoh-contoh ini menegaskan fleksibilitas dan potensi SOLAR-10.7B-Instruct untuk berdampak dan meningkatkan efisiensi, aksesibilitas, serta pengalaman pengguna di berbagai industri.
Panduan Langkah demi Langkah Menggunakan SOLAR-10.7B Instruct
Kita sudah memiliki latar belakang yang cukup tentang model SOLAR-10.7B, dan kini saatnya mempraktikkannya.
Bagian ini bertujuan memberikan semua instruksi untuk menjalankan model SOLAR 10.7 Instruct v1.0 - GGUF dari upstage.
Kodenya terinspirasi oleh dokumentasi resmi di Hugging Face. Langkah utama didefinisikan di bawah ini:
- Instal dan impor pustaka yang diperlukan
- Tentukan model SOLAR-10.7B yang akan digunakan dari Hugging Face
- Jalankan inferensi model
- Hasilkan keluaran dari permintaan pengguna
Instalasi Pustaka
Pustaka utama yang digunakan adalah transformers dan accelerate.
- Pustaka transformers menyediakan akses ke model pra-latih, dan versi yang ditentukan di sini adalah 4.35.2.
- Pustaka accelerate dirancang untuk menyederhanakan menjalankan model pembelajaran mesin pada perangkat keras yang berbeda (CPU, GPU) tanpa harus memahami detail perangkat keras secara mendalam.
%%bash
pip -q install transformers==4.35.2
pip -q install accelerate
Impor Pustaka
Setelah instalasi selesai, kita lanjut dengan mengimpor pustaka-pustaka berikut yang diperlukan:
- torch adalah pustaka PyTorch, pustaka pembelajaran mesin open-source populer yang digunakan untuk aplikasi seperti visi komputer dan NLP.
- AutoModelForCausalLM digunakan untuk memuat model pra-latih untuk causal language modeling, dan AutoTokenizer bertugas mengonversi teks ke format yang dapat dipahami model (tokenisasi).
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
Konfigurasi GPU
Model yang digunakan adalah versi 1 dari model SOLAR-10.7B di Hugging Face.
Sumber daya GPU diperlukan untuk mempercepat proses pemuatan dan inferensi model.
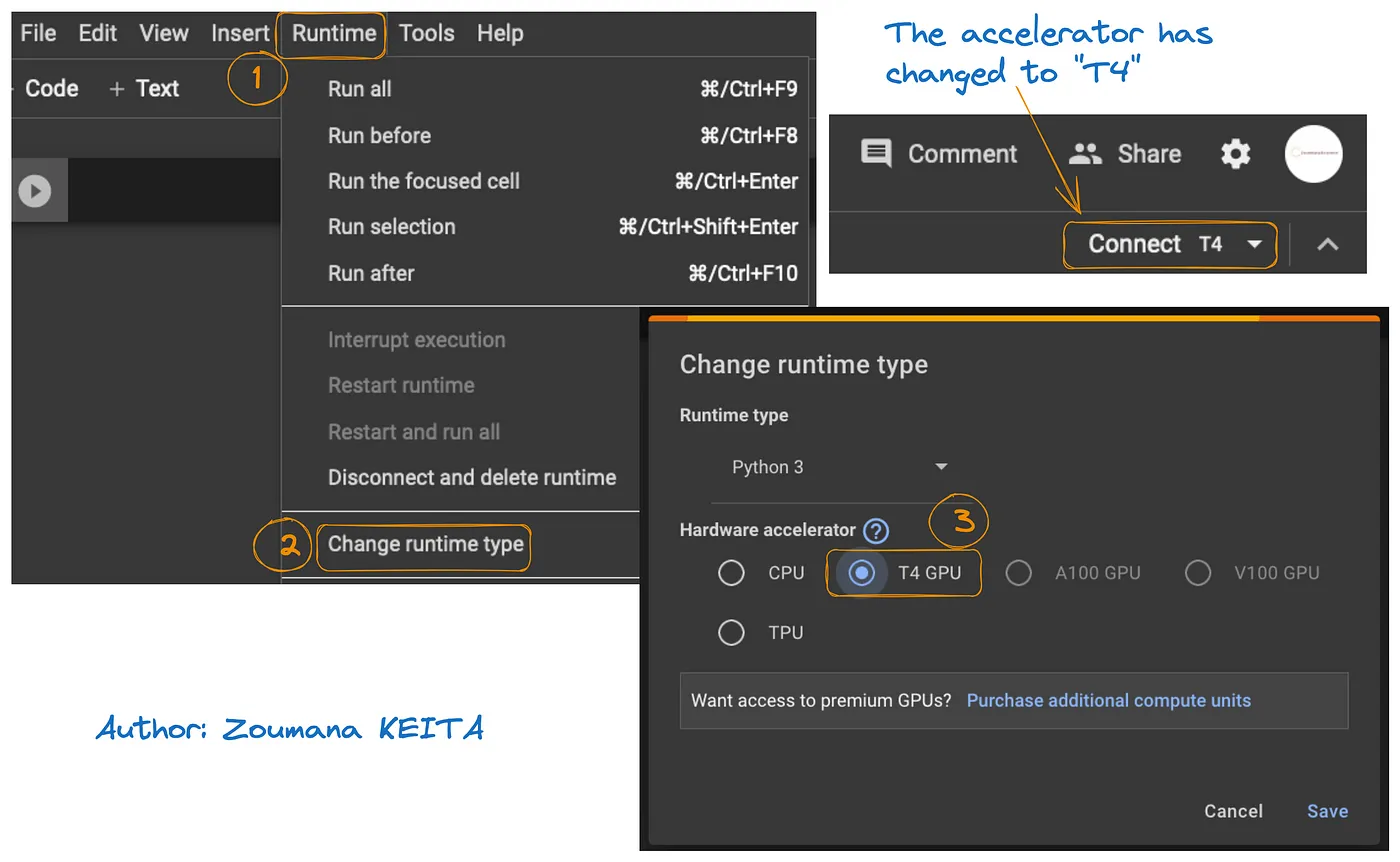
Akses ke GPU di Google Colab diilustrasikan pada gambar di bawah:
- Dari tab Runtime, pilih Change runtime
- Kemudian, pilih T4 GPU pada bagian Hardware accelerator dan Save perubahannya
Ini akan mengalihkan runtime default ke T4:
Kita dapat memeriksa properti runtime dengan menjalankan perintah berikut dari notebook Colab.
!nvidia-smi
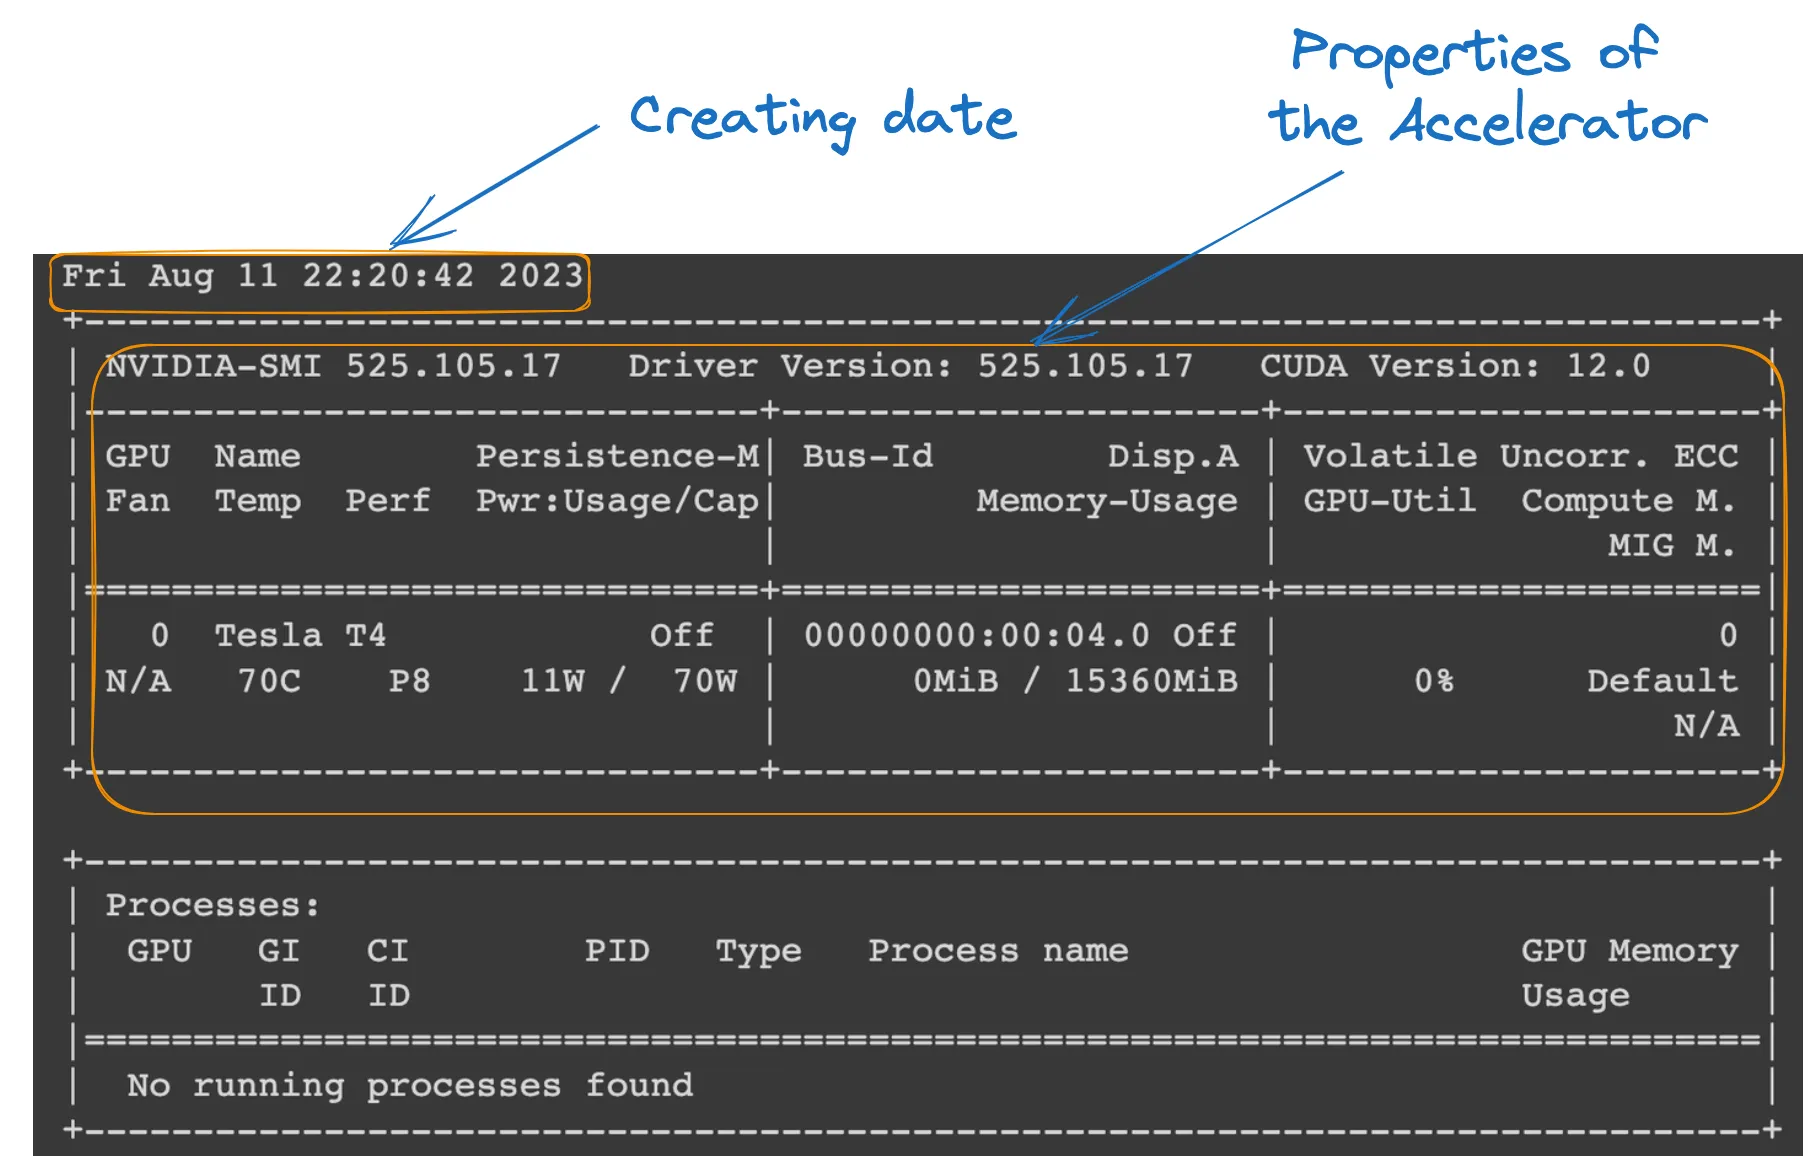
Properti GPU
Definisi model
Semua sudah siap; kita dapat melanjutkan dengan memuat model sebagai berikut:
model_ID = "Upstage/SOLAR-10.7B-Instruct-v1.0"
tokenizer = AutoTokenizer.from_pretrained(model_ID)
model = AutoModelForCausalLM.from_pretrained(
model_ID,
device_map="auto",
torch_dtype=torch.float16,
)
- model_ID adalah string yang secara unik mengidentifikasi model pra-latih yang ingin kita gunakan. Dalam hal ini, ditentukan "Upstage/SOLAR-10.7B-Instruct-v1.0".
- AutoTokenizer.from_pretrained(model_ID) memuat tokenizer yang dipra-latih pada model_ID yang ditentukan, menyiapkannya untuk memproses masukan teks.
- AutoModelForCausalLM.from_pretrained() memuat model causal language itu sendiri, dengan device_map="auto" untuk secara otomatis menggunakan perangkat keras terbaik yang tersedia (GPU yang telah kita siapkan), dan torch_dtype=torch.float16 untuk menggunakan bilangan floating-point 16-bit guna menghemat memori dan berpotensi mempercepat komputasi.
Inferensi model
Sebelum menghasilkan respons, teks masukan (permintaan pengguna) diformat dan ditokenisasi.
- user_request berisi pertanyaan atau masukan untuk model.
- conversation memformat masukan sebagai bagian dari percakapan, memberi tag peran (misalnya, 'user').
- apply_chat_template menerapkan templat percakapan pada masukan, menyiapkannya untuk model dalam format yang dipahaminya.
- tokenizer(prompt, return_tensors="pt") mengonversi prompt menjadi token dan menentukan jenis tensor ("pt" untuk tensor PyTorch), dan .to(model.device) memastikan masukan berada pada perangkat yang sama (CPU atau GPU) dengan model.
user_request = "What is the square root of 24?"
conversation = [ {'role': 'user', 'content': user_request} ]
prompt = tokenizer.apply_chat_template(conversation, tokenize=False, add_generation_prompt=True)
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
Pembuatan hasil
Bagian terakhir menggunakan model untuk menghasilkan respons atas pertanyaan masukan lalu mendekode dan mencetak teks yang dihasilkan.
- model.generate() menghasilkan teks berdasarkan masukan yang diberikan, dengan use_cache=True untuk mempercepat generasi dengan menggunakan kembali hasil komputasi sebelumnya. max_length=4096 membatasi panjang maksimum teks yang dihasilkan.
- tokenizer.decode(outputs[0]) mengonversi token yang dihasilkan kembali menjadi teks yang dapat dibaca manusia.
- Pernyataan print menampilkan jawaban yang dihasilkan atas pertanyaan pengguna.
outputs = model.generate(**inputs, use_cache=True, max_length=4096)
output_text = tokenizer.decode(outputs[0])
print(output_text)
Eksekusi kode di atas yang berhasil akan menghasilkan keluaran berikut:

Dengan mengganti permintaan pengguna dengan teks berikut, kita mendapatkan respons yang dihasilkan
user_request = "Tell me a story about the universe"

Keterbatasan model SOLAR-10.7B
Terlepas dari semua keunggulan SOLAR-10.7B, model ini memiliki keterbatasannya sendiri seperti model bahasa besar lainnya, dan yang utama disoroti di bawah ini:
- Eksplorasi hiperparameter yang mendalam: kebutuhan eksplorasi hiperparameter model yang lebih mendalam selama Depth Up-Scaling (DUS) merupakan keterbatasan kunci. Hal ini menyebabkan penghapusan 8 lapisan dari model dasar karena keterbatasan perangkat keras.
- Menuntut secara komputasi: model ini sangat menuntut sumber daya komputasi, dan hal ini membatasi penggunaannya oleh individu dan organisasi dengan kapabilitas komputasi lebih rendah.
- Kerentanan terhadap bias: potensi bias dalam data pelatihan dapat berdampak pada performa model untuk beberapa kasus penggunaan.
- Kekhawatiran lingkungan: pelatihan dan inferensi model memerlukan konsumsi energi yang signifikan, yang dapat menimbulkan kekhawatiran lingkungan.
Kesimpulan
Artikel ini telah membahas model SOLAR-10.7B, menyoroti kontribusinya terhadap kecerdasan buatan melalui pendekatan depth up-scaling. Artikel ini telah menguraikan cara kerja dan potensi aplikasinya, serta menyediakan panduan praktis untuk penggunaannya, mulai dari instalasi hingga menghasilkan keluaran.
Terlepas dari kapabilitasnya, artikel ini juga membahas keterbatasan model SOLAR-10.7B, sehingga memberikan perspektif yang seimbang bagi pengguna. Seiring AI terus berkembang, SOLAR-10.7B menjadi contoh kemajuan menuju alat AI yang lebih mudah diakses dan serbaguna.
Bagi Anda yang ingin menggali lebih dalam potensi AI, tutorial kami, Tutorial FLAN-T5: Panduan dan Fine-Tuning, menawarkan panduan lengkap untuk melakukan fine-tune model FLAN-T5 untuk tugas tanya jawab menggunakan pustaka transformers dan menjalankan inferensi yang dioptimalkan dalam skenario dunia nyata. Anda juga dapat menemukan tutorial Fine-Tuning GPT-3.5 kami dan sesi code-along tentang fine-tuning model LlaMA 2 Anda sendiri.
Seorang data scientist serbabisa yang senang berbagi pengetahuan dan memberi dampak bagi orang lain, Zoumana adalah pembuat konten di YouTube dan penulis teknologi teratas di Medium. Ia menikmati berbicara di depan umum, ngoding, dan mengajar. Zoumana meraih dua gelar magister: yang pertama di bidang ilmu komputer dengan fokus Machine Learning di Paris, Prancis, dan yang kedua di bidang Data Science dari Texas Tech University di AS. Kariernya dimulai sebagai Pengembang Perangkat Lunak di Groupe OPEN, Prancis, lalu bergabung dengan IBM sebagai Konsultan Machine Learning, di mana ia mengembangkan solusi AI end-to-end untuk perusahaan asuransi. Zoumana kemudian bergabung dengan Axionable, startup AI Berkelanjutan pertama yang berbasis di Paris dan Montreal. Di sana, ia berperan sebagai Data Scientist dan mengimplementasikan produk AI, terutama use case NLP, untuk klien dari Prancis, Montreal, Singapura, dan Swiss. Selain itu, 5% dari waktunya didedikasikan untuk Riset dan Pengembangan. Saat ini, ia bekerja sebagai Senior Data Scientist di IFC - World Bank Group.

