
Kurs
Das Projekt SOLAR-10.7B ist ein großer Schritt nach vorn in der Entwicklung großer Sprachmodelle und stellt einen neuen Ansatz vor, um diese Modelle wirksam und effizient zu skalieren.
Dieser Artikel erklärt zunächst, was das SOLAR-10.7B-Modell ist, vergleicht anschließend seine Leistungsfähigkeit mit anderen großen Sprachmodellen und zeigt Schritt für Schritt, wie die spezialisierte Fine-Tuning-Variante eingesetzt wird. Am Ende verstehst du die möglichen Einsatzszenarien des feinabgestimmten SOLAR-10.7B-Instruct-Modells und seine Grenzen.
Was ist SOLAR-10.7B?
SOLAR-10.7B ist ein Modell mit 10,7 Milliarden Parametern, entwickelt von einem Team bei Upstage AI in Südkorea.
Es basiert auf der Llama-2-Architektur und übertrifft andere große Sprachmodelle mit bis zu 30 Milliarden Parametern, darunter das Mixtral 8x7B.
Wenn du mehr zu Llama-2 erfahren möchtest, findest du in unserem Artikel Fine-Tuning LLaMA 2: A Step-by-Step Guide to Customizing the Large Language Model eine Schritt-für-Schritt-Anleitung zum Fine-Tuning von Llama-2 mit neuen Ansätzen, die Speicher- und Rechenlimitierungen umgehen, um besseren Zugang zu Open-Source-Sprachmodellen zu schaffen.
Aufbauend auf dem robusten Fundament von SOLAR-10.7B wurde das SOLAR-10.7B-Instruct-Modell mit Fokus auf das Befolgen komplexer Anweisungen feinabgestimmt. Diese Variante zeigt eine verbesserte Performance, unterstreicht die Anpassungsfähigkeit des Modells und belegt, wie wirksam Fine-Tuning für spezialisierte Ziele ist.
Zudem führt SOLAR-10.7B eine Methode namens Depth Up-Scaling ein. Schauen wir uns das im nächsten Abschnitt genauer an.
Die Depth-Up-Scaling-Methode
Diese innovative Methode erweitert die Tiefe des neuronalen Netzes, ohne die benötigten Rechenressourcen im gleichen Maße zu erhöhen. So steigt die Effizienz ebenso wie die Gesamtleistung des Modells.
Zentrale Elemente von Depth Up-Scaling
Depth Up-Scaling basiert auf drei Hauptkomponenten: (1) Mistral-7B-Gewichte, (2) Llama-2-Framework und (3) kontinuierliches Pretraining.
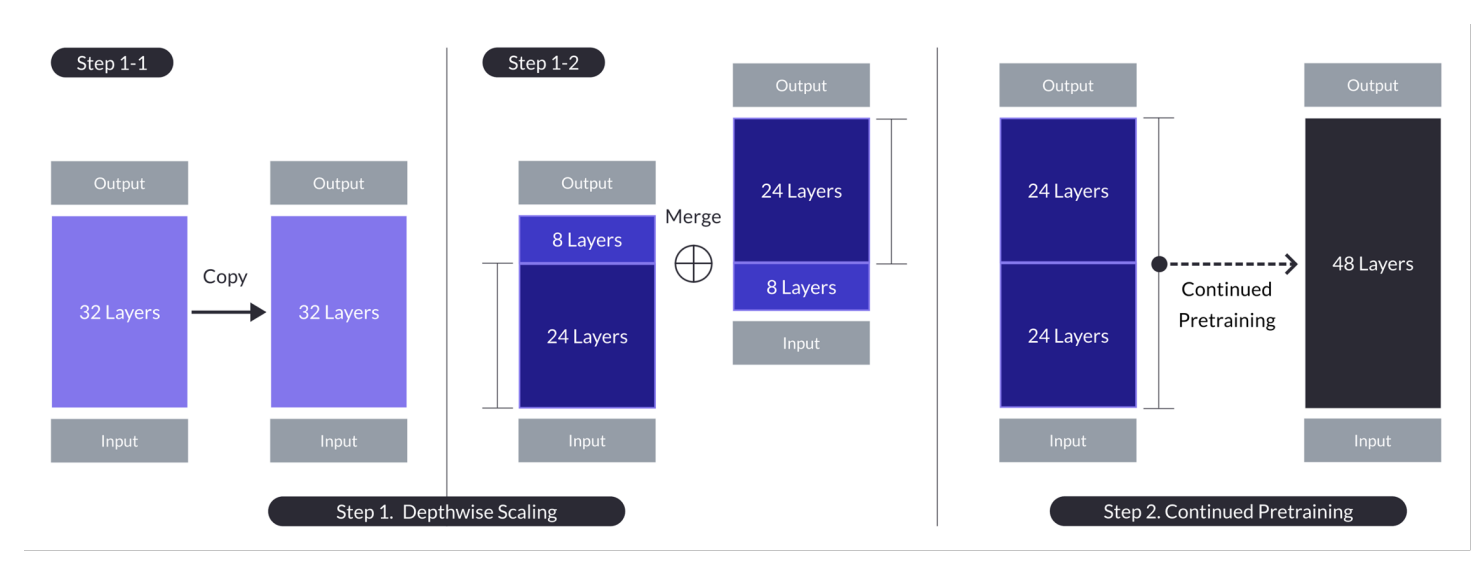
Depth Up-Scaling für den Fall mit n = 32, s = 48 und m = 8. Depth Up-Scaling wird über eine zweistufige Abfolge aus Tiefenskalierung und fortgesetztem Pretraining erreicht. (Quelle)
Basismodell:
- Nutzt eine 32-Schichten-Transformer-Architektur, konkret das Llama-2-Modell, initialisiert mit vortrainierten Gewichten von Mistral 7B.
- Gewählt aufgrund von Kompatibilität und Leistung, um Community-Ressourcen zu nutzen und neue Modifikationen für erweiterte Fähigkeiten einzuführen.
- Dient als Grundlage für Tiefenskalierung und weiteres Pretraining, um effizient hochzuskalieren.
Tiefenskalierung:
- Skaliert das Basismodell, indem eine Zielanzahl an Schichten für das skalierte Modell festgelegt wird, unter Berücksichtigung der Hardware-Fähigkeiten.
- Dupliziert das Basismodell, entfernt die letzten m Schichten aus dem Original und die ersten m Schichten aus der Kopie und verknüpft beide, um ein Modell mit s Schichten zu bilden.
- So entsteht ein skaliertes Modell mit angepasster Schichtanzahl im Bereich von 7 bis 13 Milliarden Parametern. Konkret wurde von n=32 Schichten ausgegangen und m=8 Schichten entfernt, um s=48 Schichten zu erreichen.
Fortgesetztes Pretraining:
- Gleicht den anfänglichen Leistungseinbruch nach der Tiefenskalierung aus, indem das skalierte Modell weiter vortrainiert wird.
- Im fortgesetzten Pretraining wurde eine schnelle Leistungsrückgewinnung beobachtet, zurückgeführt auf die Reduzierung von Heterogenität und Diskrepanzen im Modell.
- Fortgesetztes Pretraining ist entscheidend, um die Leistung des Basismodells wieder zu erreichen und möglicherweise zu übertreffen, indem die Architektur des tiefenskalieren Modells für effektives Lernen genutzt wird.
Diese Zusammenfassung zeigt die wesentlichen Strategien und Ergebnisse des Depth-Up-Scaling-Ansatzes: vorhandene Modelle nutzen, über Tiefenanpassungen skalieren und durch fortgesetztes Pretraining die Leistung steigern.
Mit diesem mehrstufigen Ansatz erreicht SOLAR-10.7B in vielen Fällen die Fähigkeiten deutlich größerer Modelle oder übertrifft sie sogar. Diese Effizienz macht es zur ersten Wahl für viele spezifische Anwendungen und unterstreicht Stärke und Flexibilität.
Wie funktioniert das SOLAR-10.7B-Instruct-Modell?
SOLAR-10.7B Instruct ist stark darin, komplexe Anweisungen zu interpretieren und auszuführen. Dadurch ist es extrem wertvoll in Szenarien, in denen ein präzises Verständnis und eine verlässliche Reaktion auf menschliche Eingaben entscheidend sind. Diese Fähigkeit ist zentral für intuitivere, interaktive KI-Systeme.
- SOLAR-10.7B Instruct entsteht durch Fine-Tuning des ursprünglichen SOLAR-10.7B-Modells, um Anweisungen im QA-Format zu befolgen.
- Das Fine-Tuning nutzt vor allem Open-Source-Datensätze sowie synthetisierte Mathe-QA-Datensätze, um die mathematischen Fähigkeiten des Modells zu stärken.
- Die erste Version von SOLAR-10.7B Instruct wurde durch Integration der Mistral-7B-Gewichte erstellt, um die Lernfähigkeiten für effiziente Informationsverarbeitung zu verbessern.
- Das Rückgrat von SOLAR-10.7B ist die Llama2-Architektur, die Tempo und Genauigkeit verbindet.
Insgesamt liegt die Bedeutung des feinabgestimmten SOLAR-10.7B in seiner verbesserten Leistung, seiner Anpassungsfähigkeit und seinem breiten Anwendungspotenzial – ein Treiber für Fortschritte in der natürlichen Sprachverarbeitung und der KI.
Mögliche Anwendungsfälle des feinabgestimmten SOLAR-10.7B
Bevor wir in die technische Umsetzung einsteigen, werfen wir einen Blick auf potenzielle Anwendungen eines feinabgestimmten SOLAR-10.7B.
Nachfolgend einige Beispiele aus personalisierter Bildung und Tutoring, verbessertem Kundenservice und automatisierter Inhaltserstellung.
- Personalisierte Bildung und Tutoring: SOLAR-10.7B-Instruct kann den Bildungsbereich verändern, indem es personalisierte Lernerlebnisse ermöglicht. Es versteht komplexe Fragen von Lernenden und liefert passgenaue Erklärungen, Ressourcen und Übungen. Ideal für intelligente Tutoringsysteme, die sich an individuelle Lernstile und Bedürfnisse anpassen und so Engagement und Lernerfolg steigern.
- Besserer Kundenservice: SOLAR-10.7B-Instruct kann fortgeschrittene Chatbots und virtuelle Assistenten antreiben, die komplexe Kundenanfragen sehr genau verstehen und lösen. Das verbessert nicht nur die Customer Experience durch schnelle, relevante Hilfe, sondern reduziert auch die Last für menschliche Support-Teams, indem Routineanfragen automatisiert werden.
- Automatisierte Inhaltserstellung und -zusammenfassung: Für Medien und Content-Teams bietet SOLAR-10.7B-Instruct die Möglichkeit, Texte wie News, Berichte oder kreative Inhalte automatisch zu generieren. Außerdem kann es umfangreiche Dokumente prägnant zusammenfassen – ein Gewinn für Journalistinnen, Forschende und Fachleute, die große Informationsmengen schnell erfassen und berichten müssen.
Diese Beispiele zeigen, wie vielseitig SOLAR-10.7B-Instruct ist und wie es Effizienz, Zugänglichkeit und Nutzererlebnis in vielen Branchen verbessern kann.
Schritt-für-Schritt-Anleitung: SOLAR-10.7B Instruct einsetzen
Wir haben genug Hintergrund zum SOLAR-10.7B-Modell – jetzt geht es an die Praxis.
Dieser Abschnitt enthält alle Schritte, um das SOLAR 10.7 Instruct v1.0 - GGUF-Modell von Upstage auszuführen.
Der Code orientiert sich an der offiziellen Dokumentation auf Hugging Face. Die Hauptschritte sind:
- Benötigte Bibliotheken installieren und importieren
- Das SOLAR-10.7B-Modell von Hugging Face definieren
- Model-Inferenz ausführen
- Ergebnis für die Anfrage der Nutzerin bzw. des Nutzers generieren
Installation der Bibliotheken
Die wichtigsten Bibliotheken sind transformers und accelerate.
- Die Bibliothek transformers bietet Zugriff auf vortrainierte Modelle, hier in Version 4.35.2.
- accelerate macht es leichter, ML-Modelle auf verschiedener Hardware (CPUs, GPUs) auszuführen, ohne die Details der Hardware kennen zu müssen.
%%bash
pip -q install transformers==4.35.2
pip -q install accelerate
Bibliotheken importieren
Nach der Installation importieren wir die folgenden Bibliotheken:
- torch ist die PyTorch-Bibliothek, ein populäres Open-Source-Framework für Machine Learning, etwa für Computer Vision und NLP.
- AutoModelForCausalLM lädt ein vortrainiertes Modell für kausales Sprachmodellieren, und AutoTokenizer wandelt Text in ein vom Modell verstandenes Format um (Tokenisierung).
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
GPU-Konfiguration
Verwendet wird Version 1 des SOLAR-10.7B-Modells von Hugging Face.
Eine GPU ist sinnvoll, um das Laden des Modells und die Inferenz zu beschleunigen.
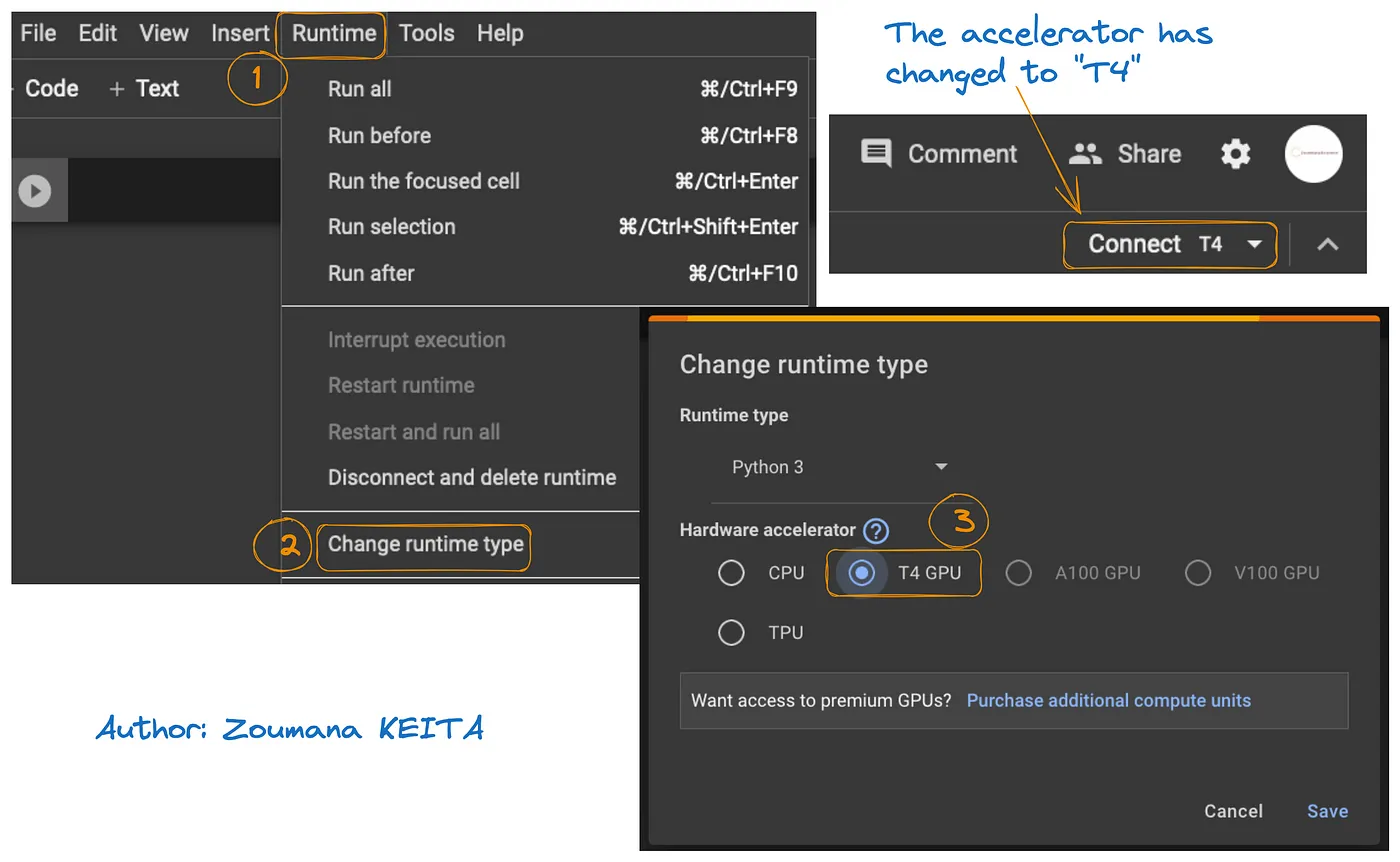
So aktivierst du die GPU in Google Colab:
- Im Tab Runtime Change runtime auswählen.
- Dann T4 GPU als Hardwarebeschleuniger wählen und Änderungen speichern.
Dadurch wechselt die Standardlaufzeit auf T4:
Die Eigenschaften der Laufzeit kannst du im Colab-Notebook mit folgendem Befehl prüfen:
!nvidia-smi
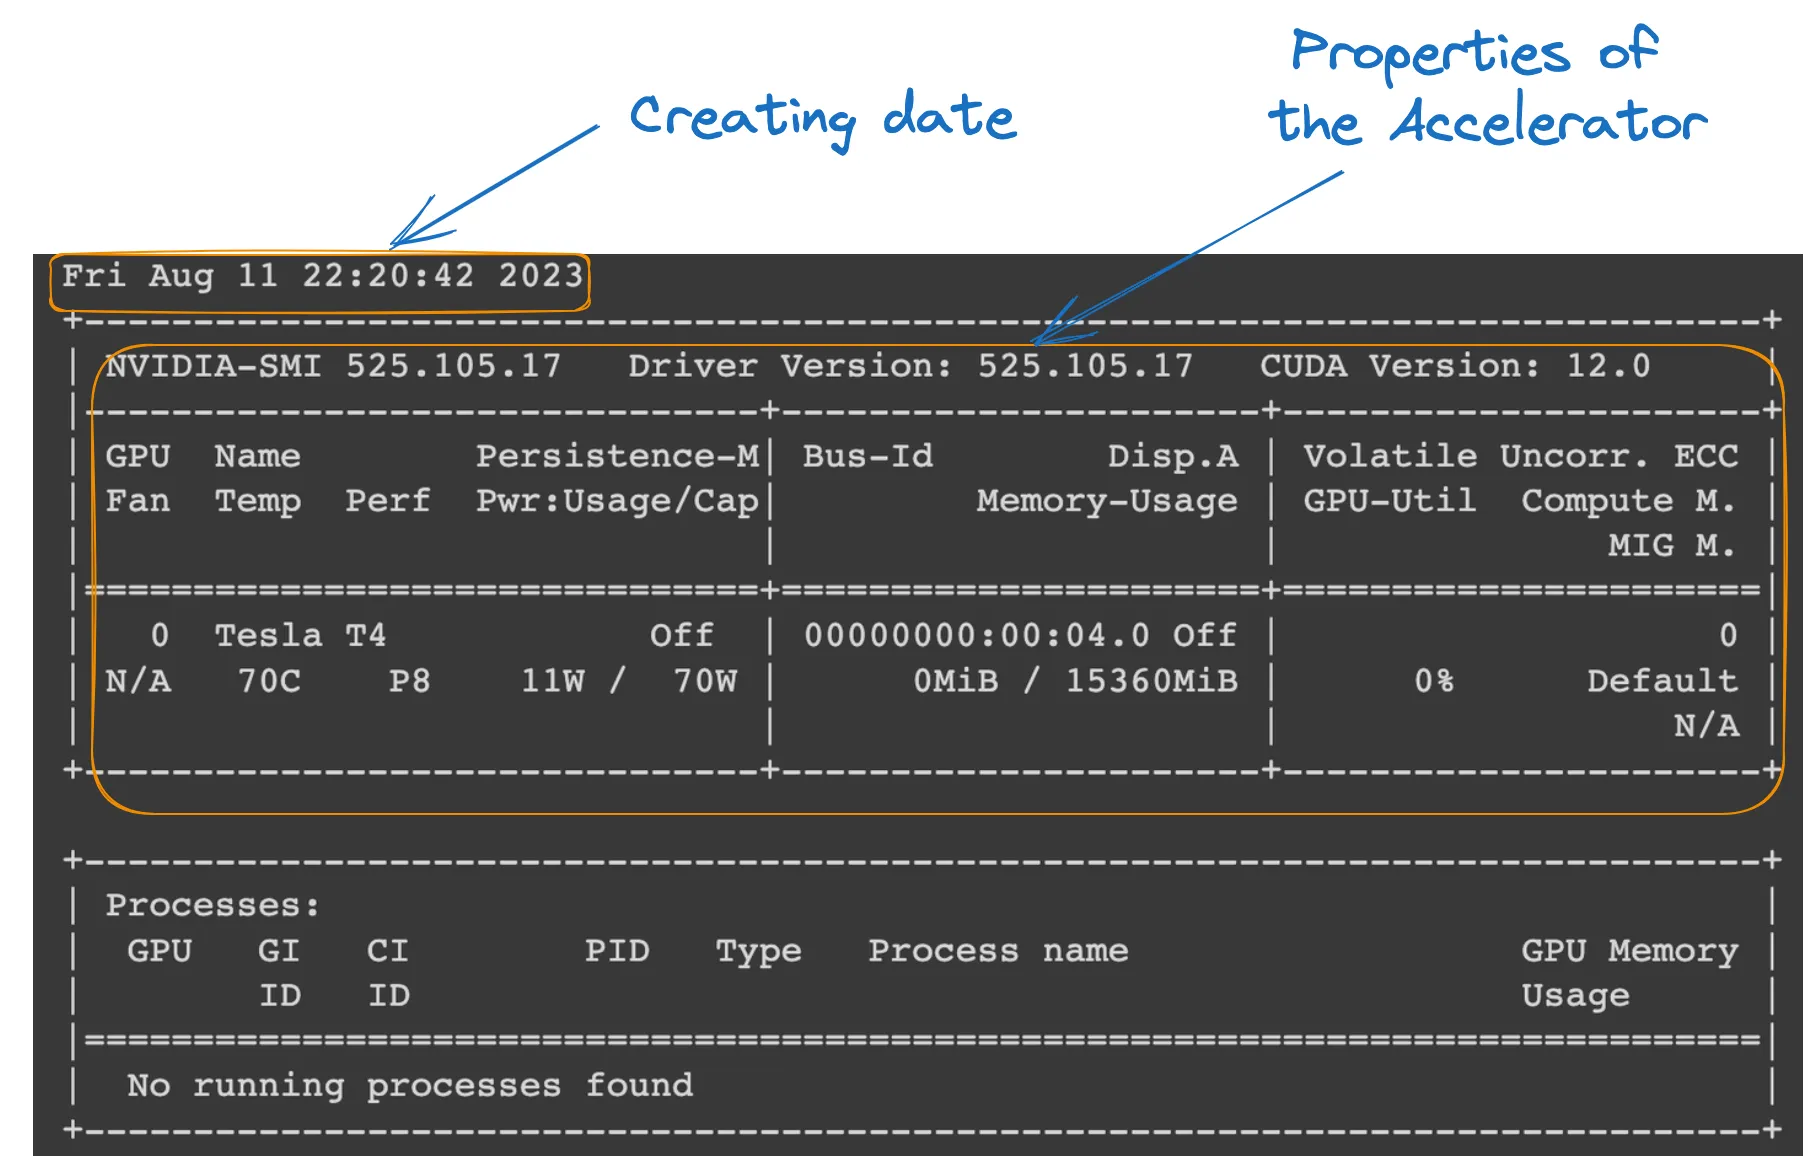
GPU-Eigenschaften
Modell definieren
Alles ist vorbereitet. Jetzt laden wir das Modell wie folgt:
model_ID = "Upstage/SOLAR-10.7B-Instruct-v1.0"
tokenizer = AutoTokenizer.from_pretrained(model_ID)
model = AutoModelForCausalLM.from_pretrained(
model_ID,
device_map="auto",
torch_dtype=torch.float16,
)
- model_ID ist die eindeutige Kennung des vortrainierten Modells. Hier verwenden wir "Upstage/SOLAR-10.7B-Instruct-v1.0".
- AutoTokenizer.from_pretrained(model_ID) lädt den für dieses Modell vortrainierten Tokenizer, um Texteingaben aufzubereiten.
- AutoModelForCausalLM.from_pretrained() lädt das kausale Sprachmodell. device_map="auto" nutzt automatisch die beste verfügbare Hardware (unsere GPU), und torch_dtype=torch.float16 spart Speicher und kann Berechnungen beschleunigen.
Modellinferenz
Vor der Antwortgenerierung wird der Eingabetext (die Nutzeranfrage) formatiert und tokenisiert.
- user_request enthält die Frage bzw. Eingabe für das Modell.
- conversation formatiert die Eingabe als Teil eines Dialogs und versieht sie mit einer Rolle (z. B. "user").
- apply_chat_template wendet eine Dialogvorlage an und bringt die Eingabe in ein vom Modell verstandenes Format.
- tokenizer(prompt, return_tensors="pt") wandelt den Prompt in Tokens und .to(model.device) stellt sicher, dass die Eingabe auf demselben Gerät liegt wie das Modell (CPU oder GPU).
user_request = "What is the square root of 24?"
conversation = [ {'role': 'user', 'content': user_request} ]
prompt = tokenizer.apply_chat_template(conversation, tokenize=False, add_generation_prompt=True)
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
Ergebnis generieren
Zum Schluss lässt du das Modell eine Antwort erzeugen, dekodierst den Text und gibst ihn aus.
- model.generate() erzeugt Text auf Basis der Eingaben. use_cache=True beschleunigt die Generierung durch Wiederverwendung bereits berechneter Ergebnisse. max_length=4096 begrenzt die maximale Länge.
- tokenizer.decode(outputs[0]) wandelt die generierten Tokens in lesbaren Text um.
- Mit print wird die Antwort auf die Nutzerfrage ausgegeben.
outputs = model.generate(**inputs, use_cache=True, max_length=4096)
output_text = tokenizer.decode(outputs[0])
print(output_text)
Die erfolgreiche Ausführung des obigen Codes liefert folgendes Ergebnis:

Wenn du die Nutzeranfrage durch folgenden Text ersetzt, erhältst du eine neue Antwort:
user_request = "Tell me a story about the universe"

Einschränkungen des SOLAR-10.7B-Modells
Trotz aller Stärken hat SOLAR-10.7B – wie jedes große Sprachmodell – auch Grenzen. Die wichtigsten sind:
- Umfassendere Hyperparameter-Suche: Während des Depth Up-Scaling (DUS) wäre eine gründlichere Erkundung der Hyperparameter nötig. Aufgrund von Hardware-Limits mussten 8 Schichten aus dem Basismodell entfernt werden.
- Hoher Rechenbedarf: Das Modell verlangt erhebliche Rechenressourcen. Das schränkt die Nutzung für Einzelpersonen und Organisationen mit begrenzter Hardware ein.
- Anfälligkeit für Bias: Verzerrungen in Trainingsdaten können die Modellleistung in bestimmten Anwendungsfällen beeinträchtigen.
- Umweltaspekt: Training und Inferenz verursachen einen hohen Energieverbrauch und können Umweltbedenken auslösen.
Fazit
Dieser Artikel hat das SOLAR-10.7B-Modell beleuchtet, insbesondere seinen Beitrag zur Künstlichen Intelligenz durch den Depth-Up-Scaling-Ansatz. Wir haben erklärt, wie das Modell arbeitet, mögliche Anwendungen aufgezeigt und eine praktische Anleitung von der Installation bis zur Ergebniserzeugung gegeben.
Trotz der starken Fähigkeiten wurden auch die Grenzen von SOLAR-10.7B thematisiert – für eine ausgewogene Einschätzung. Während sich KI weiterentwickelt, zeigt SOLAR-10.7B, wie KI-Tools zugänglicher und vielseitiger werden.
Wenn du tiefer in das Potenzial von KI einsteigen möchtest, liefert unser Tutorial FLAN-T5 Tutorial: Guide and Fine-Tuning einen vollständigen Leitfaden zum Fine-Tuning eines FLAN-T5 für eine QA-Aufgabe mit der Transformers-Bibliothek und optimierter Inferenz in einem realen Szenario. Außerdem findest du unser Fine-Tuning GPT-3.5 Tutorial und unser Code-Along zum Fine-Tuning eines eigenen LlaMA-2-Modells.
Zoumana ist ein vielseitiger Datenwissenschaftler, der sein Wissen gerne mit anderen teilt und anderen etwas zurückgibt. Er erstellt Inhalte auf YouTube und schreibt auf Medium. Er hat Freude am Sprechen, Programmieren und Unterrichten. Zoumana hat zwei Master-Abschlüsse. Den ersten in Informatik mit dem Schwerpunkt Maschinelles Lernen in Paris, Frankreich, und den zweiten in Datenwissenschaft an der Texas Tech University in den USA. Sein beruflicher Werdegang begann als Softwareentwickler bei Groupe OPEN in Frankreich, bevor er als Berater für maschinelles Lernen zu IBM wechselte, wo er End-to-End-KI-Lösungen für Versicherungsunternehmen entwickelte. Zoumana arbeitet bei Axionable, dem ersten nachhaltigen KI-Startup mit Sitz in Paris und Montreal. Dort arbeitete er als Data Scientist und implementierte KI-Produkte, vor allem NLP-Anwendungsfälle, für Kunden aus Frankreich, Montreal, Singapur und der Schweiz. Zusätzlich widmete er 5% seiner Zeit der Forschung und Entwicklung. Zurzeit arbeitet er als Senior Data Scientist bei der IFC, der Weltbankgruppe.
