
{count, plural, one {Cursus} other {Cursussen}}
Het SOLAR-10.7B-project betekent een grote sprong voorwaarts in de ontwikkeling van grote taalmodellen, met een nieuwe aanpak om deze modellen effectief en efficiënt op te schalen.
Dit artikel begint met een uitleg van wat het SOLAR-10.7B-model is, licht vervolgens de prestaties ten opzichte van andere grote taalmodellen uit en duikt in het gebruik van de gespecialiseerde, fijn-afgestelde versie. Tot slot krijg je inzicht in de mogelijke toepassingen van het fijn-afgestelde SOLAR-10.7B-Instruct-model en de beperkingen ervan.
Wat is SOLAR-10.7B?
SOLAR-10.7B is een model met 10,7 miljard parameters, ontwikkeld door een team bij Upstage AI in Zuid-Korea.
Gebaseerd op de Llama-2-architectuur overtreft dit model andere grote taalmodellen met tot wel 30 miljard parameters, waaronder het Mixtral 8X7B-model.
Wil je meer leren over Llama-2, bekijk dan ons artikel LLaMA 2 fine-tunen: een stapsgewijze gids voor het aanpassen van het grote taalmodel, met een stap-voor-stap uitleg om Llama-2 te fine-tunen met nieuwe benaderingen die geheugen- en rekeneisen omzeilen voor betere toegang tot open-source grote taalmodellen.
Bovendien is, voortbouwend op de robuuste basis van SOLAR-10.7B, het SOLAR 10.7B-Instruct-model fijn-afgesteld met de nadruk op het volgen van complexe instructies. Deze variant laat verbeterde prestaties zien, wat de aanpasbaarheid van het model en de effectiviteit van fine-tuning voor gespecialiseerde doelen onderstreept.
Tot slot introduceert SOLAR-10.7B een methode genaamd Depth Up-Scaling. Laten we dat in de volgende sectie verder verkennen.
De Depth Up-Scaling-methode
Met deze innovatieve methode kun je de diepte van het neurale netwerk van het model vergroten zonder dat hiervoor evenredig meer rekenkracht nodig is. Zo'n strategie verhoogt zowel de efficiëntie als de algehele prestaties van het model.
Essentiële elementen van Depth Up-Scaling
Depth Up-Scaling is gebaseerd op drie hoofdcomponenten: (1) Mistral 7B-gewichten, (2) Llama 2-framework en (3) doorlopende pretraining.
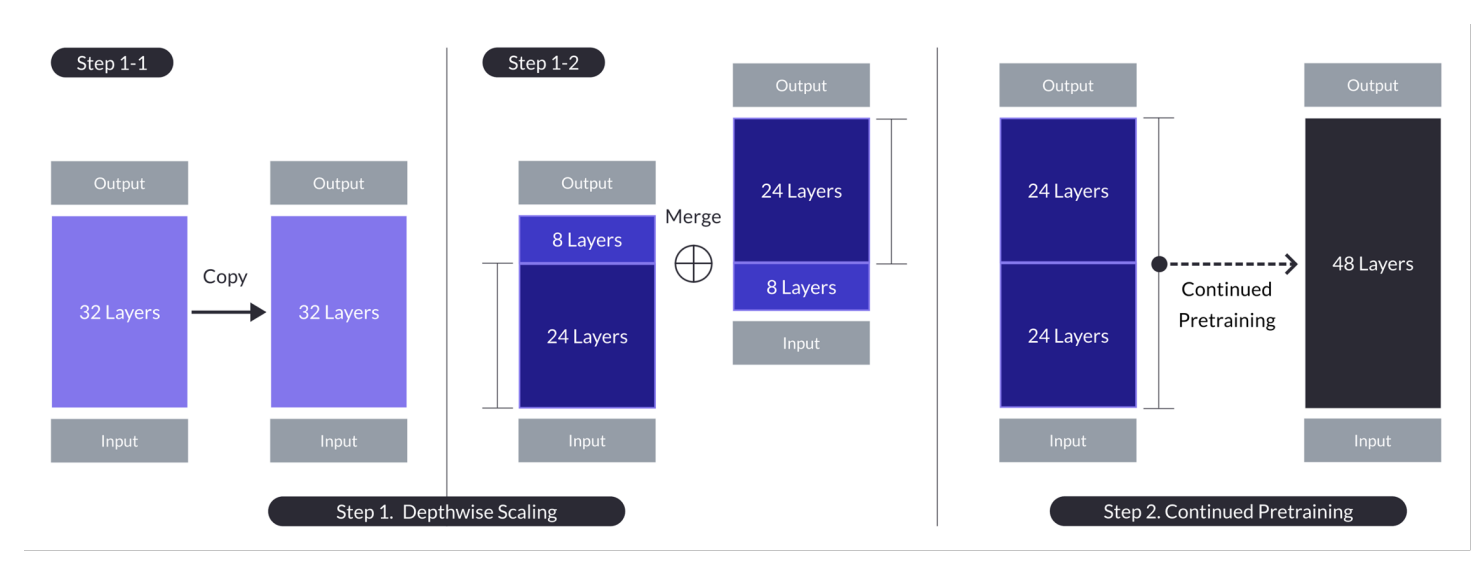
Depth up-scaling voor het geval met n = 32, s = 48 en m = 8. Depth up-scaling wordt bereikt via een tweefasig proces van diepteschaalvergroting gevolgd door voortgezette pretraining. (Bron)
Basismodel:
- Maakt gebruik van een transformatorarchitectuur met 32 lagen, specifiek het Llama 2-model, geïnitialiseerd met voorgetrainde gewichten van Mistral 7B.
- Gekozen om zijn compatibiliteit en prestaties, met als doel communitybronnen te benutten en nieuwe aanpassingen te introduceren voor verbeterde capaciteiten.
- Dient als basis voor diepteschaalvergroting en verdere pretraining om efficiënt op te schalen.
Diepteschaalvergroting:
- Schaalt het basismodel door een doellaag-aantal voor het opgeschaalde model vast te stellen, rekening houdend met de hardwarecapaciteiten.
- Omvat het dupliceren van het basismodel, het verwijderen van de laatste m lagen van het origineel en de eerste m lagen van de kopie, en deze vervolgens samen te voegen tot een model met s lagen.
- Dit proces creëert een opgeschaald model met een aangepast aantal lagen om tussen 7 en 13 miljard parameters te passen, waarbij specifiek een basis van n=32 lagen wordt gebruikt en m=8 lagen worden verwijderd om s=48 lagen te bereiken.
Voortgezette pretraining:
- Pakt de initiële prestatiedaling na diepteschaalvergroting aan door het opgeschaalde model verder voor te trainen.
- Tijdens de voortgezette pretraining werd een snel herstel van de prestaties waargenomen, wat werd toegeschreven aan het verminderen van heterogeniteit en discrepanties in het model.
- Voortgezette pretraining is cruciaal om de prestaties van het basismodel te herwinnen en mogelijk te overtreffen, waarbij de architectuur van het diepteschaalvergrote model wordt benut voor effectief leren.
Deze samenvattingen belichten de belangrijkste strategieën en uitkomsten van de Depth Up-Scaling-aanpak, met de nadruk op het benutten van bestaande modellen, opschalen via diepteaanpassing en het verhogen van de prestaties via voortgezette pretraining.
Met deze veelzijdige aanpak evenaart en overtreft SOLAR-10.7B in veel gevallen de capaciteiten van veel grotere modellen. Deze efficiëntie maakt het een uitstekende keuze voor uiteenlopende specifieke toepassingen en toont zijn kracht en flexibiliteit.
Hoe werkt het SOLAR 10.7B Instruct-model?
SOLAR-10.7B Instruct blinkt uit in het interpreteren en uitvoeren van complexe instructies, waardoor het enorm waardevol is in scenario's waarin nauwkeurig begrip en respons op menselijke opdrachten cruciaal zijn. Deze capaciteit is essentieel voor het ontwikkelen van intuïtievere en meer interactieve AI-systemen.
- SOLAR 10.7B Instruct is het resultaat van het fijn-afstellen van het oorspronkelijke SOLAR 10.7B-model om instructies in QA-formaat te volgen.
- De fine-tuning gebruikt vooral open-sourcedatasets, aangevuld met gesynthetiseerde wiskunde-QA-datasets om de wiskundige vaardigheden van het model te verbeteren.
- De eerste versie van SOLAR 10.7B Instruct is gemaakt door de Mistral 7B-gewichten te integreren om de leercapaciteiten te versterken voor effectieve en efficiënte informatieverwerking.
- De ruggengraat van SOLAR 10.7B is de Llama2-architectuur, die snelheid en nauwkeurigheid combineert.
Al met al schuilt het belang van het fijn-afgestelde SOLAR-10.7B-model in de verbeterde prestaties, aanpasbaarheid en het potentieel voor brede toepassing, wat de vooruitgang in natuurlijke taalverwerking en kunstmatige intelligentie stimuleert.
Mogelijke toepassingen van het fijn-afgestelde SOLAR-10.7B-model
Voordat we in de technische implementatie duiken, verkennen we enkele mogelijke toepassingen van een fijn-afgesteld SOLAR-10.7B-model.
Hieronder staan voorbeelden van gepersonaliseerd onderwijs en tutoring, verbeterde klantenondersteuning en geautomatiseerde contentcreatie.
- Gepersonaliseerd onderwijs en tutoring: SOLAR-10.7B-Instruct kan het onderwijs transformeren door gepersonaliseerde leerervaringen te bieden. Het kan complexe vragen van studenten begrijpen en op maat gemaakte uitleg, bronnen en oefeningen aanbieden. Deze capaciteit maakt het een ideaal hulpmiddel voor het ontwikkelen van intelligente tutorsystemen die zich aanpassen aan individuele leerstijlen en -behoeften, wat de betrokkenheid en resultaten van studenten vergroot.
- Betere klantenondersteuning: SOLAR-10.7B-Instruct kan geavanceerde chatbots en virtuele assistenten aansturen die complexe klantvragen met hoge nauwkeurigheid begrijpen en oplossen. Deze toepassing verbetert niet alleen de klantervaring door tijdige en relevante ondersteuning te bieden, maar vermindert ook de werkdruk voor menselijke servicemedewerkers door routinematige vragen te automatiseren.
- Geautomatiseerde contentcreatie en samenvatting: Voor media- en contentmakers biedt SOLAR-10.7B-Instruct de mogelijkheid om geschreven inhoud te genereren, zoals nieuwsartikelen, rapporten en creatieve teksten. Daarnaast kan het omvangrijke documenten samenvatten tot beknopte, makkelijk te begrijpen formats, wat het onmisbaar maakt voor journalisten, onderzoekers en professionals die snel grote hoeveelheden informatie moeten verwerken en rapporteren.
Deze voorbeelden onderstrepen de veelzijdigheid en het potentieel van SOLAR-10.7B-Instruct om efficiëntie, toegankelijkheid en gebruikerservaring in een breed scala aan sectoren te verbeteren.
Een stapsgewijze gids voor het gebruik van SOLAR-10.7B Instruct
We hebben nu voldoende achtergrond over het SOLAR-10.7B-model; tijd om de handen uit de mouwen te steken.
Deze sectie geeft alle instructies om het SOLAR 10.7 Instruct v1.0 - GGUF-model van Upstage te draaien.
De code is geïnspireerd op de officiële documentatie op Hugging Face. De hoofdstappen zijn als volgt:
- Installeer en importeer de benodigde libraries
- Definieer het SOLAR-10.7B-model dat je wilt gebruiken vanaf Hugging Face
- Draai de modelinference
- Genereer het resultaat op basis van de vraag van de gebruiker
Libraries installeren
De belangrijkste libraries die gebruikt worden zijn transformers en accelerate.
- De transformers-bibliotheek biedt toegang tot voorgetrainde modellen; de hier gespecificeerde versie is 4.35.2.
- De accelerate-bibliotheek is ontworpen om het draaien van machinelearningmodellen op verschillende hardware (CPU's, GPU's) te vereenvoudigen zonder dat je de hardwarespecificaties diep hoeft te begrijpen.
%%bash
pip -q install transformers==4.35.2
pip -q install accelerate
Libraries importeren
Nu de installatie voltooid is, importeren we de volgende noodzakelijke libraries:
- torch is de PyTorch-bibliotheek, een populaire open-source machinelearningbibliotheek die wordt gebruikt voor onder andere computervisie en NLP.
- AutoModelForCausalLM wordt gebruikt om een voorgetraind model voor causale taalmodellering te laden, en AutoTokenizer zet tekst om in een formaat dat het model kan begrijpen (tokenisatie).
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
GPU-configuratie
Het model dat we gebruiken is versie 1 van het SOLAR-10.7B-model op Hugging Face.
Een GPU is nodig om het laden en het inferentieproces te versnellen.
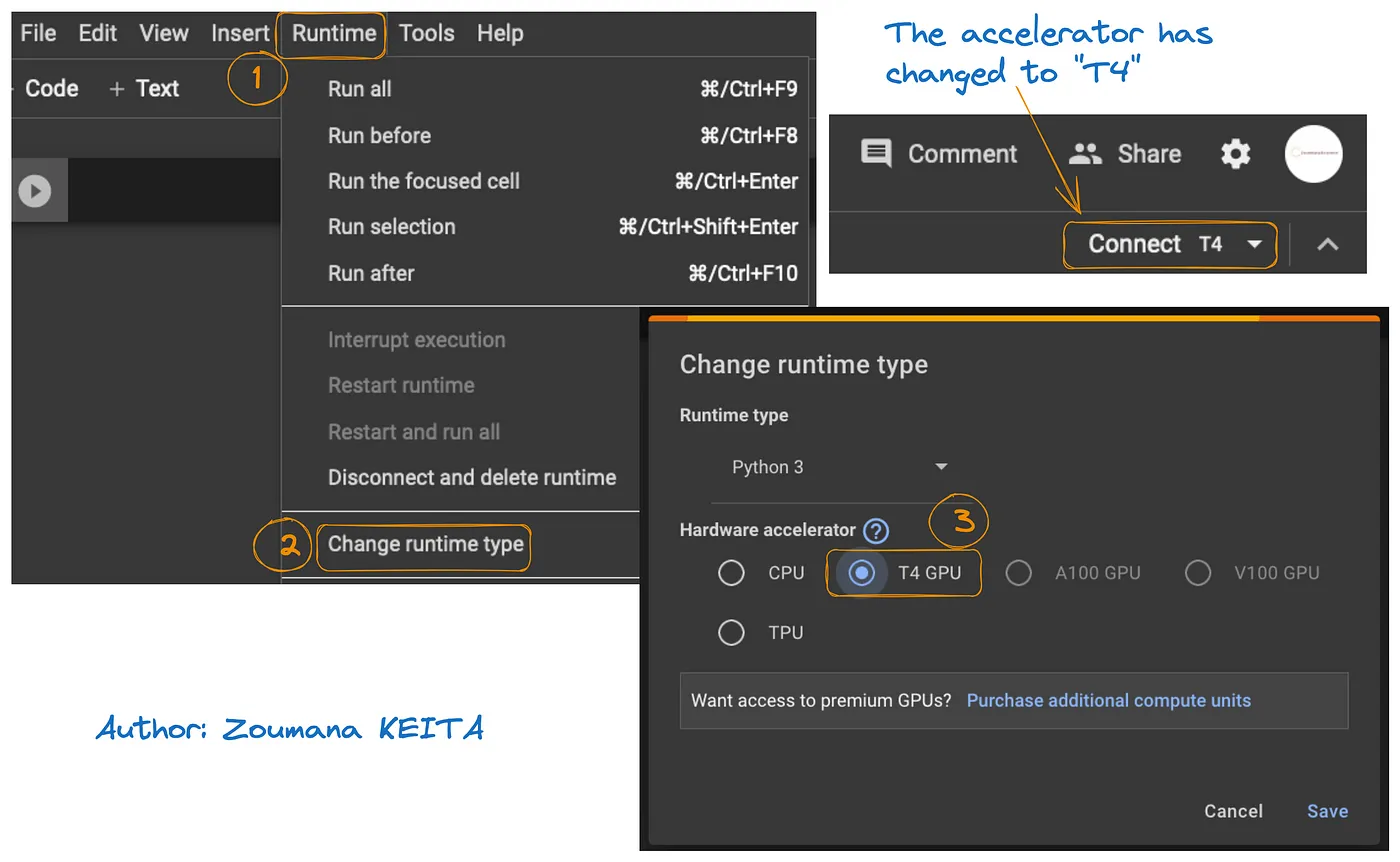
De toegang tot een GPU op Google Colab wordt geïllustreerd in de onderstaande afbeelding:
- Selecteer in het tabblad Runtime de optie Change runtime
- Kies vervolgens T4 GPU bij Hardware accelerator en Save de wijzigingen
Dit schakelt de standaardruntime om naar T4:
We kunnen de eigenschappen van de runtime controleren door het volgende commando in de Colab-notebook uit te voeren.
!nvidia-smi
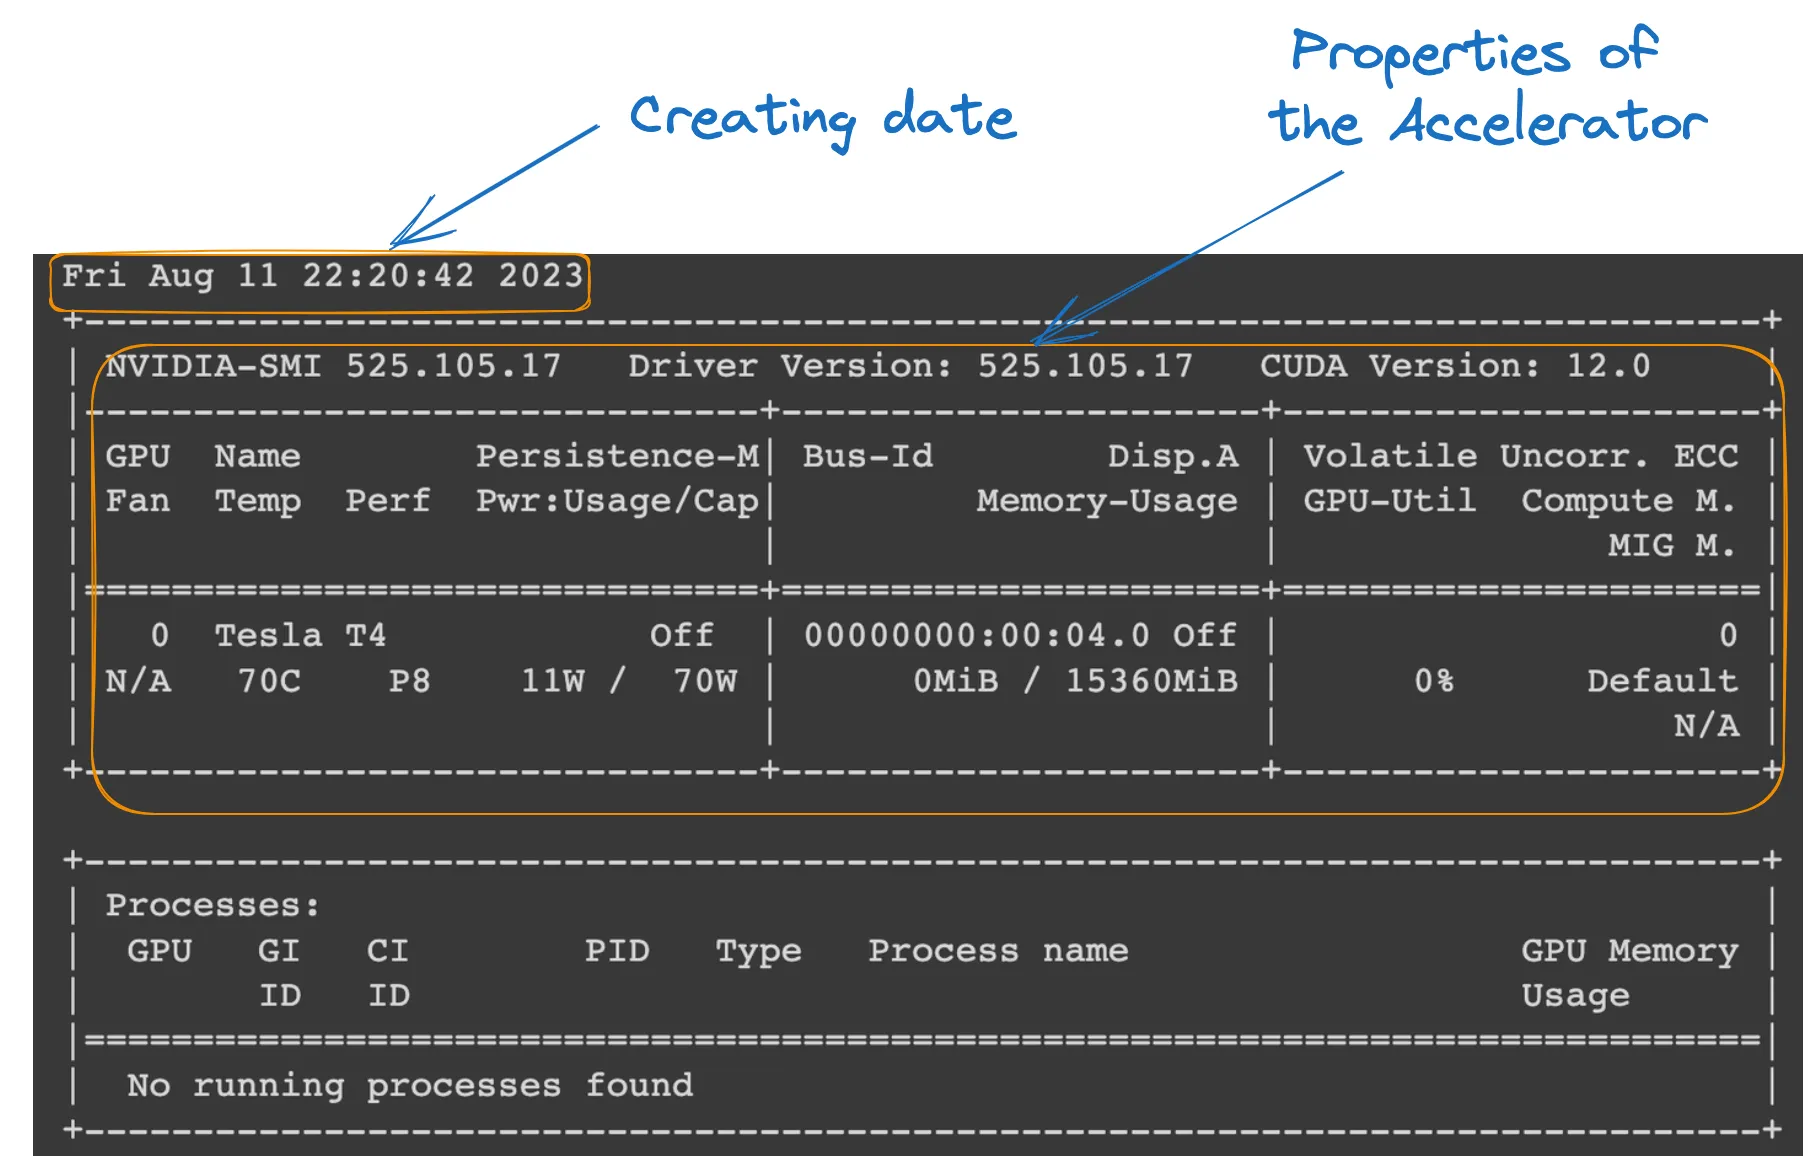
GPU-eigenschappen
Modeldefinitie
Alles is klaar; we kunnen het model als volgt laden:
model_ID = "Upstage/SOLAR-10.7B-Instruct-v1.0"
tokenizer = AutoTokenizer.from_pretrained(model_ID)
model = AutoModelForCausalLM.from_pretrained(
model_ID,
device_map="auto",
torch_dtype=torch.float16,
)
- model_ID is een string die het voorgetrainde model dat we willen gebruiken uniek identificeert. In dit geval is "Upstage/SOLAR-10.7B-Instruct-v1.0" gespecificeerd.
- AutoTokenizer.from_pretrained(model_ID) laadt een tokenizer die is voorgetraind op het opgegeven model_ID en maakt het klaar voor het verwerken van tekstinvoer.
- AutoModelForCausalLM.from_pretrained() laadt het causale taalmodel zelf, met device_map="auto" om automatisch de best beschikbare hardware te gebruiken (de GPU die we hebben ingesteld), en torch_dtype=torch.float16 om 16-bits drijvende-kommagetallen te gebruiken om geheugen te besparen en berekeningen mogelijk te versnellen.
Modelinference
Voordat er een antwoord wordt gegenereerd, wordt de invoertekst (de vraag van de gebruiker) geformatteerd en getokeniseerd.
- user_request bevat de vraag of invoer voor het model.
- conversation formatteert de invoer als onderdeel van een gesprek en labelt deze met een rol (bijv. 'user').
- apply_chat_template past een gespreksjabloon toe op de invoer, zodat deze in een formaat staat dat het model begrijpt.
- tokenizer(prompt, return_tensors="pt") zet de prompt om in tokens en specificeert het tensortype ("pt" voor PyTorch-tensors), en .to(model.device) zorgt ervoor dat de invoer op hetzelfde apparaat (CPU of GPU) staat als het model.
user_request = "What is the square root of 24?"
conversation = [ {'role': 'user', 'content': user_request} ]
prompt = tokenizer.apply_chat_template(conversation, tokenize=False, add_generation_prompt=True)
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
Resultaat genereren
In het laatste deel gebruikt het model de invoervraag om een antwoord te genereren, waarna de gegenereerde tekst wordt gedecodeerd en afgedrukt.
- model.generate() genereert tekst op basis van de aangeleverde invoer, met use_cache=True om de generatie te versnellen door eerder berekende resultaten te hergebruiken. max_length=4096 begrenst de maximale lengte van de gegenereerde tekst.
- tokenizer.decode(outputs[0]) zet de gegenereerde tokens terug om naar voor mensen leesbare tekst.
- De print-instructie toont het gegenereerde antwoord op de vraag van de gebruiker.
outputs = model.generate(**inputs, use_cache=True, max_length=4096)
output_text = tokenizer.decode(outputs[0])
print(output_text)
Als de code hierboven succesvol wordt uitgevoerd, levert dat het volgende resultaat op:

Door de gebruikersvraag te vervangen door de volgende tekst, krijgen we de onderstaande respons
user_request = "Tell me a story about the universe"

Beperkingen van het SOLAR-10.7B-model
Ondanks alle voordelen van SOLAR-10.7B heeft het, zoals elk groot taalmodel, ook beperkingen. De belangrijkste staan hieronder:
- Grondige hyperparameterverkenning: de noodzaak van een grondiger verkenning van de hyperparameters van het model tijdens Depth Up-Scaling (DUS) is een belangrijke beperking. Hierdoor zijn 8 lagen uit het basismodel verwijderd vanwege hardwarebeperkingen.
- Rekenintensief: het model vraagt aanzienlijk veel rekenbronnen, wat het gebruik beperkt voor individuen en organisaties met minder rekenkracht.
- Kwetsbaar voor bias: mogelijke vooringenomenheid in de trainingsdata kan de prestaties van het model voor sommige use-cases beïnvloeden.
- Milieuzorg: het trainen en infereren van het model vergt veel energie, wat milieuvragen kan oproepen.
Conclusie
Dit artikel heeft het SOLAR-10.7B-model verkend en de bijdrage aan kunstmatige intelligentie via de depth up-scaling-aanpak belicht. Het beschreef de werking en de mogelijke toepassingen van het model en bood een praktische gids voor het gebruik ervan, van installatie tot het genereren van resultaten.
Ondanks zijn capaciteiten zijn ook de beperkingen van het SOLAR-10.7B-model besproken, zodat gebruikers een evenwichtig beeld krijgen. Terwijl AI zich blijft ontwikkelen, laat SOLAR-10.7B de stappen zien die zijn gezet richting toegankelijkere en veelzijdigere AI-tools.
Voor wie dieper wil duiken in het potentieel van AI: onze tutorial FLAN-T5 Tutorial: gids en fine-tuning biedt een complete handleiding om een FLAN-T5-model te fine-tunen voor een vraag-en-antwoordtaak met de transformers-bibliotheek en geoptimaliseerde inference in een realistische use-case. Bekijk ook onze tutorial over het fine-tunen van GPT-3.5 en onze code-along over het fine-tunen van je eigen LlaMA 2-model.
Een veelzijdige data scientist die graag zijn kennis deelt en iets terugdoet voor anderen. Zoumana is YouTube-contentmaker en een toonaangevende techschrijver op Medium. Hij haalt plezier uit spreken, coderen en lesgeven. Zoumana heeft twee masterdiploma’s: het eerste in informatica met een focus op machine learning uit Parijs, Frankrijk, en het tweede in data science van Texas Tech University in de VS. Zijn loopbaan begon als softwareontwikkelaar bij Groupe OPEN in Frankrijk. Daarna stapte hij over naar IBM als machine learning-consultant, waar hij end-to-end AI-oplossingen ontwikkelde voor verzekeringsmaatschappijen. Zoumana sloot zich aan bij Axionable, de eerste Sustainable AI-startup met vestigingen in Parijs en Montreal. Daar werkte hij als data scientist en bouwde hij AI-producten—voornamelijk NLP-usecases—voor klanten in Frankrijk, Montreal, Singapore en Zwitserland. Daarnaast wijdde hij 5% van zijn tijd aan research & development. Momenteel werkt hij als senior data scientist bij IFC – the World Bank Group.


