
कोर्स
SOLAR-10.7B परियोजना बड़े भाषा मॉडलों के विकास में एक महत्वपूर्ण छलांग का प्रतिनिधित्व करती है, जो इन मॉडलों को प्रभावी और कुशल तरीके से स्केल करने का एक नया दृष्टिकोण पेश करती है।
यह लेख पहले बताता है कि SOLAR-10.7 B मॉडल क्या है, फिर अन्य बड़े भाषा मॉडलों के मुकाबले इसके प्रदर्शन को रेखांकित करता है और इसके विशेष फाइन-ट्यून संस्करण के उपयोग की प्रक्रिया में उतरता है। अंततः, पाठक फाइन-ट्यून किए गए SOLAR-10.7 B-Instruct मॉडल के संभावित अनुप्रयोगों और उसकी सीमाओं को समझेंगे।
SOLAR-10.7B क्या है?
SOLAR-10.7B दक्षिण कोरिया में Upstage AI की एक टीम द्वारा विकसित 10.7 बिलियन पैरामीटर्स वाला मॉडल है।
Llama-2 आर्किटेक्चर पर आधारित यह मॉडल 30 बिलियन पैरामीटर्स तक वाले अन्य बड़े भाषा मॉडलों, जिनमें Mixtral 8X7B मॉडल शामिल है, को पीछे छोड़ देता है।
Llama-2 के बारे में और जानने के लिए, हमारा लेख Fine-Tuning LLaMA 2: A Step-by-Step Guide to Customizing the Large Language Model नए तरीकों का उपयोग करके मेमोरी और कंप्यूटिंग सीमाओं को पार करने तथा ओपन-सोर्स बड़े भाषा मॉडलों तक बेहतर पहुंच के लिए Llama-2 को फाइन-ट्यून करने की चरण-दर-चरण मार्गदर्शिका प्रदान करता है।
इसके अलावा, SOLAR-10.7B की मजबूत नींव पर आधारित SOLAR 10.7B-Instruct मॉडल को जटिल निर्देशों का पालन करने पर जोर देते हुए फाइन-ट्यून किया गया है। यह वैरिएंट उन्नत प्रदर्शन दर्शाता है, जो मॉडल की अनुकूलन क्षमता और विशिष्ट उद्देश्यों को प्राप्त करने में फाइन-ट्यूनिंग की प्रभावशीलता को प्रदर्शित करता है।
अंततः, SOLAR-10.7B Depth Up-Scaling नामक एक विधि पेश करता है, और आइए अगले खंड में इसे और विस्तार से जानें।
Depth Up-Scaling विधि
यह अभिनव विधि मॉडल के न्यूरल नेटवर्क की गहराई का विस्तार करने की अनुमति देती है, वह भी बिना इसके अनुरूप कंप्यूटेशनल संसाधनों में वृद्धि की आवश्यकता के। ऐसी रणनीति मॉडल की दक्षता और समग्र प्रदर्शन दोनों को बढ़ाती है।
Depth Up-Scaling के आवश्यक घटक
Depth Up-Scaling तीन मुख्य घटकों पर आधारित है: (1) Mistral 7B वेट, (2) Llama 2 फ्रेमवर्क, और (3) सतत प्री-ट्रेनिंग।
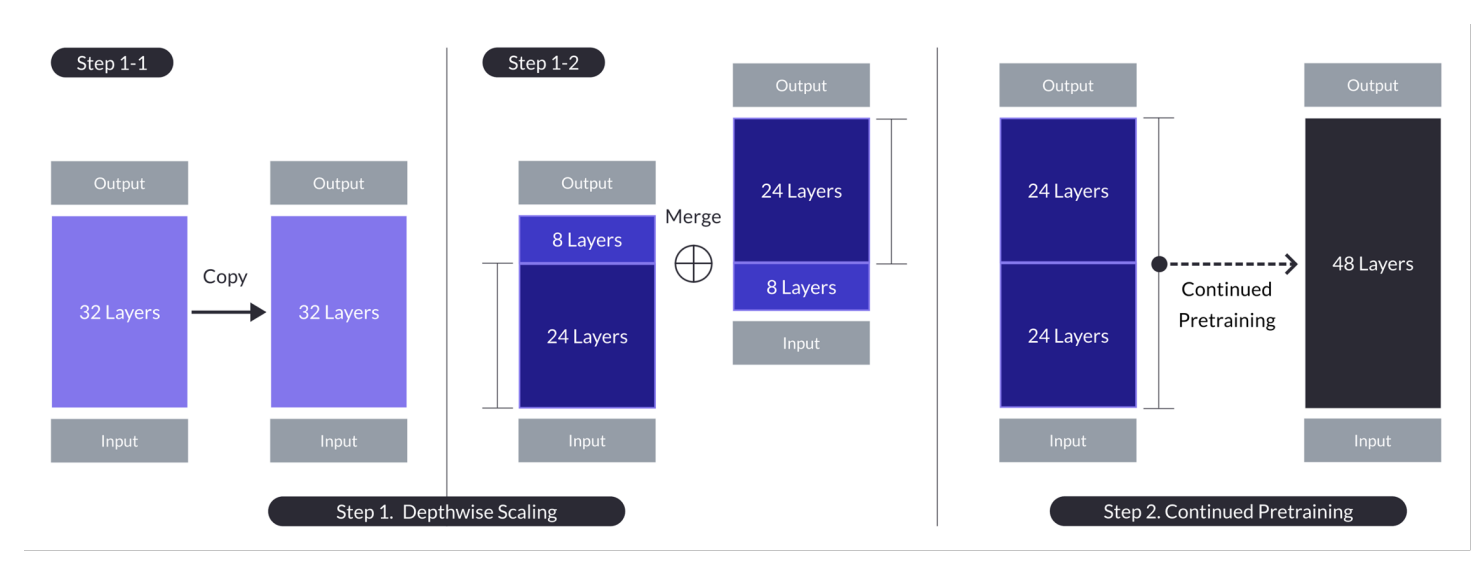
n = 32, s = 48, और m = 8 वाले मामले के लिए डेप्थ अप-स्केलिंग। डेप्थ अप-स्केलिंग को डेप्थवाइज़ स्केलिंग के बाद निरंतर प्री-ट्रेनिंग की दो-चरणीय प्रक्रिया के माध्यम से प्राप्त किया जाता है। (Source)
बेस मॉडल:
- 32-लेयर ट्रांसफॉर्मर आर्किटेक्चर का उपयोग करता है, विशेष रूप से Llama 2 मॉडल, जिसे Mistral 7B के प्री-ट्रेन वेट से इनिशियलाइज़ किया गया है।
- समुदाय संसाधनों का लाभ उठाने और उन्नत क्षमताओं के लिए नए संशोधन पेश करने के उद्देश्य से, इसकी संगतता और प्रदर्शन के लिए चुना गया।
- डेप्थवाइज़ स्केलिंग और आगे की प्री-ट्रेनिंग के लिए नींव के रूप में कार्य करता है ताकि कुशलता से स्केल किया जा सके।
डेप्थवाइज़ स्केलिंग:
- हार्डवेयर क्षमताओं को ध्यान में रखते हुए, स्केल किए गए मॉडल के लिए लक्ष्य लेयर काउंट सेट करके बेस मॉडल को स्केल करता है।
- इसमें बेस मॉडल की डुप्लिकेट प्रतिलिपि बनाना, मूल मॉडल से अंतिम m लेयर और डुप्लिकेट से शुरुआती m लेयर हटाना, फिर उन्हें जोड़कर s लेयर वाला मॉडल बनाना शामिल है।
- यह प्रक्रिया लेयरों की समायोजित संख्या वाला एक स्केल किया हुआ मॉडल बनाती है, जो 7 से 13 बिलियन पैरामीटर्स के बीच फिट बैठता है; विशेष रूप से n=32 लेयर के बेस का उपयोग करते हुए, m=8 लेयर हटाकर s=48 लेयर प्राप्त किए जाते हैं।
सतत प्री-ट्रेनिंग:
- डेप्थवाइज़ स्केलिंग के बाद प्रारंभिक प्रदर्शन में गिरावट को स्केल किए गए मॉडल की प्री-ट्रेनिंग जारी रखकर संबोधित करता है।
- सतत प्री-ट्रेनिंग के दौरान तेज प्रदर्शन रिकवरी देखी गई, जिसका श्रेय मॉडल में विषमता और असंगतियों को कम करने को दिया गया।
- बेस मॉडल के प्रदर्शन को पुनः प्राप्त करने और संभवतः उससे आगे निकलने के लिए सतत प्री-ट्रेनिंग महत्वपूर्ण है, जो प्रभावी लर्निंग के लिए डेप्थवाइज़ स्केल किए गए मॉडल की आर्किटेक्चर का लाभ उठाती है।
ये सारांश Depth Up-Scaling दृष्टिकोण की प्रमुख रणनीतियों और परिणामों को उजागर करते हैं, जो मौजूदा मॉडलों का लाभ उठाने, गहराई समायोजन के माध्यम से स्केल करने और सतत प्री-ट्रेनिंग के जरिए प्रदर्शन बढ़ाने पर केंद्रित हैं।
यह बहुआयामी दृष्टिकोण SOLAR-10.7B को कई मामलों में कहीं बड़े मॉडलों की क्षमताओं तक पहुँचने और उन्हें पार करने में सक्षम बनाता है। यह दक्षता इसे विशिष्ट अनुप्रयोगों की एक श्रृंखला के लिए प्रमुख विकल्प बनाती है, जो इसकी ताकत और लचीलेपन को दर्शाती है।
SOLAR 10.7B Instruct मॉडल कैसे काम करता है?
SOLAR-10.7B instruct जटिल निर्देशों की व्याख्या और निष्पादन में उत्कृष्ट है, जो इसे उन परिदृश्यों में अत्यंत मूल्यवान बनाता है जहाँ मानव कमांड की सटीक समझ और उस पर त्वरित प्रतिक्रिया महत्वपूर्ण होती है। यह क्षमता अधिक सहज और इंटरैक्टिव AI सिस्टम विकसित करने के लिए आवश्यक है।
- SOLAR 10.7B instruct मूल SOLAR 10.7B मॉडल को QA प्रारूप में निर्देशों का पालन करने के लिए फाइन-ट्यून करने का परिणाम है।
- फाइन-ट्यूनिंग मुख्यतः ओपन-सोर्स डेटा सेट के साथ-साथ सिंथेसाइज़्ड गणितीय QA डेटा सेट का उपयोग करती है ताकि मॉडल की गणितीय क्षमता को बढ़ाया जा सके।
- SOLAR 10.7B instruct के पहले संस्करण को Mistral 7B वेट को एकीकृत करके बनाया गया, जिससे कुशल और प्रभावी सूचना प्रसंस्करण के लिए इसकी लर्निंग क्षमताओं को सुदृढ़ किया गया।
- SOLAR 10.7B की बैकबोन Llama2 आर्किटेक्चर है, जो गति और सटीकता का संतुलन प्रदान करती है।
समग्र रूप से, फाइन-ट्यून किए गए SOLAR-10.7B मॉडल का महत्व इसके उन्नत प्रदर्शन, अनुकूलन क्षमता और व्यापक अनुप्रयोगों की संभावनाओं में निहित है, जो प्राकृतिक भाषा प्रसंस्करण और कृत्रिम बुद्धिमत्ता के क्षेत्रों को आगे बढ़ाता है।
फाइन-ट्यून किए गए SOLAR-10.7B मॉडल के संभावित अनुप्रयोग
तकनीकी क्रियान्वयन में जाने से पहले, आइए फाइन-ट्यून किए गए SOLAR-10.7B मॉडल के कुछ संभावित अनुप्रयोगों का अन्वेषण करें।
नीचे वैयक्तिकृत शिक्षा और ट्यूटरिंग, बेहतर ग्राहक सहायता, और स्वचालित कंटेंट निर्माण के कुछ उदाहरण दिए गए हैं।
- वैयक्तिकृत शिक्षा और ट्यूटरिंग: SOLAR-10.7B-Instruct व्यक्तिगत लर्निंग अनुभव प्रदान करके शिक्षा क्षेत्र में क्रांति ला सकता है। यह छात्रों के जटिल प्रश्नों को समझ सकता है और अनुरूप व्याख्याएँ, संसाधन और अभ्यास दे सकता है। यह क्षमता इसे ऐसे बुद्धिमान ट्यूटरिंग सिस्टम विकसित करने के लिए एक आदर्श उपकरण बनाती है जो व्यक्तिगत सीखने की शैली और आवश्यकताओं के अनुसार ढलते हैं, जिससे छात्र सहभागिता और परिणामों में सुधार होता है।
- बेहतर ग्राहक सहायता: SOLAR-10.7B-Instruct उन्नत चैटबॉट्स और वर्चुअल असिस्टेंट्स को शक्ति दे सकता है, जो उच्च सटीकता के साथ जटिल ग्राहक प्रश्नों को समझने और हल करने में सक्षम हों। यह अनुप्रयोग समय पर और प्रासंगिक सहायता प्रदान करके न केवल ग्राहक अनुभव में सुधार करता है, बल्कि नियमित प्रश्नों को स्वचालित करके मानव ग्राहक सेवा प्रतिनिधियों के कार्यभार को भी कम करता है।
- स्वचालित सामग्री निर्माण और सार-संक्षेप: मीडिया और कंटेंट क्रिएटर्स के लिए, SOLAR-10.7B-Instruct समाचार लेख, रिपोर्ट और रचनात्मक लेखन जैसी लिखित सामग्री का स्वचालित निर्माण करने की क्षमता प्रदान करता है। इसके अतिरिक्त, यह विस्तृत दस्तावेज़ों को संक्षिप्त, आसानी से समझ में आने वाले प्रारूपों में संक्षेपित कर सकता है, जिससे यह पत्रकारों, शोधकर्ताओं और उन पेशेवरों के लिए अमूल्य बनता है जिन्हें बड़ी मात्रा में जानकारी को शीघ्रता से आत्मसात कर उसकी रिपोर्टिंग करनी होती है।
ये उदाहरण SOLAR-10.7B-Instruct की बहुमुखी प्रतिभा और विभिन्न उद्योगों में दक्षता, पहुंच और उपयोगकर्ता अनुभव पर प्रभाव डालने और उन्हें बेहतर बनाने की क्षमता को रेखांकित करते हैं।
SOLAR -10.7B Instruct के उपयोग की चरण-दर-चरण मार्गदर्शिका
हमारे पास SOLAR-10.7B मॉडल के बारे में पर्याप्त पृष्ठभूमि है, अब व्यावहारिक रूप से काम करने का समय है।
इस खंड का उद्देश्य upstage के SOLAR 10.7 Instruct v1.0 - GGUF मॉडल को चलाने के सभी निर्देश प्रदान करना है।
कोड्स Hugging Face पर उपलब्ध आधिकारिक दस्तावेज़ से प्रेरित हैं। मुख्य चरण नीचे परिभाषित हैं:
- आवश्यक लाइब्रेरीज़ इंस्टॉल और इम्पोर्ट करें
- Hugging Face से उपयोग हेतु SOLAR-10.7B मॉडल परिभाषित करें
- मॉडल इनफ़रेंस चलाएँ
- उपयोगकर्ता के अनुरोध से परिणाम उत्पन्न करें
लाइब्रेरीज़ इंस्टॉलेशन
मुख्य लाइब्रेरीज़ हैं transformers और accelerate।
- transformers लाइब्रेरी प्री-ट्रेन मॉडलों तक पहुंच प्रदान करती है, और यहाँ निर्दिष्ट संस्करण 4.35.2 है।
- accelerate लाइब्रेरी का उद्देश्य अलग-अलग हार्डवेयर (CPU, GPU) पर मशीन लर्निंग मॉडल चलाने को सरल बनाना है, बिना हार्डवेयर विशिष्टताओं को गहराई से समझे।
%%bash
pip -q install transformers==4.35.2
pip -q install accelerate
लाइब्रेरीज़ इम्पोर्ट करें
अब जब इंस्टॉलेशन पूरा हो गया है, तो हम निम्नलिखित आवश्यक लाइब्रेरीज़ इम्पोर्ट करते हैं:
- torch PyTorch लाइब्रेरी है, जो कंप्यूटर विज़न और NLP जैसे अनुप्रयोगों में प्रयुक्त एक लोकप्रिय ओपन-सोर्स मशीन लर्निंग लाइब्रेरी है।
- AutoModelForCausalLM कॉज़ल लैंग्वेज मॉडलिंग के लिए प्री-ट्रेन मॉडल लोड करने हेतु उपयोग होता है, और AutoTokenizer पाठ को ऐसे फ़ॉर्मेट में बदलने के लिए ज़िम्मेदार है जिसे मॉडल समझ सके (टोकनाइज़ेशन)।
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
GPU कॉन्फ़िगरेशन
उपयोग किया जाने वाला मॉडल Hugging Face से SOLAR-10.7B मॉडल का संस्करण 1 है।
मॉडल को लोड करने और इनफ़रेंस प्रक्रिया को तेज करने के लिए GPU संसाधन आवश्यक है।
Google Colab पर GPU तक पहुँच नीचे दिए गए ग्राफ़िक में दर्शाई गई है:
- Runtime टैब से, Change runtime चुनें
- फिर Hardware accelerator सेक्शन से T4 GPU चुनें और बदलावों को Save करें
यह डिफ़ॉल्ट रनटाइम को T4 में स्विच कर देगा:
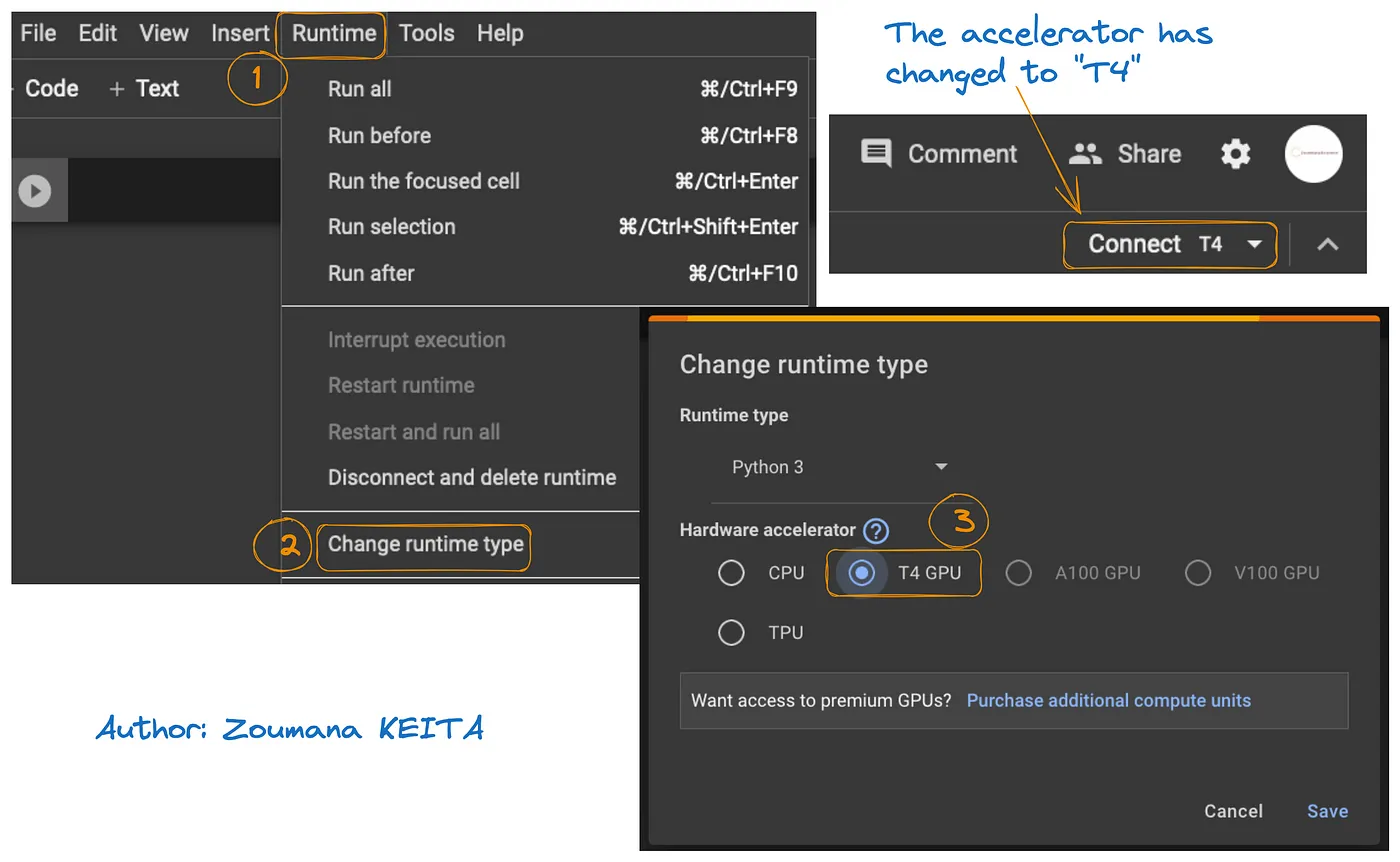
हम Colab नोटबुक से निम्नलिखित कमांड चलाकर रनटाइम की विशेषताओं की जाँच कर सकते हैं।
!nvidia-smi
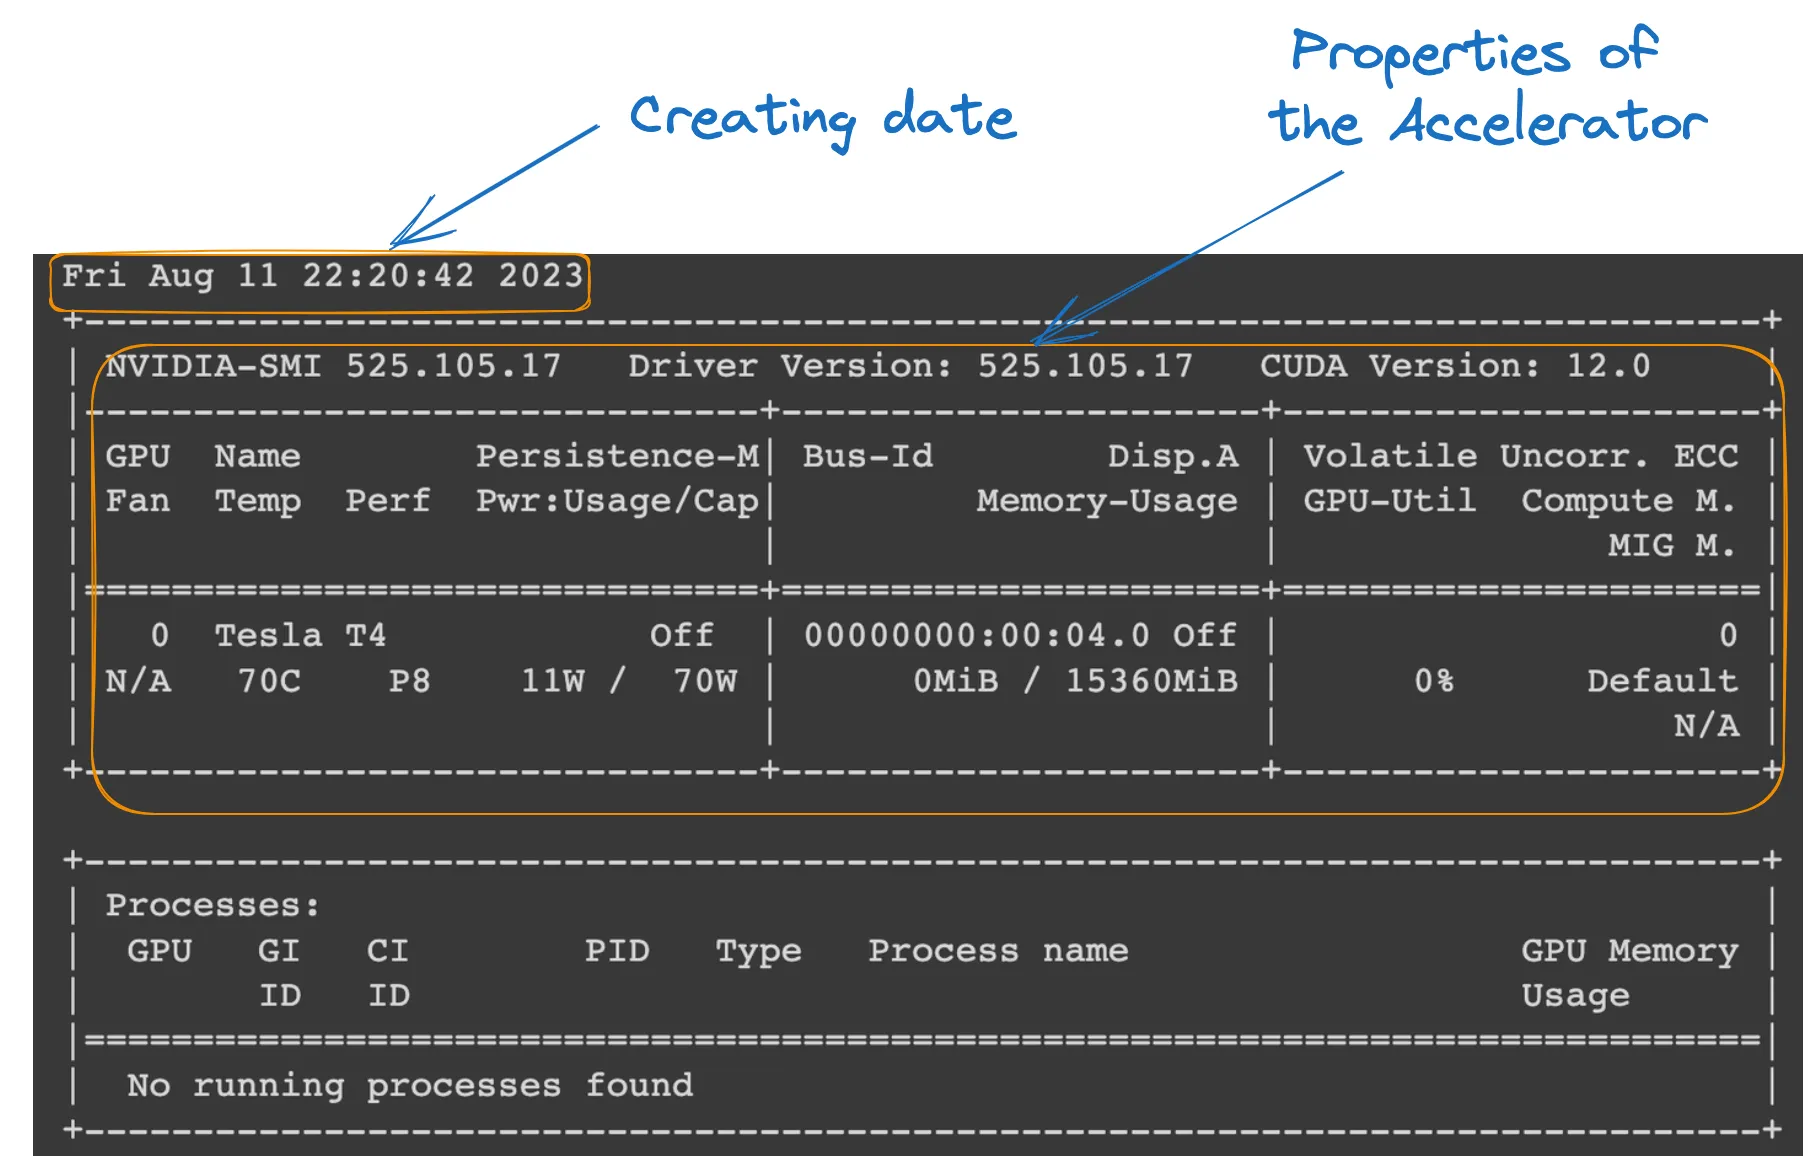
GPU गुण
मॉडल परिभाषा
सब कुछ सेट हो गया है; अब हम मॉडल को निम्नानुसार लोड कर सकते हैं:
model_ID = "Upstage/SOLAR-10.7B-Instruct-v1.0"
tokenizer = AutoTokenizer.from_pretrained(model_ID)
model = AutoModelForCausalLM.from_pretrained(
model_ID,
device_map="auto",
torch_dtype=torch.float16,
)
- model_ID वह स्ट्रिंग है जो उस प्री-ट्रेन मॉडल की विशिष्ट पहचान करती है जिसे हम उपयोग करना चाहते हैं। यहाँ "Upstage/SOLAR-10.7B-Instruct-v1.0" निर्दिष्ट है।
- AutoTokenizer.from_pretrained(model_ID) निर्दिष्ट model_ID पर प्री-ट्रेन टोकनाइज़र लोड करता है, जो इनपुट टेक्स्ट को प्रोसेस करने के लिए तैयार करता है।
- AutoModelForCausalLM.from_pretrained() स्वयं कॉज़ल लैंग्वेज मॉडल को लोड करता है, जहाँ device_map="auto" उपलब्ध सर्वश्रेष्ठ हार्डवेयर (हमने जो GPU सेट किया है) का स्वतः उपयोग करता है, और torch_dtype=torch.float16 16-बिट फ़्लोटिंग-पॉइंट का उपयोग मेमोरी बचाने और संभावित रूप से गणनाओं को तेज करने के लिए करता है।
मॉडल इनफ़रेंस
प्रतिक्रिया उत्पन्न करने से पहले, इनपुट टेक्स्ट (उपयोगकर्ता का अनुरोध) को फ़ॉर्मेट और टोकनाइज़ किया जाता है।
- user_request में मॉडल के लिए प्रश्न या इनपुट होता है।
- conversation इनपुट को संवाद का हिस्सा बनाकर फ़ॉर्मेट करता है, इसे एक भूमिका (जैसे 'user') के साथ टैग करता है।
- apply_chat_template इनपुट पर एक वार्तालाप टेम्पलेट लागू करता है, जिससे इसे उस फ़ॉर्मेट में तैयार किया जाता है जिसे मॉडल समझता है।
- tokenizer(prompt, return_tensors="pt") प्रॉम्प्ट को टोकन में बदलता है और टेंसर प्रकार (PyTorch टेंसर के लिए "pt") निर्दिष्ट करता है, और .to(model.device) सुनिश्चित करता है कि इनपुट उसी डिवाइस (CPU या GPU) पर हो जिस पर मॉडल है।
user_request = "What is the square root of 24?"
conversation = [ {'role': 'user', 'content': user_request} ]
prompt = tokenizer.apply_chat_template(conversation, tokenize=False, add_generation_prompt=True)
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
परिणाम उत्पन्न करना
अंतिम खंड इनपुट प्रश्न के लिए मॉडल का उपयोग करके प्रतिक्रिया उत्पन्न करता है और फिर उत्पन्न टेक्स्ट को डिकोड कर प्रिंट करता है।
- model.generate() दिए गए इनपुट के आधार पर टेक्स्ट उत्पन्न करता है; use_cache=True पहले से गणना किए गए परिणामों का पुन: उपयोग करके जनरेशन को तेज करता है। max_length=4096 उत्पन्न टेक्स्ट की अधिकतम लंबाई सीमित करता है।
- tokenizer.decode(outputs[0]) उत्पन्न टोकन को पुनः मानव-पठनीय टेक्स्ट में बदलता है।
- print स्टेटमेंट उपयोगकर्ता के प्रश्न का उत्पन्न उत्तर प्रदर्शित करता है।
outputs = model.generate(**inputs, use_cache=True, max_length=4096)
output_text = tokenizer.decode(outputs[0])
print(output_text)
ऊपर दिए गए कोड के सफल निष्पादन से निम्नलिखित परिणाम उत्पन्न होता है:

उपयोगकर्ता अनुरोध को निम्नलिखित टेक्स्ट से बदलने पर हमें यह प्रतिक्रिया प्राप्त होती है
user_request = "Tell me a story about the universe"

SOLAR-10.7B मॉडल की सीमाएँ
SOLAR-10.7B के सभी लाभों के बावजूद, इसकी अपनी सीमाएँ हैं, जैसे किसी भी अन्य बड़े भाषा मॉडल की होती हैं, और प्रमुख सीमाएँ नीचे रेखांकित हैं:
- हाइपरपैरामीटर्स की विस्तृत जाँच: Depth Up-Scaling (DUS) के दौरान मॉडल के हाइपरपैरामीटर्स की अधिक व्यापक जाँच की आवश्यकता एक प्रमुख सीमा है। इससे हार्डवेयर सीमाओं के कारण बेस मॉडल से 8 लेयर हटानी पड़ीं।
- उच्च कंप्यूटेशनल माँग: मॉडल कंप्यूटेशन संसाधनों के लिहाज से काफी माँग करता है, और यह कम कंप्यूटेशनल क्षमता वाले व्यक्तियों और संगठनों द्वारा इसके उपयोग को सीमित करता है।
- बायस के प्रति संवेदनशीलता: प्रशिक्षण डेटा में संभावित पक्षपात कुछ उपयोग मामलों में मॉडल के प्रदर्शन को प्रभावित कर सकता है।
- पर्यावरणीय चिंता: मॉडल का प्रशिक्षण और इनफ़रेंसिंग पर्याप्त ऊर्जा खपत की मांग करता है, जो पर्यावरणीय चिंताएँ बढ़ा सकता है।
निष्कर्ष
इस लेख ने SOLAR-10.7B मॉडल का अन्वेषण किया, डेप्थ अप-स्केलिंग दृष्टिकोण के माध्यम से कृत्रिम बुद्धिमत्ता में उसके योगदान को उजागर किया। इसमें मॉडल के संचालन और संभावित अनुप्रयोगों की रूपरेखा दी गई, और इंस्टॉलेशन से लेकर परिणाम जनरेशन तक इसके उपयोग के लिए एक व्यावहारिक मार्गदर्शिका प्रदान की गई।
अपनी क्षमताओं के बावजूद, लेख ने SOLAR-10.7B मॉडल की सीमाओं को भी संबोधित किया, ताकि उपयोगकर्ताओं को संतुलित दृष्टिकोण मिल सके। जैसे-जैसे AI विकसित होता जा रहा है, SOLAR-10.7B अधिक सुलभ और बहुमुखी AI टूल्स की दिशा में हुई प्रगति का उदाहरण प्रस्तुत करता है।
जो लोग AI की संभावनाओं में और गहराई से उतरना चाहते हैं, उनके लिए हमारा ट्यूटोरियल FLAN-T5 Tutorial: Guide and Fine-Tuning transformers लाइब्रेरी का उपयोग करके प्रश्न-उत्तर कार्य हेतु FLAN-T5 मॉडल को फाइन-ट्यून करने और वास्तविक दुनिया के परिदृश्य में अनुकूलित इनफ़रेंस चलाने की संपूर्ण मार्गदर्शिका प्रदान करता है। आप हमारा Fine-Tuning GPT-3.5 ट्यूटोरियल और अपने स्वयं के LlaMA 2 मॉडल को फाइन-ट्यून करने पर हमारा कोड-अलॉन्ग भी देख सकते हैं।
बहु-प्रतिभाशाली डेटा साइंटिस्ट जो अपना ज्ञान साझा करने और समुदाय को वापस देने में आनंद लेते हैं, ज़ूमाना YouTube पर कंटेंट क्रिएटर हैं और Medium पर शीर्ष तकनीकी लेखक हैं। उन्हें बोलने, कोडिंग करने और पढ़ाने में खुशी मिलती है। ज़ूमाना के पास दो मास्टर डिग्री हैं—पहली पेरिस, फ्रांस से कंप्यूटर साइंस में, मशीन लर्निंग पर केंद्रित, और दूसरी अमेरिका के टेक्सास टेक यूनिवर्सिटी से डेटा साइंस में। उनका करियर फ्रांस में Groupe OPEN में सॉफ्टवेयर डेवलपर के रूप में शुरू हुआ, जिसके बाद वे IBM में मशीन लर्निंग कंसल्टेंट बने, जहाँ उन्होंने बीमा कंपनियों के लिए एंड-टू-एंड एआई समाधान विकसित किए। ज़ूमाना ने Axionable, पेरिस और मॉन्ट्रियल स्थित पहली Sustainable AI स्टार्टअप, से जुड़कर डेटा साइंटिस्ट के रूप में काम किया और फ्रांस, मॉन्ट्रियल, सिंगापुर और स्विट्ज़रलैंड के क्लाइंट्स के लिए मुख्यतः NLP उपयोग मामलों पर आधारित एआई प्रोडक्ट्स लागू किए। इसके अतिरिक्त, अपने समय का 5% उन्होंने अनुसंधान और विकास को समर्पित किया। वर्तमान में, वे IFC - The World Bank Group में सीनियर डेटा साइंटिस्ट के रूप में कार्यरत हैं।
