
Cours
Le projet SOLAR-10.7B marque une avancée majeure dans le développement des grands modèles de langage, avec une nouvelle approche pour les faire monter en échelle de façon efficace et efficiente.
Cet article commence par expliquer ce qu’est le modèle SOLAR-10.7B, puis présente ses performances par rapport à d’autres grands modèles de langage et détaille l’utilisation de sa version spécialisée fine-tunée. Enfin, vous comprendrez les cas d’usage possibles du modèle SOLAR-10.7B-Instruct affiné ainsi que ses limites.
Qu’est-ce que SOLAR-10.7B ?
SOLAR-10.7B est un modèle de 10,7 milliards de paramètres développé par une équipe d’Upstage AI en Corée du Sud.
Basé sur l’architecture Llama-2, ce modèle dépasse d’autres grands modèles allant jusqu’à 30 milliards de paramètres, y compris Mixtral 8X7B.
Pour en savoir plus sur Llama-2, notre article Affiner LLaMA 2 : guide pas à pas pour personnaliser le grand modèle de langage propose un tutoriel étape par étape pour affiner Llama-2, avec de nouvelles approches pour contourner les contraintes de mémoire et de calcul et faciliter l’accès aux modèles open source.
Par ailleurs, sur cette base robuste, le modèle SOLAR-10.7B-Instruct est affiné avec un accent particulier sur le suivi d’instructions complexes. Cette variante affiche de meilleures performances, illustrant l’adaptabilité du modèle et l’efficacité du fine-tuning pour atteindre des objectifs spécialisés.
Enfin, SOLAR-10.7B introduit une méthode appelée Depth Up-Scaling, que nous allons explorer dans la section suivante.
La méthode Depth Up-Scaling
Cette méthode innovante permet d’augmenter la profondeur du réseau neuronal du modèle sans exiger une hausse proportionnelle des ressources de calcul. Elle améliore ainsi à la fois l’efficience et les performances globales du modèle.
Éléments clés du Depth Up-Scaling
Le Depth Up-Scaling repose sur trois composantes principales : (1) les poids de Mistral 7B, (2) le cadre Llama 2, et (3) un pré-entraînement continu.
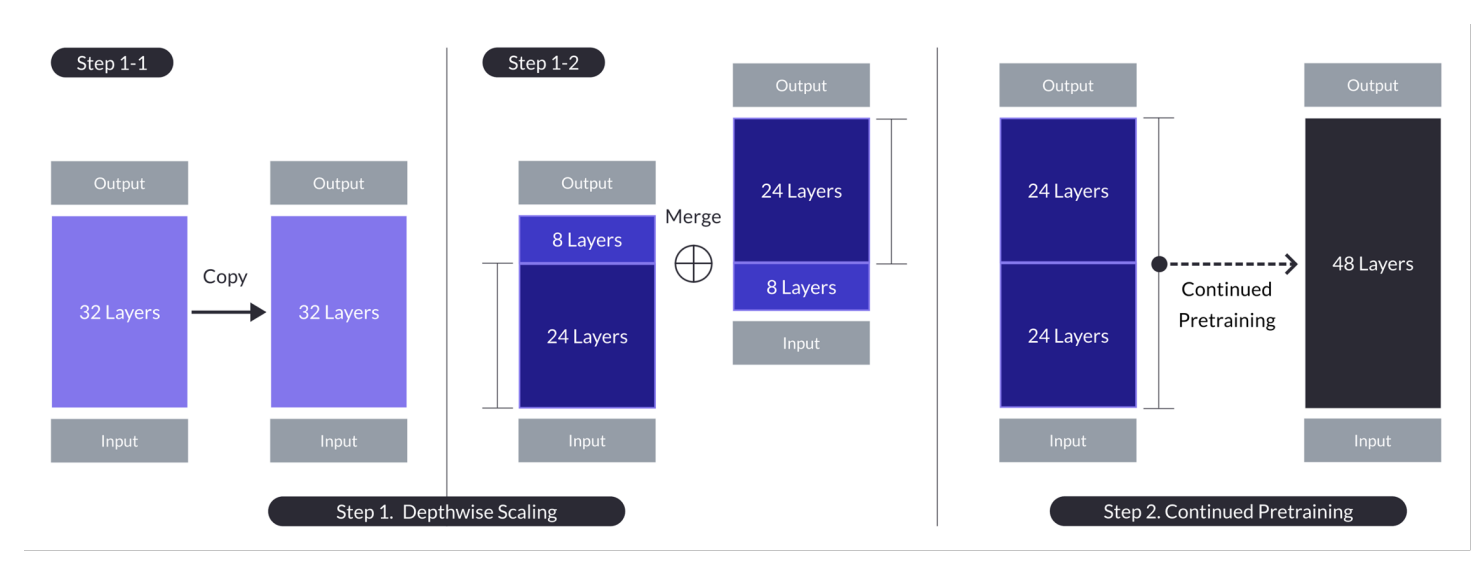
Mise à l’échelle en profondeur pour le cas n = 32, s = 48 et m = 8. La montée en profondeur se fait en deux étapes : scaling en profondeur puis pré-entraînement continu. (Source)
Modèle de base :
- Utilise une architecture Transformer à 32 couches, en l’occurrence Llama 2, initialisée avec des poids pré-entraînés de Mistral 7B.
- Choisie pour sa compatibilité et ses performances, afin de tirer parti des ressources de la communauté et d’introduire des modifications inédites pour accroître les capacités.
- Servez de fondation pour la montée en profondeur et le pré-entraînement ultérieur afin d’augmenter l’échelle efficacement.
Montée en profondeur (Depthwise Scaling) :
- Fait évoluer le modèle de base en définissant un nombre cible de couches pour le modèle mis à l’échelle, en tenant compte du matériel disponible.
- Consiste à dupliquer le modèle de base, à retirer les m dernières couches de l’original et les m premières couches du duplicata, puis à les concaténer pour former un modèle à s couches.
- Ce procédé crée un modèle mis à l’échelle avec un nombre de couches ajusté pour se situer entre 7 et 13 milliards de paramètres, en partant de n=32 couches et en retirant m=8 couches pour obtenir s=48 couches.
Pré-entraînement continu :
- Compense la baisse initiale de performance après la montée en profondeur en poursuivant le pré-entraînement du modèle mis à l’échelle.
- Une reprise rapide des performances a été observée durant ce pré-entraînement continu, attribuée à la réduction de l’hétérogénéité et des écarts dans le modèle.
- Le pré-entraînement continu est essentiel pour retrouver, voire dépasser, les performances du modèle de base en tirant parti de l’architecture issue de la montée en profondeur.
Ces synthèses mettent en évidence les stratégies et résultats clés de l’approche Depth Up-Scaling : capitaliser sur des modèles existants, augmenter l’échelle via l’ajustement de la profondeur et renforcer les performances grâce au pré-entraînement continu.
Grâce à cette approche multidimensionnelle, SOLAR-10.7B atteint, et souvent dépasse, les capacités de modèles bien plus volumineux. Cette efficience en fait un excellent choix pour de nombreux cas d’usage, démontrant sa puissance et sa flexibilité.
Comment fonctionne le modèle SOLAR-10.7B Instruct ?
SOLAR-10.7B Instruct excelle dans l’interprétation et l’exécution d’instructions complexes, ce qui est précieux dans des contextes où la compréhension fine et la réactivité aux consignes humaines sont cruciales. Cette capacité est essentielle pour concevoir des systèmes d’IA plus intuitifs et interactifs.
- SOLAR-10.7B Instruct est obtenu en affinant le modèle SOLAR-10.7B d’origine pour suivre des instructions au format questions-réponses.
- Le fine-tuning s’appuie principalement sur des jeux de données open source, complétés par des jeux de QA mathématiques synthétiques afin d’améliorer les compétences en mathématiques du modèle.
- La première version de SOLAR-10.7B Instruct a été créée en intégrant les poids de Mistral 7B pour renforcer ses capacités d’apprentissage et optimiser le traitement de l’information.
- La colonne vertébrale de SOLAR-10.7B est l’architecture Llama2, qui concilie vitesse et précision.
Globalement, l’intérêt du modèle SOLAR-10.7B affiné réside dans ses performances accrues, son adaptabilité et son potentiel d’applications à grande échelle, faisant progresser le traitement du langage naturel et l’intelligence artificielle.
Applications possibles du modèle SOLAR-10.7B affiné
Avant de passer à la mise en œuvre technique, explorons quelques cas d’usage potentiels d’un modèle SOLAR-10.7B affiné.
Voici des exemples en éducation personnalisée et tutorat, support client amélioré et création de contenu automatisée.
- Éducation personnalisée et tutorat : SOLAR-10.7B-Instruct peut transformer le secteur éducatif en offrant des expériences d’apprentissage personnalisées. Il comprend des questions complexes d’apprenants et propose des explications, ressources et exercices adaptés. Idéal pour bâtir des systèmes de tutorat intelligents qui s’ajustent aux styles et besoins d’apprentissage, afin de renforcer l’engagement et les résultats.
- Support client renforcé : SOLAR-10.7B-Instruct peut propulser des chatbots et assistants virtuels avancés, capables de comprendre et résoudre des demandes complexes avec une grande précision. Cette application améliore l’expérience client grâce à un support pertinent et rapide, tout en réduisant la charge des équipes en automatisant les demandes récurrentes.
- Génération et synthèse de contenu automatisées : Pour les médias et créateurs, SOLAR-10.7B-Instruct permet d’automatiser la rédaction d’articles, de rapports ou de contenus créatifs. Il peut aussi résumer de longs documents en formats courts et faciles à lire, un atout pour journalistes, chercheurs et professionnels qui doivent assimiler rapidement de gros volumes d’informations.
Ces exemples illustrent la polyvalence et le potentiel de SOLAR-10.7B-Instruct pour améliorer l’efficacité, l’accessibilité et l’expérience utilisateur dans de nombreux secteurs.
Guide pas à pas pour utiliser SOLAR-10.7B Instruct
Nous avons désormais le contexte nécessaire sur SOLAR-10.7B : passons à la pratique.
Cette section fournit toutes les instructions pour exécuter le modèle SOLAR 10.7 Instruct v1.0 - GGUF d’Upstage.
Les extraits de code s’inspirent de la documentation officielle sur Hugging Face. Les principales étapes sont :
- Installer et importer les bibliothèques nécessaires
- Définir le modèle SOLAR-10.7B à utiliser depuis Hugging Face
- Exécuter l’inférence du modèle
- Générer le résultat à partir de la demande de l’utilisateur
Installation des bibliothèques
Les bibliothèques principales sont transformers et accelerate.
- La bibliothèque transformers donne accès à des modèles pré-entraînés. La version indiquée ici est la 4.35.2.
- La bibliothèque accelerate simplifie l’exécution de modèles de machine learning sur différents matériels (CPU, GPU) sans devoir maîtriser les spécificités matérielles.
%%bash
pip -q install transformers==4.35.2
pip -q install accelerate
Importer les bibliothèques
Une fois l’installation terminée, importez les bibliothèques suivantes :
- torch est la bibliothèque PyTorch, un framework open source populaire pour la vision par ordinateur et le NLP.
- AutoModelForCausalLM charge un modèle pré-entraîné pour le language modeling causal, et AutoTokenizer convertit le texte en un format compréhensible par le modèle (tokenisation).
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
Configuration du GPU
Le modèle utilisé est la version 1 de SOLAR-10.7B depuis Hugging Face.
Une ressource GPU est nécessaire pour accélérer le chargement du modèle et l’inférence.
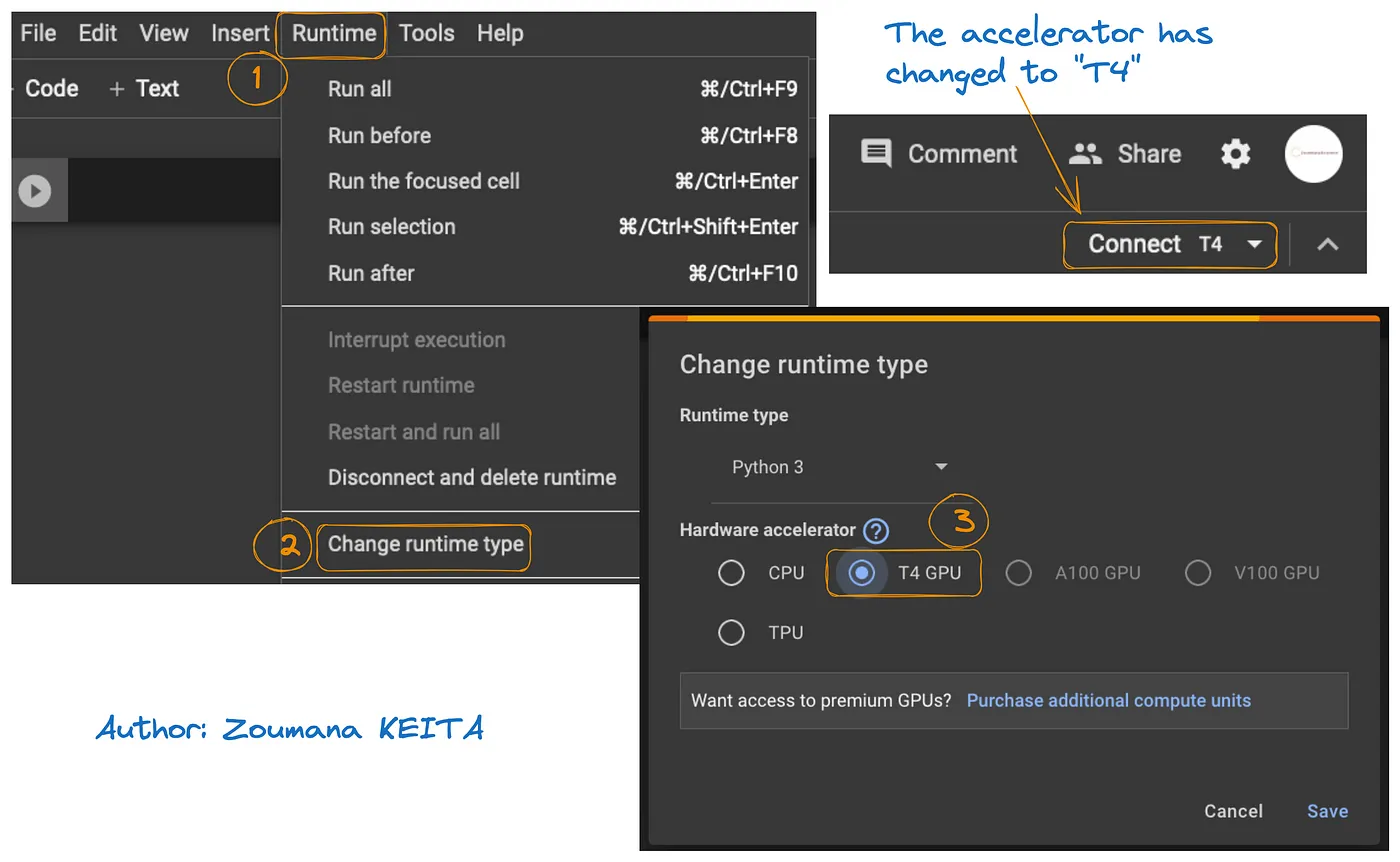
L’accès au GPU sur Google Colab est illustré ci-dessous :
- Dans l’onglet Runtime, sélectionnez Change runtime
- Choisissez ensuite T4 GPU dans la section Hardware accelerator et Save pour enregistrer
Cela basculera l’environnement d’exécution par défaut sur T4 :
Vous pouvez vérifier les propriétés de l’environnement en exécutant la commande suivante dans le notebook Colab.
!nvidia-smi
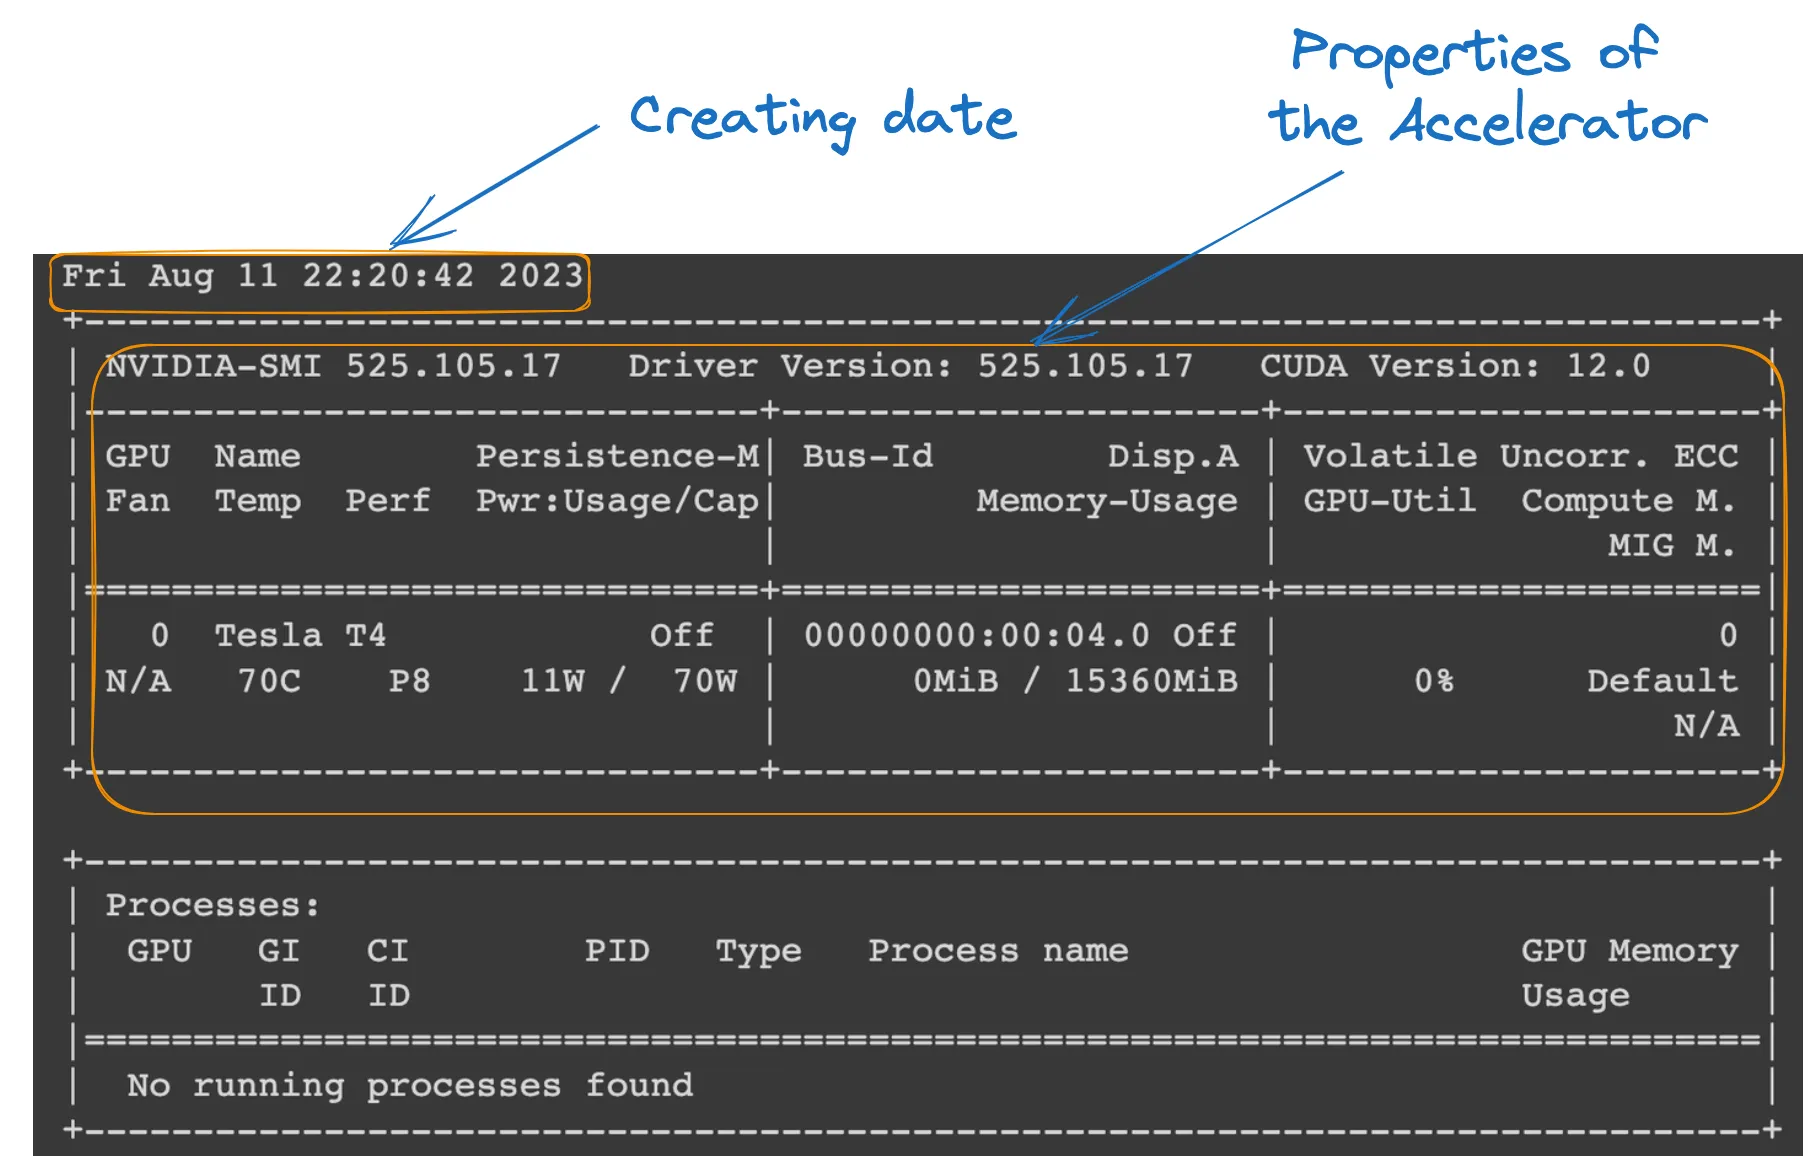
Propriétés du GPU
Définition du modèle
Tout est en place : chargeons le modèle comme suit :
model_ID = "Upstage/SOLAR-10.7B-Instruct-v1.0"
tokenizer = AutoTokenizer.from_pretrained(model_ID)
model = AutoModelForCausalLM.from_pretrained(
model_ID,
device_map="auto",
torch_dtype=torch.float16,
)
- model_ID est une chaîne qui identifie de manière unique le modèle pré-entraîné à utiliser. Ici, "Upstage/SOLAR-10.7B-Instruct-v1.0".
- AutoTokenizer.from_pretrained(model_ID) charge un tokenizer pré-entraîné associé à ce model_ID pour préparer le texte en entrée.
- AutoModelForCausalLM.from_pretrained() charge le modèle de langage causal, avec device_map="auto" pour exploiter automatiquement le meilleur matériel disponible (le GPU configuré) et torch_dtype=torch.float16 pour utiliser des flottants 16 bits, économisant de la mémoire et accélérant potentiellement les calculs.
Inférence du modèle
Avant de générer une réponse, le texte d’entrée (la demande de l’utilisateur) est formaté et tokenisé.
- user_request contient la question ou l’entrée destinée au modèle.
- conversation met en forme l’entrée dans un format conversationnel, avec un rôle (par ex. : « user »).
- apply_chat_template applique un gabarit conversationnel à l’entrée, dans un format que le modèle comprend.
- tokenizer(prompt, return_tensors="pt") convertit l’invite en tokens et précise le type de tenseur (« pt » pour PyTorch), tandis que .to(model.device) garantit que l’entrée est sur le même dispositif (CPU ou GPU) que le modèle.
user_request = "What is the square root of 24?"
conversation = [ {'role': 'user', 'content': user_request} ]
prompt = tokenizer.apply_chat_template(conversation, tokenize=False, add_generation_prompt=True)
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
Génération du résultat
La section finale utilise le modèle pour générer une réponse à la question d’entrée, puis décode et affiche le texte généré.
- model.generate() génère du texte à partir des entrées fournies, avec use_cache=True pour accélérer la génération en réutilisant des calculs antérieurs. max_length=4096 limite la longueur maximale du texte généré.
- tokenizer.decode(outputs[0]) reconvertit les tokens générés en texte lisible.
- L’instruction print affiche la réponse générée à la question de l’utilisateur.
outputs = model.generate(**inputs, use_cache=True, max_length=4096)
output_text = tokenizer.decode(outputs[0])
print(output_text)
L’exécution réussie du code ci-dessus génère le résultat suivant :

En remplaçant la demande utilisateur par le texte suivant, on obtient la réponse générée :
user_request = "Tell me a story about the universe"

Limites du modèle SOLAR-10.7B
Malgré ses atouts, SOLAR-10.7B présente des limites, comme tout grand modèle de langage. Les principales sont les suivantes :
- Exploration approfondie des hyperparamètres : la nécessité d’explorer plus largement les hyperparamètres durant le Depth Up-Scaling (DUS) constitue une limite clé. Elle a conduit à retirer 8 couches du modèle de base pour des raisons matérielles.
- Forte exigence de calcul : le modèle requiert des ressources de calcul importantes, ce qui en limite l’usage pour des individus ou organisations disposant de capacités moindres.
- Vulnérabilité aux biais : des biais potentiels dans les données d’entraînement peuvent affecter les performances du modèle selon les cas d’usage.
- Impact environnemental : l’entraînement et l’inférence du modèle consomment beaucoup d’énergie, ce qui peut soulever des préoccupations environnementales.
Conclusion
Cet article a présenté le modèle SOLAR-10.7B, en soulignant sa contribution à l’intelligence artificielle grâce à l’approche de montée en profondeur. Il a décrit son fonctionnement, ses cas d’usage possibles et fourni un guide pratique, de l’installation jusqu’à la génération de résultats.
Tout en reconnaissant ses capacités, nous avons également abordé les limites du modèle SOLAR-10.7B pour offrir une vision équilibrée aux utilisateurs. À mesure que l’IA évolue, SOLAR-10.7B illustre les progrès vers des outils plus accessibles et polyvalents.
Pour aller plus loin, notre tutoriel Tutoriel FLAN-T5 : guide et fine-tuning propose un guide complet pour affiner un modèle FLAN-T5 sur une tâche de questions-réponses avec la bibliothèque transformers et exécuter une inférence optimisée en situation réelle. Consultez aussi notre tutoriel sur le fine-tuning de GPT-3.5 et notre code-along sur le fine-tuning de votre propre modèle LlaMA 2.
Scientifique de données aux multiples talents qui aime partager ses connaissances et rendre service aux autres, Zoumana est un créateur de contenu sur YouTube et un rédacteur technique de premier plan sur Medium. Il prend plaisir à parler, à coder et à enseigner. Zoumana est titulaire de deux masters. Le premier en informatique avec une spécialisation en apprentissage automatique à Paris, en France, et le second en science des données à l'université Texas Tech aux États-Unis. Son parcours professionnel a débuté en tant que développeur de logiciels au sein du Groupe OPEN en France, avant de rejoindre IBM en tant que consultant en apprentissage automatique, où il a développé des solutions d'IA de bout en bout pour les compagnies d'assurance. Zoumana a rejoint Axionable, la première startup d'IA durable basée à Paris et Montréal. Il y a occupé le poste de Data Scientist et a mis en œuvre des produits d'IA, principalement des cas d'utilisation NLP, pour des clients en France, à Montréal, à Singapour et en Suisse. En outre, 5 % de son temps a été consacré à la recherche et au développement. Il travaille actuellement en tant que scientifique de données senior à l'IFC, le groupe de la Banque mondiale.
