Pular para o conteúdo principal

Tutorial do modelo ajustado SOLAR-10.7B

Um guia completo para usar o modelo SOLAR-10.7B ajustado para tarefas baseadas em instruções em um cenário real.
Atualizado 17 de set. de 2026  · 13 min lido

Explorar com IA

ChatGPTClaudePerplexity

O projeto SOLAR-10.7B representa um salto importante no desenvolvimento de grandes modelos de linguagem, trazendo uma nova forma de escalar esses modelos de maneira eficaz e eficiente.

Este artigo começa explicando o que é o modelo SOLAR-10.7B, depois destaca seu desempenho em comparação com outros grandes modelos de linguagem e aprofunda o uso de sua versão especializada e ajustada por fine-tuning. Por fim, você vai entender as aplicações potenciais do modelo ajustado SOLAR-10.7B-Instruct e também suas limitações.

O que é o SOLAR-10.7B?

SOLAR-10.7B é um modelo com 10,7 bilhões de parâmetros desenvolvido por uma equipe da Upstage AI, na Coreia do Sul.

Baseado na arquitetura do Llama-2, esse modelo supera outros LLMs com até 30 bilhões de parâmetros, incluindo o Mixtral 8X7B.

Para saber mais sobre Llama-2, nosso artigo Fine-Tuning LLaMA 2: A Step-by-Step Guide to Customizing the Large Language Model traz um passo a passo de como ajustar o Llama-2, com novas abordagens para contornar limitações de memória e computação e ampliar o acesso a LLMs open source.

Além disso, com base na base robusta do SOLAR-10.7B, o modelo SOLAR-10.7B-Instruct passa por fine-tuning com foco em seguir instruções complexas. Essa variante demonstra desempenho superior, evidenciando a adaptabilidade do modelo e a eficácia do fine-tuning para atingir objetivos especializados.

Por fim, o SOLAR-10.7B introduz um método chamado Depth Up-Scaling. Vamos explorar melhor esse conceito a seguir.

O método Depth Up-Scaling

Esse método inovador permite expandir a profundidade da rede neural do modelo sem exigir um aumento proporcional de recursos computacionais. Essa estratégia melhora tanto a eficiência quanto o desempenho geral do modelo.

Elementos essenciais do Depth Up-Scaling

O Depth Up-Scaling se baseia em três componentes principais: (1) pesos do Mistral 7B, (2) framework Llama 2 e (3) pré-treinamento contínuo.
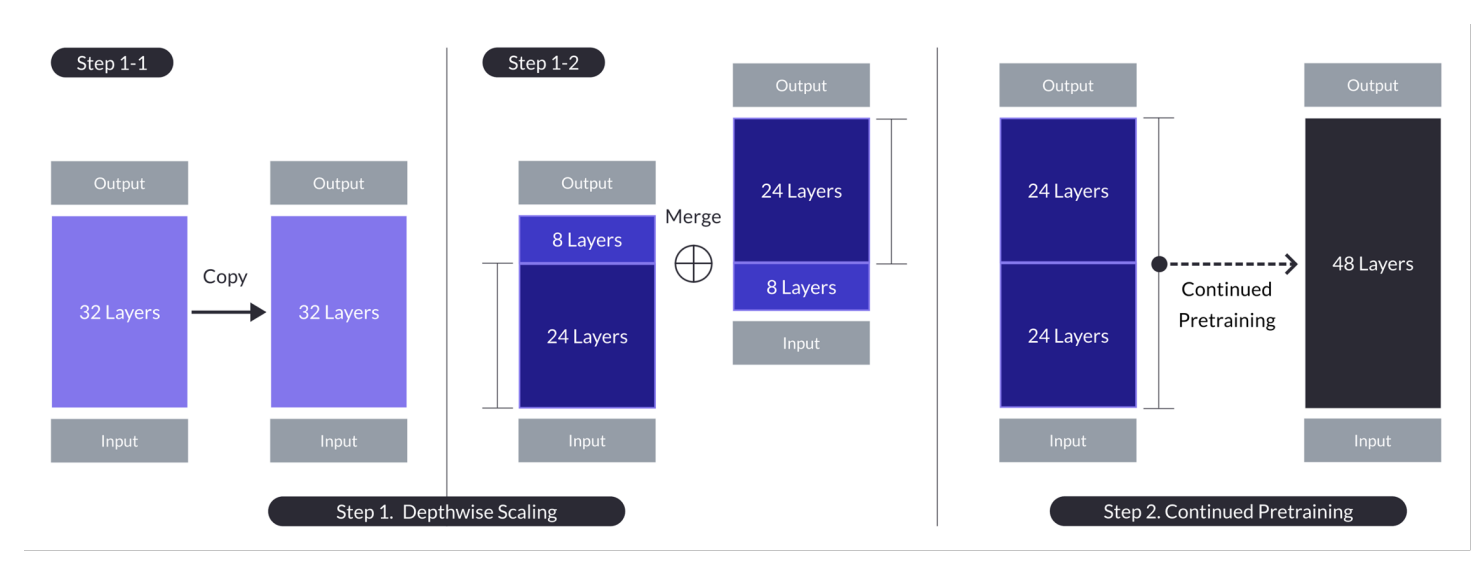
Depth up-scaling for the case with n = 32, s = 48, and m = 8. Depth up-scaling is achieved through a dual-stage process of depthwise scaling followed by continued pretraining. (Source)

Depth up-scaling para o caso com n = 32, s = 48 e m = 8. O depth up-scaling é obtido por um processo em duas etapas: aumento de profundidade e, em seguida, pré-treinamento contínuo. (Fonte)

Modelo base:

  • Utiliza uma arquitetura transformer de 32 camadas, especificamente o modelo Llama 2, inicializado com pesos pré-treinados do Mistral 7B.
  • Escolhido por sua compatibilidade e desempenho, visando aproveitar recursos da comunidade e introduzir modificações para ampliar as capacidades.
  • Serve como base para o aumento de profundidade e para o pré-treinamento posterior, permitindo escalar com eficiência.

Aumento de profundidade (Depthwise Scaling):

  • Escala o modelo base definindo uma contagem-alvo de camadas para o modelo ampliado, levando em conta as capacidades de hardware.
  • Envolve duplicar o modelo base, remover as m camadas finais do original e as m camadas iniciais da cópia e, em seguida, concatená-los para formar um modelo com s camadas.
  • Esse processo cria um modelo escalado com número de camadas ajustado para ficar entre 7 e 13 bilhões de parâmetros, usando especificamente uma base de n=32 camadas, removendo m=8 camadas para chegar a s=48 camadas.

Pré-treinamento contínuo:

  • Trata a queda inicial de desempenho após o aumento de profundidade ao continuar o pré-treinamento do modelo escalado.
  • Observou-se uma rápida recuperação de desempenho durante o pré-treinamento contínuo, atribuída à redução de heterogeneidade e discrepâncias no modelo.
  • O pré-treinamento contínuo é crucial para recuperar e potencialmente superar o desempenho do modelo base, aproveitando a arquitetura com maior profundidade para um aprendizado mais eficaz.

Esses pontos destacam as estratégias e os resultados do Depth Up-Scaling, com foco em aproveitar modelos existentes, escalar ajustando a profundidade e melhorar o desempenho por meio de pré-treinamento contínuo.

Com essa abordagem multifacetada, o SOLAR-10.7B alcança — e, em muitos casos, supera — as capacidades de modelos bem maiores. Essa eficiência o torna uma ótima escolha para diversas aplicações específicas, evidenciando sua força e flexibilidade.

Como funciona o SOLAR-10.7B Instruct?

O SOLAR-10.7B Instruct se destaca em interpretar e executar instruções complexas, o que é extremamente valioso em cenários onde a compreensão precisa e a resposta a comandos humanos são cruciais. Essa capacidade é essencial para desenvolver sistemas de IA mais intuitivos e interativos.

  • O SOLAR-10.7B Instruct é resultado do fine-tuning do SOLAR-10.7B original para seguir instruções em formato de perguntas e respostas (QA).
  • O fine-tuning usa majoritariamente datasets open source, além de conjuntos de QA matemáticos sintetizados para aprimorar as habilidades do modelo em matemática.
  • A primeira versão do SOLAR-10.7B Instruct foi criada integrando os pesos do Mistral 7B para fortalecer sua capacidade de aprendizado e processar informações com eficiência.
  • A espinha dorsal do SOLAR-10.7B é a arquitetura Llama 2, que equilibra velocidade e precisão.

Em resumo, a importância do SOLAR-10.7B ajustado está em seu desempenho superior, adaptabilidade e potencial de aplicação ampla, impulsionando os campos de processamento de linguagem natural e inteligência artificial.

Aplicações potenciais do modelo SOLAR-10.7B ajustado

Antes de ir para a implementação técnica, vamos explorar algumas aplicações potenciais de um SOLAR-10.7B ajustado por fine-tuning.

Abaixo estão alguns exemplos em educação personalizada e tutoria, atendimento ao cliente aprimorado e criação automatizada de conteúdo.

  • Educação personalizada e tutoria: o SOLAR-10.7B-Instruct pode transformar o setor de educação ao oferecer experiências de aprendizado personalizadas. Ele entende dúvidas complexas dos alunos e oferece explicações, recursos e exercícios sob medida. Essa capacidade o torna ideal para desenvolver sistemas de tutoria inteligentes que se adaptam ao estilo e às necessidades de aprendizado de cada pessoa, aumentando o engajamento e os resultados.
  • Atendimento ao cliente melhor: o SOLAR-10.7B-Instruct pode impulsionar chatbots e assistentes virtuais avançados, capazes de entender e resolver dúvidas complexas de clientes com alta precisão. Isso melhora a experiência do cliente com suporte rápido e relevante e reduz a carga das equipes de atendimento ao automatizar solicitações rotineiras.
  • Criação e sumarização automatizada de conteúdo: para mídia e criadores, o SOLAR-10.7B-Instruct permite automatizar a geração de textos como notícias, relatórios e até escrita criativa. Além disso, ele pode resumir documentos extensos em formatos concisos e fáceis de entender, sendo valioso para jornalistas, pesquisadores e profissionais que precisam assimilar e reportar grandes volumes de informação rapidamente.

Esses exemplos mostram a versatilidade e o potencial do SOLAR-10.7B-Instruct para impactar e melhorar eficiência, acessibilidade e experiência do usuário em diversos setores.

Guia passo a passo para usar o SOLAR-10.7B Instruct

Já temos o contexto necessário sobre o SOLAR-10.7B; agora é hora de colocar a mão na massa.

Esta seção reúne todas as instruções para executar o modelo SOLAR 10.7 Instruct v1.0 - GGUF da Upstage.

Os códigos são inspirados na documentação oficial no Hugging Face. As etapas principais são:

  • Instalar e importar as bibliotecas necessárias
  • Definir o modelo SOLAR-10.7B a usar no Hugging Face
  • Executar a inferência do modelo
  • Gerar o resultado a partir da solicitação do usuário

Instalação das bibliotecas

As principais bibliotecas usadas são transformers e accelerate.

  • A biblioteca transformers dá acesso a modelos pré-treinados; aqui usamos a versão 4.35.2.
  • A biblioteca accelerate simplifica a execução de modelos de ML em diferentes hardwares (CPUs, GPUs) sem exigir conhecimento profundo das particularidades do hardware.
%%bash
pip -q install transformers==4.35.2
pip -q install accelerate

Importar bibliotecas

Com a instalação concluída, vamos importar as bibliotecas necessárias:

  • torch é a biblioteca PyTorch, muito usada para aplicações como visão computacional e PLN.
  • AutoModelForCausalLM carrega um modelo pré-treinado para modelagem de linguagem causal, e AutoTokenizer converte o texto para um formato que o modelo entende (tokenização).
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

Configuração de GPU

O modelo utilizado é a versão 1 do SOLAR-10.7B disponível no Hugging Face.

É necessário ter GPU para agilizar o carregamento e a inferência do modelo.

O acesso à GPU no Google Colab é ilustrado no gráfico abaixo:

  • No menu Runtime, selecione Change runtime
  • Em seguida, escolha T4 GPU em Hardware accelerator e Save as alterações

Isso vai alterar o runtime padrão para T4:
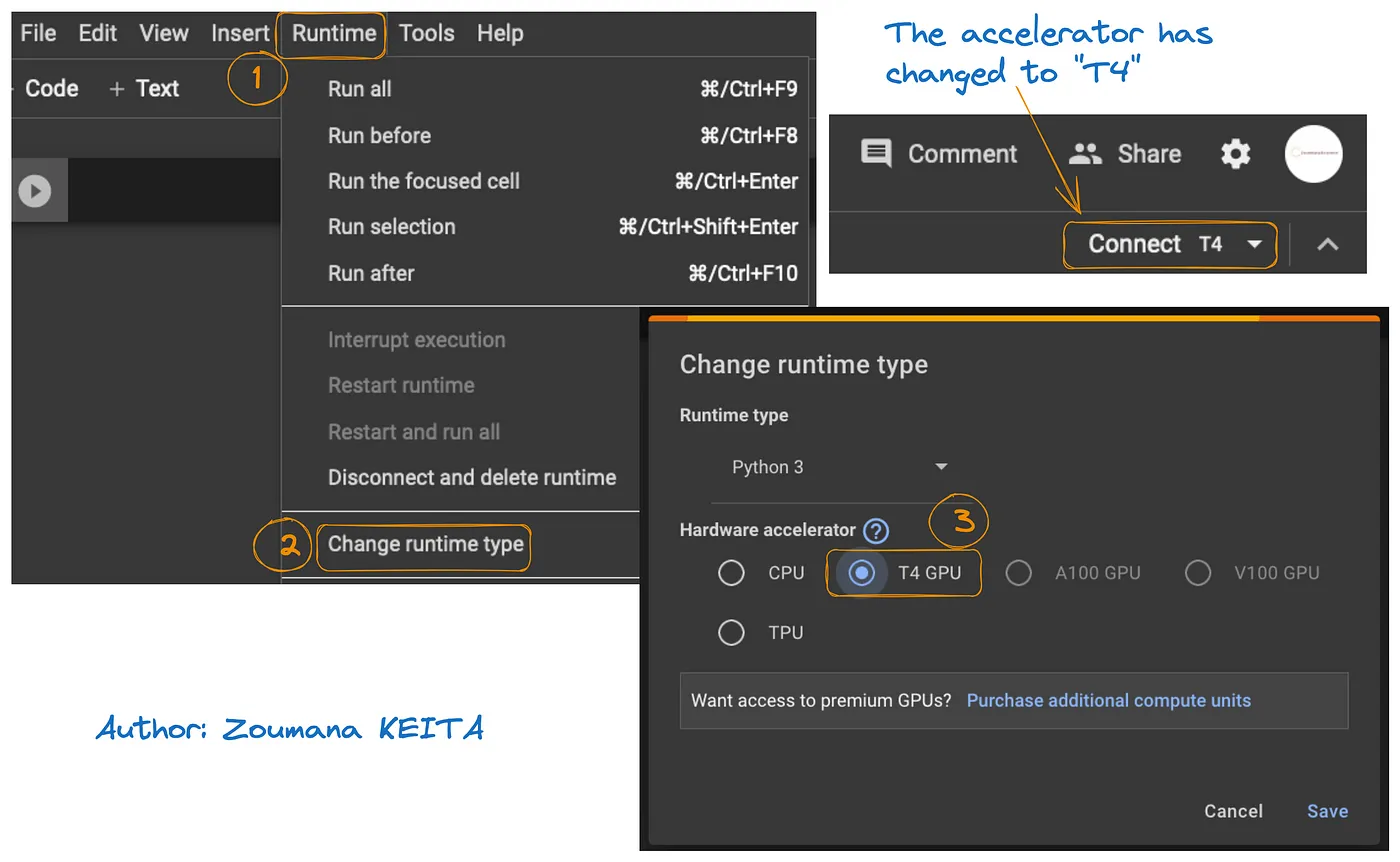
GPU access from Google Colab

Podemos checar as propriedades do runtime executando o comando abaixo no notebook do Colab.

!nvidia-smi
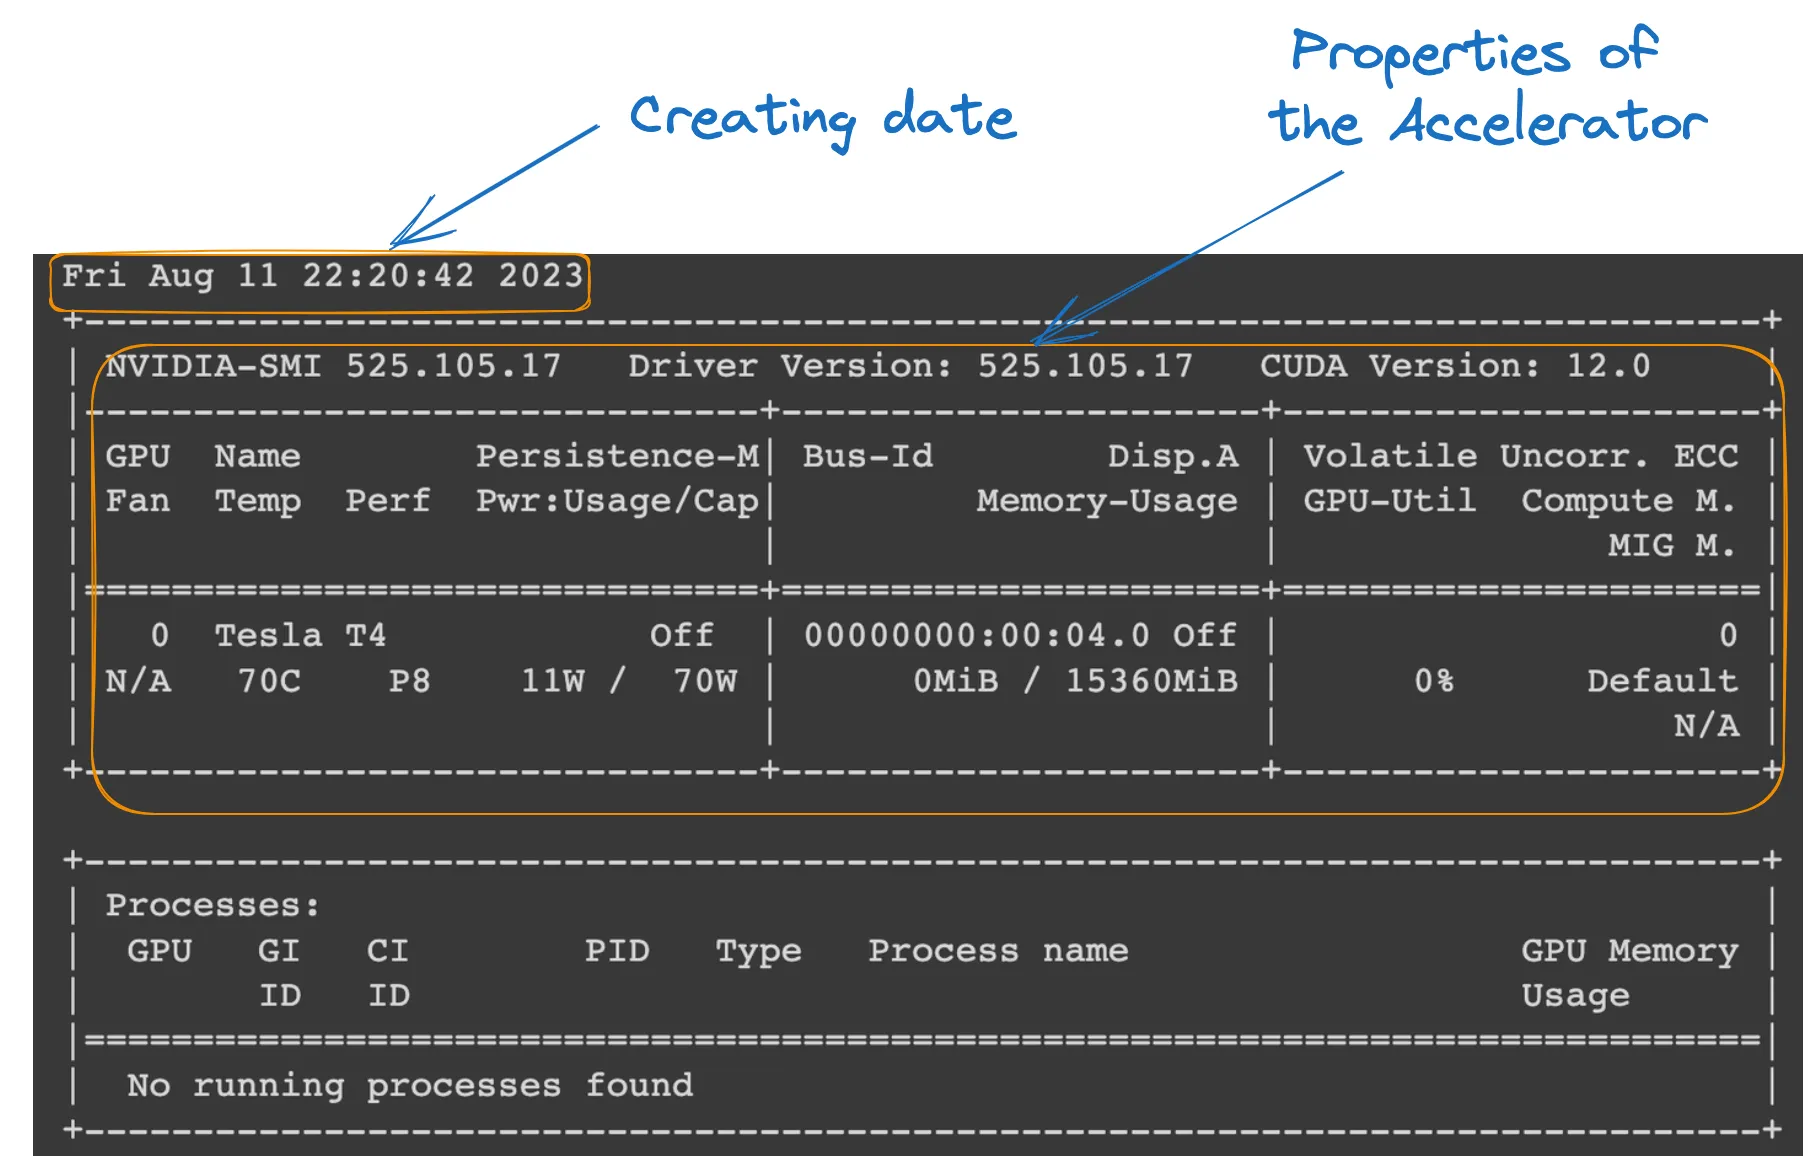
GPU properties

Propriedades da GPU

Definição do modelo

Com tudo pronto, podemos carregar o modelo da seguinte forma:

model_ID = "Upstage/SOLAR-10.7B-Instruct-v1.0"

tokenizer = AutoTokenizer.from_pretrained(model_ID)
model = AutoModelForCausalLM.from_pretrained(
	model_ID,
	device_map="auto",
	torch_dtype=torch.float16,
)
  • model_ID é a string que identifica de forma única o modelo pré-treinado que queremos usar. Neste caso, "Upstage/SOLAR-10.7B-Instruct-v1.0".
  • AutoTokenizer.from_pretrained(model_ID) carrega um tokenizer pré-treinado para o model_ID especificado, preparando-o para processar entradas de texto.
  • AutoModelForCausalLM.from_pretrained() carrega o próprio modelo de linguagem causal, com device_map="auto" para usar automaticamente o melhor hardware disponível (a GPU que configuramos) e torch_dtype=torch.float16 para usar números de 16 bits, economizando memória e acelerando os cálculos.

Inferência do modelo

Antes de gerar uma resposta, o texto de entrada (solicitação do usuário) é formatado e tokenizado.

  • user_request contém a pergunta ou entrada para o modelo.
  • conversation formata a entrada como parte de uma conversa, marcando com um papel (por exemplo, 'user').
  • apply_chat_template aplica um template conversacional à entrada, deixando-a no formato que o modelo entende.
  • tokenizer(prompt, return_tensors="pt") converte o prompt em tokens e especifica o tipo de tensor ("pt" para PyTorch); .to(model.device) garante que a entrada esteja no mesmo dispositivo (CPU ou GPU) do modelo.
user_request = "What is the square root of 24?"

conversation = [ {'role': 'user', 'content': user_request} ]

prompt = tokenizer.apply_chat_template(conversation, tokenize=False, add_generation_prompt=True)
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

Geração do resultado

A última parte usa o modelo para gerar a resposta à pergunta de entrada e, em seguida, decodifica e imprime o texto gerado.

  • model.generate() gera texto com base nas entradas fornecidas, com use_cache=True para acelerar reutilizando resultados já computados. max_length=4096 limita o tamanho máximo do texto gerado.
  • tokenizer.decode(outputs[0]) converte os tokens gerados de volta para texto legível.
  • O print exibe a resposta gerada para a pergunta do usuário.
outputs = model.generate(**inputs, use_cache=True, max_length=4096)
output_text = tokenizer.decode(outputs[0])
print(output_text)

A execução bem-sucedida do código acima gera o seguinte resultado:

image4.png

Substituindo a solicitação do usuário pelo texto abaixo, obtemos a resposta gerada:

user_request = "Tell me a story about the universe"

image6.png

Limitações do modelo SOLAR-10.7B

Apesar de todos os benefícios, o SOLAR-10.7B tem limitações como qualquer outro LLM. As principais são:

  • Exploração aprofundada de hiperparâmetros: a necessidade de explorar melhor os hiperparâmetros durante o Depth Up-Scaling (DUS) é uma limitação importante. Isso levou à remoção de 8 camadas do modelo base devido a restrições de hardware.
  • Alto consumo computacional: o modelo exige muitos recursos de computação, o que limita seu uso por pessoas e organizações com menor capacidade computacional.
  • Vulnerabilidade a vieses: vieses potenciais nos dados de treinamento podem impactar o desempenho do modelo em alguns casos de uso.
  • Questões ambientais: o treinamento e a inferência do modelo demandam consumo significativo de energia, o que pode gerar preocupações ambientais.

Conclusão

Este artigo explorou o modelo SOLAR-10.7B, destacando sua contribuição para a inteligência artificial por meio da abordagem de depth up-scaling. Apresentamos como o modelo funciona, suas aplicações potenciais e um guia prático de uso, da instalação até a geração de resultados.

Apesar de suas capacidades, também abordamos as limitações do SOLAR-10.7B, oferecendo uma visão equilibrada para quem pretende utilizá-lo. À medida que a IA evolui, o SOLAR-10.7B exemplifica os avanços rumo a ferramentas mais acessíveis e versáteis.

Para quem quer se aprofundar no potencial da IA, nosso tutorial FLAN-T5 Tutorial: Guide and Fine-Tuning traz um guia completo de fine-tuning de um modelo FLAN-T5 para uma tarefa de QA usando a biblioteca transformers e executando inferência otimizada em um cenário real. Você também pode conferir nosso tutorial de fine-tuning do GPT-3.5 e nosso code-along sobre como ajustar seu próprio modelo LlaMA 2.


Zoumana Keita 's photo
Author
Zoumana Keita
LinkedIn
Twitter

A Zoumana desenvolve ferramentas de IA LLM para ajudar as empresas a realizar due diligence de sustentabilidade e avaliações de risco. Anteriormente, ele trabalhou como cientista de dados e engenheiro de aprendizado de máquina na Axionable e na IBM. Zoumana é o fundador da plataforma de tecnologia educacional de aprendizagem entre pares ETP4Africa. Ele escreveu mais de 20 tutoriais para o DataCamp.

Tópicos
Inteligência Artificial

Comece sua jornada em IA hoje!

Curso

Conceitos de IA Generativa

2 h
117.2K
Descubra como usar IA generativa de forma responsável e seu impacto futuro na sociedade.
Ver detalhesRight Arrow
Iniciar Curso
Ver maisRight Arrow
Relacionado

Tutorial

DCLM-7B da Apple: Configuração, exemplo de uso, ajuste fino

Comece a usar o modelo de linguagem grande DCLM-7B da Apple e saiba como configurá-lo, usá-lo e ajustá-lo para tarefas específicas.
Dimitri Didmanidze's photo

Dimitri Didmanidze

9 min

Tutorial

Guia para iniciantes do LlaMA-Factory WebUI: Ajuste fino dos LLMs

Saiba como fazer o ajuste fino dos LLMs em conjuntos de dados personalizados, avaliar o desempenho e exportar e servir modelos com facilidade usando a estrutura com pouco ou nenhum código do LLaMA-Factory.
Abid Ali Awan's photo

Abid Ali Awan

12 min

Tutorial

Guia de Introdução ao Ajuste Fino de LLMs

O ajuste fino dos grandes modelos de linguagem (LLMs, Large Language Models) revolucionou o processamento de linguagem natural (PLN), oferecendo recursos sem precedentes em tarefas como tradução de idiomas, análise de sentimentos e geração de textos. Essa abordagem transformadora aproveita modelos pré-treinados como o GPT-2, aprimorando seu desempenho em domínios específicos pelo processo de ajuste fino.
Josep Ferrer's photo

Josep Ferrer

11 min

Tutorial

Visão GPT-4: Um guia abrangente para iniciantes

Este tutorial apresentará tudo o que você precisa saber sobre o GPT-4 Vision, desde o acesso a ele, passando por exemplos práticos do mundo real, até suas limitações.
Arunn Thevapalan's photo

Arunn Thevapalan

12 min

Tutorial

Guia para iniciantes no uso da API do ChatGPT

Este guia o orienta sobre os conceitos básicos da API ChatGPT, demonstrando seu potencial no processamento de linguagem natural e na comunicação orientada por IA.
Moez Ali's photo

Moez Ali

11 min

Tutorial

Uma introdução ao uso do DALL-E 3: Dicas, exemplos e recursos

Descubra como usar o DALL-E 3 para criar imagens. Descubra o que é o DALL-E 3, seus principais recursos e como usar os prompts para obter os melhores resultados.
Kurtis Pykes 's photo

Kurtis Pykes

13 min

Ver MaisVer Mais