
{count, plural, one {Corso} other {Corsi}}
Il progetto SOLAR-10.7B rappresenta un notevole passo avanti nello sviluppo dei large language model, introducendo un nuovo approccio per scalarli in modo efficace ed efficiente.
Questo articolo inizia spiegando che cos’è il modello SOLAR-10.7B, per poi evidenziarne le prestazioni rispetto ad altri large language model e approfondire il processo di utilizzo della sua versione specializzata messa a punto. Infine, il lettore capirà le potenziali applicazioni del modello messo a punto SOLAR-10.7B-Instruct e i suoi limiti.
Che cos’è SOLAR-10.7B?
SOLAR-10.7B è un modello da 10,7 miliardi di parametri sviluppato da un team di Upstage AI in Corea del Sud.
Basato sull’architettura Llama-2, questo modello supera altri large language model fino a 30 miliardi di parametri, incluso il modello Mixtral 8X7B.
Per saperne di più su Llama-2, il nostro articolo Fine-Tuning LLaMA 2: A Step-by-Step Guide to Customizing the Large Language Model offre una guida passo passo per mettere a punto Llama-2, utilizzando nuovi approcci per superare i limiti di memoria e calcolo e migliorare l’accesso ai large language model open source.
Inoltre, partendo dalla solida base di SOLAR-10.7B, il modello SOLAR-10.7B-Instruct è messo a punto con un’enfasi particolare sul seguire istruzioni complesse. Questa variante dimostra prestazioni migliorate, mettendo in luce l’adattabilità del modello e l’efficacia del fine-tuning nel raggiungere obiettivi specializzati.
Infine, SOLAR-10.7B introduce un metodo chiamato Depth Up-Scaling, che approfondiremo nella sezione seguente.
Il metodo Depth Up-Scaling
Questo metodo innovativo consente di aumentare la profondità della rete neurale del modello senza richiedere un corrispondente incremento delle risorse computazionali. Tale strategia migliora sia l’efficienza sia le prestazioni complessive del modello.
Elementi essenziali del Depth Up-Scaling
Il Depth Up-Scaling si basa su tre componenti principali: (1) pesi di Mistral 7B, (2) framework Llama 2 e (3) pre-training continuo.
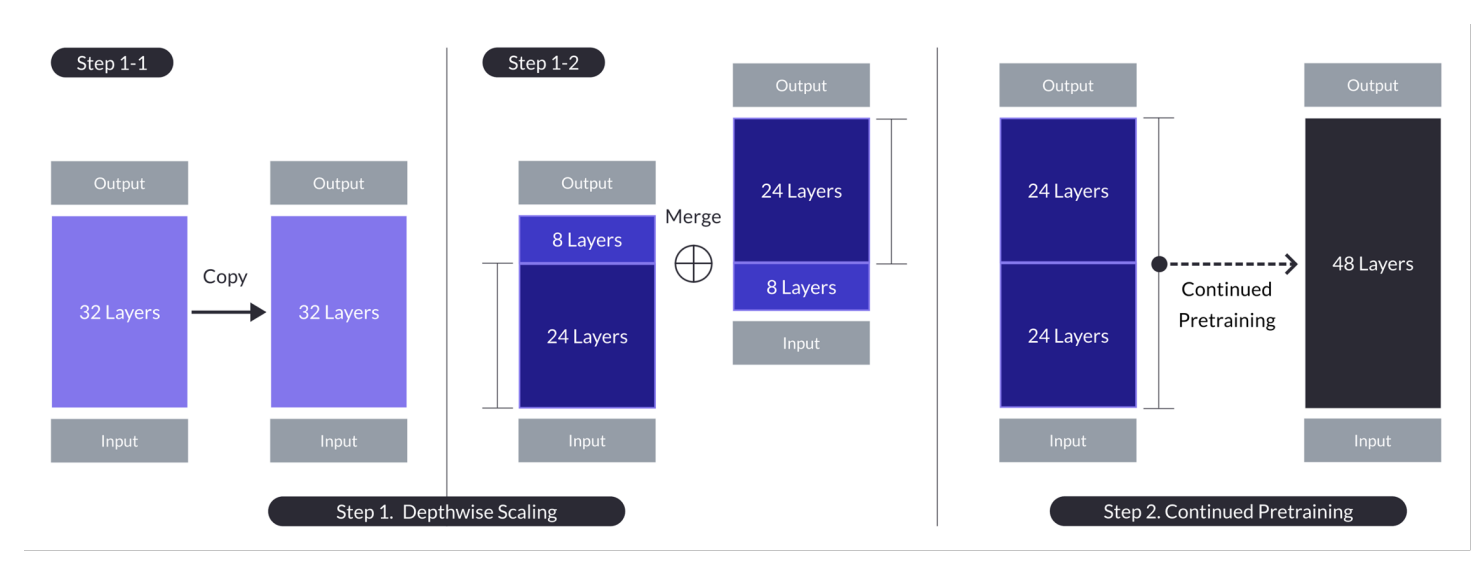
Depth up-scaling per il caso con n = 32, s = 48 e m = 8. Il depth up-scaling si ottiene tramite un processo in due fasi: scaling in profondità seguito da pretraining continuato. (Fonte)
Modello di base:
- Utilizza un’architettura transformer a 32 layer, nello specifico il modello Llama 2, inizializzato con pesi pre-addestrati di Mistral 7B.
- Scelto per compatibilità e prestazioni, con l’obiettivo di sfruttare le risorse della community e introdurre modifiche innovative per capacità potenziate.
- Serve come base per lo scaling in profondità e il pretraining successivo per scalare in modo efficiente.
Scaling in profondità:
- Scala il modello di base impostando un numero di layer target per il modello scalato, tenendo conto delle capacità hardware.
- Prevede la duplicazione del modello di base, la rimozione degli ultimi m layer dall’originale e dei primi m layer dal duplicato, quindi il loro concatenamento per formare un modello con s layer.
- Questo processo crea un modello scalato con un numero di layer regolato per rientrare tra 7 e 13 miliardi di parametri, utilizzando in particolare una base di n=32 layer, rimuovendo m=8 layer per ottenere s=48 layer.
Pretraining continuato:
- Affronta il calo iniziale di prestazioni dopo lo scaling in profondità continuando a pre-addestrare il modello scalato.
- Durante il pretraining continuato si è osservato un rapido recupero delle prestazioni, attribuito alla riduzione dell’eterogeneità e delle discrepanze nel modello.
- Il pretraining continuato è cruciale per recuperare e potenzialmente superare le prestazioni del modello di base, sfruttando l’architettura del modello scalato in profondità per un apprendimento efficace.
Questi riepiloghi evidenziano le strategie chiave e i risultati dell’approccio Depth Up-Scaling, concentrandosi sullo sfruttamento di modelli esistenti, sulla scalabilità tramite l’aggiustamento della profondità e sul miglioramento delle prestazioni grazie al pretraining continuato.
Grazie a questo approccio multifattoriale, SOLAR-10.7B raggiunge e, in molti casi, supera le capacità di modelli molto più grandi. Questa efficienza lo rende una scelta di primo piano per una serie di applicazioni specifiche, mettendone in mostra forza e flessibilità.
Come funziona il modello SOLAR-10.7B Instruct?
SOLAR-10.7B Instruct eccelle nell’interpretare ed eseguire istruzioni complesse, risultando estremamente prezioso in scenari in cui la comprensione precisa e la reattività ai comandi umani sono fondamentali. Questa capacità è essenziale per sviluppare sistemi di intelligenza artificiale più intuitivi e interattivi.
- SOLAR-10.7B Instruct è il risultato del fine-tuning del modello SOLAR-10.7B originale per seguire istruzioni in formato QA.
- Il fine-tuning utilizza principalmente dataset open source insieme a dataset QA sintetici di matematica per migliorare le abilità matematiche del modello.
- La prima versione di SOLAR-10.7B Instruct è creata integrando i pesi di Mistral 7B per rafforzarne le capacità di apprendimento e l’elaborazione efficace ed efficiente delle informazioni.
- La spina dorsale di SOLAR-10.7B è l’architettura Llama2, che offre un connubio di velocità e accuratezza.
In generale, l’importanza del modello SOLAR-10.7B messo a punto risiede nelle prestazioni migliorate, nell’adattabilità e nel potenziale di ampia applicazione, spingendo in avanti i campi dell’elaborazione del linguaggio naturale e dell’intelligenza artificiale.
Applicazioni potenziali del modello SOLAR-10.7B messo a punto
Prima di passare all’implementazione tecnica, esploriamo alcune potenziali applicazioni di un modello SOLAR-10.7B messo a punto.
Di seguito alcuni esempi di istruzione e tutoraggio personalizzati, assistenza clienti migliorata e creazione automatizzata di contenuti.
- Istruzione e tutoraggio personalizzati: SOLAR-10.7B-Instruct può rivoluzionare il settore educativo offrendo esperienze di apprendimento personalizzate. Può comprendere domande complesse degli studenti, fornendo spiegazioni, risorse ed esercizi su misura. Questa capacità lo rende uno strumento ideale per sviluppare sistemi di tutoraggio intelligenti che si adattano agli stili e alle esigenze di apprendimento individuali, migliorando il coinvolgimento e i risultati degli studenti.
- Assistenza clienti migliore: SOLAR-10.7B-Instruct può alimentare chatbot e assistenti virtuali avanzati in grado di comprendere e risolvere con alta accuratezza richieste complesse dei clienti. Questa applicazione non solo migliora l’esperienza dei clienti offrendo supporto tempestivo e pertinente, ma riduce anche il carico di lavoro degli operatori automatizzando le richieste di routine.
- Creazione e sintesi automatizzata di contenuti: Per media e content creator, SOLAR-10.7B-Instruct offre la possibilità di automatizzare la generazione di contenuti scritti, come articoli di cronaca, report e testi creativi. Inoltre, può riassumere documenti estesi in formati concisi e di facile comprensione, risultando prezioso per giornalisti, ricercatori e professionisti che devono assimilare e riportare rapidamente grandi volumi di informazioni.
Questi esempi sottolineano la versatilità e il potenziale di SOLAR-10.7B-Instruct nel migliorare efficienza, accessibilità ed esperienza utente in un’ampia gamma di settori.
Guida passo passo all’uso di SOLAR-10.7B Instruct
Abbiamo abbastanza contesto sul modello SOLAR-10.7B ed è il momento di passare alla pratica.
Questa sezione ha l’obiettivo di fornire tutte le istruzioni per eseguire il modello SOLAR 10.7 Instruct v1.0 - GGUF di upstage.
I codici si ispirano alla documentazione ufficiale su Hugging Face. I passaggi principali sono i seguenti:
- Installare e importare le librerie necessarie
- Definire il modello SOLAR-10.7B da usare da Hugging Face
- Eseguire l’inferenza del modello
- Generare il risultato dalla richiesta dell’utente
Installazione delle librerie
Le librerie principali utilizzate sono transformers e accelerate.
- La libreria transformers fornisce accesso a modelli pre-addestrati; qui è specificata la versione 4.35.2.
- La libreria accelerate è progettata per semplificare l’esecuzione di modelli di machine learning su diversi hardware (CPU, GPU) senza dover comprendere in profondità le specifiche dell’hardware.
%%bash
pip -q install transformers==4.35.2
pip -q install accelerate
Import delle librerie
Ora che l’installazione è completata, procediamo importando le seguenti librerie necessarie:
- torch è la libreria PyTorch, una popolare libreria open source di machine learning utilizzata per applicazioni come computer vision e NLP.
- AutoModelForCausalLM viene utilizzato per caricare un modello pre-addestrato per il causal language modeling, e AutoTokenizer è responsabile di convertire il testo in un formato comprensibile dal modello (tokenizzazione).
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
Configurazione della GPU
Il modello utilizzato è la versione 1 del modello SOLAR-10.7B da Hugging Face.
È necessaria una GPU per velocizzare il caricamento del modello e il processo di inferenza.
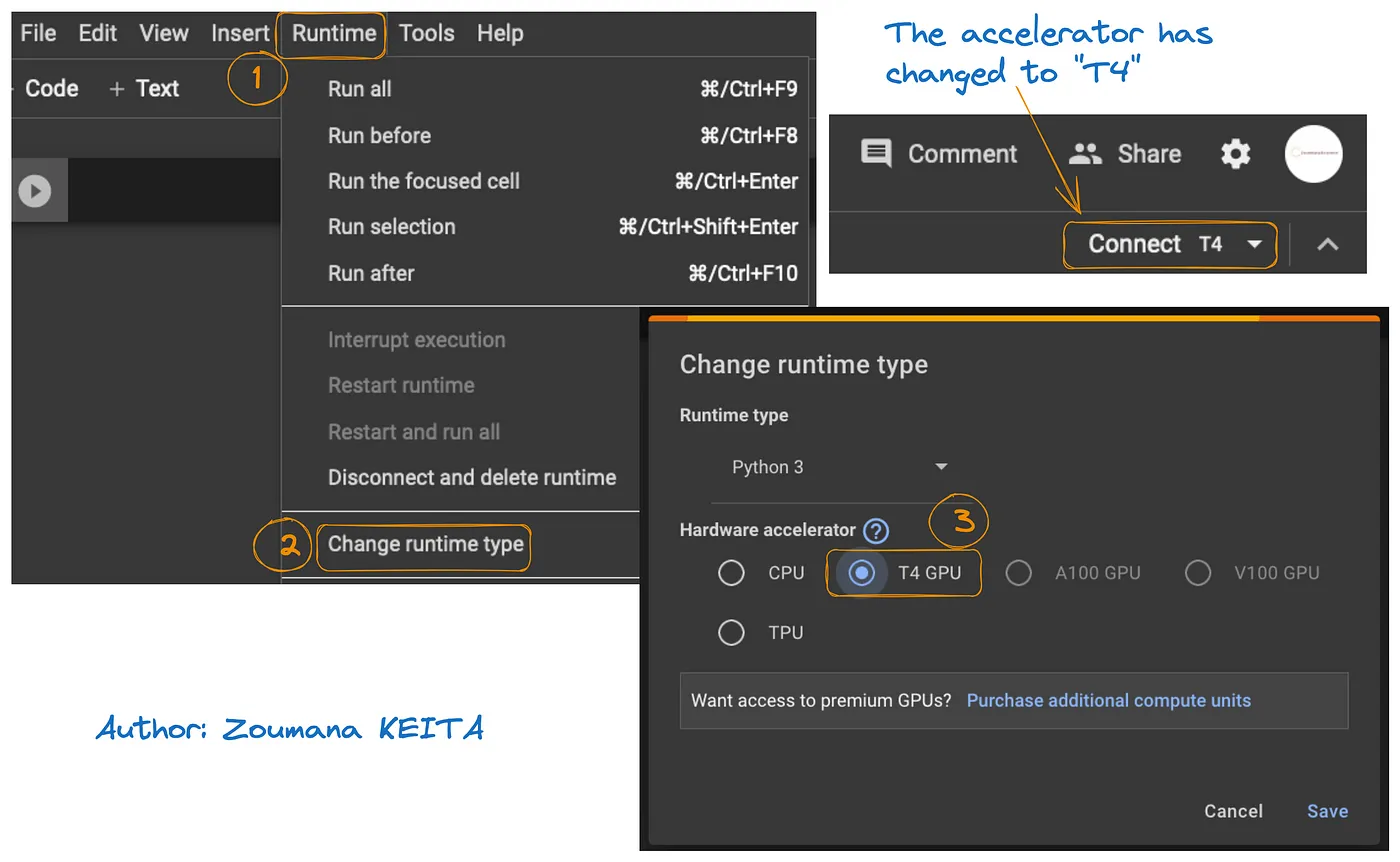
L’accesso alla GPU su Google Colab è illustrato nel grafico seguente:
- Dal tab Runtime, seleziona Change runtime
- Poi scegli T4 GPU nella sezione Hardware accelerator e Save le modifiche
Questo imposterà il runtime predefinito su T4:
Possiamo verificare le proprietà del runtime eseguendo il seguente comando dal notebook Colab.
!nvidia-smi
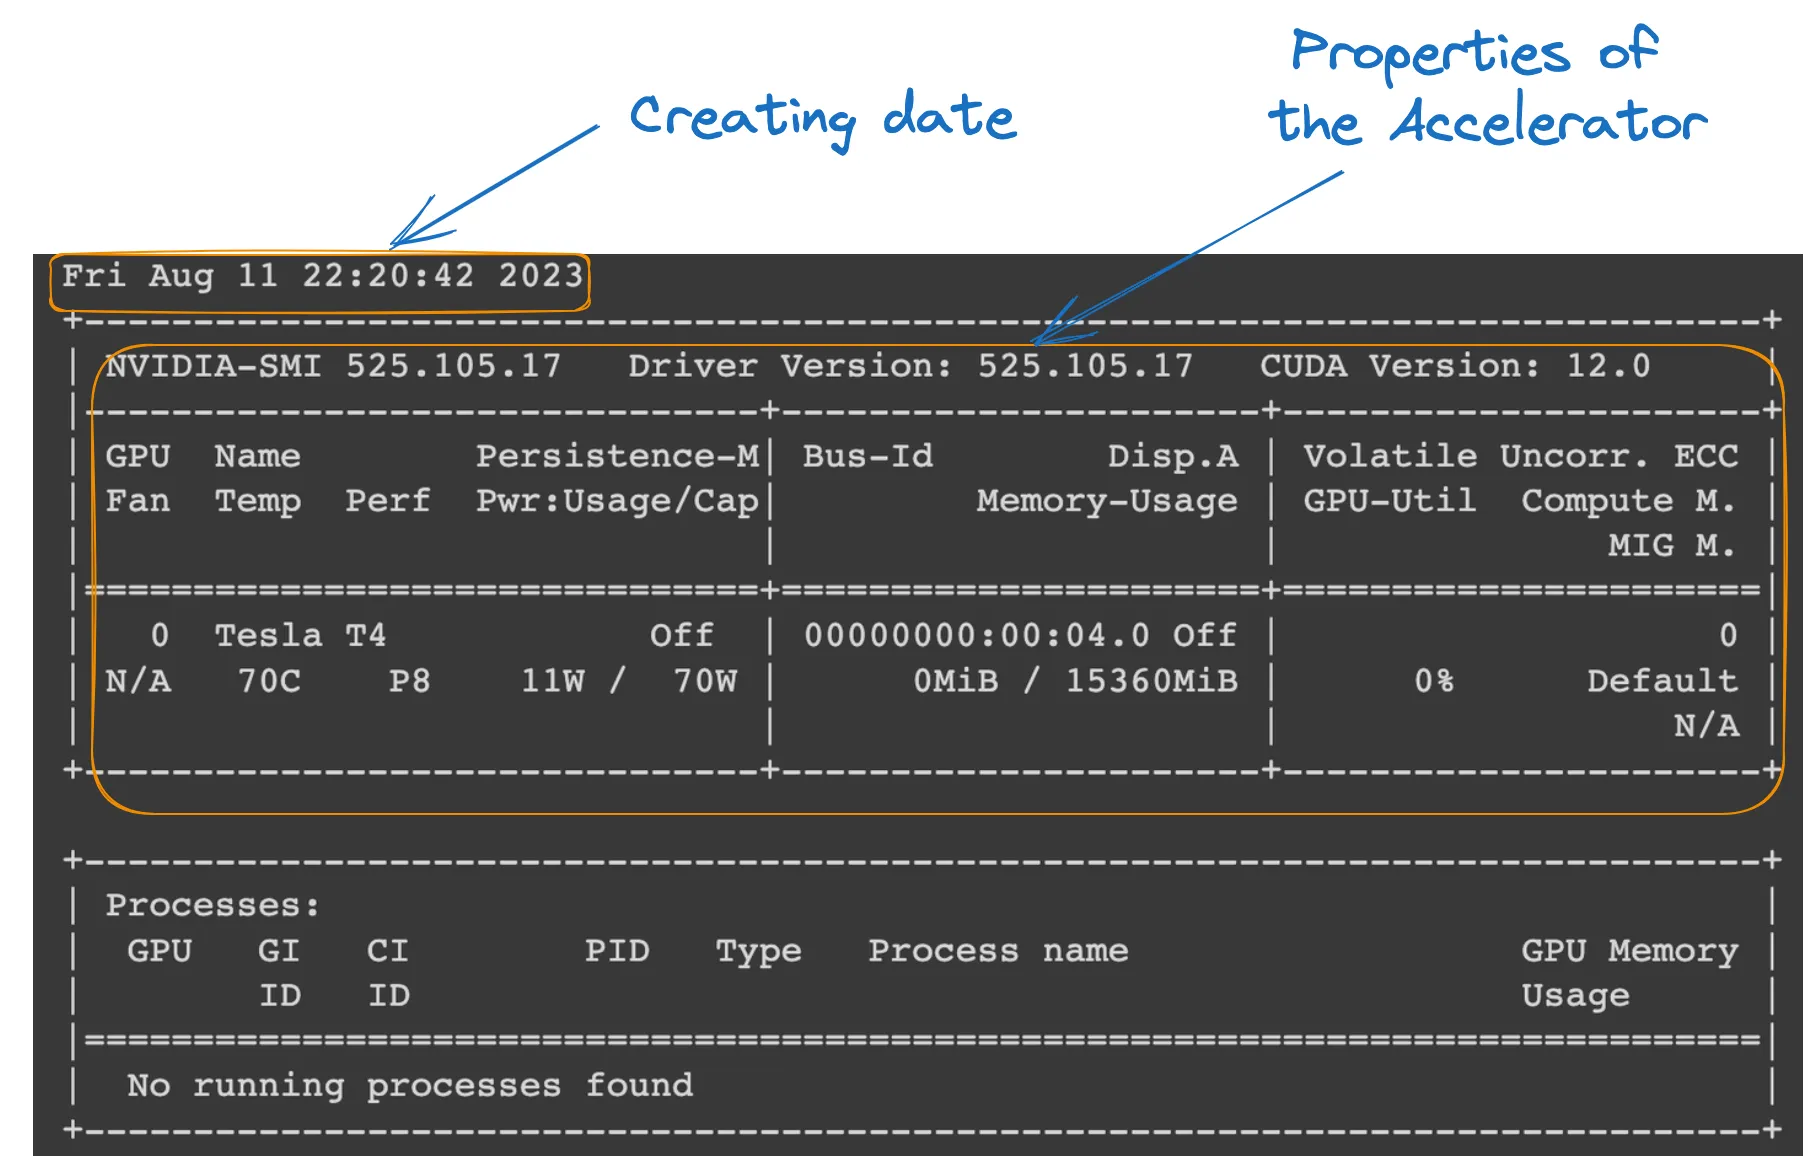
Proprietà della GPU
Definizione del modello
È tutto pronto; possiamo procedere con il caricamento del modello come segue:
model_ID = "Upstage/SOLAR-10.7B-Instruct-v1.0"
tokenizer = AutoTokenizer.from_pretrained(model_ID)
model = AutoModelForCausalLM.from_pretrained(
model_ID,
device_map="auto",
torch_dtype=torch.float16,
)
- model_ID è una stringa che identifica in modo univoco il modello pre-addestrato che vogliamo usare. In questo caso è specificato "Upstage/SOLAR-10.7B-Instruct-v1.0".
- AutoTokenizer.from_pretrained(model_ID) carica un tokenizer pre-addestrato sul model_ID specificato, preparandolo all’elaborazione dell’input testuale.
- AutoModelForCausalLM.from_pretrained() carica il modello di linguaggio causale, con device_map="auto" per utilizzare automaticamente l’hardware migliore disponibile (la GPU che abbiamo configurato) e torch_dtype=torch.float16 per usare numeri in virgola mobile a 16 bit, risparmiando memoria e potenzialmente accelerando i calcoli.
Inferenza del modello
Prima di generare una risposta, il testo di input (richiesta dell’utente) viene formattato e tokenizzato.
- user_request contiene la domanda o l’input per il modello.
- conversation formatta l’input come parte di una conversazione, etichettandolo con un ruolo (ad es. "user").
- apply_chat_template applica un template conversazionale all’input, preparandolo per il modello in un formato che comprende.
- tokenizer(prompt, return_tensors="pt") converte il prompt in token e specifica il tipo di tensore ("pt" per i tensori PyTorch), e .to(model.device) garantisce che l’input sia sullo stesso dispositivo (CPU o GPU) del modello.
user_request = "What is the square root of 24?"
conversation = [ {'role': 'user', 'content': user_request} ]
prompt = tokenizer.apply_chat_template(conversation, tokenize=False, add_generation_prompt=True)
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
Generazione del risultato
La sezione finale utilizza il modello per generare una risposta alla domanda di input e quindi decodifica e stampa il testo generato.
- model.generate() genera testo sulla base degli input forniti, con use_cache=True per velocizzare la generazione riutilizzando risultati calcolati in precedenza. max_length=4096 limita la lunghezza massima del testo generato.
- tokenizer.decode(outputs[0]) converte i token generati in testo leggibile.
- L’istruzione print visualizza la risposta generata alla domanda dell’utente.
outputs = model.generate(**inputs, use_cache=True, max_length=4096)
output_text = tokenizer.decode(outputs[0])
print(output_text)
L’esecuzione corretta del codice sopra genera il seguente risultato:

Sostituendo la richiesta dell’utente con il seguente testo, otteniamo la risposta generata
user_request = "Tell me a story about the universe"

Limitazioni del modello SOLAR-10.7B
Nonostante tutti i vantaggi di SOLAR-10.7B, come ogni altro large language model presenta delle limitazioni, e le principali sono evidenziate di seguito:
- Esplorazione approfondita degli iperparametri: la necessità di un’esplorazione più approfondita degli iperparametri del modello durante il Depth Up-Scaling (DUS) è una limitazione chiave. Ciò ha comportato la rimozione di 8 layer dal modello di base a causa di limitazioni hardware.
- Richieste computazionali elevate: il modello richiede risorse computazionali significative, e questo ne limita l’uso da parte di individui e organizzazioni con capacità inferiori.
- Vulnerabilità ai bias: bias potenziali nei dati di addestramento potrebbero influenzare le prestazioni del modello in alcuni casi d’uso.
- Impatto ambientale: l’addestramento e l’inferenza del modello richiedono un consumo energetico significativo, che può sollevare preoccupazioni ambientali.
Conclusione
Questo articolo ha esplorato il modello SOLAR-10.7B, evidenziandone il contributo all’intelligenza artificiale tramite l’approccio di depth up-scaling. Ha delineato il funzionamento e le potenziali applicazioni del modello e fornito una guida pratica al suo utilizzo, dall’installazione alla generazione dei risultati.
Pur riconoscendone le capacità, l’articolo ha anche affrontato le limitazioni del modello SOLAR-10.7B, offrendo una prospettiva equilibrata per gli utenti. Con l’evolversi dell’IA, SOLAR-10.7B esemplifica i progressi compiuti verso strumenti di IA più accessibili e versatili.
Per chi desidera approfondire il potenziale dell’IA, il nostro tutorial FLAN-T5 Tutorial: Guide and Fine-Tuning offre una guida completa al fine-tuning di un modello FLAN-T5 per un task di question answering usando la libreria transformers ed eseguendo un’inferenza ottimizzata in uno scenario reale. Puoi trovare anche il nostro tutorial sul Fine-Tuning di GPT-3.5 e il nostro code-along su come mettere a punto il tuo modello LlaMA 2.
Un data scientist poliedrico che ama condividere le proprie conoscenze e restituire valore agli altri, Zoumana è un content creator su YouTube e un top writer tech su Medium. Trova soddisfazione nel parlare in pubblico, programmare e insegnare. Zoumana ha due lauree magistrali: la prima in informatica con specializzazione in Machine Learning conseguita a Parigi, Francia, e la seconda in Data Science alla Texas Tech University negli Stati Uniti. Ha iniziato la sua carriera come Software Developer presso Groupe OPEN in Francia, per poi passare a IBM come Machine Learning Consultant, dove ha sviluppato soluzioni di IA end-to-end per compagnie assicurative. Successivamente, è entrato in Axionable, la prima startup di Sustainable AI con sede a Parigi e Montréal. Lì ha lavorato come Data Scientist e ha implementato prodotti di IA, principalmente casi d’uso di NLP, per clienti in Francia, Montréal, Singapore e Svizzera. Inoltre, ha dedicato il 5% del suo tempo ad attività di Ricerca e Sviluppo. Attualmente lavora come Senior Data Scientist presso IFC - World Bank Group.



