Curso
Conceptos de la IA generativa
2 h
117.2K
El proyecto SOLAR-10.7B supone un gran salto en el desarrollo de modelos de lenguaje de gran tamaño, al introducir una nueva forma de escalar estos modelos de manera eficaz y eficiente.
Este artículo empieza explicando qué es el modelo SOLAR-10.7B, destaca su rendimiento frente a otros modelos de lenguaje grandes y profundiza en el uso de su versión especializada ajustada. Por último, entenderás las posibles aplicaciones del modelo ajustado SOLAR-10.7B-Instruct y sus limitaciones.
SOLAR-10.7B es un modelo de 10,7 mil millones de parámetros desarrollado por un equipo de Upstage AI en Corea del Sur.
Basado en la arquitectura de Llama-2, este modelo supera a otros modelos de lenguaje grandes con hasta 30 mil millones de parámetros, incluido el modelo Mixtral 8X7B.
Si quieres saber más sobre Llama-2, nuestro artículo Fine-Tuning LLaMA 2: A Step-by-Step Guide to Customizing the Large Language Model ofrece una guía paso a paso para ajustar Llama-2, con nuevos enfoques para superar las limitaciones de memoria y cómputo y facilitar el acceso a modelos de lenguaje abiertos.
Además, sobre la base sólida de SOLAR-10.7B, el modelo SOLAR-10.7B-Instruct se ajusta con énfasis en seguir instrucciones complejas. Esta variante demuestra un rendimiento superior, lo que pone de relieve la capacidad de adaptación del modelo y la eficacia del ajuste fino para lograr objetivos especializados.
Por último, SOLAR-10.7B introduce un método llamado Depth Up-Scaling, que exploramos a continuación.
Este método innovador permite ampliar la profundidad de la red neuronal del modelo sin requerir un aumento equivalente de los recursos computacionales. Esta estrategia mejora tanto la eficiencia como el rendimiento global del modelo.
Depth Up-Scaling se basa en tres componentes principales: (1) pesos de Mistral 7B, (2) marco de Llama 2 y (3) preentrenamiento continuo.
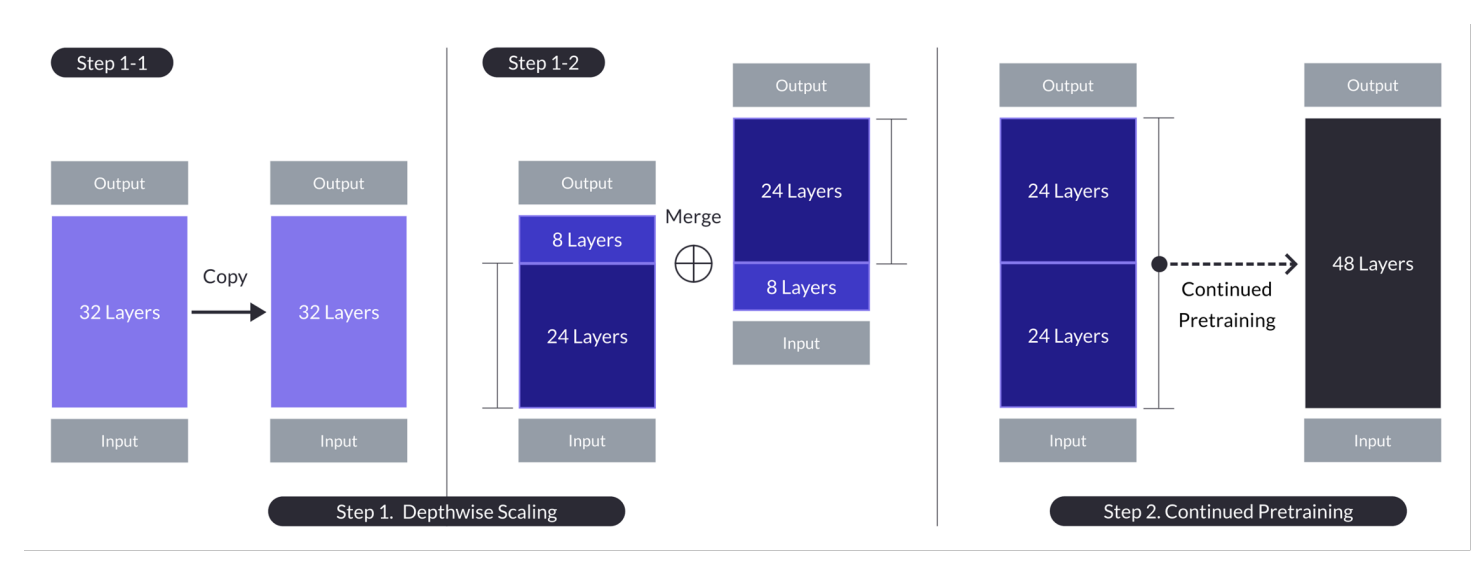
Escalado en profundidad para el caso con n = 32, s = 48 y m = 8. El escalado en profundidad se consigue mediante un proceso de dos fases: escalado por profundidad seguido de preentrenamiento continuo. (Source)
Modelo base:
Escalado en profundidad:
Preentrenamiento continuo:
Estos resúmenes destacan las estrategias y resultados clave del enfoque Depth Up-Scaling, centrado en aprovechar modelos existentes, escalar ajustando la profundidad y mejorar el rendimiento mediante preentrenamiento continuo.
Gracias a este enfoque multifacético, SOLAR-10.7B iguala y, en muchos casos, supera las capacidades de modelos mucho más grandes. Esta eficiencia lo convierte en una opción destacada para múltiples aplicaciones específicas, demostrando su solidez y flexibilidad.
SOLAR-10.7B Instruct destaca interpretando y ejecutando instrucciones complejas, lo que lo hace muy valioso en escenarios donde la comprensión precisa y la capacidad de responder a órdenes humanas son cruciales. Esta capacidad es esencial para desarrollar sistemas de IA más intuitivos e interactivos.
En conjunto, la importancia del modelo SOLAR-10.7B ajustado radica en su mayor rendimiento, su adaptabilidad y su potencial de aplicación generalizada, impulsando los campos del procesamiento del lenguaje natural y la inteligencia artificial.
Antes de entrar en la implementación técnica, veamos algunas posibles aplicaciones de un modelo SOLAR-10.7B ajustado.
A continuación, algunos ejemplos de educación y tutoría personalizadas, mejor atención al cliente y creación automática de contenido.
Estos ejemplos subrayan la versatilidad y el potencial de SOLAR-10.7B-Instruct para mejorar la eficiencia, la accesibilidad y la experiencia de usuario en una amplia variedad de sectores.
Ya tenemos suficiente contexto sobre el modelo SOLAR-10.7B; es hora de ponernos manos a la obra.
Esta sección te da todas las instrucciones para ejecutar el modelo SOLAR-10.7 Instruct v1.0 - GGUF de upstage.
El código se basa en la documentación oficial en Hugging Face. Los pasos principales son:
Las librerías principales son transformers y accelerate.
%%bash
pip -q install transformers==4.35.2
pip -q install accelerateUna vez completada la instalación, importamos las siguientes librerías necesarias:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizerEl modelo utilizado es la versión 1 del SOLAR-10.7B disponible en Hugging Face.
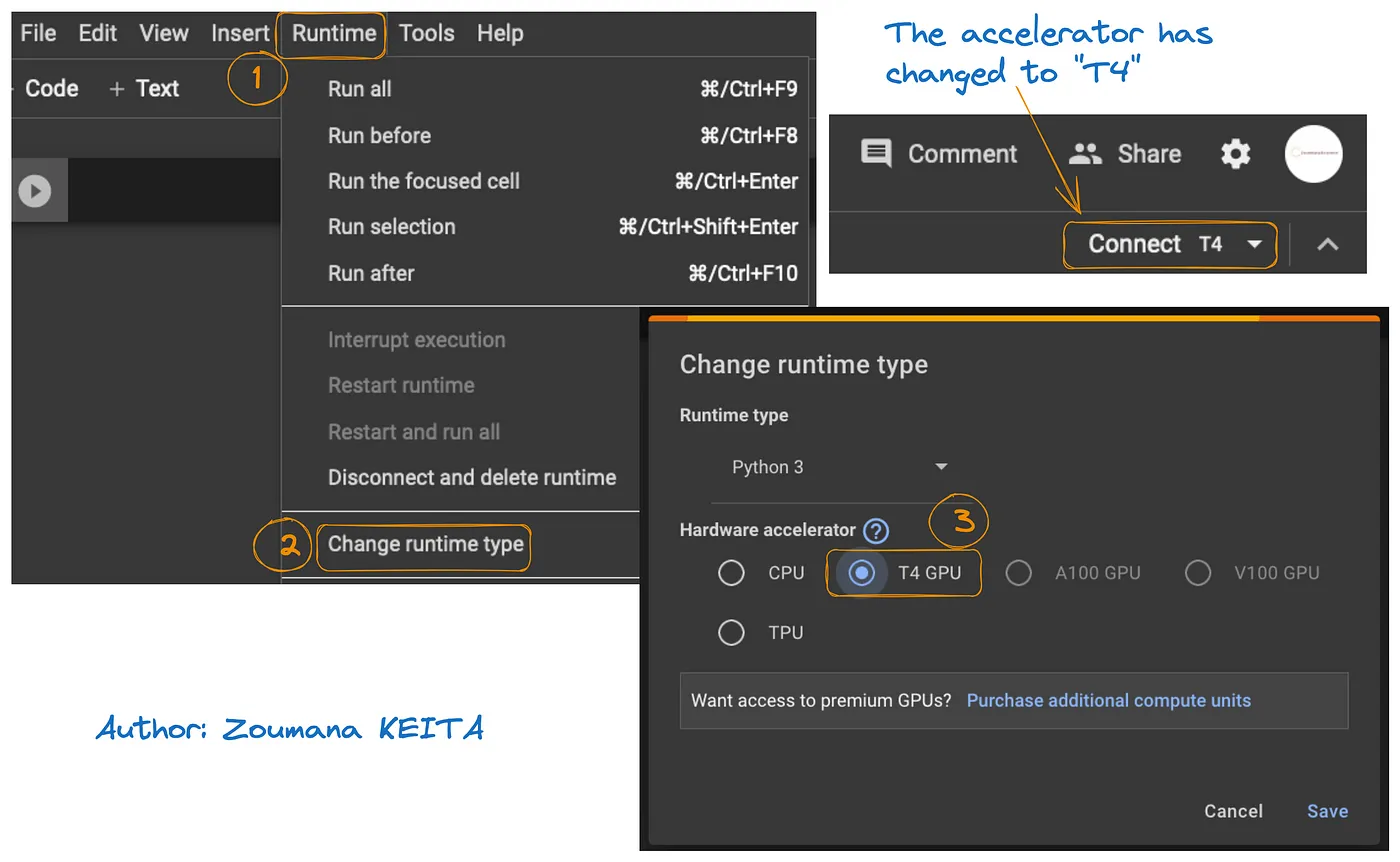
Necesitarás una GPU para acelerar la carga del modelo y el proceso de inferencia.
El acceso a la GPU en Google Colab se ilustra en la imagen siguiente:
Esto cambiará el runtime predeterminado a T4:
Podemos comprobar las propiedades del runtime ejecutando el siguiente comando en el cuaderno de Colab.
!nvidia-smi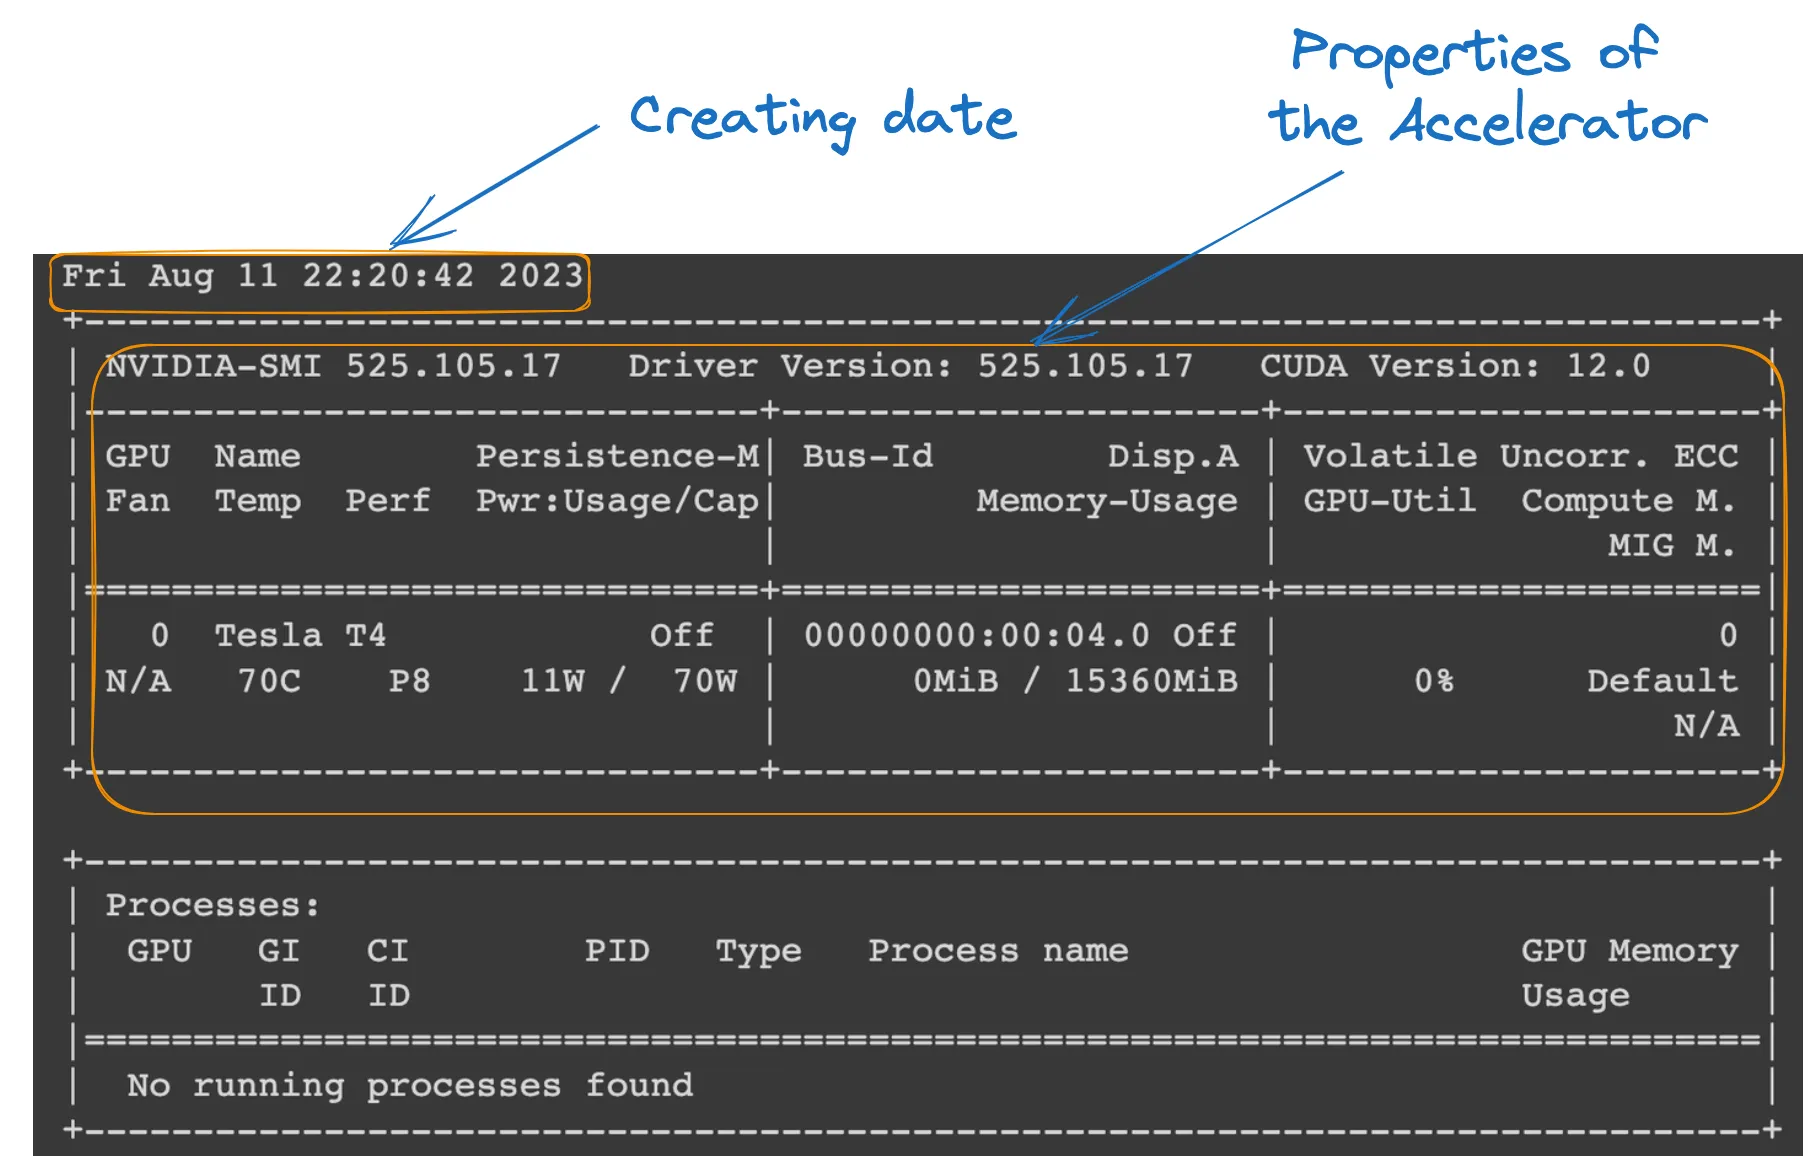
Propiedades de la GPU
Con todo preparado, cargamos el modelo así:
model_ID = "Upstage/SOLAR-10.7B-Instruct-v1.0"

tokenizer = AutoTokenizer.from_pretrained(model_ID)
model = AutoModelForCausalLM.from_pretrained(
	model_ID,
	device_map="auto",
	torch_dtype=torch.float16,
)Antes de generar una respuesta, el texto de entrada (petición del usuario) se formatea y tokeniza.
user_request = "What is the square root of 24?"

conversation = [ {'role': 'user', 'content': user_request} ]

prompt = tokenizer.apply_chat_template(conversation, tokenize=False, add_generation_prompt=True)
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)La sección final usa el modelo para generar una respuesta a la pregunta de entrada y luego decodifica e imprime el texto generado.
outputs = model.generate(**inputs, use_cache=True, max_length=4096)
output_text = tokenizer.decode(outputs[0])
print(output_text)
La ejecución correcta del código anterior genera el siguiente resultado:

Si sustituimos la petición del usuario por el siguiente texto, obtenemos la nueva respuesta generada:
user_request = "Tell me a story about the universe"
A pesar de todas sus ventajas, SOLAR-10.7B también tiene limitaciones, como cualquier modelo de lenguaje grande. Las principales son:
Este artículo ha explorado el modelo SOLAR-10.7B, destacando su aportación a la inteligencia artificial mediante el enfoque de escalado en profundidad. Hemos visto cómo funciona, sus posibles aplicaciones y una guía práctica para su uso, desde la instalación hasta la generación de resultados.
Pese a sus capacidades, también hemos abordado sus limitaciones para ofrecerte una visión equilibrada. A medida que la IA evoluciona, SOLAR-10.7B ejemplifica los avances hacia herramientas más accesibles y versátiles.
Si quieres profundizar en el potencial de la IA, nuestro tutorial FLAN-T5 Tutorial: Guide and Fine-Tuning ofrece una guía completa para ajustar un modelo FLAN-T5 para una tarea de preguntas y respuestas con la librería transformers y ejecutar inferencia optimizada en un escenario real. También puedes consultar nuestro tutorial de fine-tuning de GPT-3.5 y nuestro code-along sobre cómo ajustar tu propio modelo LlaMA 2.
¡Empieza hoy tu camino en IA!
Curso
Curso
Curso
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
15 min
Tutorial
Dimitri Didmanidze
9 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
11 min
Tutorial
Kurtis Pykes
7 min