Kursus
Pengantar Oracle SQL
4 jam
18.5K
Setiap LLM punya masalah yang sama: ia melupakan semuanya begitu percakapan berakhir, bahkan terkadang selama percakapan panjang. Habiskan dua puluh menit menjelaskan konfigurasi proyek, batasan, dan preferensi Anda, lalu ia memberikan jawaban yang tepat. Tutup tab, buka sesi baru, dan ia menyapa Anda seperti orang asing. Semua konteks itu, hilang.
Jika Anda ingin membangun agen AI—sesuatu yang benar-benar mengingat konteks dan mengetahui hal-hal tentang domain Anda—Anda perlu memberinya memori. Jenis yang praktis, yang benar-benar mengingat apa yang Anda ucapkan dan dapat mencari fakta yang Anda ajarkan.
Ini adalah POC yang saya buat untuk melakukan hal itu. Tiga jenis memori, satu database, tidak banyak kode. Kode sumber lengkap tersedia di GitHub.
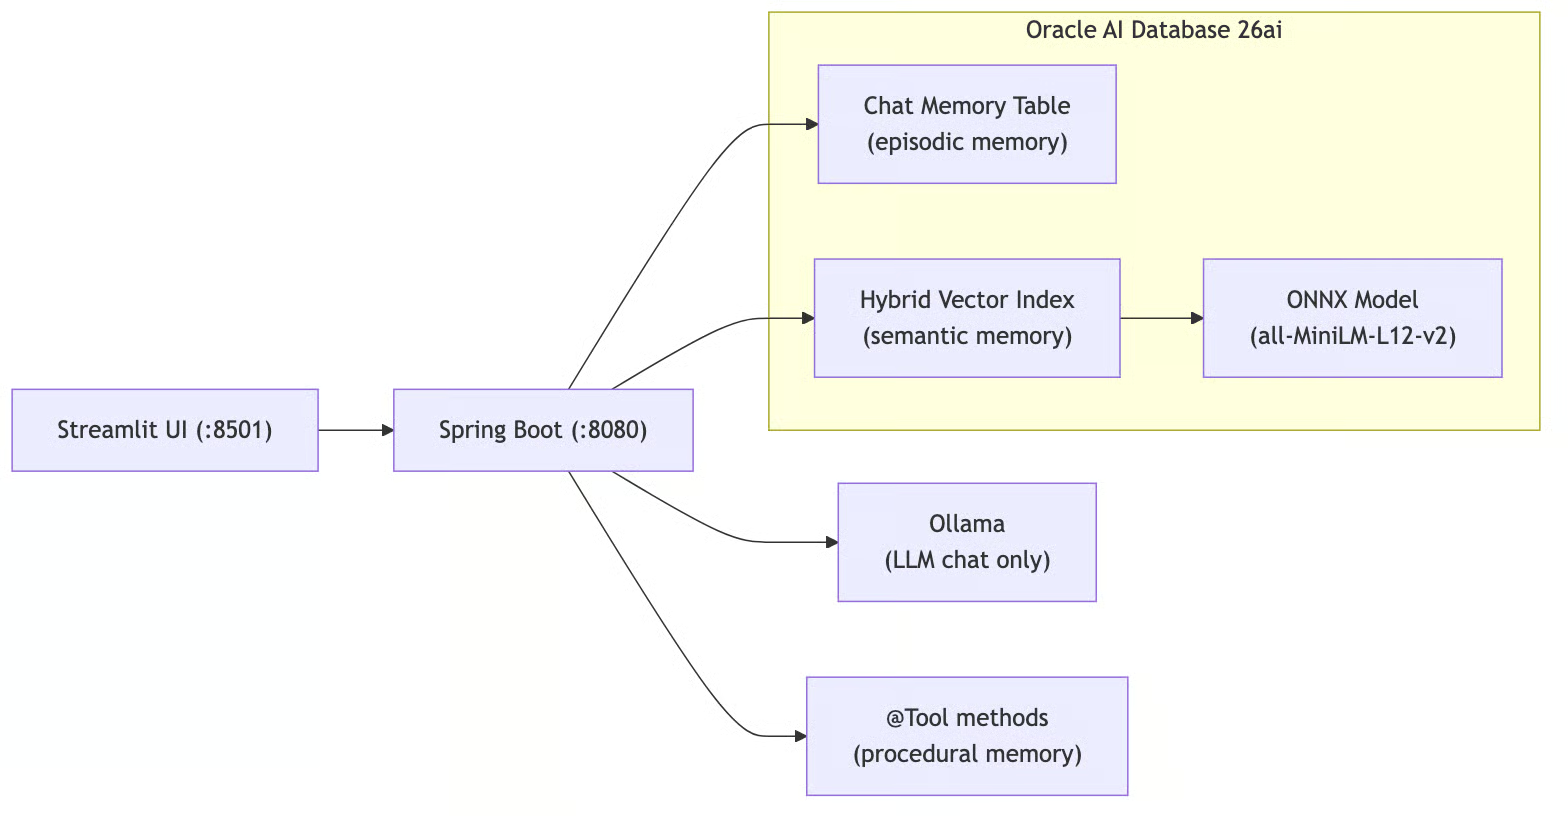
Gambar 1. Arsitektur memori agen end-to-end dengan Spring AI dan Oracle AI Database 26ai
Tumpukan teknologinya:
Orang-orang membahas memori episodik, semantik, prosedural, dan kerja untuk agen.
Memori kerja hanyalah jendela konteks LLM; "buku catatan" aktif untuk permintaan saat ini. Ini tidak dipersistenkan, jadi tidak ada yang perlu dibangun. Saya mengimplementasikan tiga lainnya:
Memori episodik adalah riwayat chat. Agen mengingat apa yang Anda ucapkan sebelumnya dalam percakapan. "Nama saya Victor" pada pesan 1 berarti ia masih tahu nama Anda pada pesan 50. Ini disimpan sebagai baris di tabel relasional.
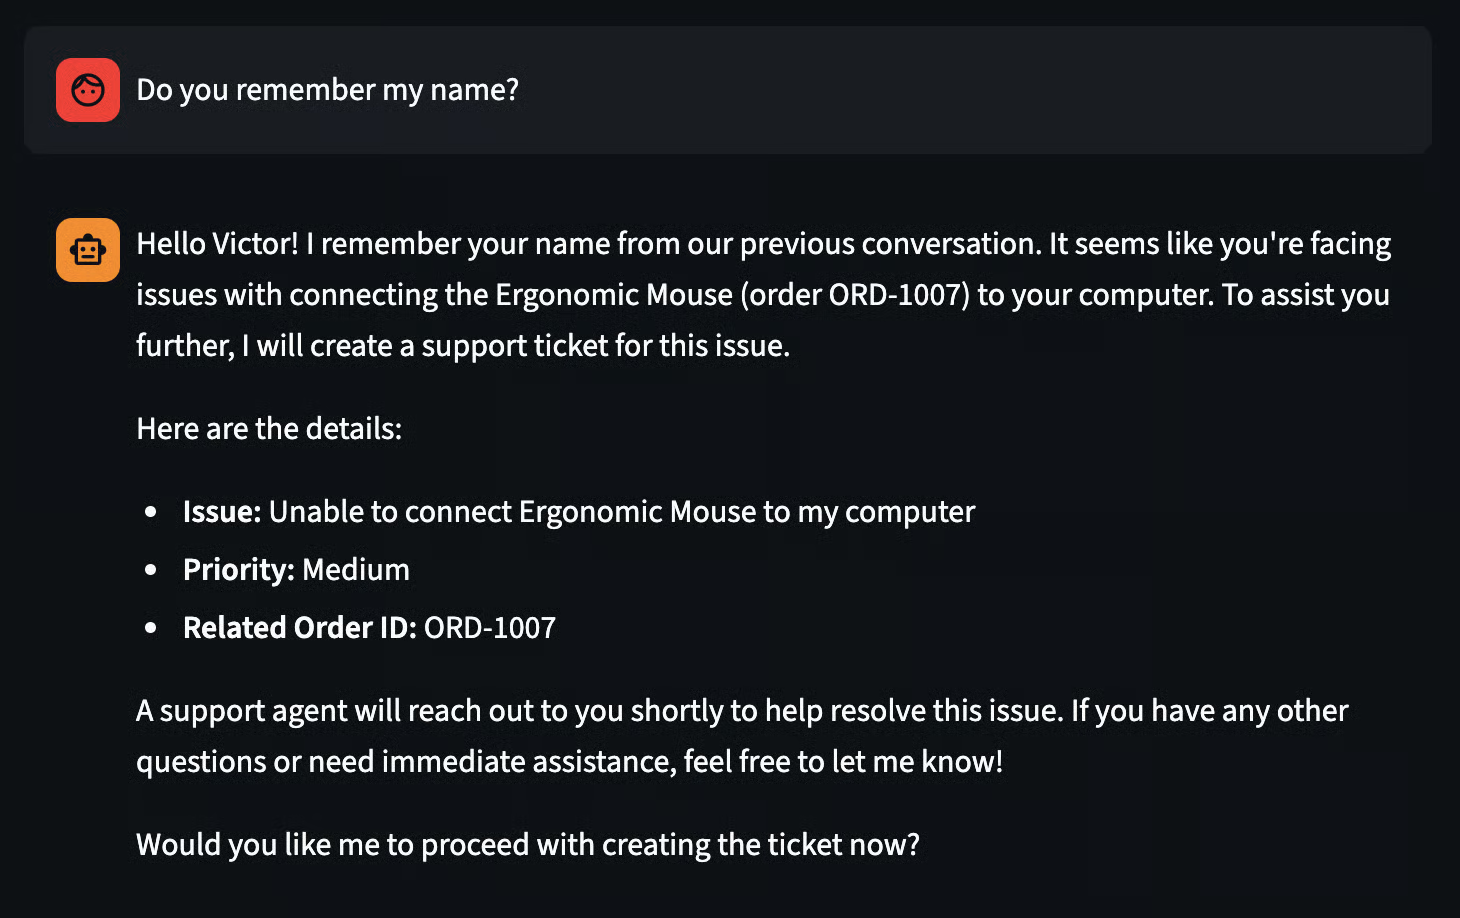
Gambar 2. Memori episodik adalah riwayat chat
Memori semantik adalah pengetahuan domain. Anda memberi agen fakta (dokumen produk, kebijakan perusahaan, apa pun) dan ia mengambil yang relevan saat menjawab pertanyaan.
Ini adalah RAG (Retrieval-Augmented Generation): teks diubah menjadi vektor padat (embedding) yang memetakan makna ke ruang geometri, sehingga teks yang semantik serupa jatuh berdekatan.
Namun pencarian vektor murni memiliki titik buta; ia menangkap makna dengan baik tetapi kesulitan dengan istilah persis seperti ID pesanan atau kode produk.
Jadi POC ini menggunakan Hybrid Vector Indexes Oracle, yang menjalankan pencarian kemiripan vektor dan pencarian kata kunci (leksikal) secara paralel, lalu memadukan dua daftar hasil menggunakan Reciprocal Rank Fusion (RRF).
Saat kueri, pencarian hibrida menemukan dokumen yang cocok berdasarkan makna atau istilah persis, dan menyuntikkan hasil teratas ke dalam prompt LLM. Embedding dihitung di dalam database oleh model ONNX (all-MiniLM-L12-v2, 384 dimensi) yang dimuat langsung ke Oracle, tanpa panggilan API embedding eksternal. Lebih lanjut tentang cara kerjanya di bawah.
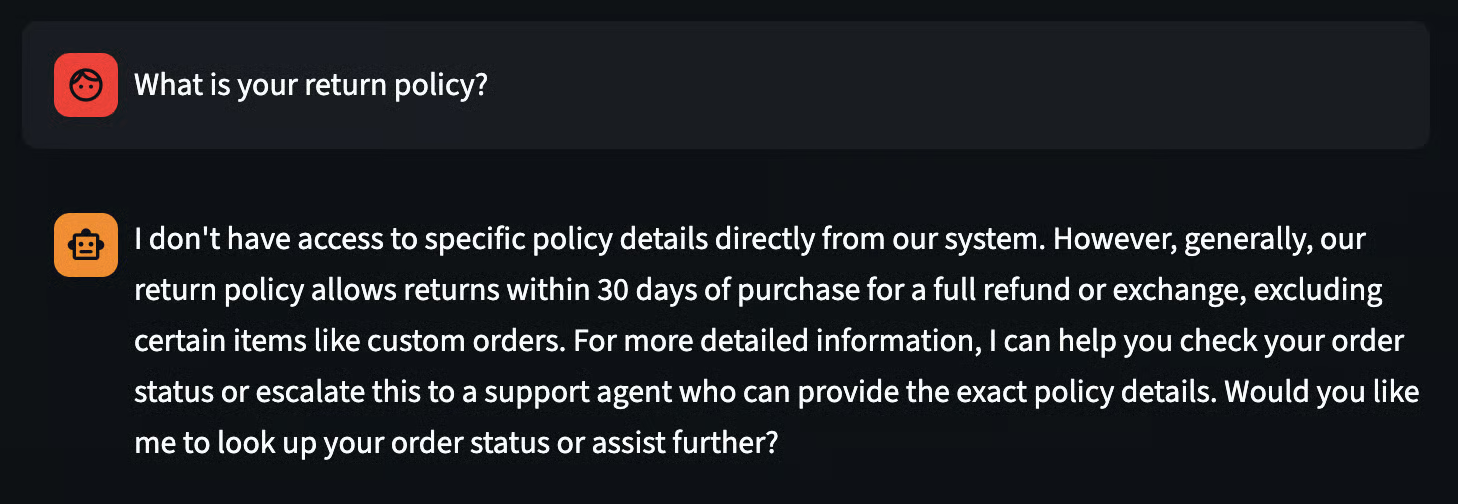
Gambar 3. Memori semantik sebagai pengetahuan domain
Memori prosedural adalah "bagaimana", alur kerja langkah demi langkah yang diketahui agen cara mengeksekusinya. Mencari pesanan, memulai pengembalian, melakukan eskalasi ke dukungan. Di Spring AI, ini adalah metode beranotasi @Tool yang dapat dipanggil LLM saat memutuskan tugas memerlukan tindakan, bukan sekadar jawaban.
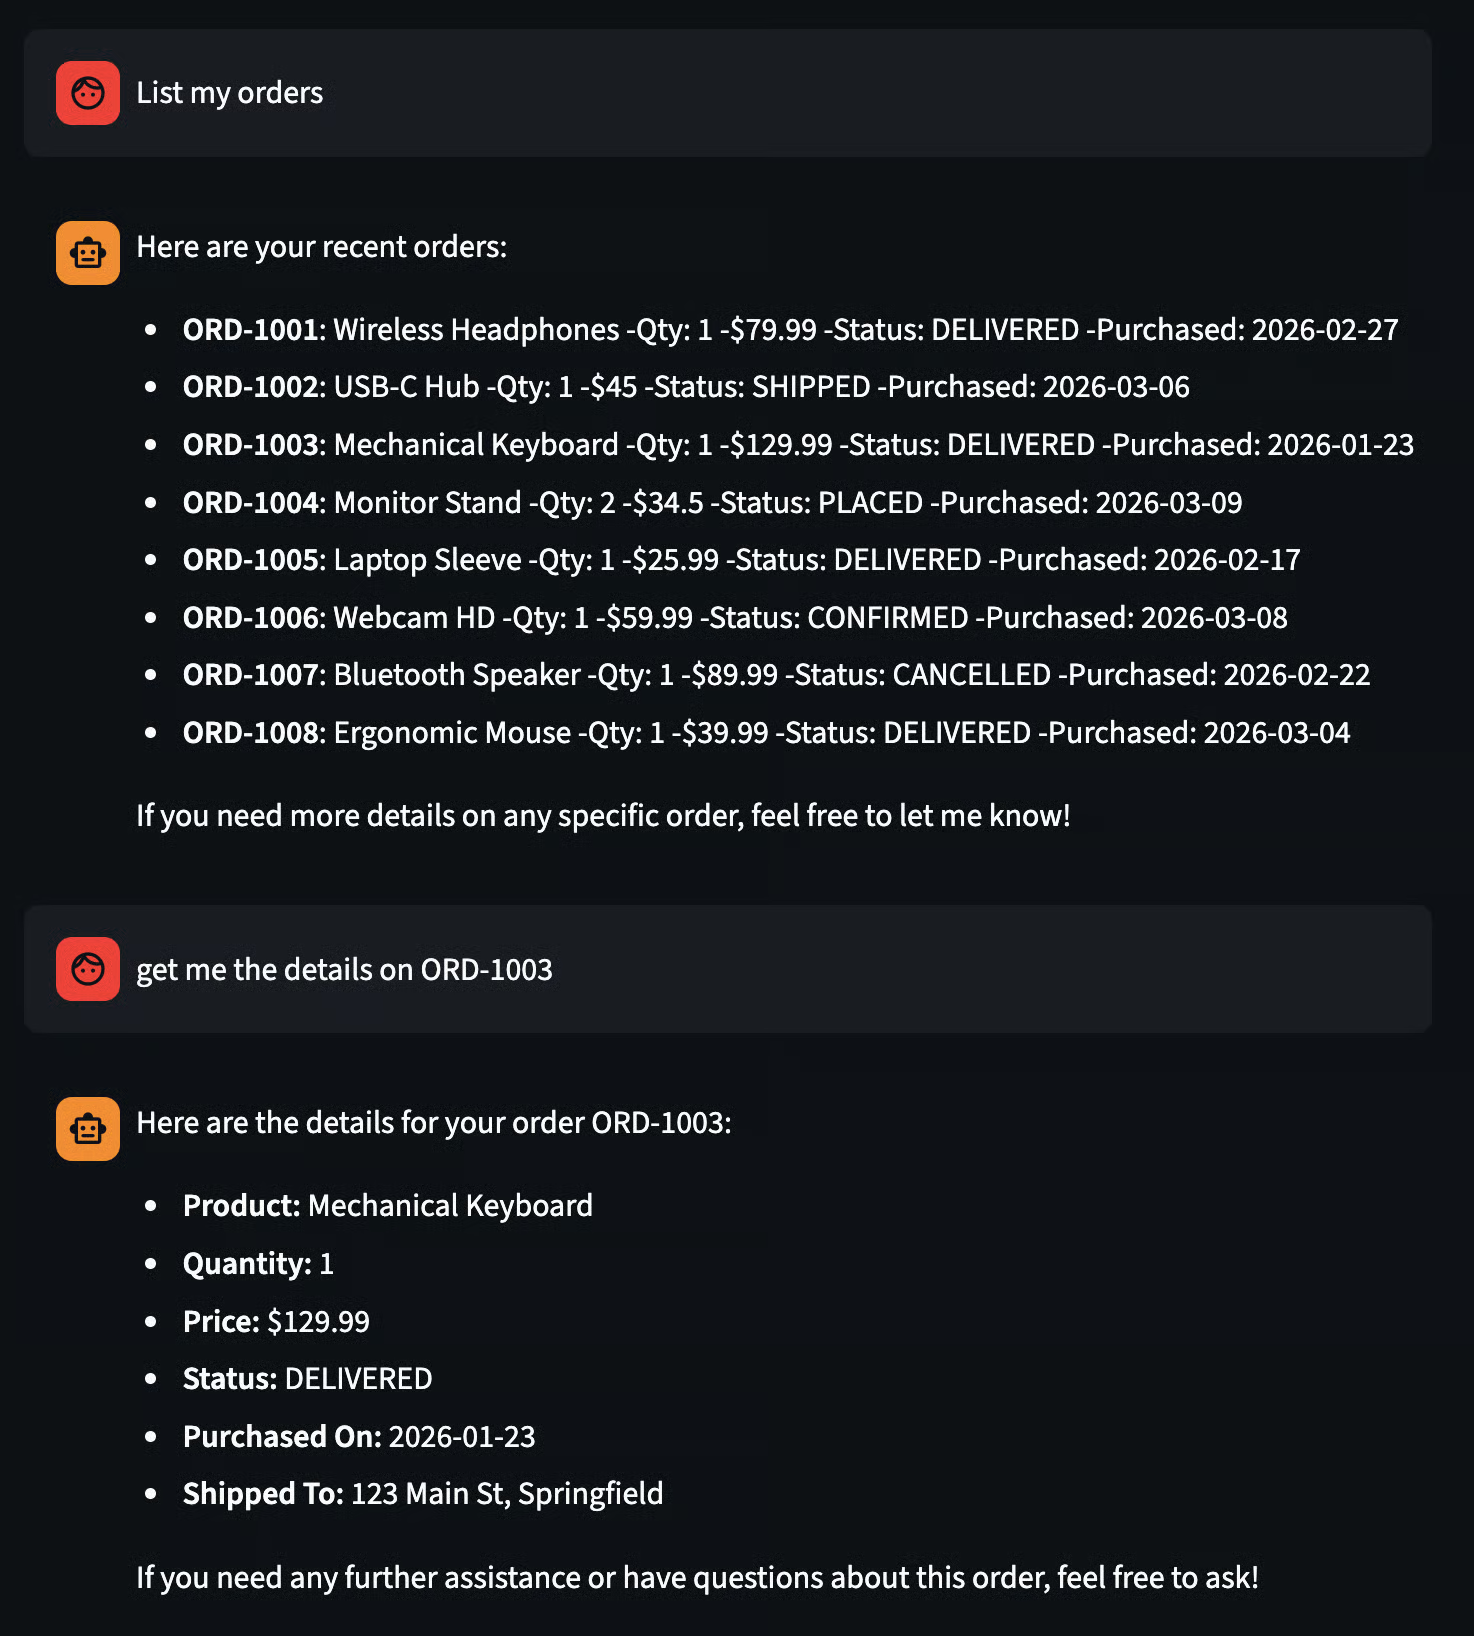
Gambar 4. Memori prosedural dalam aksi, saat agen menggunakan pemanggilan alat untuk menanyakan data pesanan langsung dan mengembalikan hasil spesifik tugas.
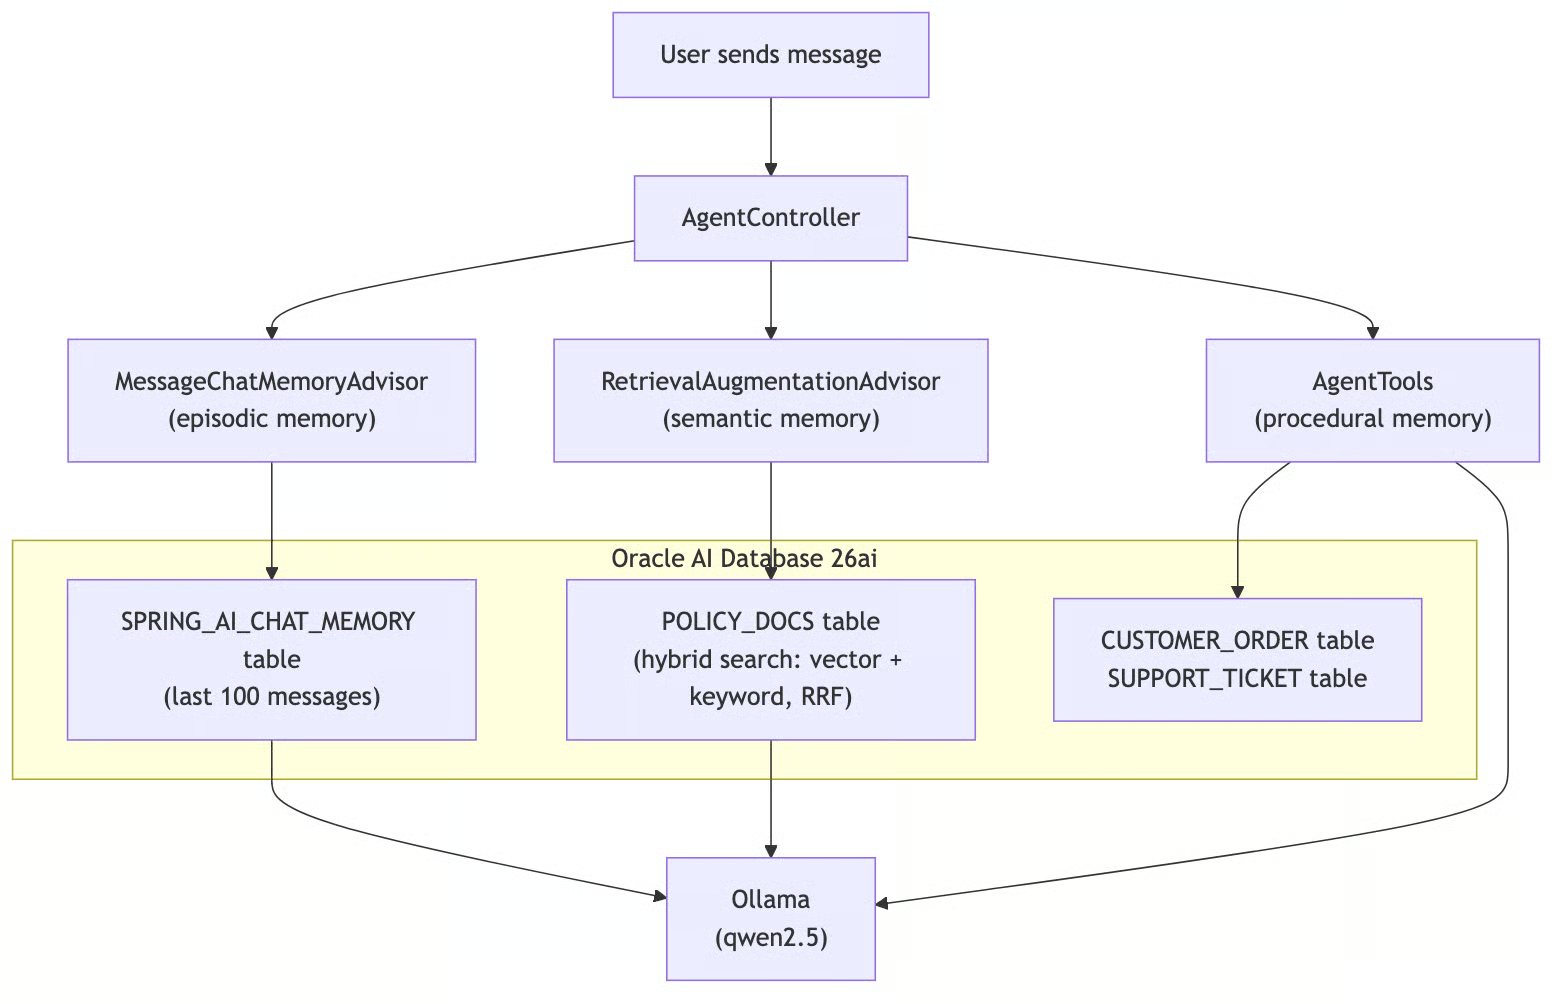
Gambar 5. Alur permintaan melalui AgentController, tempat memori episodik, semantik, dan prosedural dikombinasikan dari tabel Oracle AI Database sebelum menghasilkan respons dengan Ollama.
Kedua tabel berada di Oracle Database yang sama. Tanpa Pinecone. Tanpa Redis. Tanpa database kedua. Satu connection pool, satu set kredensial, satu hal untuk dipantau.
Memori prosedural diimplementasikan sebagai metode beranotasi @Tool dalam komponen Spring yang mengkueri tabel database nyata. Berikut dua metode representatif, disederhanakan untuk kejelasan; kelas lengkap memiliki total enam alat (lihat AgentTools.java):
@Tool(description = "Look up the status of a customer order by its order ID. " +
        "Returns the current status including shipping information.")
public String lookupOrderStatus(
        @ToolParam(description = "The order ID to look up, e.g. ORD-1001") String orderId) {
    // Fetches order from DB via JPA, returns formatted status string
}

@Tool(description = "Initiate a product return for a given order. " +
        "Validates the order exists, checks that it is in DELIVERED status, " +
        "and verifies the return is within the 30-day return window.")
public String initiateReturn(
        @ToolParam(description = "The order ID to return") String orderId,
        @ToolParam(description = "The reason for the return") String reason) {
    // Validates order exists, checks DELIVERED status and 30-day window, updates status via JPA
}
Deskripsi @Tool memberi tahu LLM kapan menggunakan tiap metode, dan @ToolParam menjelaskan argumennya. Saat pengguna berkata "Saya ingin mengembalikan pesanan ORD-1001," LLM membaca deskripsi alat, memutuskan initiateReturn adalah prosedur yang tepat, mengekstrak argumen dari percakapan, memanggil metode tersebut, dan menggabungkan hasilnya ke dalam respons.
Empat alat lainnya adalah getCurrentDateTime (mengambil tanggal/waktu saat ini dari database), listOrders, escalateToSupport, dan listSupportTickets. Polanya sama: kueri database melalui JPA atau JDBC. LLM memutuskan kapan harus bertindak; metode Java mendefinisikan caranya.
Controller menyatukan semuanya; dua advisor, enam alat, satu ChatClient. Berikut intinya, disederhanakan untuk kejelasan (versi lengkap menambahkan validasi input, penanganan error, dan endpoint manajemen percakapan. Lihat AgentController.java):
@RestController
@RequestMapping("/api/v1/agent")
public class AgentController {

    public AgentController(ChatClient.Builder builder,
                           JdbcChatMemoryRepository chatMemoryRepository,
                           JdbcTemplate jdbcTemplate,
                           AgentTools agentTools) {
        // Builds a ChatClient with:
        //   - MessageChatMemoryAdvisor (episodic: last 100 messages per conversation)
        //   - RetrievalAugmentationAdvisor + OracleHybridDocumentRetriever (semantic: hybrid search)
        //   - AgentTools via .defaultTools() (procedural: 6 @Tool methods)
        //   - System prompt defining the agent persona and tool usage rules
    }

    @PostMapping("/chat")
    public ResponseEntity<String> chat(
            @RequestBody String message,
            @RequestHeader("X-Conversation-Id") String conversationId) {
        // Sends message to ChatClient with conversation ID, returns LLM response
    }

    @PostMapping("/knowledge")
    public ResponseEntity<String> addKnowledge(@RequestBody String content) {
        // Inserts text into POLICY_DOCS table via JDBC (hybrid index handles embedding)
    }
}
Dua endpoint, dua advisor, enam alat, satu ChatClient. Mari uraikan tiga jenis memori.
Pola advisor di Spring AI adalah tempat keajaiban terjadi. Advisor mencegat setiap panggilan ke LLM dan dapat memodifikasi prompt sebelum dikirim serta memproses respons saat kembali.
MessageChatMemoryAdvisor menangani memori episodik. Sebelum setiap panggilan LLM, ia memuat 100 pesan terakhir untuk percakapan saat ini dari tabel SPRING_AI_CHAT_MEMORY dan menambahkannya di awal prompt. Setelah respons, ia menyimpan pertukaran baru. Percakapan diidentifikasi oleh header X-Conversation-Id: ID berbeda, memori berbeda.
RetrievalAugmentationAdvisor menangani memori semantik. Sebelum setiap panggilan LLM, OracleHybridDocumentRetriever kustom memanggil DBMS_HYBRID_VECTOR.SEARCH, yang menjalankan pencarian kemiripan vektor dan pencarian kata kunci Oracle Text secara paralel dan memadukan hasilnya dengan Reciprocal Rank Fusion (RRF).
Lima dokumen teratas yang cocok disuntikkan ke dalam prompt sebagai konteks melalui ContextualQueryAugmenter khusus yang memperlakukan dokumen sebagai pelengkap; LLM diminta menggunakannya hanya untuk pertanyaan kebijakan, bukan untuk permintaan tindakan atau konteks percakapan. Ini mencegah konteks RAG menimpa riwayat chat atau menekan pemanggilan alat.
Mengapa hibrida alih-alih pencarian vektor murni? Embedding padat menangkap makna: kueri tentang "kebijakan pengembalian" akan cocok dengan dokumen tentang refund dan penukaran meskipun kata-kata itu tidak muncul persis.
Namun lemah pada istilah persis: kueri untuk "ORD-1001" menurun kualitasnya karena model embedding mengodekan semantik, bukan kata kunci. Pencarian hibrida mencakup keduanya: sisi vektor menangani makna, sisi kata kunci menangani kecocokan persis, dan RRF menggabungkan dua daftar hasil berdasarkan posisi peringkat alih-alih mencoba menormalkan skor yang tidak sebanding.
AgentTools menangani memori prosedural. Panggilan .defaultTools(agentTools) mendaftarkan semua enam metode beranotasi @Tool dari komponen. Pada setiap permintaan, LLM menerima deskripsi alat bersama pesan pengguna. Jika tugas memerlukan tindakan, bukan sekadar pengambilan pengetahuan, LLM memanggil alat yang sesuai, memperoleh hasilnya, dan menenunnya ke dalam respons. Spring AI menangani protokol pemanggilan alat secara otomatis.
Ketiga jenis memori berjalan pada setiap permintaan. Agen secara bersamaan mengingat apa yang Anda ucapkan, mencari pengetahuan yang relevan, dan mengetahui cara melakukan tugas.
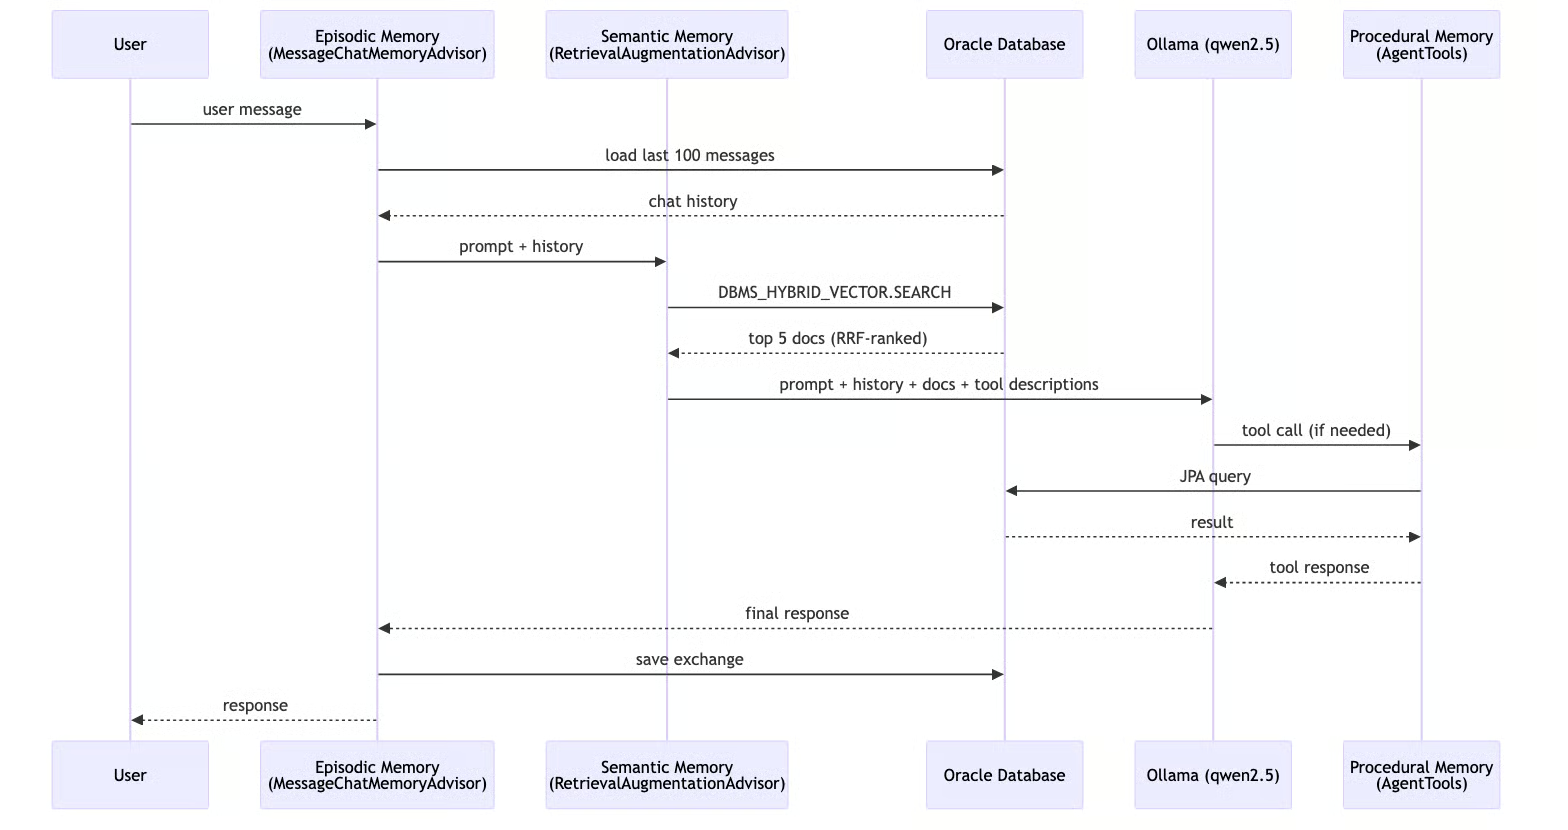
Gambar 6 Urutan permintaan end-to-end di mana riwayat chat, konteks RAG hibrida, dan pemanggilan alat opsional digabungkan untuk menghasilkan dan mempersistenkan respons akhir.
Endpoint /knowledge sederhana: POST beberapa teks, dan itu akan dimasukkan ke tabel POLICY_DOCS melalui JDBC. Indeks vektor hibrida menangani embedding secara otomatis menggunakan model ONNX di dalam database, tanpa perlu panggilan API embedding eksternal. Lain kali seseorang menanyakan pertanyaan terkait, pencarian hibrida akan menemukannya.
Sebuah DataSeeder (Spring CommandLineRunner) mengisi database saat startup dengan 8 pesanan demo dan 12 dokumen kebijakan (pengembalian, pengiriman, dukungan, garansi, pembayaran, pembatalan, penukaran, pengiriman internasional, privasi, promosi, jaminan produk, dan kebijakan pemesanan dalam jumlah besar). Kebijakan dimuat dari berkas sumber policies.json dan dimasukkan ke tabel POLICY_DOCS melalui JDBC. Pesanan menggunakan tanggal relatif sehingga logika jendela pengembalian 30 hari selalu berfungsi untuk tujuan demo. Seeder memeriksa jumlah yang ada untuk menghindari duplikasi saat restart.
Versi pertama POC ini menggunakan QuestionAnswerAdvisor milik Spring AI dengan OracleVectorStore: pencarian kemiripan vektor murni dengan ambang kosinus. Ini bekerja untuk pertanyaan yang bersih dan terumus baik tentang kebijakan. Namun runtuh pada istilah persis dan salah ketik. Kueri "order ORD-1001" akan mencoba mencocokkan secara semantik terhadap dokumen kebijakan, yang tidak masuk akal. Salah ketik "retrun polcy" akan kehilangan skor kemiripan karena model embedding tidak tahu itu salah ketik.
Oracle 26ai menyediakan DBMS_HYBRID_VECTOR.SEARCH, satu panggilan PL/SQL yang menjalankan pencarian kemiripan vektor dan pencarian kata kunci Oracle Text secara paralel, lalu memadukan hasilnya.
Wawasan kuncinya adalah Reciprocal Rank Fusion (RRF): alih-alih mencoba menormalkan skor kemiripan kosinus (dibatasi 0-1) terhadap skor kata kunci BM25 (tidak dibatasi), ia memberi peringkat dokumen berdasarkan posisinya di setiap daftar hasil.
Dokumen yang berada di peringkat #1 pada hasil vektor dan #3 pada hasil kata kunci mendapatkan peringkat gabungan yang mencerminkan kedua sinyal.
Penyiapannya adalah skrip SQL satu kali yang memuat model embedding ONNX ke Oracle AI Database dan membuat indeks hibrida:
/SQL
-- Load the ONNX model for in-database embeddings
BEGIN
  DBMS_VECTOR.LOAD_ONNX_MODEL(
    directory  => 'DM_DUMP',
    file_name  => 'all_MiniLM_L12_v2.onnx',
    model_name => 'ALL_MINILM_L12_V2'
  );
END;
/

-- Create a hybrid index: vector similarity + Oracle Text keyword search
CREATE HYBRID VECTOR INDEX POLICY_HYBRID_IDX
ON POLICY_DOCS(content)
PARAMETERS('MODEL ALL_MINILM_L12_V2 VECTOR_IDXTYPE HNSW');
Setelah indeks ada, embedding dihitung secara otomatis saat baris dimasukkan — tanpa perlu panggilan API embedding eksternal.
QuestionAnswerAdvisor milik Spring AI hanya membungkus VectorStore.similaritySearch(), pencarian vektor murni, tidak ada yang lain. Untuk menggunakan pencarian hibrida, saya beralih ke RetrievalAugmentationAdvisor, yang merupakan alternatif modular: ia menerima DocumentRetriever kustom dan QueryAugmenter kustom untuk mengontrol bagaimana dokumen yang diambil disuntikkan ke prompt.
OracleHybridDocumentRetriever kustom mengimplementasikan DocumentRetriever dan memanggil DBMS_HYBRID_VECTOR.SEARCH melalui JDBC, meneruskan parameter JSON yang menentukan indeks hibrida, penilaian (RRF), dan pencocokan kata kunci:
public List<Document> retrieve(Query query) {
    // Builds a JSON spec with hybrid index name, RRF scorer, vector + text search clauses
    // Calls DBMS_HYBRID_VECTOR.SEARCH via JDBC, parses JSON results into List<Document>
}
Ini melewati OracleVectorStore sepenuhnya untuk retrieval. Klausa text.contains menggunakan pencocokan kata kunci OR biasa (kata lebih dari 2 karakter), membiarkan stemming bawaan Oracle Text menangani variasi.
Agen memerlukan pengambilan yang akurat untuk membuat keputusan yang baik. Jika memori semantik mengembalikan dokumen kebijakan yang salah atau berkeyakinan rendah, LLM mungkin berhalusinasi parameter alat atau melewatkan pemanggilan alat yang seharusnya digunakan.
Pencarian hibrida berarti konteks dengan keyakinan lebih tinggi, yang berarti keputusan otonom yang lebih baik; agen lebih kecil kemungkinannya untuk salah mengutip kebijakan atau melewatkan dokumen relevan saat makna dan istilah persis sama-sama dicocokkan.
Konfigurasi berada dalam satu application.yaml. Keputusan desain kunci: Hibernate membuat tabel JPA secara otomatis (ddl-auto: update), Spring AI membuat tabel memori chat secara otomatis (initialize-schema: always), tabel POLICY_DOCS dan hybrid vector index dibuat oleh skrip SQL satu kali (setup-hybrid-search.sql), dan Oracle UCP membagikan satu connection pool untuk ketiga jenis memori.
Tanpa Flyway, tanpa kelas @Configuration kustom. Konfigurasi otomatis Spring AI mendeteksi driver JDBC Oracle dan menghubungkan semuanya. Lihat application.yaml lengkap di repositori.
Frontend Streamlit mengirim pesan ke backend dan merender respons. Berikut intinya (aplikasi penuh menyertakan tombol cepat mulai dan fitur percakapan baru. Lihat app.py):
def send_message(prompt, url):
    # POSTs plain text to /api/v1/agent/chat with X-Conversation-Id header
    # Renders user message and assistant response in Streamlit chat UI

if prompt := st.chat_input("Type a message..."):
    send_message(prompt, backend_url)
Ia menghasilkan UUID per sesi untuk ID percakapan, mengirim teks biasa ke backend, dan merender respons. Itu saja.
Versi singkat: mulai kontainer Oracle DB, muat model ONNX dan buat indeks hibrida (penyiapan satu kali), instal Ollama dan tarik model chat (qwen2.5), jalankan backend Spring Boot dengan profil local, dan opsional mulai UI Streamlit. Embedding ditangani di dalam database oleh model ONNX, tanpa perlu model embedding Ollama. Petunjuk penyiapan lengkap ada di repo README.
Uji cepat dengan curl:
curl -X POST http://localhost:8080/api/v1/agent/chat \
  -H "Content-Type: text/plain" \
  -H "X-Conversation-Id: test-1" \
-d "What orders do I have?"Pengaturan ini adalah default yang kuat untuk membangun agen nyata dengan Spring AI dan Oracle Database karena menjaga semua lapisan memori dalam satu tumpukan operasional: konteks episodik, retrieval semantik, dan tindakan prosedural. Spring AI memberi Anda abstraksi yang rapi (Advisors + @Tool) sehingga perilaku agen tetap mudah dibaca dan diuji, sementara Oracle menangani data transaksional dan retrieval hibrida dalam sistem yang sama, dengan embedding di dalam database dan peringkat RRF untuk presisi lebih baik pada makna maupun istilah persis.
Hasilnya praktis: lebih sedikit komponen bergerak, lebih sedikit kegagalan integrasi, latensi lebih rendah, dan operasi produksi lebih mudah. Alih-alih menjahit sistem terpisah untuk riwayat chat, pencarian vektor, pencarian kata kunci, dan tabel bisnis, Anda membangun di satu platform dan tetap mendapatkan retrieval berkualitas tinggi plus eksekusi alat yang andal. Bagi tim yang mengirimkan fitur agen, kombinasi kesederhanaan, akurasi, dan kontrol operasional itu sulit dikalahkan.
Untuk mempelajari lebih lanjut tentang agen AI dan cara kerjanya, saya sarankan melihat AI Agent Fundamentals skill track dari DataCamp.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt




