Curso
Introducción a Oracle SQL
4 h
18.3K
Todos los LLM tienen el mismo problema: olvidan todo en cuanto termina la conversación, a veces incluso durante conversaciones largas. Te pasas veinte minutos explicando la configuración de tu proyecto, tus limitaciones y tus preferencias, y clava la respuesta. Cierras la pestaña, abres una sesión nueva y te saluda como si no te conociera. Todo ese contexto, desaparecido.
Si quieres crear un agente de IA que realmente recuerde el contexto y conozca tu dominio, tienes que darle memoria. Del tipo práctico: que recuerde lo que dijiste y pueda consultar los hechos que le enseñaste.
Este es un POC que construí justo para eso. Tres tipos de memoria, una base de datos y poco código. El código fuente completo está disponible en GitHub.
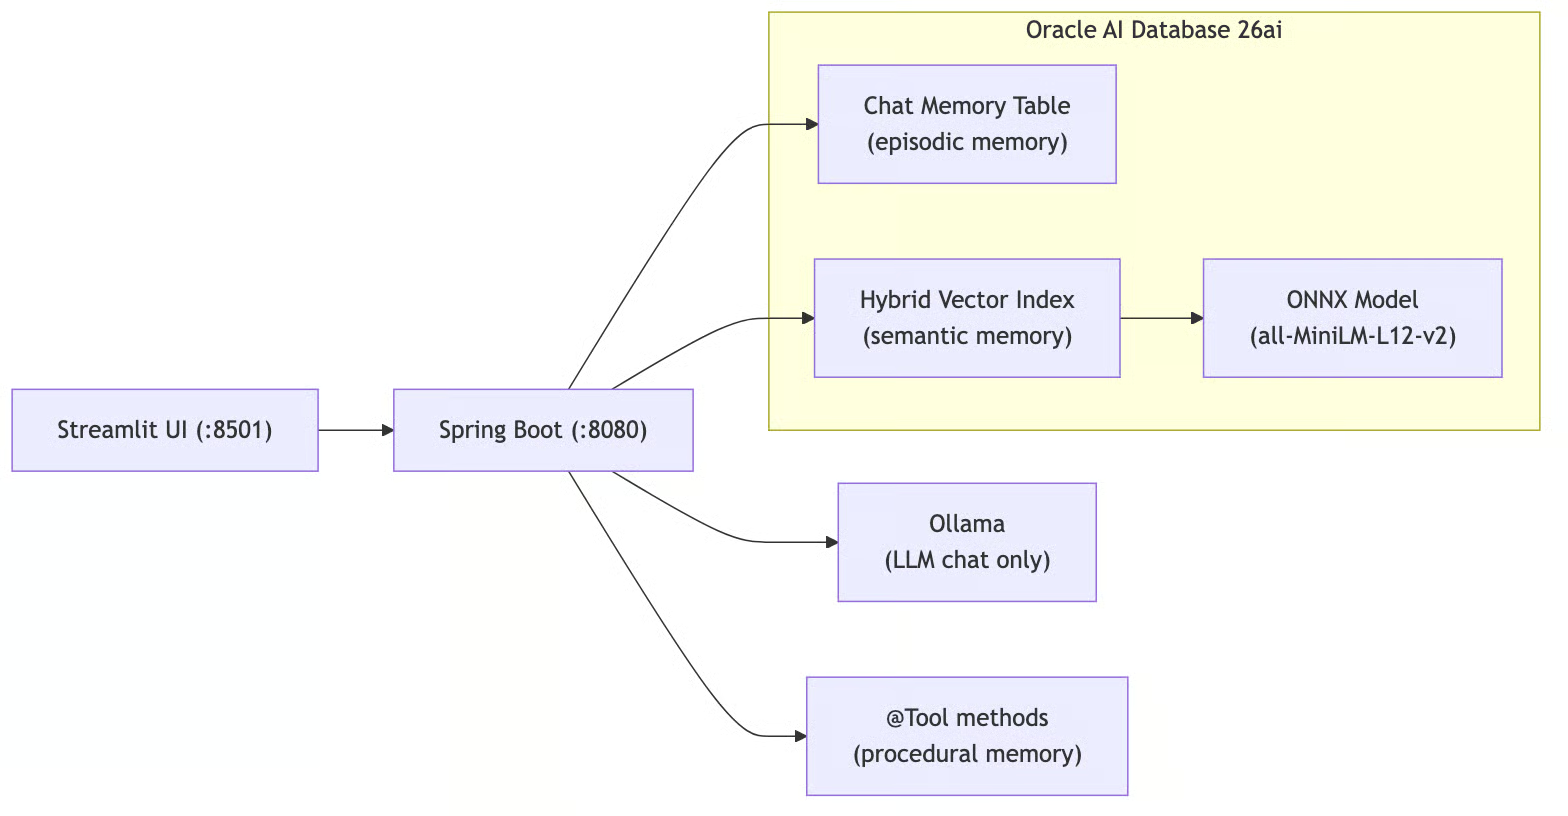
Figura 1. Arquitectura de memoria de extremo a extremo con Spring AI y Oracle AI Database 26ai
El stack:
Suele hablarse de memoria episódica, semántica, procedimental y de trabajo en agentes.
La memoria de trabajo es simplemente la ventana de contexto del LLM; el "bloc de notas" activo de la petición actual. No se persiste, así que no hay nada que construir. Yo he implementado las otras tres:
La memoria episódica es el historial de chat. El agente recuerda lo que dijiste antes. "Me llamo Víctor" en el mensaje 1 implica que aún sabe tu nombre en el mensaje 50. Se almacena como filas en una tabla relacional.
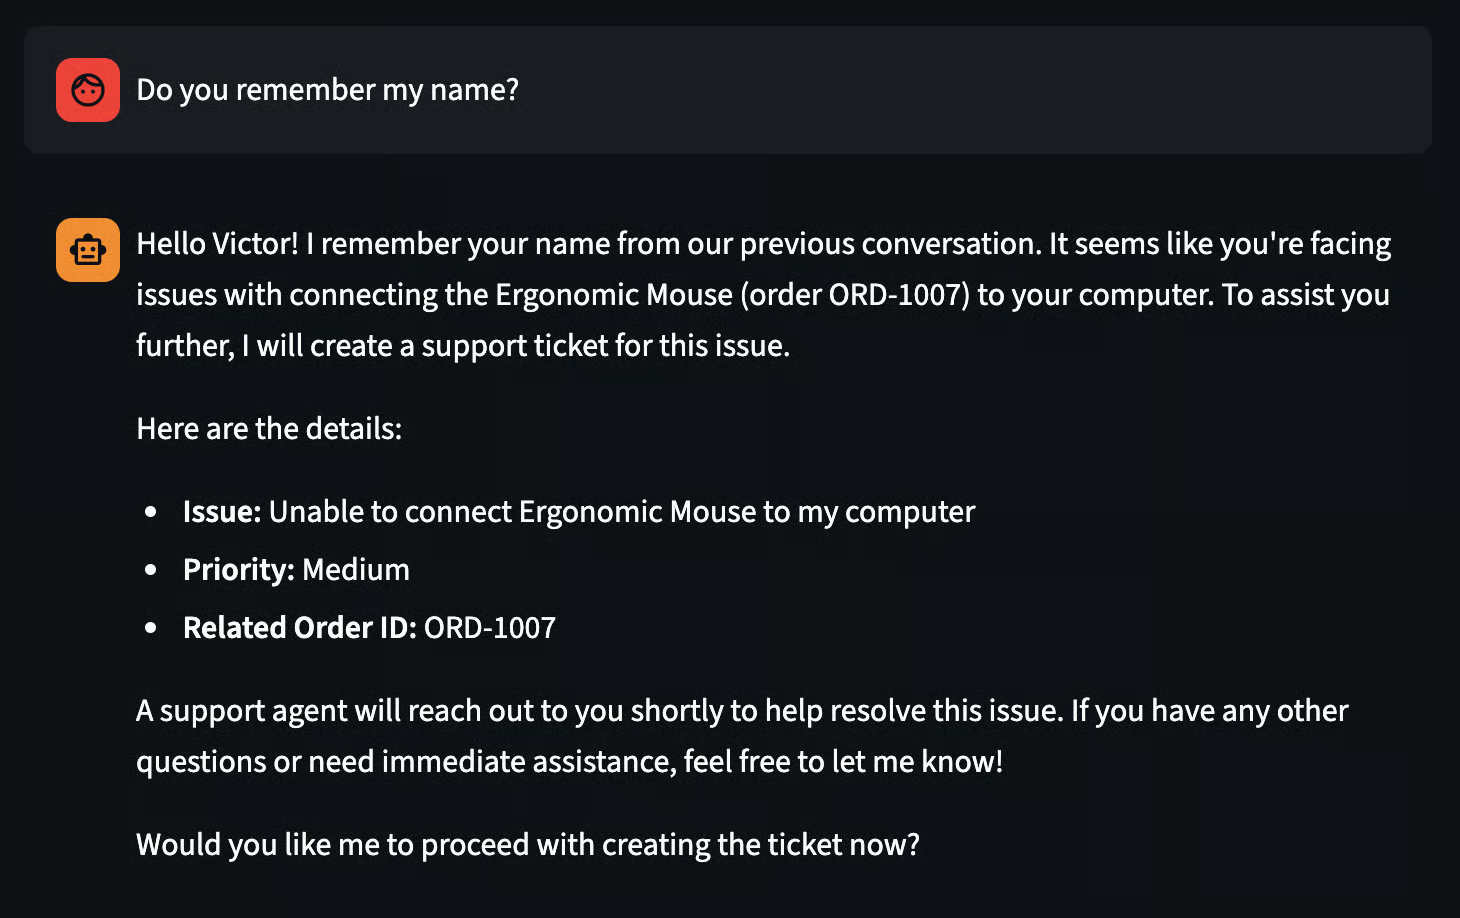
Figura 2. La memoria episódica es el historial de chat
La memoria semántica es el conocimiento del dominio. Alimentas al agente con hechos (documentación de producto, políticas de empresa, lo que sea) y los recupera cuando responde preguntas.
Esto es RAG (Retrieval-Augmented Generation): el texto se convierte en vectores densos (embeddings) que mapean significado a un espacio geométrico, de modo que los textos semánticamente similares quedan cerca.
Pero la búsqueda puramente vectorial tiene puntos ciegos: captura bien el significado, pero se atasca con términos exactos como IDs de pedido o códigos de producto.
Por eso este POC usa Hybrid Vector Indexes de Oracle, que ejecutan en paralelo búsqueda por similitud vectorial y por palabras clave, y luego fusionan ambos resultados con Reciprocal Rank Fusion (RRF).
En la consulta, la búsqueda híbrida encuentra documentos que coinciden por significado o por términos exactos e inyecta los mejores resultados en el prompt del LLM. Los embeddings se calculan dentro de la base de datos con un modelo ONNX (all-MiniLM-L12-v2, 384 dimensiones) cargado directamente en Oracle, sin llamadas a APIs externas de embeddings. Más abajo explico cómo funciona.
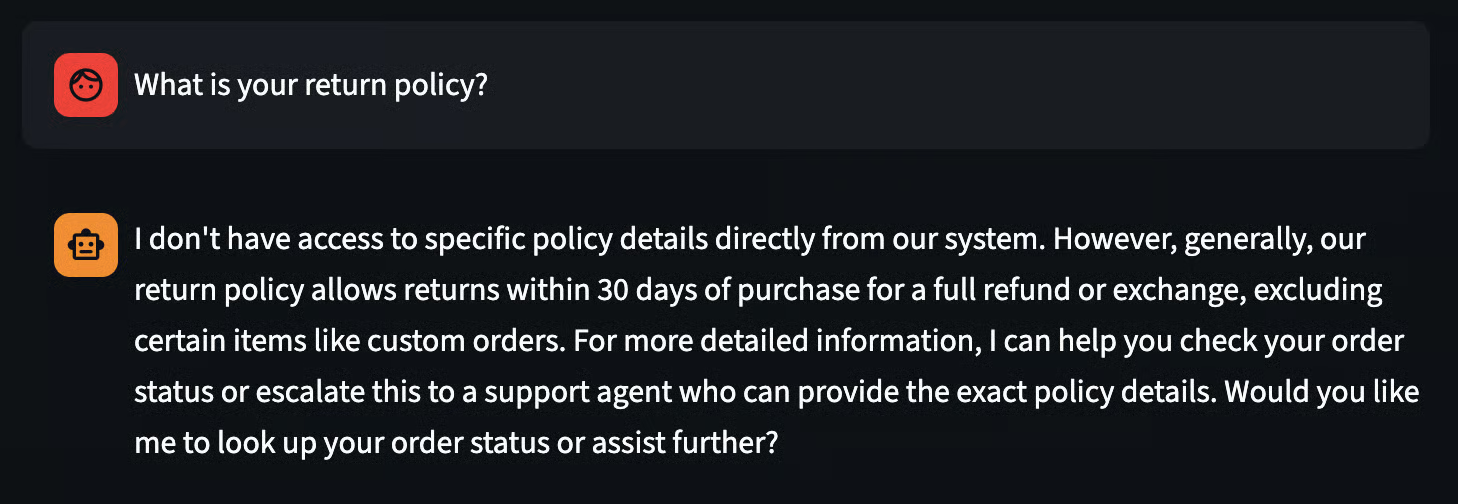
Figura 3. La memoria semántica como conocimiento del dominio
La memoria procedimental es el "cómo": los flujos paso a paso que el agente sabe ejecutar. Consultar un pedido, iniciar una devolución, escalar a soporte. En Spring AI, son métodos anotados con @Tool que el LLM puede invocar cuando decide que una tarea requiere acción, no solo una respuesta.
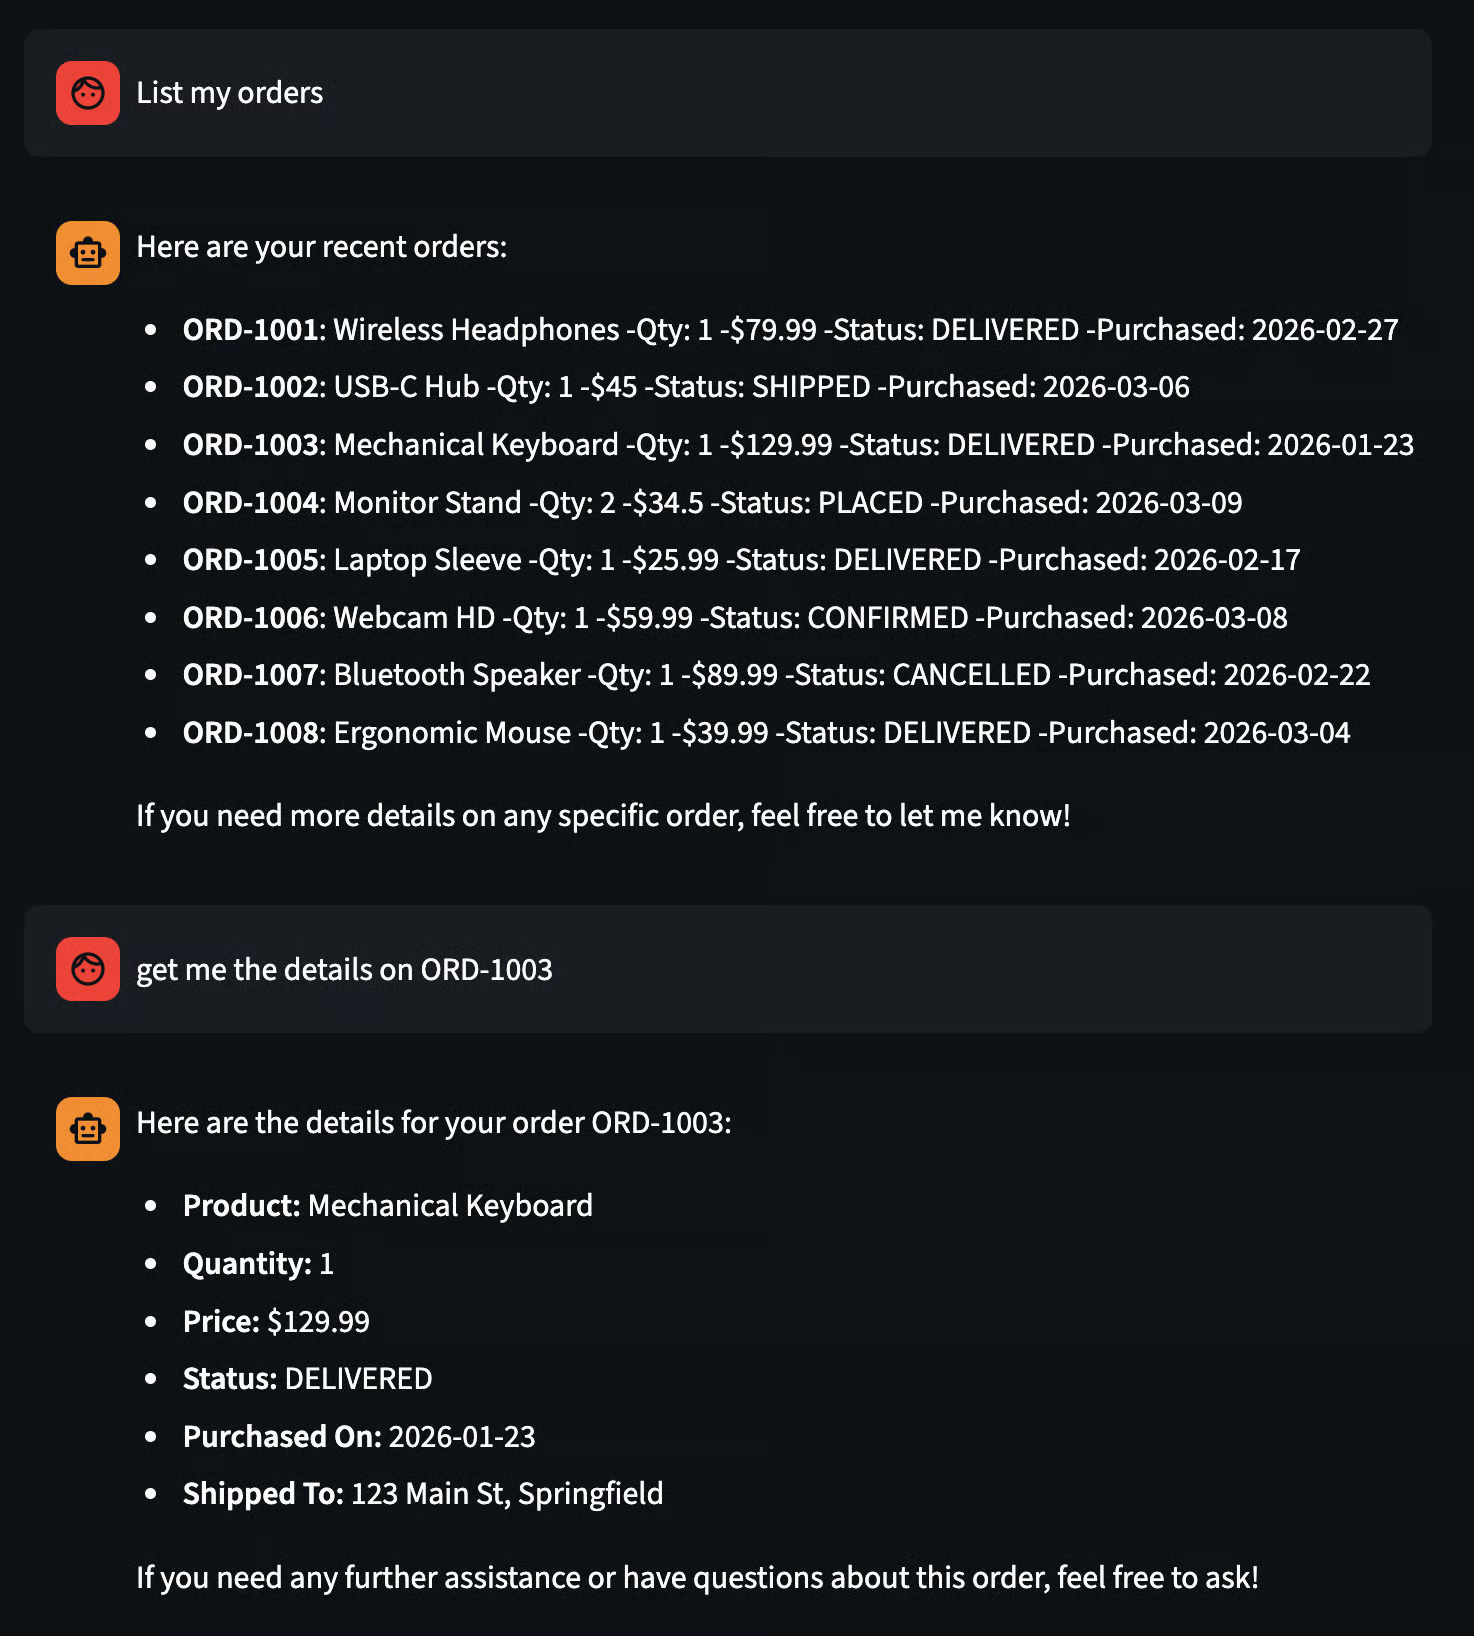
Figura 4. Memoria procedimental en acción: el agente usa herramientas para consultar pedidos en vivo y devolver resultados específicos de la tarea.
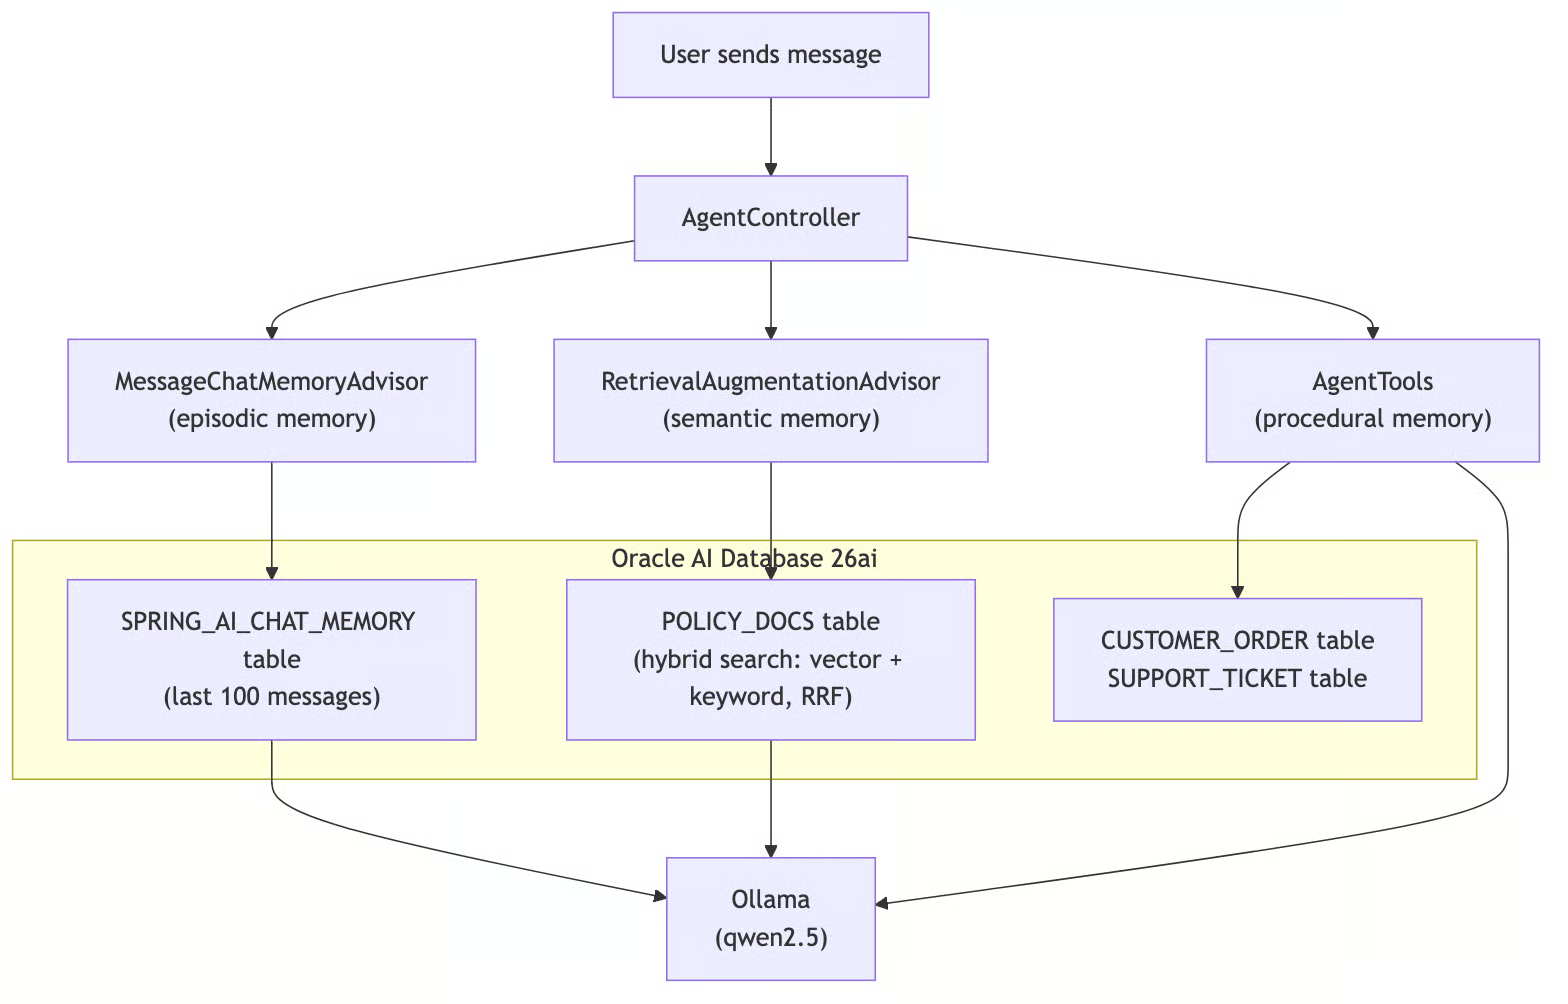
Figura 5. Flujo de petición en AgentController, donde se combinan las memorias episódica, semántica y procedimental desde tablas de Oracle AI Database antes de generar la respuesta con Ollama.
Ambas tablas viven en la misma base de datos Oracle. Sin Pinecone. Sin Redis. Sin segunda base de datos. Un único pool de conexiones, un único set de credenciales, una sola cosa que monitorizar.
La memoria procedimental se implementa como métodos anotados con @Tool en un componente de Spring que consulta tablas reales. Aquí tienes dos métodos representativos, simplificados para mayor claridad; la clase completa tiene seis herramientas en total (ver AgentTools.java):
@Tool(description = "Look up the status of a customer order by its order ID. " +
        "Returns the current status including shipping information.")
public String lookupOrderStatus(
        @ToolParam(description = "The order ID to look up, e.g. ORD-1001") String orderId) {
    // Fetches order from DB via JPA, returns formatted status string
}

@Tool(description = "Initiate a product return for a given order. " +
        "Validates the order exists, checks that it is in DELIVERED status, " +
        "and verifies the return is within the 30-day return window.")
public String initiateReturn(
        @ToolParam(description = "The order ID to return") String orderId,
        @ToolParam(description = "The reason for the return") String reason) {
    // Validates order exists, checks DELIVERED status and 30-day window, updates status via JPA
}
La descripción de @Tool indica al LLM cuándo usar cada método, y @ToolParam describe los argumentos. Cuando el usuario dice "Quiero devolver el pedido ORD-1001", el LLM lee las descripciones de las herramientas, decide que initiateReturn es el procedimiento correcto, extrae los argumentos de la conversación, llama al método e incorpora el resultado a su respuesta.
Las otras cuatro herramientas son getCurrentDateTime (obtiene fecha y hora actuales de la base de datos), listOrders, escalateToSupport y listSupportTickets. Siguen el mismo patrón: consultas a base de datos vía JPA o JDBC. El LLM decide cuándo actuar; los métodos Java definen el cómo.
El controlador orquesta todo: dos advisors, seis herramientas, un ChatClient. Aquí va el núcleo, simplificado para mayor claridad (la versión completa añade validación de entrada, manejo de errores y endpoints de gestión de conversaciones. Ver AgentController.java):
@RestController
@RequestMapping("/api/v1/agent")
public class AgentController {

    public AgentController(ChatClient.Builder builder,
                           JdbcChatMemoryRepository chatMemoryRepository,
                           JdbcTemplate jdbcTemplate,
                           AgentTools agentTools) {
        // Builds a ChatClient with:
        //   - MessageChatMemoryAdvisor (episodic: last 100 messages per conversation)
        //   - RetrievalAugmentationAdvisor + OracleHybridDocumentRetriever (semantic: hybrid search)
        //   - AgentTools via .defaultTools() (procedural: 6 @Tool methods)
        //   - System prompt defining the agent persona and tool usage rules
    }

    @PostMapping("/chat")
    public ResponseEntity<String> chat(
            @RequestBody String message,
            @RequestHeader("X-Conversation-Id") String conversationId) {
        // Sends message to ChatClient with conversation ID, returns LLM response
    }

    @PostMapping("/knowledge")
    public ResponseEntity<String> addKnowledge(@RequestBody String content) {
        // Inserts text into POLICY_DOCS table via JDBC (hybrid index handles embedding)
    }
}
Dos endpoints, dos advisors, seis herramientas, un ChatClient. Veamos los tres tipos de memoria.
El patrón de advisors de Spring AI es donde está la magia. Los advisors interceptan cada llamada al LLM y pueden modificar el prompt antes de enviarlo y procesar la respuesta al volver.
MessageChatMemoryAdvisor gestiona la memoria episódica. Antes de cada llamada al LLM, carga los últimos 100 mensajes de la conversación actual desde la tabla SPRING_AI_CHAT_MEMORY y los antepone al prompt. Tras la respuesta, guarda el nuevo intercambio. La conversación se identifica con la cabecera X-Conversation-Id: ID distinto, memoria distinta.
RetrievalAugmentationAdvisor gestiona la memoria semántica. Antes de cada llamada al LLM, un OracleHybridDocumentRetriever personalizado llama a DBMS_HYBRID_VECTOR.SEARCH, que ejecuta en paralelo la búsqueda por similitud vectorial y la búsqueda por palabras clave de Oracle Text y fusiona los resultados con Reciprocal Rank Fusion (RRF).
Los 5 documentos mejor clasificados se inyectan en el prompt como contexto mediante un ContextualQueryAugmenter a medida que los trata como material de apoyo; se indica al LLM que los use solo para preguntas de políticas, no para acciones ni para contexto conversacional. Así evitamos que el contexto RAG sobrepase el historial de chat o suprima llamadas a herramientas.
¿Por qué híbrido en lugar de puramente vectorial? Los embeddings densos capturan significado: una consulta sobre "política de devoluciones" hará match con documentos de reembolsos e intercambios aunque esas palabras exactas no aparezcan.
Pero flojean con términos exactos: una búsqueda de "ORD-1001" se degrada porque el modelo de embeddings codifica semántica, no keywords. La búsqueda híbrida cubre ambos casos: el lado vectorial maneja el significado, el lado de palabras clave maneja coincidencias exactas, y RRF fusiona ambas listas por posición en ranking en vez de intentar normalizar puntuaciones incompatibles.
AgentTools gestiona la memoria procedimental. La llamada .defaultTools(agentTools) registra los seis métodos anotados con @Tool del componente. En cada petición, el LLM recibe las descripciones de las herramientas junto al mensaje del usuario. Si la tarea requiere acción y no solo recuperar conocimiento, llama a la herramienta adecuada, obtiene el resultado y lo integra en su respuesta. Spring AI gestiona el protocolo de llamadas a herramientas automáticamente.
Los tres tipos de memoria se ejecutan en cada petición. El agente recuerda lo que dijiste, consulta conocimiento relevante y sabe cómo realizar tareas.
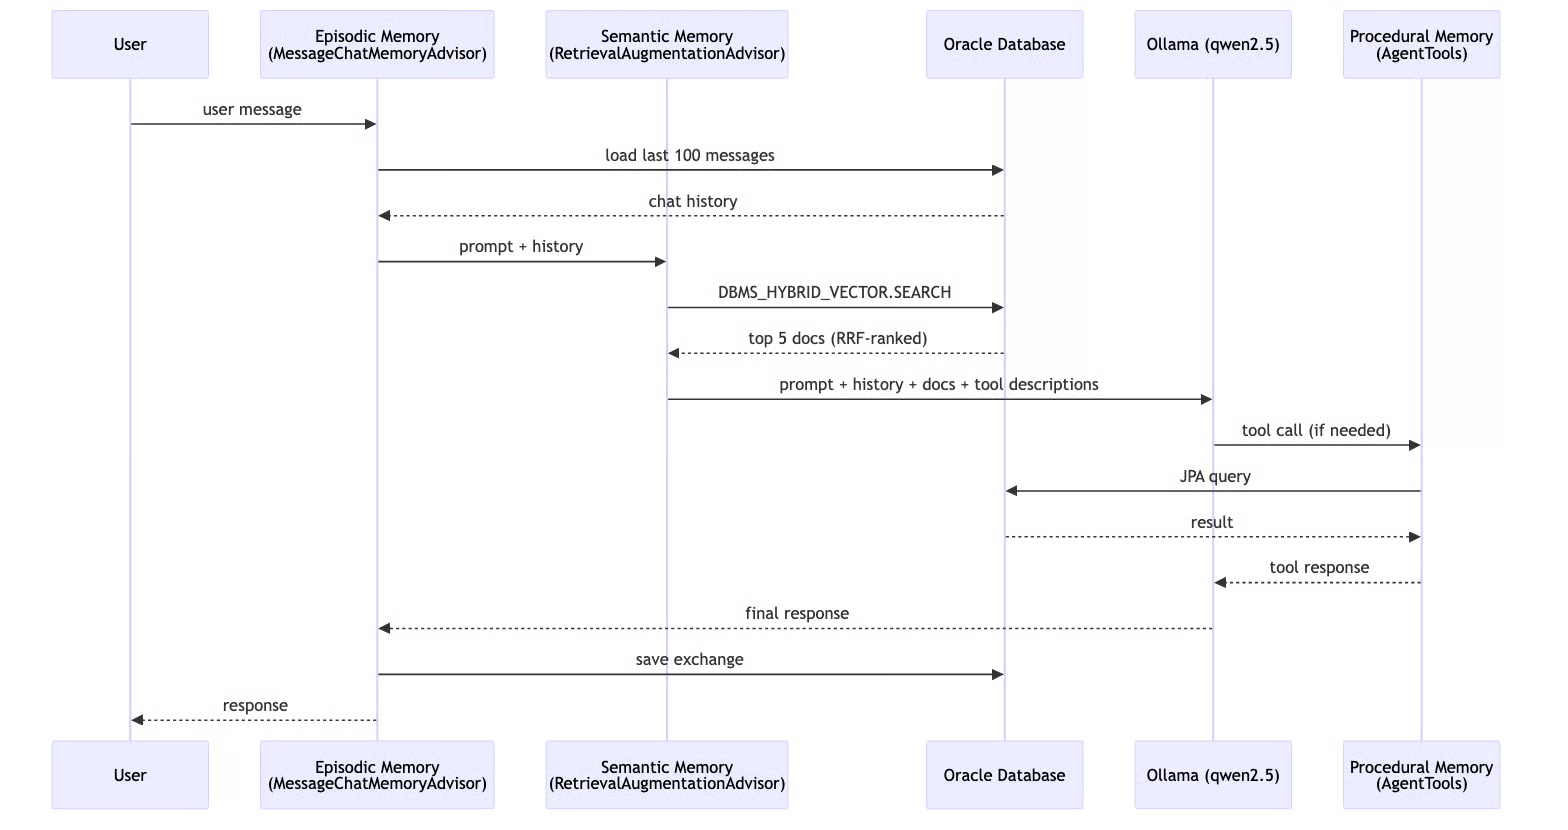
Figura 6. Secuencia de extremo a extremo donde historial de chat, contexto RAG híbrido y llamadas a herramientas opcionales se combinan para producir y persistir la respuesta final.
El endpoint /knowledge es sencillo: haces POST con texto y se inserta en la tabla POLICY_DOCS vía JDBC. El índice vectorial híbrido se encarga automáticamente de los embeddings usando el modelo ONNX en la base de datos, sin necesidad de una API externa de embeddings. La próxima vez que alguien pregunte algo relacionado, la búsqueda híbrida lo encontrará.
Un DataSeeder (CommandLineRunner de Spring) rellena la base de datos al inicio con 8 pedidos de demo y 12 documentos de políticas (devoluciones, envíos, soporte, garantía, pagos, cancelaciones, cambios, envíos internacionales, privacidad, promociones, garantía de producto y pedidos al por mayor). Las políticas se cargan desde un recurso policies.json y se insertan en la tabla POLICY_DOCS vía JDBC. Los pedidos usan fechas relativas para que la lógica de la ventana de devolución de 30 días funcione siempre en la demo. El seeder comprueba recuentos existentes para evitar duplicados en reinicios.
La primera versión de este POC usaba QuestionAnswerAdvisor de Spring AI con OracleVectorStore: búsqueda de similitud vectorial pura con umbral de coseno. Funcionaba para preguntas claras y bien formuladas sobre políticas. Pero se venía abajo con términos exactos y con typos. Una consulta como "order ORD-1001" intentaba casar semánticamente con documentos de políticas, lo cual no tiene sentido. Un "retrun polcy" mal escrito perdía puntuación porque el modelo de embeddings no sabe que es un error tipográfico.
Oracle 26ai ofrece DBMS_HYBRID_VECTOR.SEARCH, una única llamada PL/SQL que ejecuta en paralelo búsqueda por similitud vectorial y búsqueda por palabras clave con Oracle Text, y luego fusiona los resultados.
La clave es Reciprocal Rank Fusion (RRF): en lugar de intentar normalizar puntuaciones de coseno (acotadas 0-1) frente a BM25 (no acotadas), clasifica los documentos por su posición en cada lista de resultados.
Un documento que es n.º 1 en resultados vectoriales y n.º 3 en resultados por keywords obtiene un ranking combinado que refleja ambas señales.
La configuración es un script SQL de una sola vez que carga un modelo de embeddings ONNX en Oracle AI Database y crea un índice híbrido:
/SQL
-- Load the ONNX model for in-database embeddings
BEGIN
  DBMS_VECTOR.LOAD_ONNX_MODEL(
    directory  => 'DM_DUMP',
    file_name  => 'all_MiniLM_L12_v2.onnx',
    model_name => 'ALL_MINILM_L12_V2'
  );
END;
/

-- Create a hybrid index: vector similarity + Oracle Text keyword search
CREATE HYBRID VECTOR INDEX POLICY_HYBRID_IDX
ON POLICY_DOCS(content)
PARAMETERS('MODEL ALL_MINILM_L12_V2 VECTOR_IDXTYPE HNSW');
Una vez existe el índice, los embeddings se calculan automáticamente al insertar filas —sin llamadas externas a APIs de embeddings.
El QuestionAnswerAdvisor de Spring AI solo envuelve VectorStore.similaritySearch(), búsqueda vectorial pura y nada más. Para usar la búsqueda híbrida, cambié a RetrievalAugmentationAdvisor, la alternativa modular: acepta un DocumentRetriever personalizado y un QueryAugmenter a medida para controlar cómo se inyectan los documentos recuperados en el prompt.
El OracleHybridDocumentRetriever personalizado implementa DocumentRetriever y llama a DBMS_HYBRID_VECTOR.SEARCH vía JDBC, pasando un parámetro JSON que especifica el índice híbrido, el scorer (RRF) y una coincidencia por palabras clave:
public List<Document> retrieve(Query query) {
    // Builds a JSON spec with hybrid index name, RRF scorer, vector + text search clauses
    // Calls DBMS_HYBRID_VECTOR.SEARCH via JDBC, parses JSON results into List<Document>
}
Esto evita usar OracleVectorStore para la recuperación. La cláusula text.contains usa coincidencia simple por palabras clave con OR (palabras de más de 2 caracteres), dejando que el stemming integrado de Oracle Text gestione variaciones.
El agente necesita recuperaciones precisas para tomar buenas decisiones. Si la memoria semántica devuelve documentos erróneos o de baja confianza, el LLM puede alucinar parámetros de herramientas o saltarse una herramienta que debería usar.
La búsqueda híbrida aporta contexto de mayor confianza, lo que se traduce en decisiones más acertadas: el agente es menos propenso a citar mal una política o a omitir un documento relevante cuando se combinan significado y términos exactos.
La configuración vive en un único application.yaml. Decisiones clave: Hibernate crea automáticamente las tablas JPA (ddl-auto: update), Spring AI crea automáticamente la tabla de memoria de chat (initialize-schema: always), la tabla POLICY_DOCS y el índice híbrido se crean con un script SQL de una sola vez (setup-hybrid-search.sql) y Oracle UCP comparte un único pool de conexiones para los tres tipos de memoria.
Sin Flyway, sin clases @Configuration personalizadas. La autoconfiguración de Spring AI detecta el driver JDBC de Oracle y conecta todo. Consulta el application.yaml completo en el repo.
El frontend en Streamlit envía mensajes al backend y representa las respuestas. Este es el núcleo (la app completa incluye botones de inicio rápido y la opción de nueva conversación. Ver app.py):
def send_message(prompt, url):
    # POSTs plain text to /api/v1/agent/chat with X-Conversation-Id header
    # Renders user message and assistant response in Streamlit chat UI

if prompt := st.chat_input("Type a message..."):
    send_message(prompt, backend_url)
Genera un UUID por sesión como ID de conversación, envía texto plano al backend y muestra la respuesta. Y listo.
Versión corta: inicia un contenedor de Oracle DB, carga el modelo ONNX y crea el índice híbrido (configuración de una sola vez), instala Ollama y descarga el modelo de chat (qwen2.5), ejecuta el backend de Spring Boot con el perfil local y, opcionalmente, arranca la UI de Streamlit. Los embeddings se gestionan dentro de la base de datos con el modelo ONNX, sin necesidad de un modelo de embeddings en Ollama. Las instrucciones completas están en el README del repo.
Prueba rápida con curl:
curl -X POST http://localhost:8080/api/v1/agent/chat \
  -H "Content-Type: text/plain" \
  -H "X-Conversation-Id: test-1" \
-d "What orders do I have?"Esta configuración es un gran punto de partida para crear agentes reales con Spring AI y Oracle Database porque mantiene todas las capas de memoria en un mismo stack operativo: contexto episódico, recuperación semántica y acciones procedimentales. Spring AI te da abstracciones limpias (Advisors + @Tool) para que el comportamiento del agente sea legible y testeable, mientras Oracle gestiona datos transaccionales y recuperación híbrida en el mismo sistema, con embeddings en la base de datos y ranking RRF para mayor precisión tanto en significado como en términos exactos.
El resultado es práctico: menos piezas móviles, menos fallos de integración, menor latencia y operaciones en producción más sencillas. En lugar de coser sistemas separados para historial de chat, búsqueda vectorial, búsqueda por palabras clave y tablas de negocio, construyes sobre una única plataforma y aun así obtienes recuperación de alta calidad y ejecución fiable de herramientas. Para equipos que lanzan funcionalidades de agentes, esa combinación de simplicidad, precisión y control operativo es difícil de superar.
Si quieres profundizar en agentes de IA y cómo funcionan, te recomiendo el AI Agent Fundamentals skill track de DataCamp.
Top DataCamp Courses
Curso
Curso
Curso